xv6 lab5
cow fork
存储空间定义
关于存储,首先,存储器的访问颗粒是1个字 = 8bit, 所以每个字节 都有一个物理地址。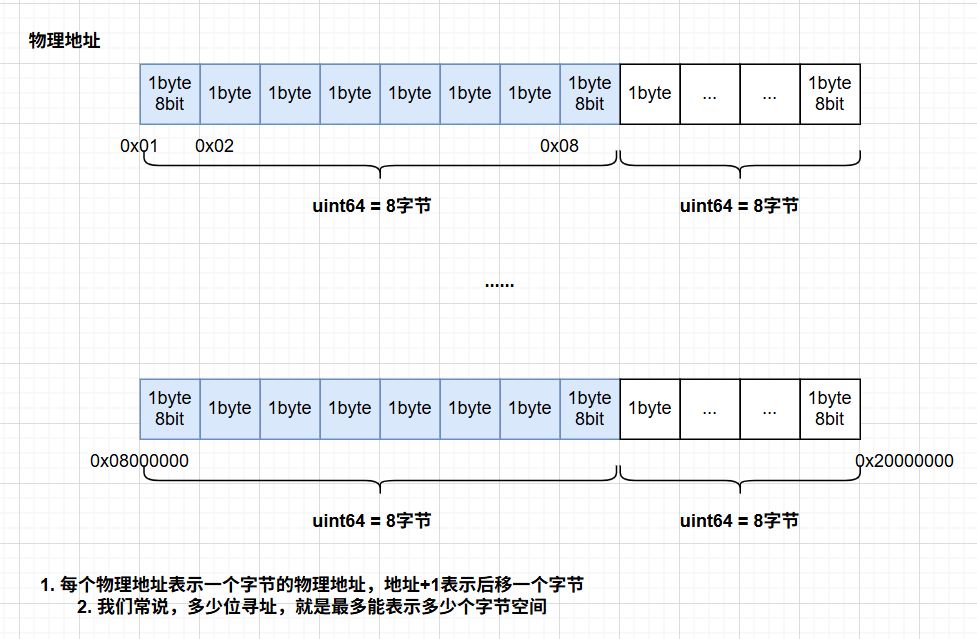
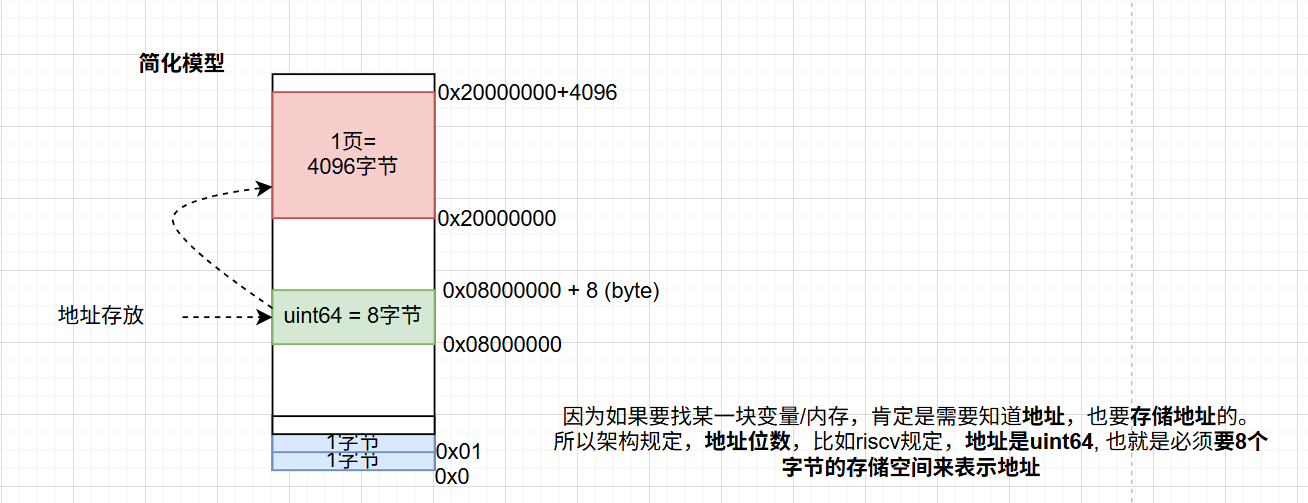
所以如果定义一个指针,uint64* p; 他实际上是一块uint64的内存,里面存放的是一个uint64内存的开始地址,也可以表示一片连着的uint64内存的初始块的起始地址(数组)
这也就解释了,为什么如果uint64 a, a++, 则表示的是下一个字节,而uint64 *a, a++, 则a指向的是下一个uint64内存。
pagetable_t
//riscv.h |
所以pagetable是一个指向uint64_t的内存块的数组的指针
里面每一项,是pte,也就是一个8字节的内存。64位,但是我们只使用里面的后面一部分的位数
硬件是如何转换的?
CPU访问一个虚拟地址(例如0x80001234)时,硬件(MMU)会进行以下动作:
VPN : xv6 (Sv39) 中,前27位(0x234)是偏移量。
查表寻踪:MMU 持有 VPN 去查表,找到对应的 PTE。
PTE中取出对应的物理页号(PPN),这就是物理内存中那一页的“起始” 。
直接调整12位偏移量,就得到了最终的物理地址。
关键点:映射对称,低12位是完全不动、原封不动地复制过去的。
VA:[ 虚拟页号 A ]+[ 偏移量 0x234 ]
PA:[ 物理页号 B ]+[ 偏移量 0x234 ]
fork
分析一下普通的fork的内容
- 创建子进程allocproc()
- np->pid
- np->status = USED
- np->trapframe = kalloc() 分配一页(4096字节)的物理内存地址
- np->pagetable 创建空的页表
- uvmcreate(),默认分配一页内存 创建pagetable_t变量指向这段内存
- mappage(trampoline) 添加一页映射trampoline
- mappage(trapframe) 添加一页映射前面分配的trapframe
- np->context, 指定上下文
- context->ra = forkret
- context->sp = kstack + PIGESIZE (sp栈底到栈顶1页大小)
- uvmcopy(p->pagetable, np->pagetable, p->sz) 拷贝父进程页表到子进程
- 针对每一页虚拟内存的起始地址va(uint64)(0 ~ p->sz)
- 从父进程的pagetable中walk出该页虚拟地址va对应的pte(一段uint64内存)
- 验证该pte是否有效(PTE_V)
- (因为我们不需要父进程pte,而是需要在子进程复制一份pte)
- PTE2PA 得到 该va对应的pa
- 拷贝父进程该va对应的pte的flag
- 申请一页空的内存mem kalloc
- 从父进程的pa拷贝父进程的该页内存到mem
- mappage 添加该va ~ mem 的映射在子进程的页表中
- 针对每一页虚拟内存的起始地址va(uint64)(0 ~ p->sz)
- np->sz = p->sz 拷贝父进程的虚拟地址空间大小
- 拷贝父进程trapframe内容
- 设置子进程的fork()返回值a0寄存器 = 0
- 复制文件描述符引用
- 复制进程名
- np->parent = p
- 设置子进程状态RUNABLE,加入调度器,开始运行
- 返回子进程pid
p->sz, kstack什么时候定的?
kalloc
kalloc.c负责对物理内存的管理,因为这里涉及到一个链表结构:
struct run { |
kmem就是我们实际的内核的物理内存管理员,他持有一个锁(针对多cpu申请内存),还有一个struct run的指针,
注意这里struct run的结构体,他这里只是借用了struct结构体的一个内部变量内存结构,这样就相当于说明,一个一小块内存,里面排头的一个8字节指针,指向下一块小内存。就这样一直指下去,至于里面的值是什么,不知道,纯粹的野指针。
他先创建了这么个结构,然后有一个头:struct run *freelist, 她指向第一块这个小struc内存
void |
这里是freerange,他是在系统初始化的时候在init的时候被调用的,告知他物理内存的起始和终止位置。freerange会把这块物理内存,按页大小(4096字节)划分好,并传入每页的起始地址,给kfree,用于释放,串联。
void |
kfree,当freerange传入一页物理内存的指针,他会格式化这一页内存,然后把这个指针改成struct run的指针,这样就完成了r对这个内存的指向,虽然他实际上还是指向的一个struct run这块小内存,但起始地址是相同的,指针r里面存的地址才是我们想要的,至于struct run是什么我们不关心。
这样就可以逐步把这些指针串起来,变成一个一页一页的链表,至此,freerange就完成了对初始状态下,空闲内存列表的收集。
void * |
最后就是kalloc了,就是从这个空闲链表上摘下一个空闲页。如果用完了要释放了,就还用上面的kfree释放物理页,让他重新回归空闲列表。
cow fork实现
注意一点:
cow fork 和 fork本质上没什么不同,只是延时创建内存,共同的,
子进程还是无法写父进程的只读区域,也就是无法动父进程的代码段。这里要区分于
fork + exec, exec才是真正把所有内存区域全部写,覆盖成你要执行的指令程序。这样覆盖完后,只读区域,和读写区域就变了。就完成了一个全新的指令进程了。
1. 分配
应该修改uvmcopy的内容,不能直接mem = kalloc分配内存拷贝,而是就用父进程的那一页物理内存,直接加入页表,同时设置父进程页表和子进程页表为合法,只读
2. 使用
思路如下: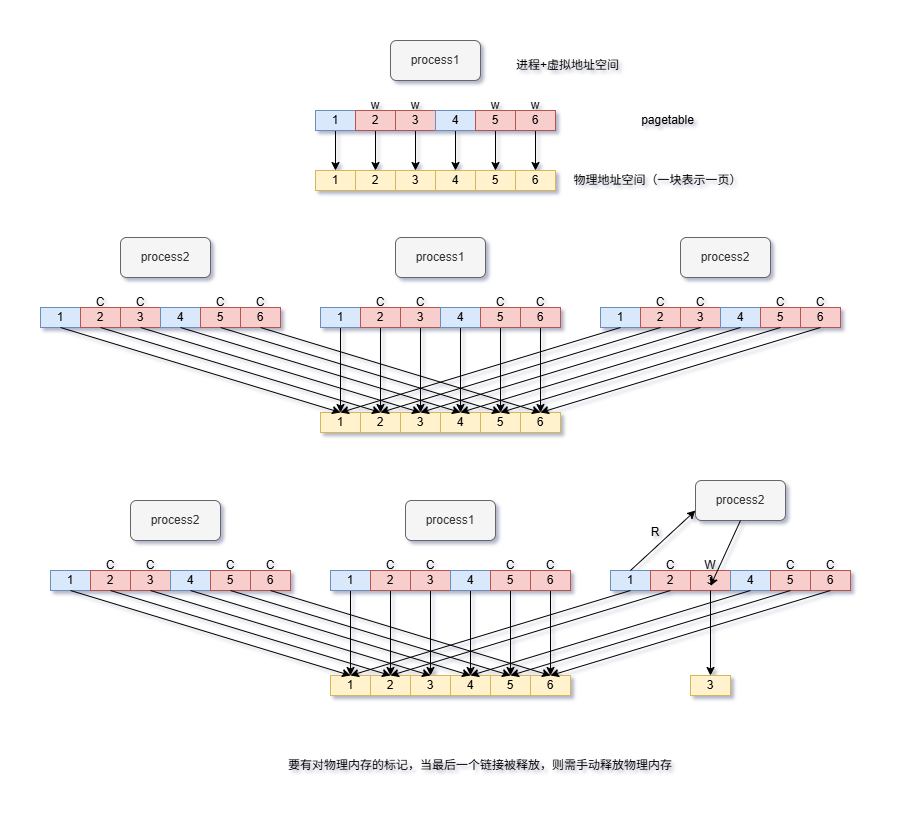
3. 释放
这里也很关键,不然sh执行指令exec覆盖的时候,就会出现释放kfree灾难,所以有必要了解一下总结在上面的kalloc的内容
所以要关注什么时候,需要真正释放,而不是结束一次进程就要释放一次进程,这样就释放灾难了。
这里非常关键,如果你没有内存页统计管理的话,就会导致进程在执行中,容易释放掉所有的内存,因为子进程不管你的父进程有啥,直接free了,
这样容易报错:
xv6 kernel is booting |
kalloc.c里面的实现逻辑,需要有一个对物理内存页的全局计数:
总结规则就是:
1. kalloc -> 申请新的物理内存 (cnt = 1)
2. kfree ->
- cnt > 1, (实际上不止一个进程拥有这块内存页), cnt -1
- cng <=0, (此时需要回收内存), cnt = 0
3. kinit -> 初始化统计数组为0,(这样freerange里面才能触发kfree,统一收集所有空闲内存页)
diff --git a/kernel/kalloc.c b/kernel/kalloc.c |
这边我犯了一些错误,只考虑了单个cpu的情况,事实上,会有很多个cpu,这会导致,如果你修改kmem内存管理员内的任何东西的时候,如果不加锁,会出现数据被意外修改。所以一定要完整的加锁才行
4. 使用支持内存计数统计
当我们在kalloc.c中支持了物理内存页的计数统计,肯定需要让cpu在处理访问页的时候,用上。
所以,还要在之前的uvmcopy,usertrap中用上。
因为对于进程和内存来说,总共就3种涉及的关系:
- 申请新的kalloc()
- 释放旧的kfree()
- 拷贝内存uvmcopy()
所以这里需要再次修改之前的uvmcopy(), 之前只实现了cow的标志位逻辑和申请拷贝逻辑,没有计数。后面trap的时候,就无法根据计数正确的释放free
//uvmcopy() |
此时,进行cowtest测试, 可以看到简单测试已经通过了,还有一个file的test
cowtest 2 19 30232 |
这个file的test,实际上是要copyout也要实现缺页处理
copyout
正常普通的写内存可能发生在:
- cpu修改变量的值
- exec覆盖内存
- copyout内核把数据往用户空间的内存拷贝。
- ……
这些情况都可以因为mmu+pagetable,出现页异常。
所以,copyout也要像usertrap一样,进行页处理
@@ -356,12 +378,51 @@ copyout(pagetable_t pagetable, uint64 dstva, char *src, uint64 len) |
这边我也犯了几个错误
1. 数据拷贝的时机
因为触发页异常,申请一页新内存,
必须要在释放旧内存前,拷贝旧内存数据到新内存,原因是:我们实际写数据,不可能刚好写一页4096字节,可能旧写一个字节,甚至只改变一些标志位,剩下的旧内存数据,依然是有效的,不能丢弃。2. 引用计数逻辑的死循环风险
按道理来说,当释放到这页物理内存,只有一个进程的时候,就不需要再释放,然后申请新页了,直接默认属于最后一个进程就行了。也可以不修复,只是让最后一个进程重新申请一次内存,麻烦一点而已。
cow fork 的基本实现(cowtest)
From 43bc35e4289e3d3261ff4a7b7691665b1856c228 Mon Sep 17 00:00:00 2001 |