infra nano-vllm 源码解读
本小节,主要来通过nano-vllm的源码解读,来了解推理系统vllm的整个架构设计,推理优化的点,并最终实现手写nano-vllm。
项目架构
这里先分析一下整个nano-vllm的项目架构
nano-vllm 是一个教学级别的轻量化 vLLM推理引擎实现
整体框架图如下: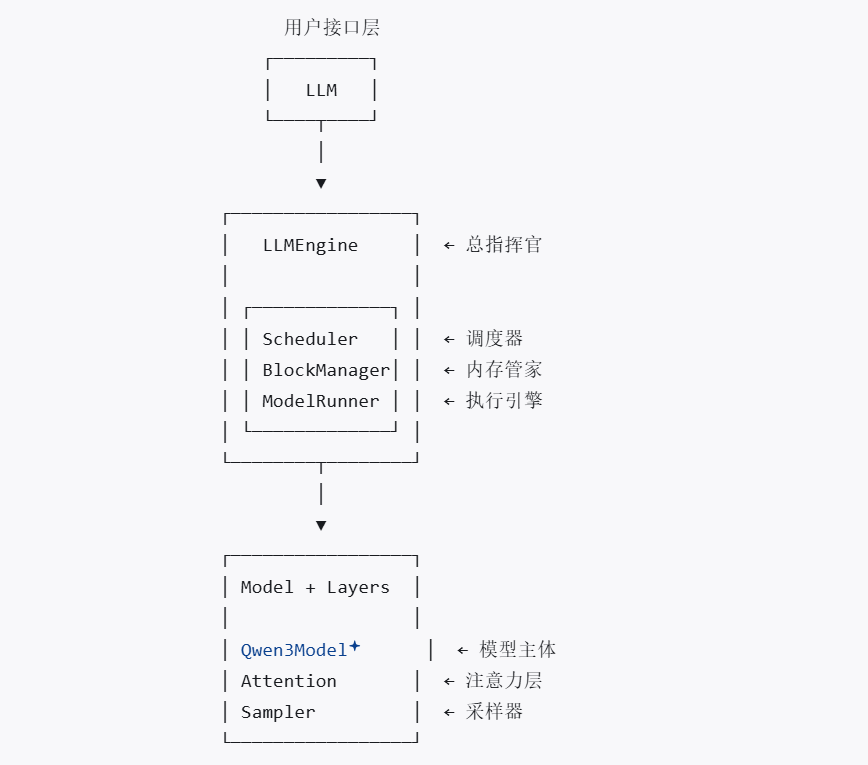
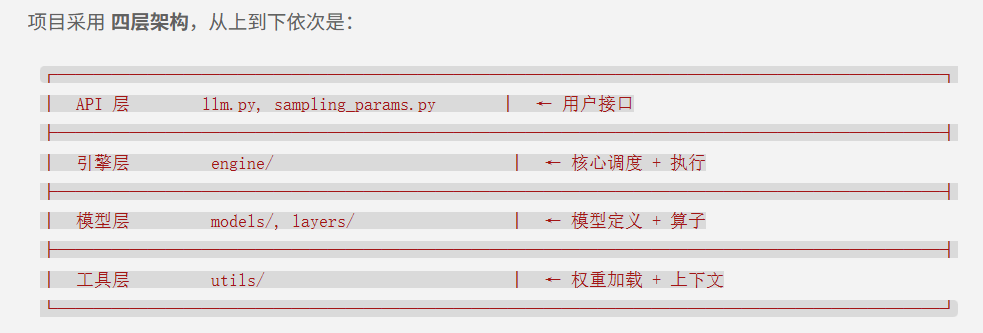
所以,总共包含4个部分:
- API层,提供用户接口,比如对话等
- 引擎层:提供调度,内存管理
- 模型层:提供算子+模型定义
- 工具层
api层
这一层主要就是面向用户的接口封装:
用户只需 LLM(model_path, ...) + llm.generate(prompts, sampling_params) 两行即可完成推理
|
引擎层
这是vllm的核心
├── engine/ # 推理引擎核心 |
模型算子层
这一层主要提供推理框架
├── layers/ # ⚙️ 神经网络层实现 |
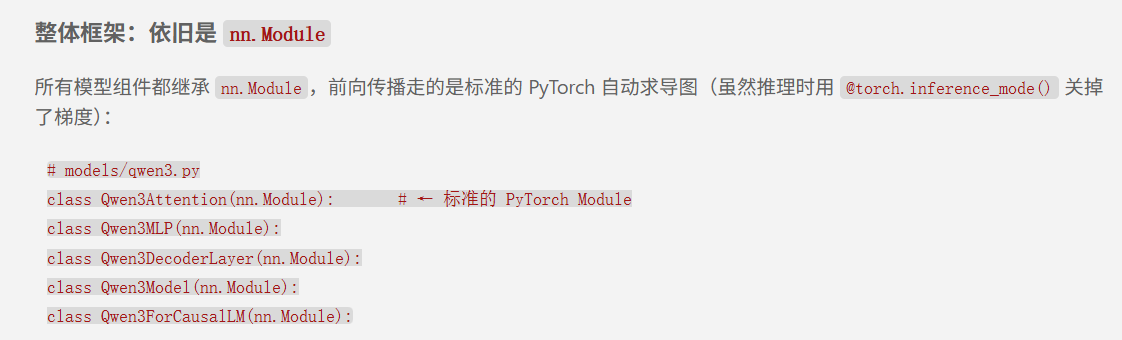
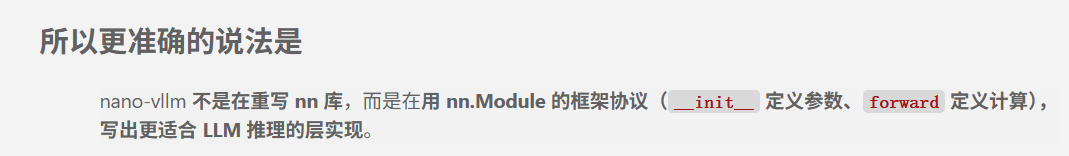
注意,这里我们的nano-vllm,并没有完全脱离pytorch,而是在torch的基础上,做了定制和优化。
各层的实现不同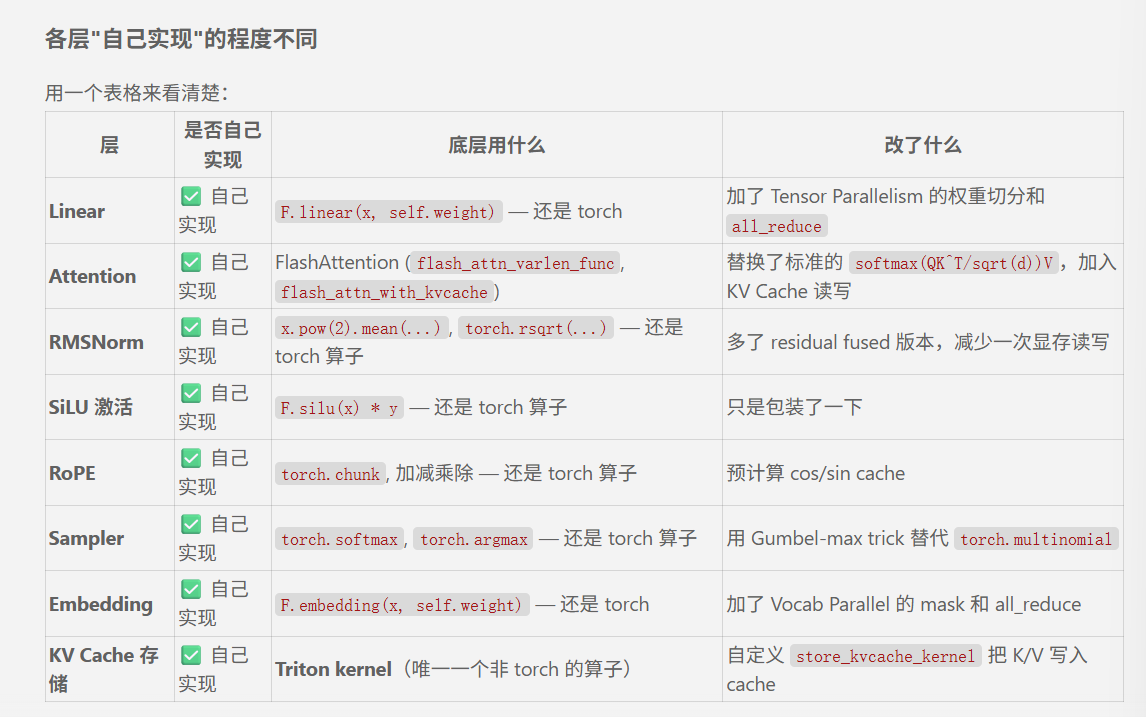
相当于就是对大模型的各个主要组件(算子),为了解决他们的性能问题,而进行了重构
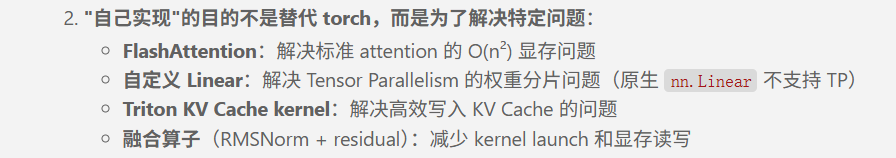
主要有:
- FlashAttention, 解决注意力计算的O(n2)的显存问题
- FFN,解决张量并行问题(TP)
- Triton KVCache kernel, 解决高效写入KV Cache的问题
- 融合算子
所以本质上,nano-vllm是重写的模型推理涉及的6个特定nn库里面的层:
PyTorch 提供的 nano-vllm 复写的 |
工具层
├── utils/ # 工具模块 |
数据处理流程
用户输入 → Tokenizer → Sequence → Scheduler → ModelRunner → Model → Sampler → 输出 |
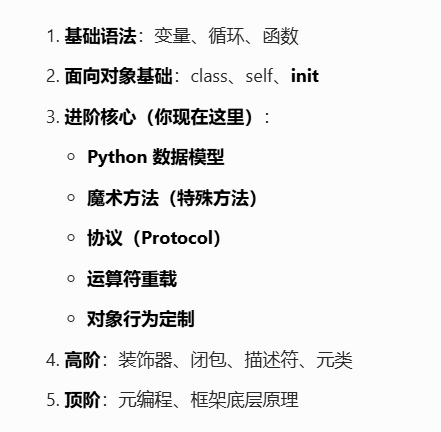
python语法补充
类型注解
简单来说,这是在告诉 Python(以及阅读代码的人):“这个变量应该是某种特定的类型”。
Python 本身是动态类型语言(变量可以随时改变类型),但类型注解能让代码更易读、减少 Bug,并且让 IDE(如 VS Code/PyCharm)提供更精准的代码补全
model : str |
- 语法:
变量名: 类型 - 理解: 声明
model变量应该是一个字符串(string)。这只是个标注,不会强制阻止你给它赋值数字,但静态检查工具(如 MyPy)会报错。
max_tokens: int = 64 |
- 语法:
变量名: 类型 = 默认值 - 理解: 声明
max_tokens是整数(integer),并且它的初始值是64。
prompts: list[str] | list[list[int]] |
- 语法:
A | B(Python 3.10+ 的新写法) - 理解:
|符号读作 “或者”。- 它可以是一个字符串列表:
["hello", "world"] - 或者是一个嵌套的整数列表:
[[1, 2], [3, 4]]
- 它可以是一个字符串列表:
hf_config: AutoConfig | None |
- 语法:
类型 | None - 理解: 表示这个变量要么是一个
AutoConfig对象,要么是None(空)。
segs: list[Sequence] |
- 语法:
容器类型[内部元素类型] - 理解: 这是一个列表,但列表里的每一个元素都必须符合
Sequence(序列)协议(比如列表、元组或字符串)。
python一切皆对象
- 整数
1是对象 - 字符串
"hello"是对象 - 列表
[]是对象 - 函数
def func():是对象 - **类
MyClass是type类的实例。
所以,定义一个class Book,他有很多属性
class Book: |
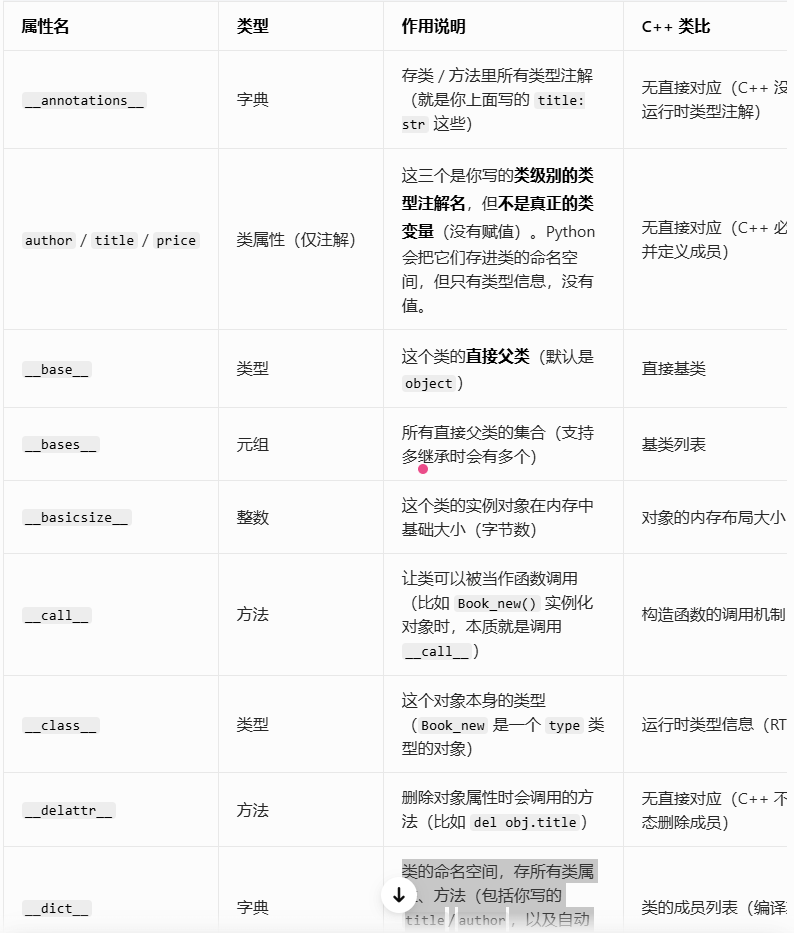
所以,一个类,默认有三个方法:
- init
- call
- delattr
当然这不是全部,一个类实例,有很多个方法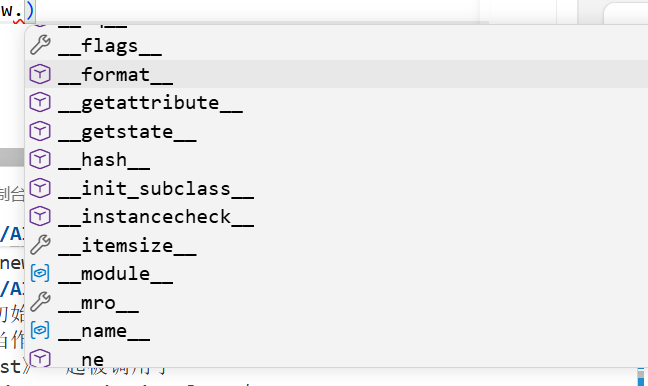
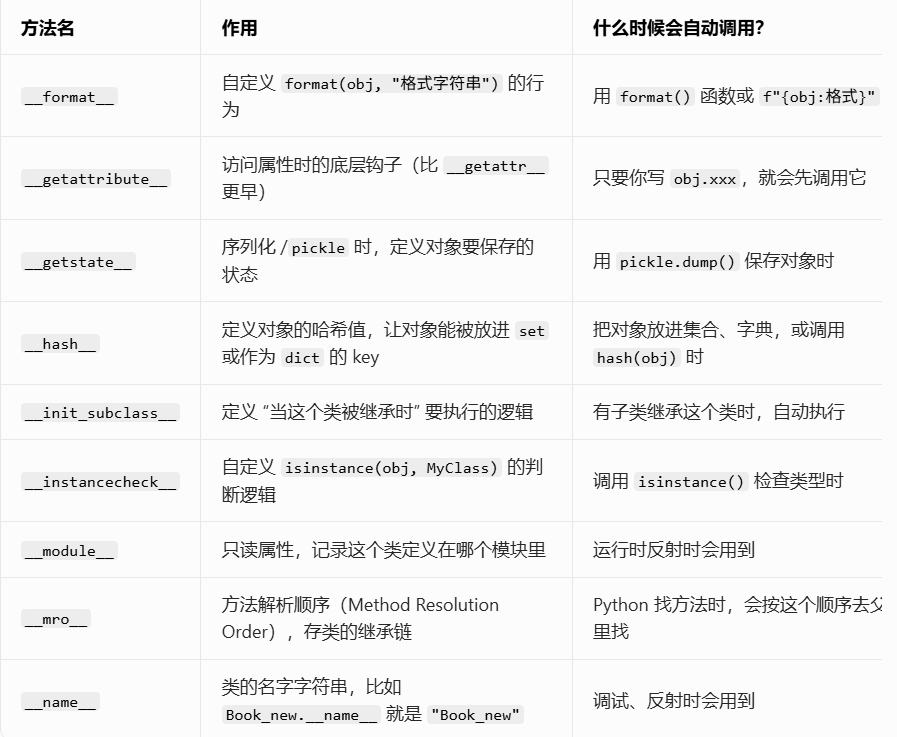
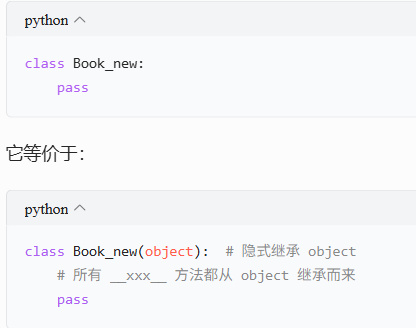
因为 Python 的 object 类默认提供了这些方法的基础实现。
常用的类实例的方法
__repr__:重写它,让 print(obj) 输出好看的信息,而不是 <Book object at 0x...>。
__eq__ / __hash__:如果想让对象可以用 == 比较,相当于重载
__getattr__ / __setattr__:需要自定义属性访问逻辑时(比如做代理、动态属性)
__call__:想让对象可以像函数一样被调用时(比如 obj())
dataclass装饰器
装饰器
就是一个自动插件,你写好一个基础的类,加上这个帽子,就可以在后台自动为你的基础类添加很多功能。
|
所以装饰器的作用,就是帮你默认改造上面类实例的一些默认方法
dataclass改造的方法
dataclassdataclass 是 Python 3.7 引入的一个模块,专门用来创建只负责保存数据的类。
改造了哪些方法呢?
- __init__方法
自动识别你的类型注解,然后写入你的init来帮你构造初始化函数
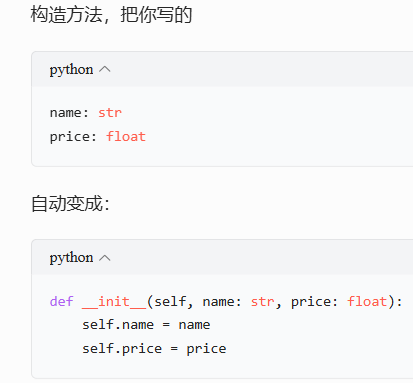
- **__repr__方法
格式化打印方法, 没有写的话,打印对象,默认会打印地址,相当于重载了<<
eq
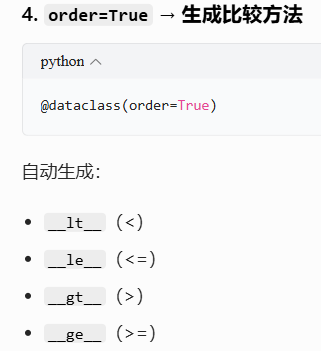
重载==如果开启了order=True参数
frozen=True→ 让对象不可修改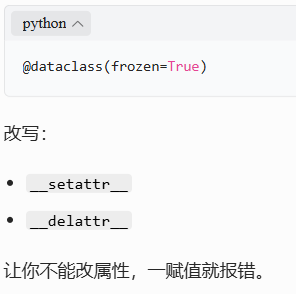
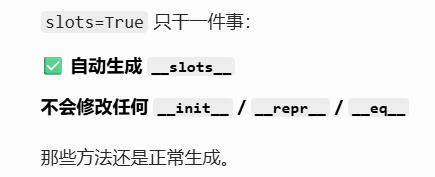
slots=True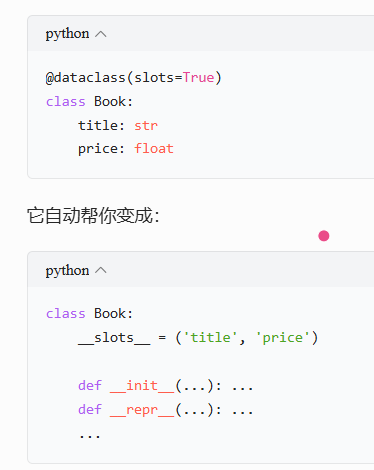
正常,我们是通过__dict__字典,来查看所有的成员变量的,也可以动态增减成员属性。但是占内存,速度慢
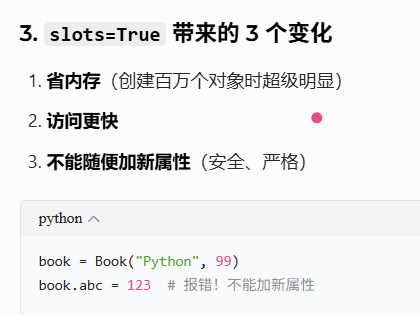
而开启了slots之后,就等于锁死了属性,不能动态增减属性,但是内存占用少了,访问速度更快,但是没有__dict__了。
属性装饰器
@property 是一个装饰器,能把类里的方法伪装成属性,让你可以像访问普通变量一样调用它,但底层执行的是函数逻辑。
三种基本用法
- 只读属性
某个值是计算出来的,不想让用户直接修改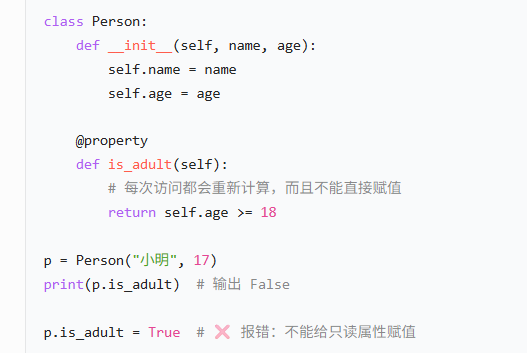
这样可以实现一个只读属性
- 属性写校验
我们在修改某个属性时,想要先校验,因为直接修改属性肯定无法校验,所以需要用
@[属性].setter
来设置这个属性的写入方法
注意:@name.setter 是 property 的语法糖,它必须跟在 @property 装饰的 name 方法后面才能用。所以必须依赖@property才行
- 可删除属性
@xxx.deleter,不常用
场景:删除属性时需要做清理工作。
语法糖
语法糖(Syntactic Sugar),就是「让代码写起来更甜、更舒服,但功能上没有任何变化的语法」。
它本质上是语言给你提供的「便捷写法」,底层会自动帮你转换成等价的、更繁琐的代码,让你少写重复、难看的代码。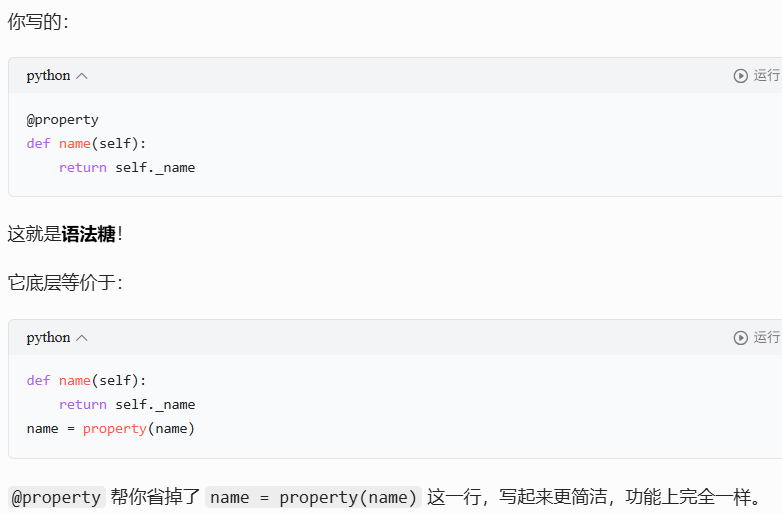
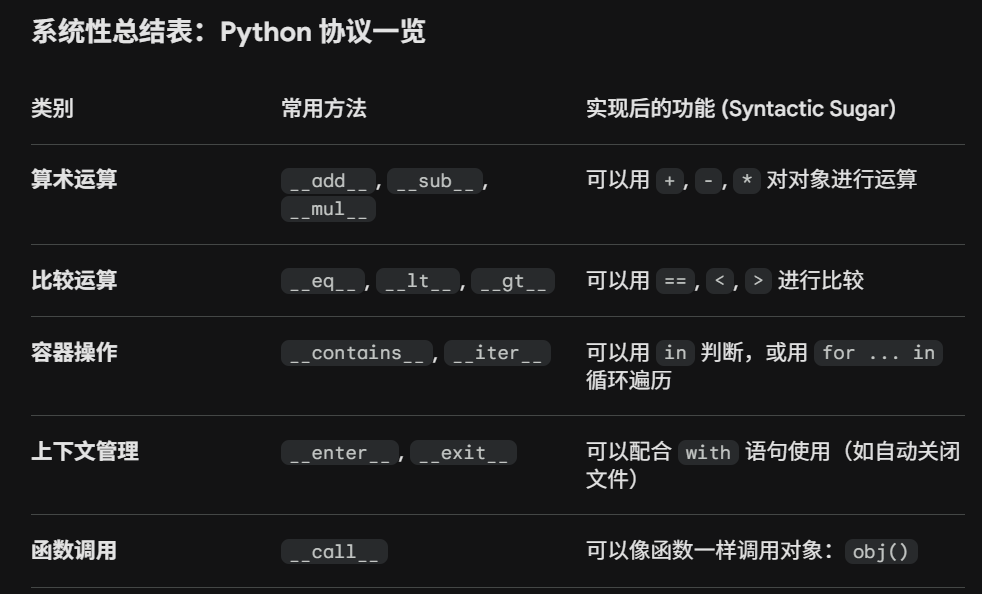
协议(Protocol)
# sequence.py |
Python 数据模型(Data Model)(魔术方法/双下方法)
这一块属于python 协议 编程的核心:只要你在类里实现了特定的魔术方法,你的对象就可以表现得像内置类型(如列表、字典、数字)一样。
容器与序列协议 (Container/Sequence Protocol)
类里面实现的__len__, getitem 这些方法,能够把我自己的类伪装成一个列表/元组
__len__(self):- 触发方式: 调用
len(obj)。 - 作用: 返回对象的长度。
- 触发方式: 调用
__getitem__(self, key): 数组下标访问- 触发方式: 使用索引取值
obj[key]。 - 作用: 定义如何获取数据。支持
key为整数(索引)或slice对象(切片obj[1:3])。
- 触发方式: 使用索引取值
# 注意这个方法只能返回整形int |
生命周期与初始化 (Lifecycle)
__init__(self, ...): 初始化对象。__new__(self, ...): 真正创建实例的方法(在__init__之前执行,常用于单例模式)。__del__(self): 析构方法,当对象被垃圾回收时触发
序列化协议 (Serialization)
__getstate__(self):- 作用: 当你尝试“打包”(序列化)一个对象存入磁盘或在网络传输时,这个方法决定哪些数据被保存。
- 场景: 如果类里有一个巨大的临时缓存或无法序列化的文件句柄,你可以通过这个方法把它们排除在外。
__setstate__(self, state):- 作用: “拆包”(反序列化)时,如何根据保存的数据重建对象。
import pickle |
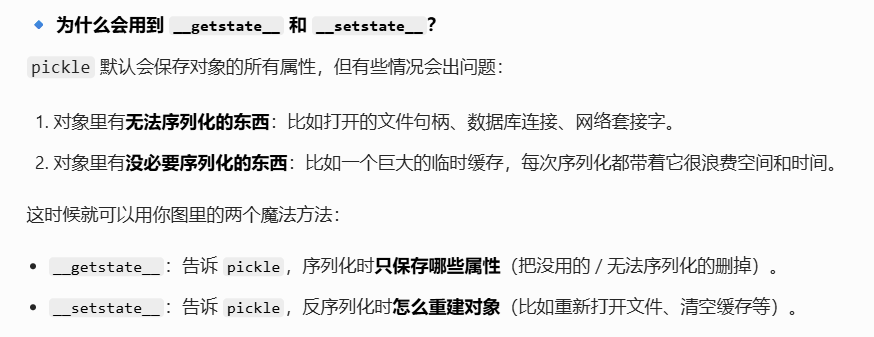
其实说白了,就是特地指定哪些能打包序列化,哪些不用打包序列化
对象表示 (Object Representation)
决定对象在不同环境下如何显示。
__str__:print(obj)时显示的对用户友好的字符串。__repr__: 开发调试时显示的字符串(应尽量能通过eval(repr(obj))还原对象)。
class Person: |
枚举类
from enum import Enum, auto |
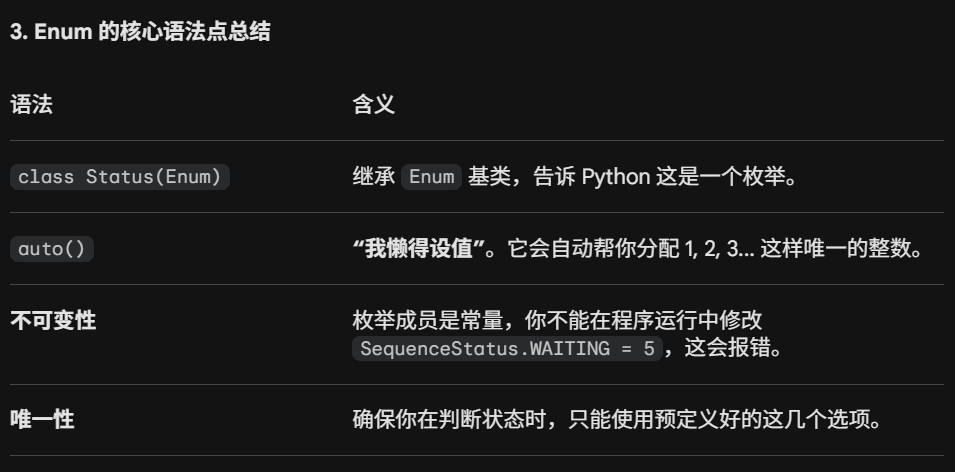
Enum是枚举类的基类,auto是一个函数估计,提供自动计数,防止重复
另外的装饰器
装饰器的本质是一个“包装器”,在不修改原函数内部代码的前提下,为函数增加额外的功能。
pytorch装饰器
在sampler.py, model_runner.py这种速度要求高的文件里面,有以下两种装饰器
@torch.compile (内核编译优化)
- 语法点: 这是 PyTorch 2.0+ 的核心特性。
- 背后的原理: 默认情况下,Python 是“一行一行”执行代码的(解释型)。这个装饰器会把 Python 函数转换成高度优化的中间表示 (IR),然后针对 GPU 生成专门的内核代码(Triton 内核)。
- 效果: 极大地减少 CPU 启动开销(Overhead),提高 GPU 的吞吐量。它让你的 Python 代码跑起来接近 C++ 的速度。
@torch.inference_mode() (上下文管理)
- 语法点: 这是一个带括号的装饰器(实际上是一个装饰器工厂)。
- 背后的原理: 它告诉 PyTorch:“我现在的操作只是为了推理(预测),不是为了训练。”
- 效果:
- 关闭梯度计算(不记录反向传播所需的中间变量)。
- 减少显存消耗。
- 性能更快(比旧的
with torch.no_grad():甚至还要更快一些)。
functools工具类装饰器
@lru_cache(maxsize=1) (最近最少使用缓存)
- 语法点:
lru_cache来自标准库functools。 - 背后的原理: 它给函数增加了一个“备忘录”。当你第一次用参数
A调用get_rope时,它计算结果并存起来;第二次用同样的参数调用时,它直接从内存里拿结果,不再执行函数内部逻辑。 - 场景: 在大模型中,
get_rope(获取旋转位置嵌入)通常涉及复杂的三角函数计算。因为模型的旋转位置编码在运行中通常是固定的,所以用maxsize=1缓存住最近一次的结果,可以省去每一层都重复计算的开销。
装饰器的基本知识
要掌握这一块语法,你需要理解以下三个层级:
| 层级 | 表现形式 | 核心作用 |
|---|---|---|
| 基础层 | def decorator(func): |
理解装饰器本质是一个接收函数并返回函数的高阶函数。 |
| 进阶层 | @decorator(args) |
理解带参数的装饰器(如 lru_cache(1)),它先执行函数生成真正的装饰器。 |
| 工程层 | @torch.compile 等 |
掌握在特定框架中,如何利用装饰器无侵入地实现性能优化。 |
基础数据结构
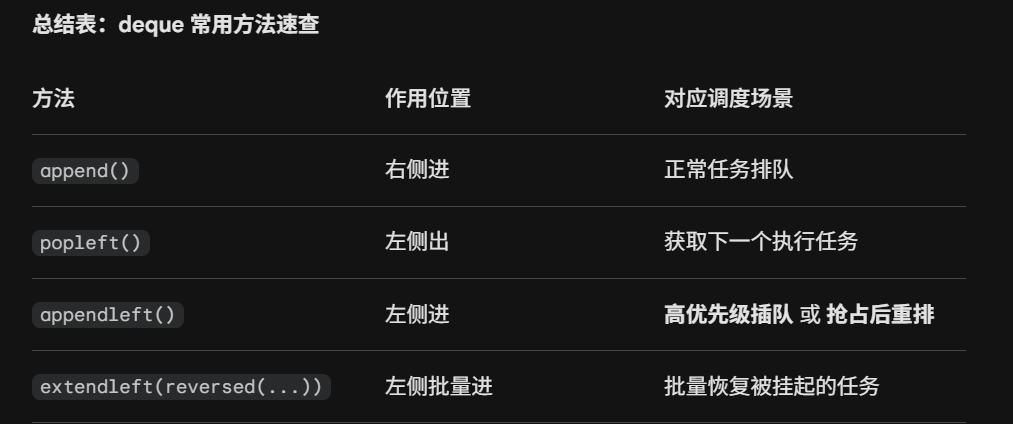
双端队列deque
就是双向链表,数据可以从两头进,也可以从两头出。
因为是双向链表,所以,增,删首尾节点的时间复杂度是O(1),对比list,增加删除最后一个元素是O(1),但是增删第一个元素是O(n)
- 添加元素(push)
- .append(x): 尾部插入
- .appendleft(x):队首插入(高优先级立刻处理)
- 弹出元素(pop)、
- pop(): 从队尾取出一个并删除
- popleft(): 从队首取出一个并删除(调度器常用,获取下一个待处理的任务)
- 批量操作(Extend)
- extend(iterable): 在右侧批量添加
- extendleft(iterable): 在左侧逐个批量添加(最终方向相反)
- 特殊功能(限制长度)
- d = deque(maxlen=10)
- 满了之后,右边加一个,左边会被挤掉一个,用于处理滑动窗口或者最近日志记录
- d = deque(maxlen=10)
deque的初始化,
from collections import deque |
元素可以是任意类型,只要是可迭代对象,就能进行初始化
判断一个对象是否是可迭代的
from collections.abc import Iterable |
isinstance 类型检查
其中isinstance 是 Python 最常用、最重要的内置函数之一,专门用来判断一个对象 是不是 某种类型。
isinstance(要检查的对象, 类型) |
返回结果:True / False
# 判断 100 是不是 int 类型 |
itertools.count类
itertools.count(), 为了给每一个新生成的对象(比如一条 Sequence/请求)分配一个全局唯一的 ID
它是 Python 内置标准库中的一个无限迭代器。
- 形象理解:它就像一个永不停歇的计数器。你不需要告诉它什么时候停止,只要你找它要(调用
next()),它就会给你下一个数字。 - 默认行为:如果不传参数,它从
0开始,步长为1。即:0, 1, 2, 3...
from itertools import count |
列表推导式
outputs = [outputs[seq_id] for seq_id in sorted(outputs.keys())]
- 外层
[]:表示最终结果是一个列表。 outputs[seq_id]:这是结果表达式(你想存进列表里的东西)。for seq_id in sorted(outputs.keys()):这是迭代逻辑。它先获取字典所有的键,排序,然后逐个取出。
字典推导式
config_kwargs = {k: v for k, v in kwargs.items() if k in config_fields}
其中:items() 是字典(dict)的内置方法,把字典里的所有「键值对」一次性取出来。
item() 这个是单数,他的作用是把只有一个元素的数组/列表,转换成一个值
集合推导式
就是返回的是set集合my_set = {x for x in [1, 2, 2, 3, 4, 4, 5] if x > 2}
enumerate
enumerate 是 Python 里一个超常用、超好用的内置函数,专门用来「遍历序列时,同时拿到索引和元素」
enumerate 就是给你要遍历的东西,自动加上序号,让你不用自己写 i = 0; i += 1 来计数。
常用数据结构对应表
- list 列表 = C++
vector动态数组 - tuple 元组 = 只读不可变数组
- dict 字典 = 哈希表
unordered_map - deque 双向队列 = 双向链表
- set 集合 = 哈希集合
unordered_set- 自动去重、判断成员超快
s = {1,2,3} |
- frozenset 不可变集合
- 不能增删,可当字典 key
- heapq 小顶堆 = 优先队列
priority_queue- 用来做 TopK、排序、任务优先级
- collections.defaultdict
- 带默认值字典,避免键不存在报错
- collections.OrderedDict
- 有序字典(3.7+dict 本身也有序)
- collections.Counter
- 计数统计神器,统计列表 / 字符串元素频次
- collections.namedtuple
- 命名元组,轻量级结构体
- array.array
- 纯同类型紧凑数组,比 list 省内存
- bisect 有序数组
- 维持列表有序,二分查找插入
最简用途速记
- 存有序可改数据 → list
- 固定不变数据 → tuple
- 键值查找 → dict
- 头尾快速增删 → deque
- 去重、判存在 → set
- 排序优先取最值 → heapq
- 统计次数 → Counter
- 轻量结构体 → namedtuple
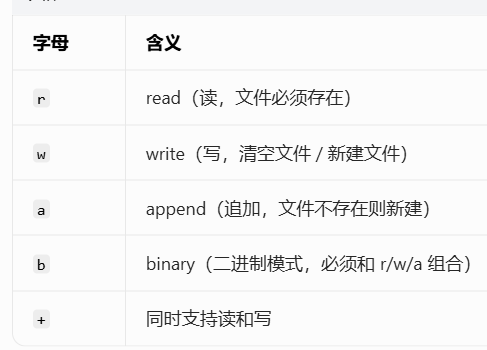
序列化pickle
pickle 序列化
# model_runner.py |
通常不仅仅是为了“保存到文件”,更多是为了“跨进程通信”。
- 序列化 (
dumps):把内存中复杂的对象(比如列表、字典、甚至你自定义的类实例)“拍扁”成一串字节流(Binary)。 - 反序列化 (
loads):把这串字节流重新“吹气”膨胀,恢复成内存中一模一样的对象。
1. 一般用在进程间通信上:IPC
大模型推理通常是多卡的。主进程(Master)负责分配任务,工作进程(Worker/GPU)负责计算
主进程把要执行的
method_name和args用pickle.dumps变成字节,通过网络或管道(Pipe)发给 GPU 进程。GPU 进程收到后用
pickle.loads还原,然后执行对应的函数
2. 分布式对象传输
分布式训练或推理(Ray 框架或 Torch Distributed),对象需要在不同的物理机器之间传输。由于网线里只能传二进制数据,pickle 就充当了“打包员”
3. 保存模型状态/检查点 (Checkpoint)
当你训练了一个模型,或者计算出了一些复杂的特征向量(Embeddings),你可以把它们 pickle.dump 到磁盘上。下次启动程序,直接 load 回来,不需要重新计算
pickle序列化的api
dumps→ 转字节(内存)loads→ 从字节恢复dump→ 存文件load→ 读文件
import pickle |
星号解包
| 符号 | 名字 | 作用 |
|---|---|---|
* |
单星号 | 解包位置参数(列表 / 元组 / 可迭代对象) |
** |
双星号 | 解包关键字参数(字典) |
列表,元组/可迭代对象 + * 是拆分成多个对象
、
**双星号解包,关键字参数《-》字典的类型转换
字典 + ** 拆分成关键字
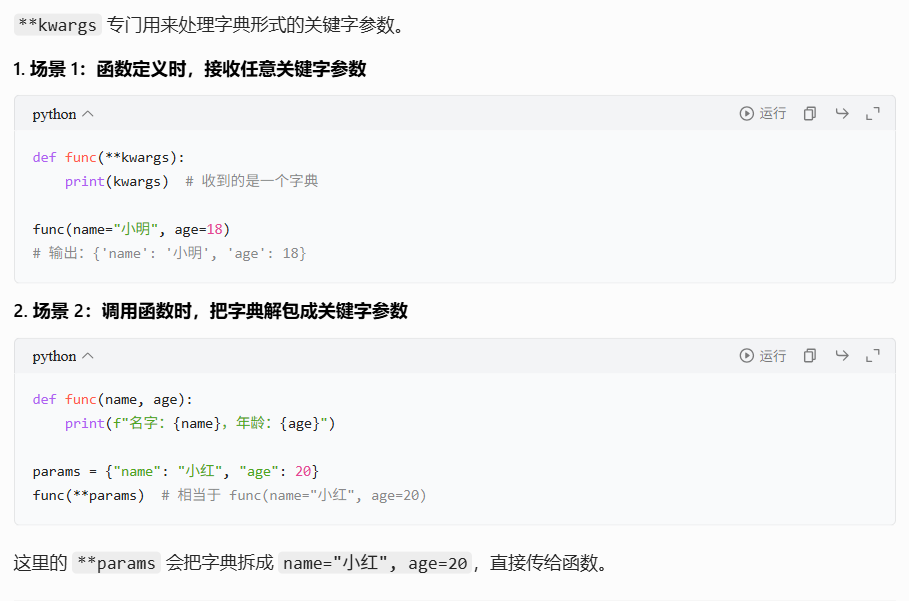
def func(*args, **kwargs): |
@classmethon 和 @staticmethod
| 装饰器 | 自动传入的参数 | 能访问的内容 | 典型用途 |
|---|---|---|---|
@classmethod |
cls(类本身) |
类的属性、其他类方法 | 创建实例、工厂方法、修改类属性 |
@staticmethod |
无 | 类和实例都不能直接访问 | 与类相关但不需要类信息的工具函数 |
class Person: |
什么时候用 @classmethod?
- 你需要在方法里创建这个类的实例(比如工厂模式)
- 你需要修改 / 访问类属性(比如统计创建了多少个实例)
- 你需要调用类的其他方法
什么时候用 @staticmethod?
- 方法逻辑和类本身完全无关,只是 “名义上属于这个类”
- 不需要访问类属性,也不需要访问实例属性
断言 assert
“设卡检查”
assert 是一种调试辅助工具。它的逻辑非常简单粗暴:
- 如果条件为
True:程序继续跑,像什么都没发生一样。 - 如果条件为
False:程序立即“原地爆炸”(抛出AssertionError异常),并停止运行。
| 语法 | 含义 |
|---|---|
assert <条件> |
仅检查条件。 |
assert <条件>, <错误消息> |
条件失败时,打印出你写的字符串,方便排查。 |
| 性能提示 | 如果在启动 Python 时使用了 -O(优化模式),断言会被全部忽略。 |
在 model_runner.py 这种高性能代码中,区分这两种报错很重要:
if...raise...:用于处理预期内的错误(比如用户输入了一个不存在的文件名)。即使发布了,也要保留。assert:用于捕捉程序内部的逻辑错误(开发者认为“这绝对不可能发生”的情况)。它主要在开发和测试阶段起作用。
整体推理架构梳理
┌──────────────────────────────────────────────┐ |
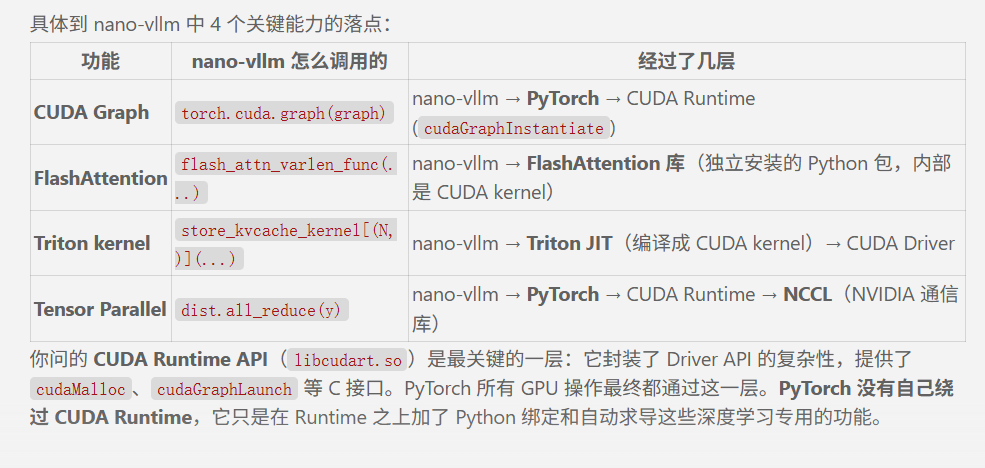
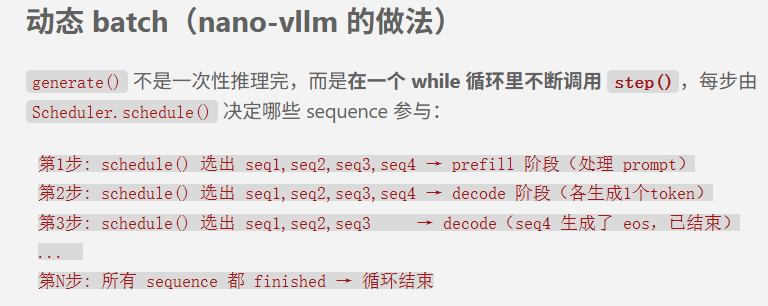
- 前缀缓存prefix cache
- chunked prefill (scheduler)
- 仅支持等待队列中第一个seq的chunked
- CUDA Graph
- FlashAttention
- continuous batching
- 张量并行
- pagedattention
- block_table作为页表,写入位置作为slot, blockmanager作为操作系统,kvcache是具体的物理内存,所以底层具体写入物理内存,用的是FlashAttention, 而页表管理则是靠blockmanager
分模块解析
sequence
//一个序列,prompt提示,请求 |
blockmanager
block里面存放序列的tokens,主要用于计算前缀cache
//定义一个block内存页,存放KVcache |
BlockManager用于管理空闲Block内存的分配与回收
负责管理所有的block的申请与回收 |
scheduler
|
model_runner
//负责执行模型推理的前向传播 |
LLMEngine
class LLMEngine(){ |