infra Transformer 推理性能分析
这里主要总结一下,ai infra里面的各种术语,以及transformer的参数,计算,以及优化点的分析:
ai infra的各部分与transformer的对应关系
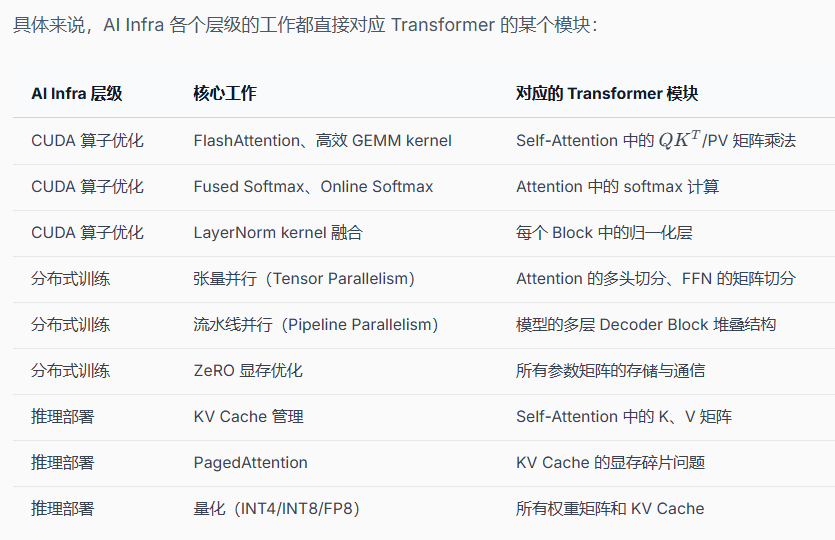
主要分为:
- CUDA算子
- FlashAttention, 高效GEMM kernel
- Fused Softmax, online Softmax
- LayerNorm kernel 融合
- 分布式训练
- 张量并行(层内多头并行)
- 流水线并行(decoder block堆叠)
- ZeRO 显存优化(所有参数矩阵的存储与通信)
- 推理部署
- KVcache管理
- PagedAttention (KVcache的显存碎片)
- 量化(INT4/INT8/FP8)(所有权重矩阵和KVCache)
主流大模型架构:Decoder-only
主流大模型:GPT,LLaMA, Mistral, Qwen, Deepseek 都是编码器仅结构
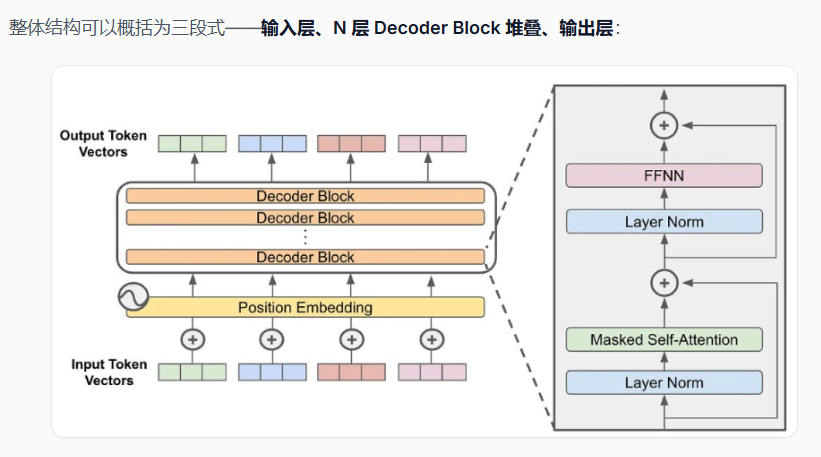
结构和传统的transformer的decoder块,稍有不同。这就是后面将会讲的 Pre-Norm vs Post-Norm 区别
encoder-only / encoder-decoder / decoder-only 对比
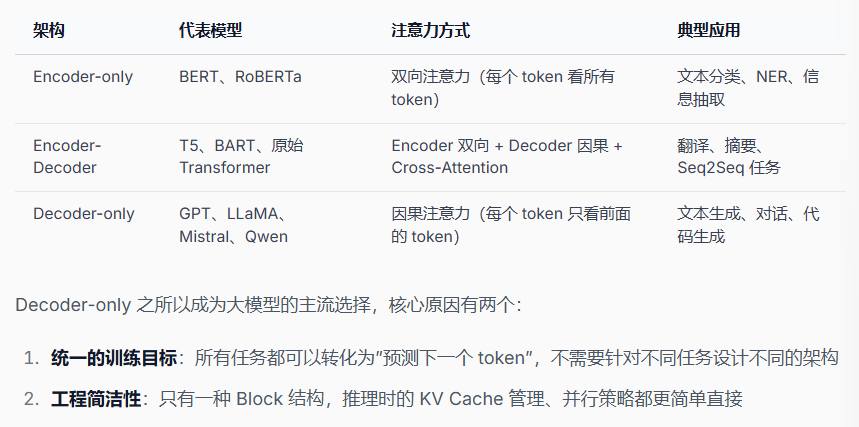
我们的大模型的主流都是Decoder-only, 因为目标都是自回归
decoder-only block解析
self-attention
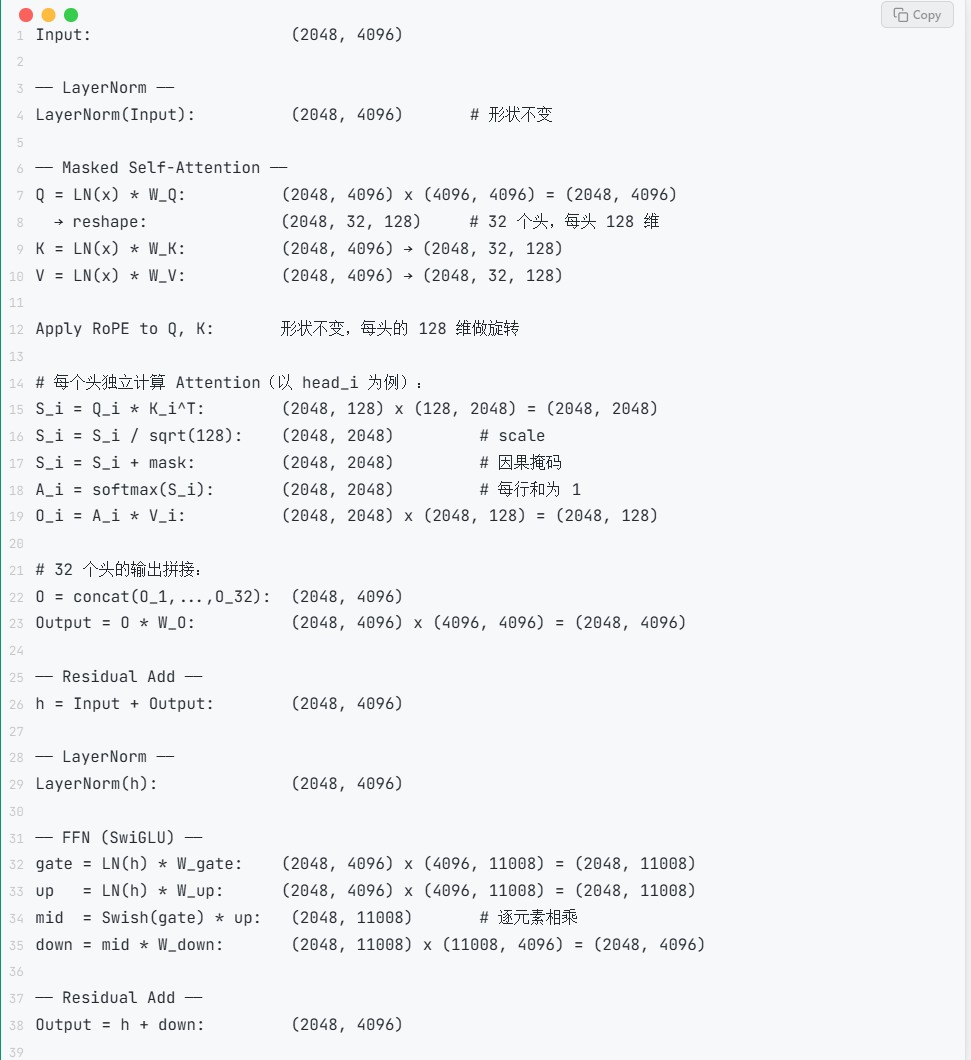
这里先要强调,主流大模型,输入block的X的embed_size 就等于 hidden_size = d_model
所以X(batch_size, seq_len, d_model),
QKV线性投影
x 经过:
- W_Q (d_model, d_model)
- W_K (d_model, d_model)
- W_V (d_model, d_model)
得到我们的Q,K, V
这一步就是多头的里面,统一升维,不过还是从d_model -> d_model
所以这一步,会有3个指令的运算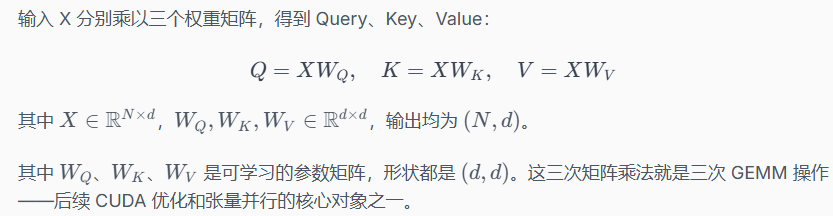
优化点:CUDA优化,张量并行(多头)
注意力计算
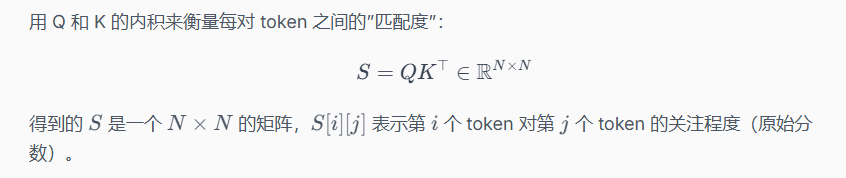
注意力分数
缩放
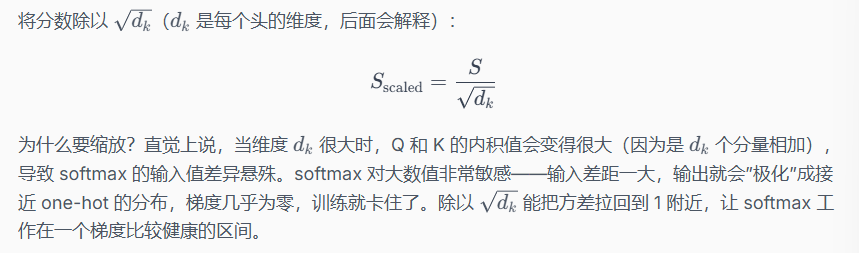
把方差拉回1
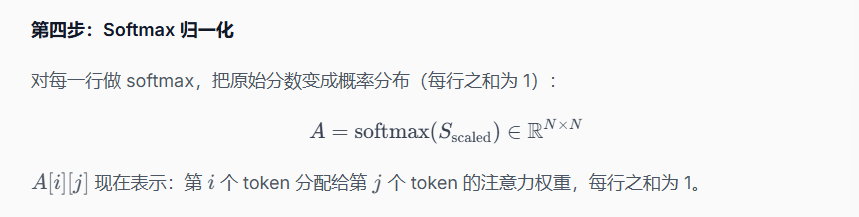
softmax
优化点:softmax算子
softmax标准实现,需要对一个q的所有k的打分做两边扫描
online softmax: 合并成一遍扫描
FlashAttention: 基于online softmax 快速计算attention
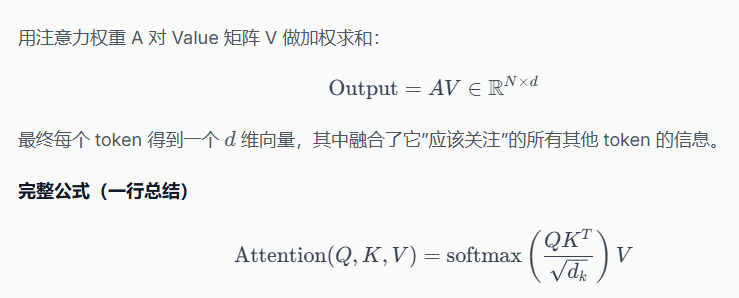
加权求和得到V
输出投影
合并多头,输出d_model维度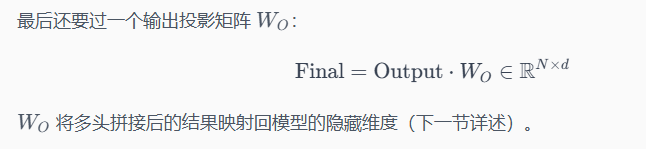
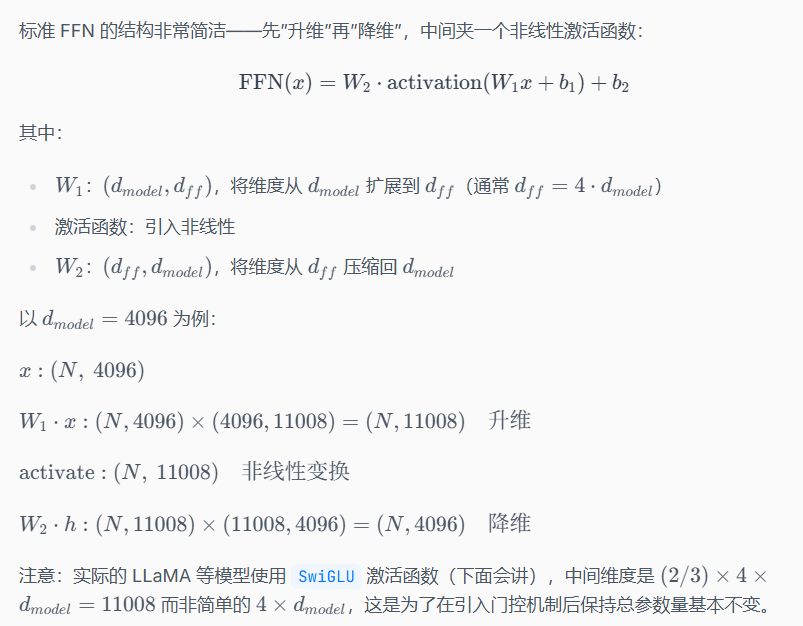
FFN
前面attention负责让信息交互,FFN负责对每个信息token做深度加工
模型参数量分析
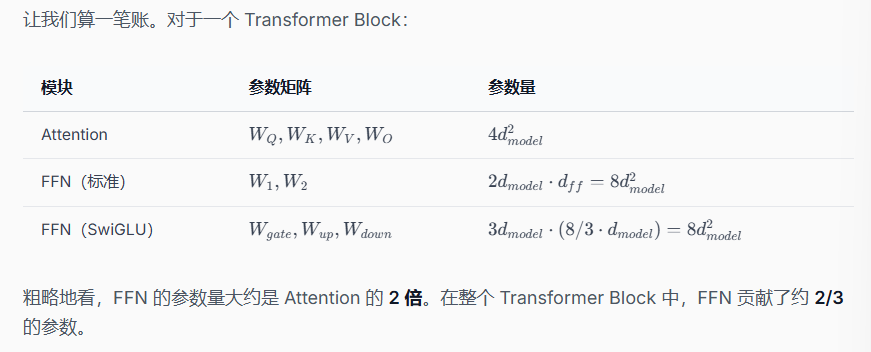
attention: embed_size = d_model
FFN(标准), 两层,且d_ff= 4d_model
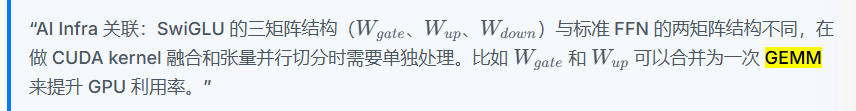
AI Infra 关联:由于 FFN 的参数量占大头,在做张量并行时,FFN 的切分方式直接影响通信开销。Megatron-LM 将 W1W1 按列切分、W2W2 按行切分,使得中间结果不需要 AllReduce,只在最后做一次 AllReduce——这种切分方式正是利用了 FFN 的”先升维后降维”结构。在混合专家模型(MoE)中,FFN 进一步被拆分为多个”专家”,引入了 Expert Parallelism 这一新的并行维度。
激活函数的变化
- ReLU
- GELU
- SwiGLU
位置编码
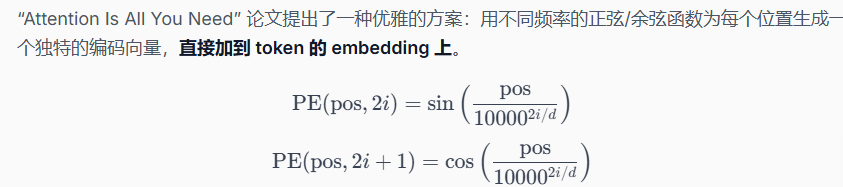
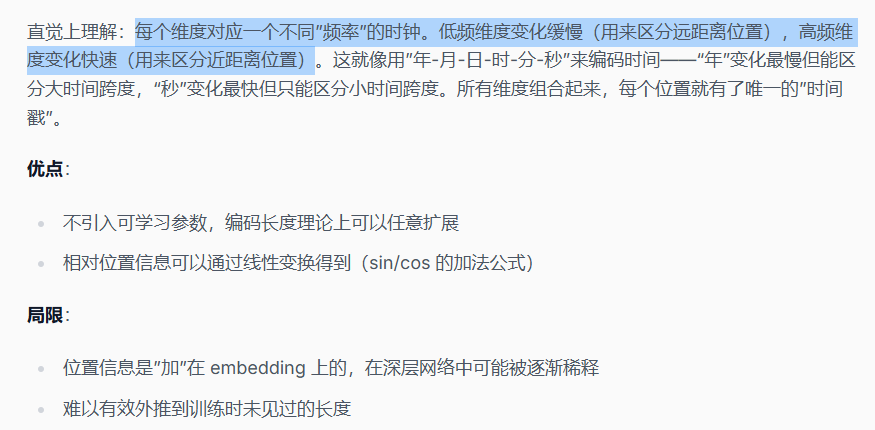
Sinusoidal位置编码(原始)
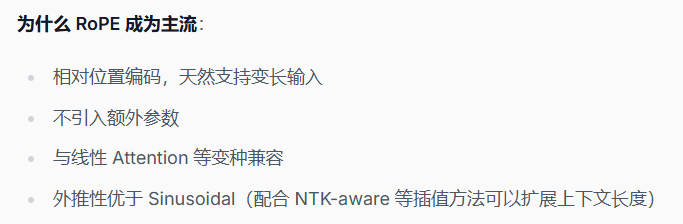
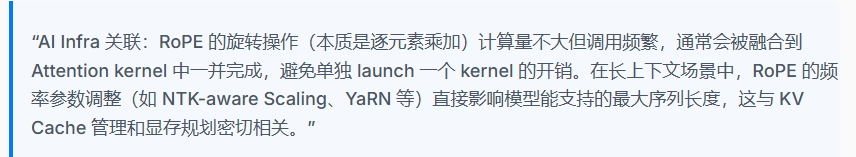
RoPE(旋转位置编码)(主流选择)
核心思想:不在 embedding 层注入位置信息,而是在计算 Attention 时,通过旋转 Q 和 K 向量来编码位置。
具体做法是把 Q 和 K 向量的每两个相邻维度看作二维平面上的坐标,然后根据 token 的位置按特定角度旋转这个二维向量: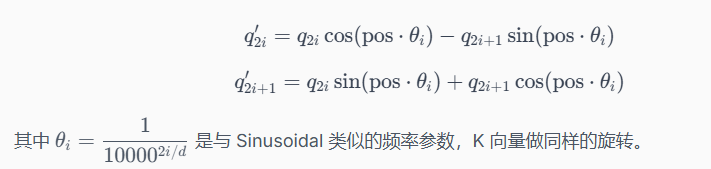
这样做的关键性质是:旋转后的 Q 和 K 做内积时,结果只依赖于两个 token 的相对位置差
这意味着 Attention 天然编码了相对位置信息,非常符合语言理解的需求(“第 3 个词和第 5 个词之间的关系”比”第 3 个词和第 5 个词各自的绝对位置”更重要)
LayerNorm, 残差连接
LayerNorm(Layer Normalization)对每个 token 的特征向量做归一化——减去均值、除以标准差,再通过可学习的缩放参数 γγ 和偏移参数 ββ 恢复表达能力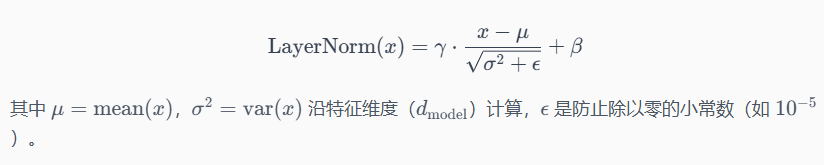
Pre-Norm / Post- Norm
LayerNorm 放在子层的前面还是后面,是一个看似微小但影响深远的设计选择
经典的transformer是放在后面,post norm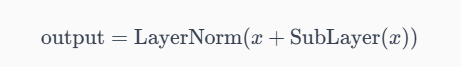
当前大模型主流是pre-norm
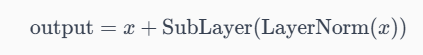
关键区别是残差的高速通路不经过LayerNorm处理
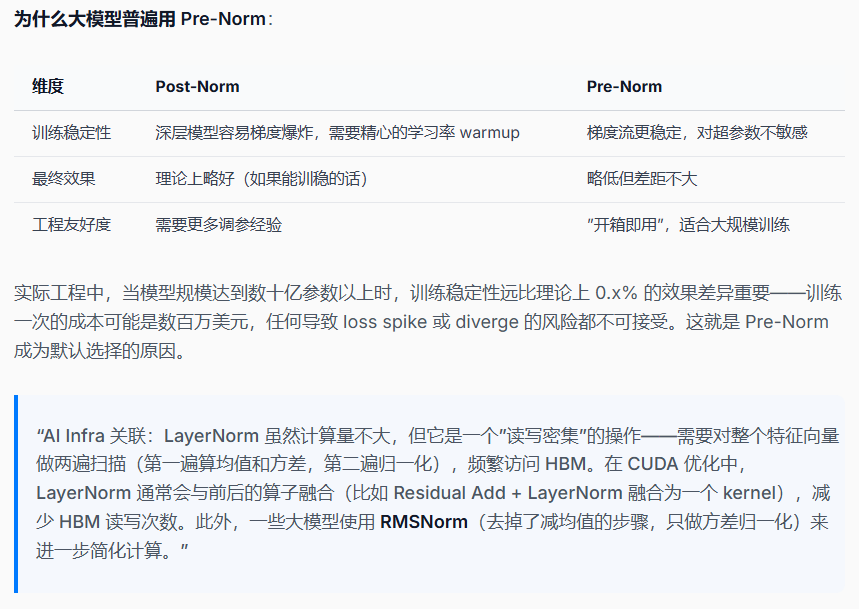
总结
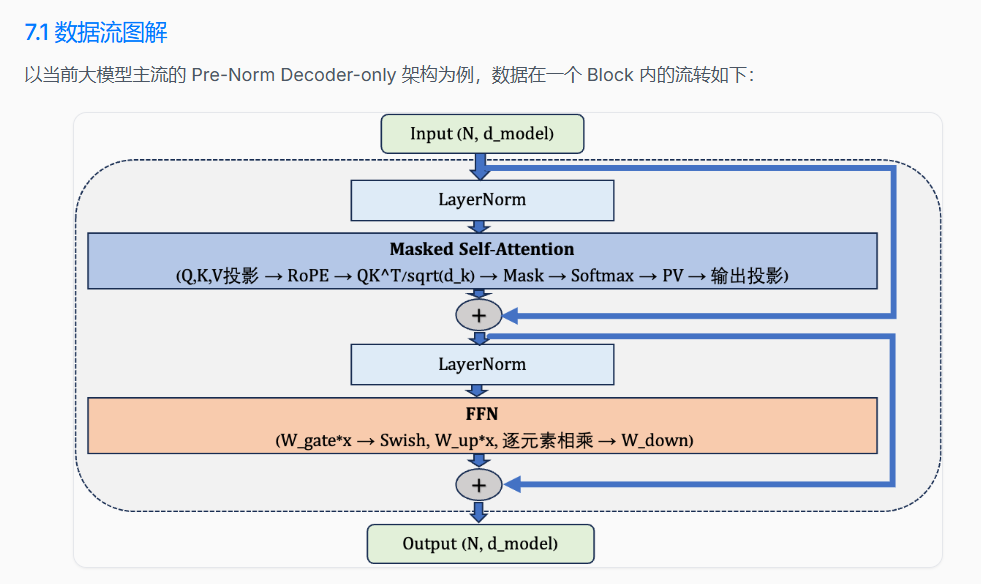
注意这里,位置编码是在输入后,先进入层归一化,然后进入掩码自注意力的时候,先升维,然后再模型的语义空间里面,进行位置编码的
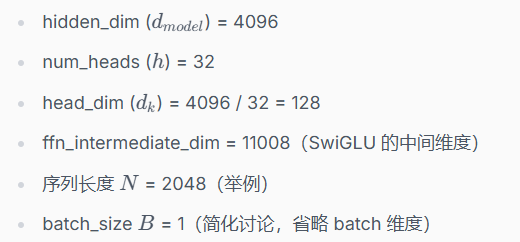
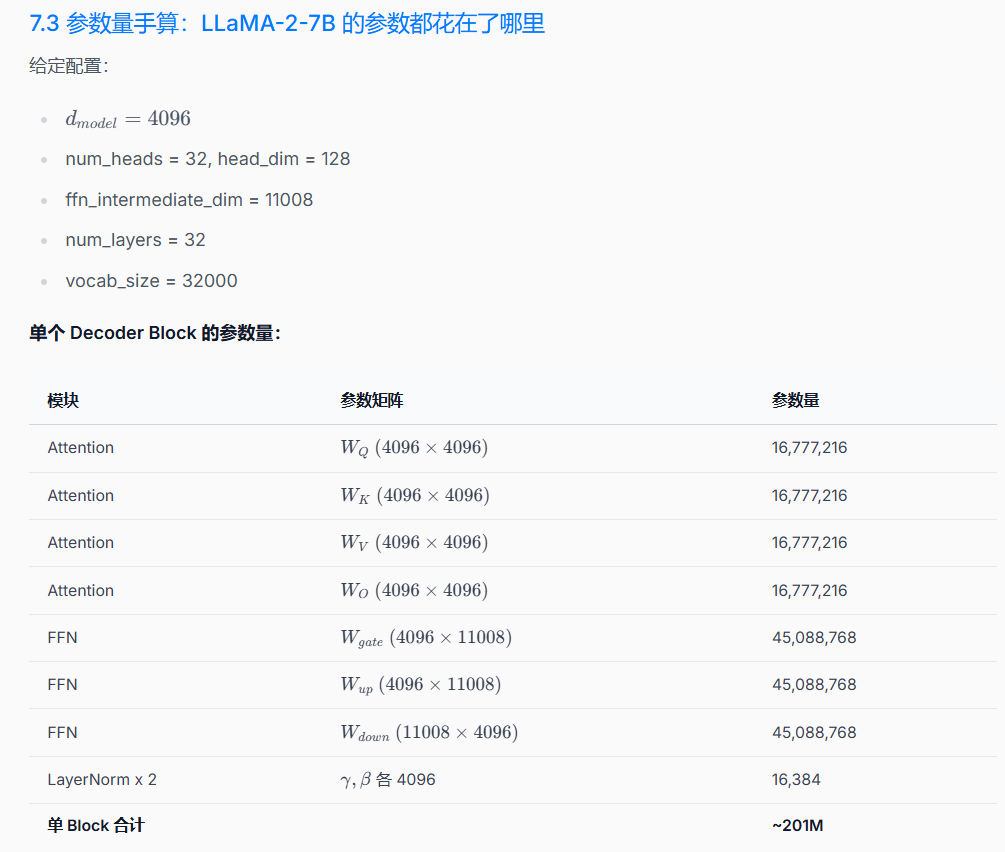
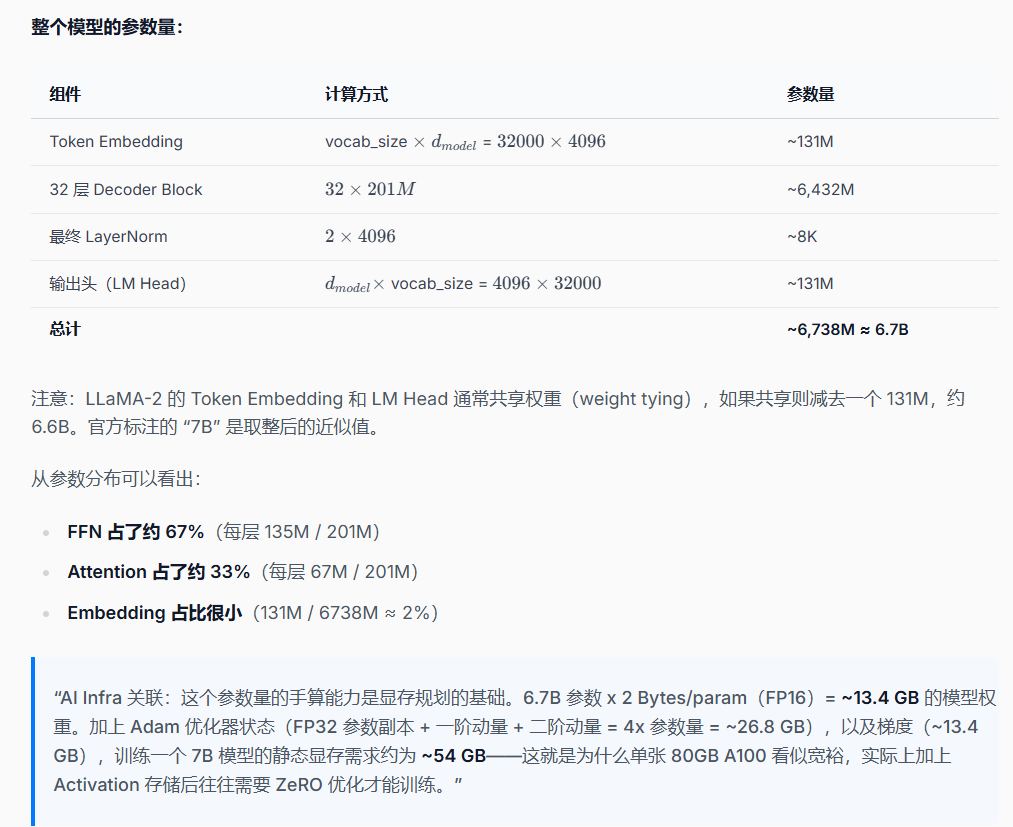
LLaMA-2-7B 为例,跟踪梯度
KVcache
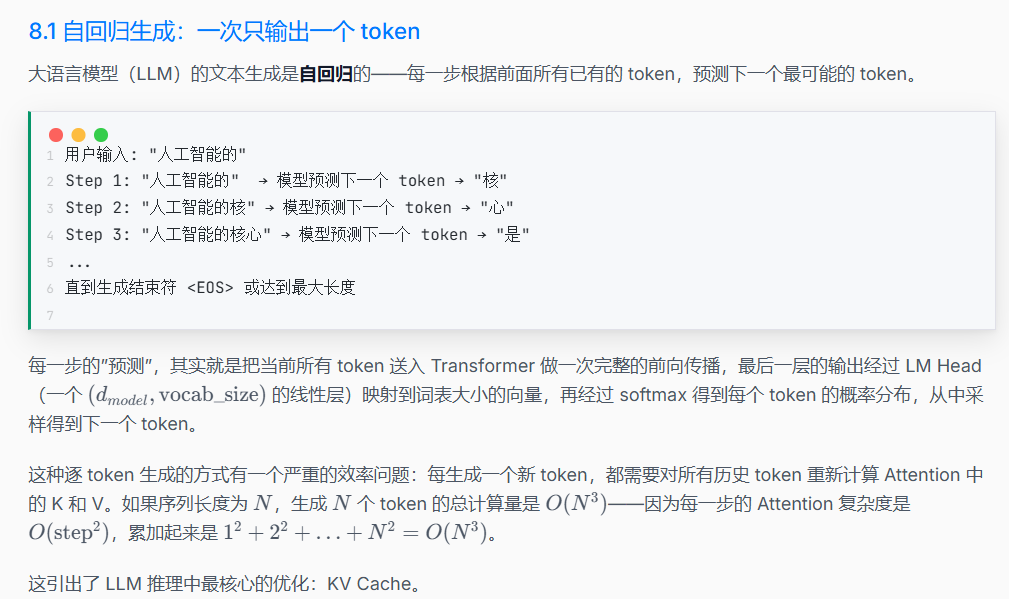
Prefill 和 Decode 两阶段
prefill: 预填充阶段:(初始KVcache)(计算瓶颈)
处理用户输入的整个 prompt。所有输入 token 可以并行计算,一次前向传播就生成所有 token 的 K、V,并缓存起来。
Prefill 阶段的矩阵运算 batch 维度大(NN 个 token 一起算),是典型的 **Compute Bound**(算力瓶颈)操作。它的耗时决定了 TTFT(Time To First Token,首 token 延迟)。
decode(解码):逐个生成输出 token。每步只有 1 个新 token 的 Q 去和所有历史 K 做 Attention,新 token 的 K、V 追加到缓存中(带宽瓶颈)
Decode 阶段每步只有 1 个 token 的计算量,矩阵乘法退化为矩阵-向量乘,GPU 的算力远远用不满,大部分时间花在从 HBM 搬运 KV Cache 数据上。这是典型的 Memory Bound(带宽瓶颈)操作。它的耗时决定了 TPOT(Time Per Output Token,每 token 延迟)。
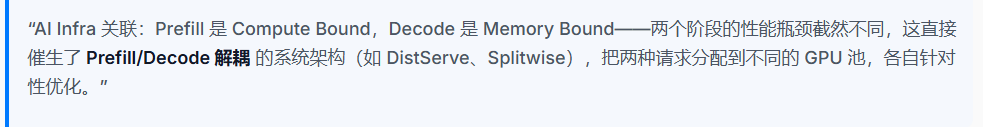
这就是PD分离
KVCache开销分析
KV Cache 的做法是:把每一层、每一步算出的 K 和 V 缓存在 GPU 显存中。Decode 时,新 token 只需要计算自己的 Q、K、V,然后把新的 K、V 追加到缓存中,Attention 计算使用完整的缓存 K、V。
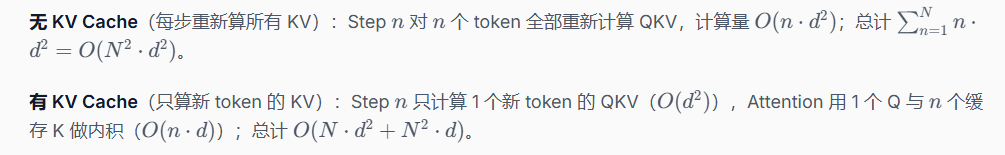
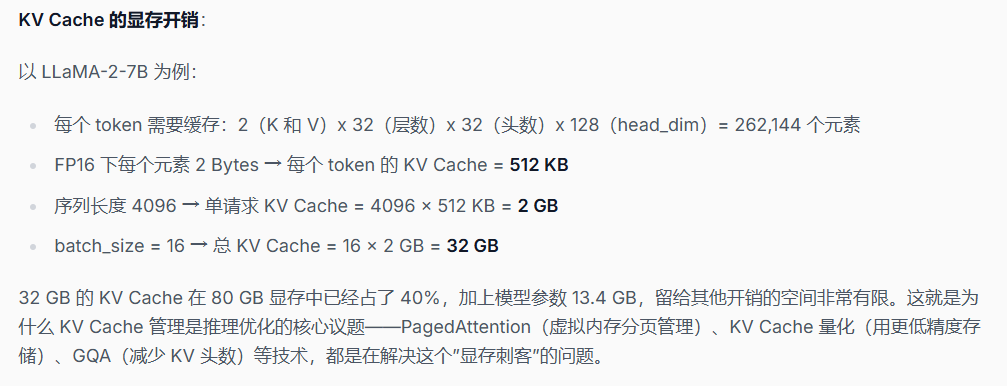
所以这里,为了减少推理的显存占用: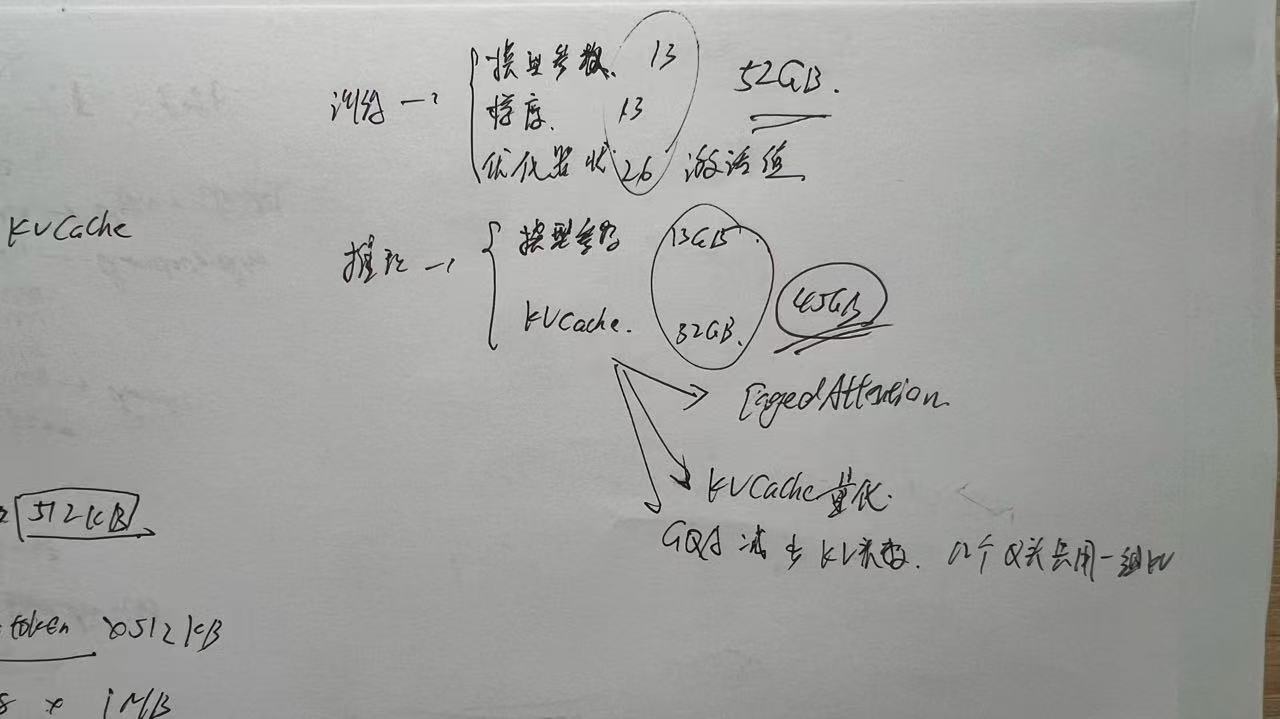
decoder-only 的不同
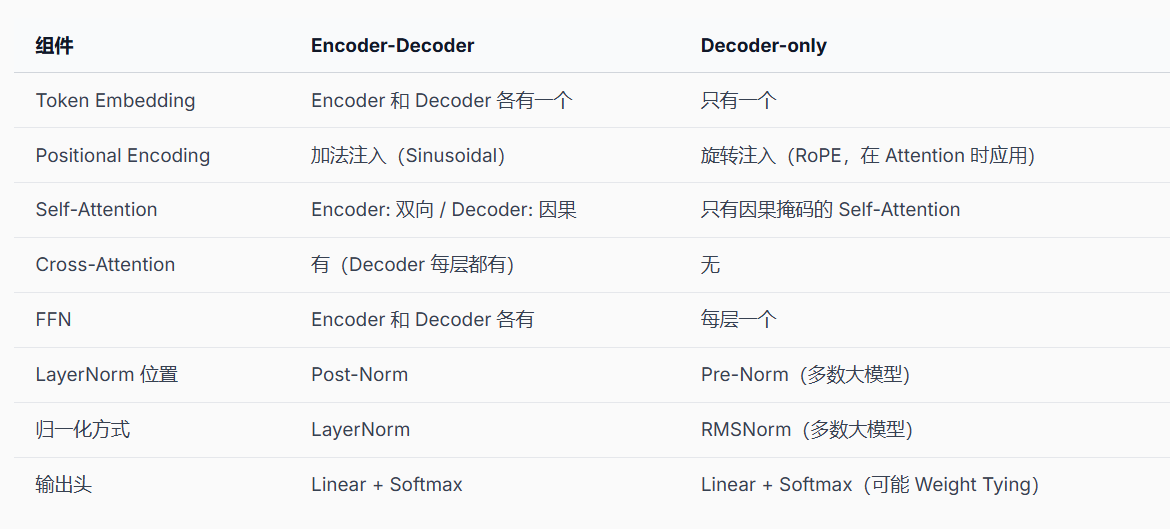
可以发现,Decoder-only最后是束搜索
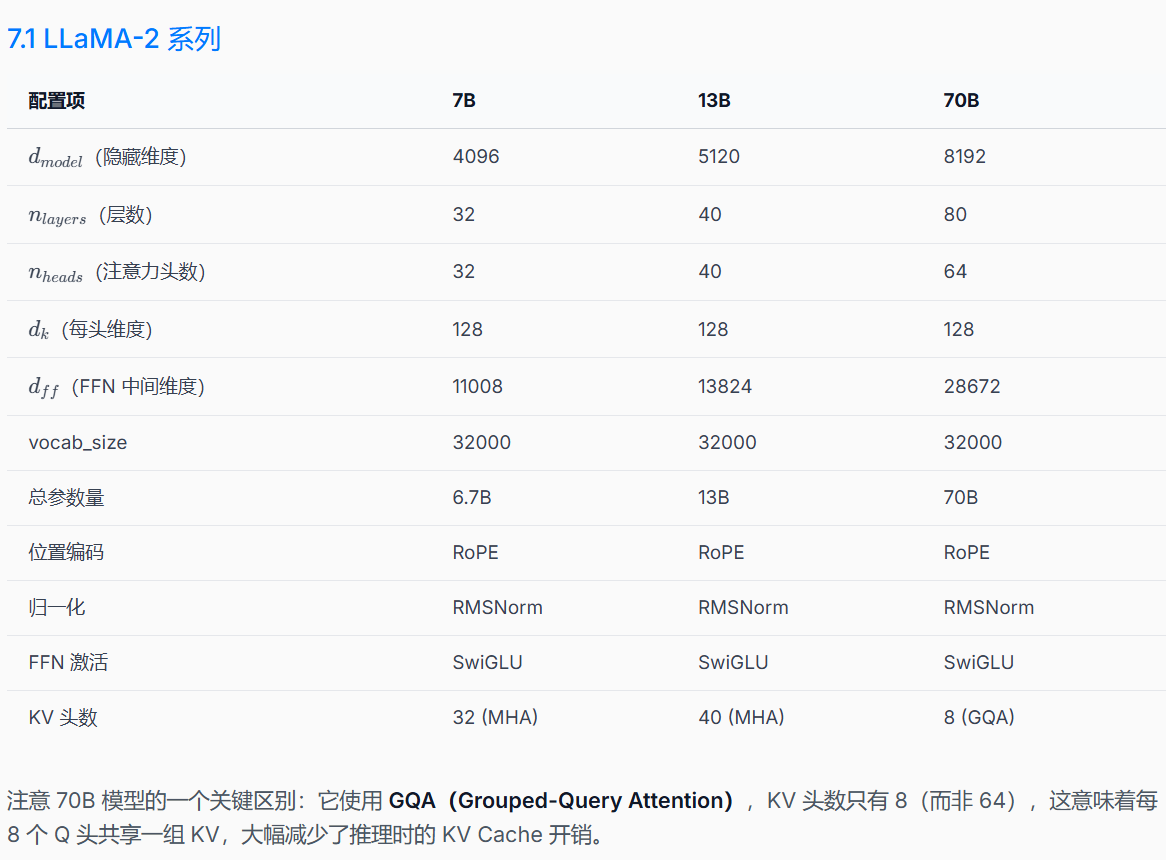
llama2
术语
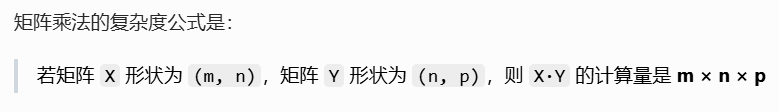
GEMM:矩阵乘法
矩阵乘法的计算复杂度:A(n,m) x B (m, d) 计算量O(nxmxd)
FlashAttention:
计算attention的缩放点积的点积的时候
标准实现:完整的NxN的注意力权重,写到HBM显存种
FlashAttention:通过tiling分块计算+online softmax, 让注意力矩阵全部在SRAM中,把访存从O(N2)降到O(N), 计算量没变,占用内存大幅减少
“Memory-aware”优化的核心思想
是通过分块,来触发缓存机制
参数量计算: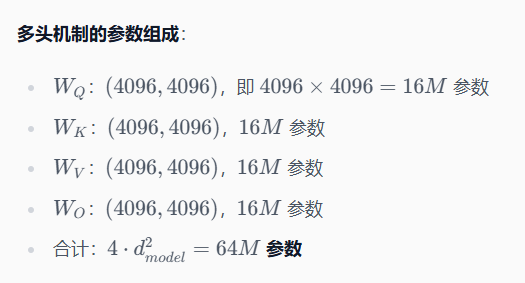
16M 是 4096x4096 / 10^6得来的
Megatron-LM 张量并行:
多头注意力
32 个头可以均匀分配到多张 GPU 上——比如 4 张卡各处理 8 个头,每张卡只需要 1/4 的 QKV 权重和计算量。这就是 Megatron-LM 张量并行的核心思想:沿着”头”的维度切分 Attention 模块。切分之后只需要一次 AllReduce 通信就能将各卡的部分结果汇总
Attention 头数的变种——MQA(Multi-Query Attention) 让所有头共享一组 KV、GQA(Grouped-Query Attention) 让若干头共享一组 KV——直接影响 KV Cache 的大小和张量并行的切分方式,是推理优化中的核心概念。
算子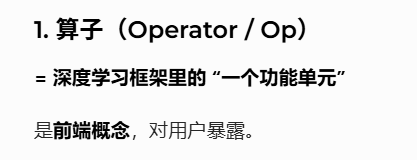
kernel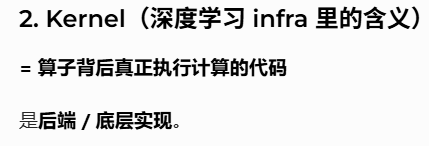
Weight Tying(权重共享)
说的是,词嵌入和词返回的权重是共享的