imx6ull linux 阻塞与非阻塞*
后期总结
我们在IO的时候,阻塞是一件好事,可以节省CPU资源
linux实现阻塞的底层机制,就是依赖等待队列。
主要有以下三种情况
- (
open指明了read以阻塞方式读)- 直接在驱动read里面挂入等待队列,就是我们read里面的阻塞
- 单路阻塞
- (
open指明了read以非阻塞方式读)- 驱动read里面就要支持即时返回
- 若
应用层就想要即时返回,根本不想要阻塞,不考虑性能,完全非阻塞- while循环,主动轮询,占用CPU
若应用层还想要阻塞来优化:- 在select, poll的系统调用里面挂入等待队列,read为非阻塞,阻塞在系统调用中。
- 多路阻塞
linux 阻塞与非阻塞
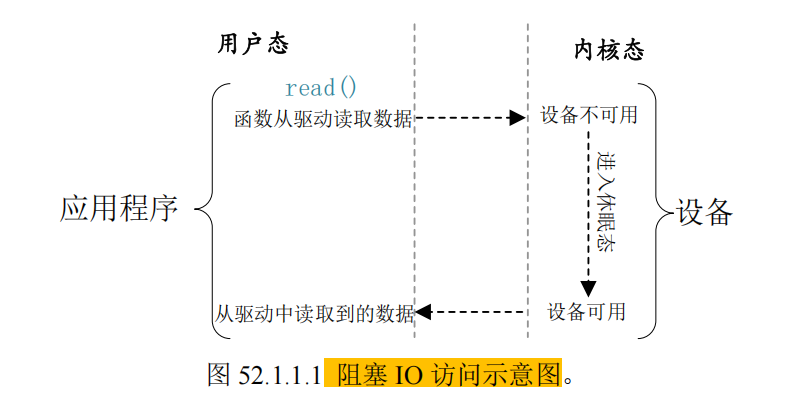
这里的IO指的是用户态程序通过系统调用和内核态的驱动程序之间的输入输出。
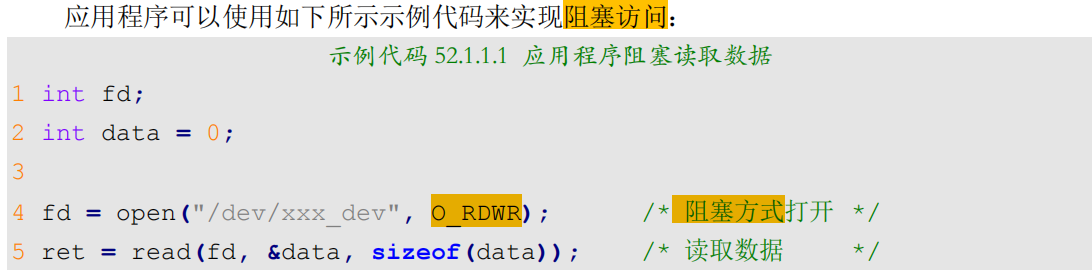
- 阻塞IO:
- 没获取到需要的资源
- 进程进入阻塞状态,让出cpu,直到获得设备资源为止
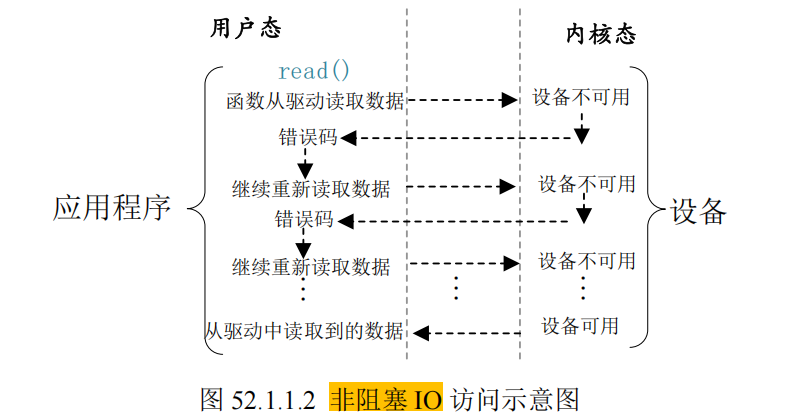
- 非阻塞IO:
- 没获取到需要的资源,用户态进程不会进入阻塞状态
- 用户态的IO函数,直接返回
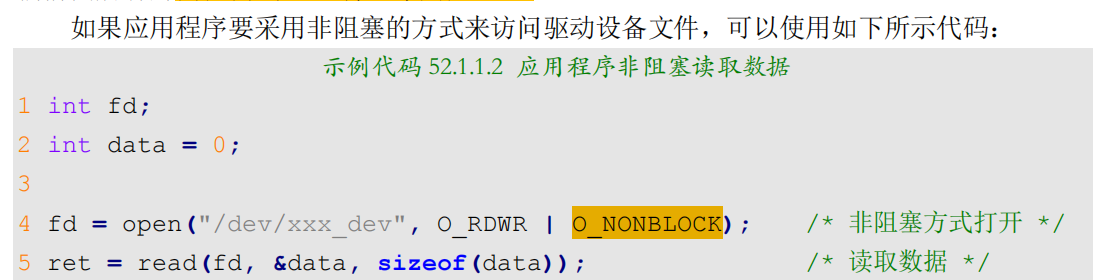
注意:
这里的阻塞,需要驱动程序配合,如果配合,还是阻塞不了.
linux实现阻塞/非阻塞IO的几个机制
等待队列 wait queue(阻塞的底层实现机制)
阻塞访问的最大好处就是省资源,因为进程进入阻塞状态,让出了cpu。
但是当设备文件可以操作的时候,必须要唤醒进程(一般在中断函数中完成唤醒工作)
所以,linux内核提供了等待队列机制,来实现阻塞进程的唤醒工作,主要工作就两个:
- 进程进入内核态,发现资源没准备号,主动休眠等待
- 在中断中,资源准备好,唤醒休眠的进程。
等待队列定义在include/linux/wait.h中
等待队列 API 梳理
- A. 核心数据结构
- B. 初始化 (Initialization)
- C. 入队与阻塞 (Wait Events) —— 最常用
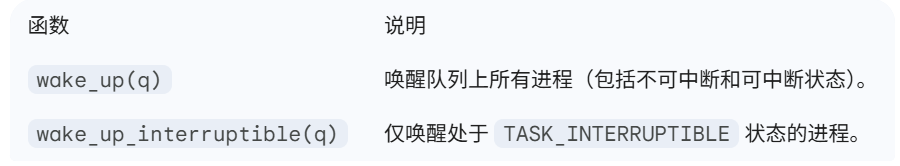
- D. 唤醒 (Wake Up)

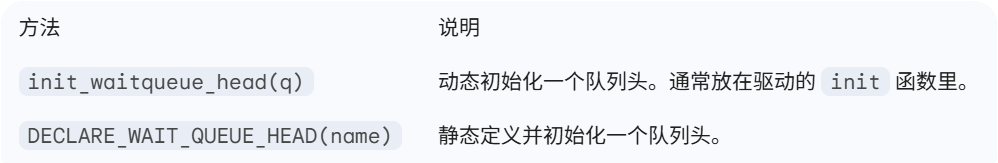
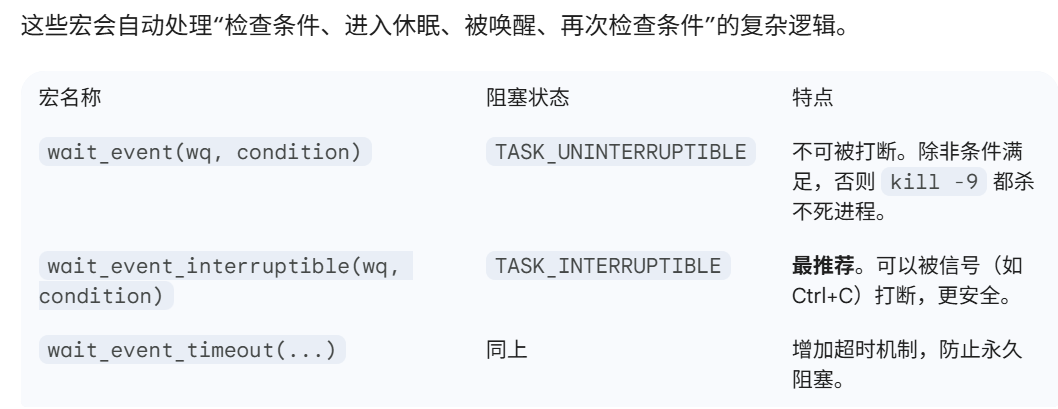
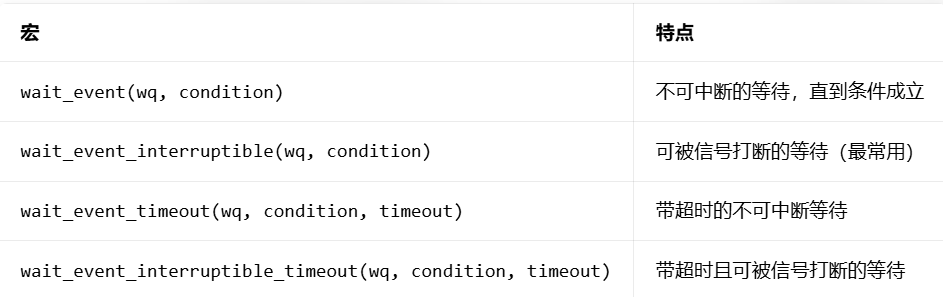
demo
1. 设备体结构定义
struct timer_dev { |
2. 在 init 函数中初始化
static int __init timer_init(void) { |
3. 在 read 函数中实现阻塞
static ssize_t timer_read(struct file *filp, char __user *buf, size_t cnt, loff_t *offt) { |
两种阻塞api写法
注:wait_event本质上是宏,下面两段等待阻塞的方法是一样的:
DECLARE_WAITQUEUE(wait, current); |
等同于
ret = wait_event_interruptible(dev->r_wait, |
4. 在中断/定时器处理函数中唤醒
void timer_function(unsigned long arg) { |
- 不要在中断里调用 wait_event:中断处理函数(Top Half)绝不能休眠。
- 条件检查要严谨:wait_event 醒来后会重新检查 condition。如果多个进程在等同一个队列,其中一个抢先处理了数据并把 condition 改回了 0,其他进程会继续睡回去。
- 信号处理:
wait_event_interruptible返回非 0 值表示是被信号(信号量、Ctrl+C等)意外叫醒的,驱动应该及时返回并处理这个异常
轮询(系统调用阻塞,等待唤醒 == 监听)
如果用户进程以非阻塞方式访问设备,设备驱动程序就要提供非阻塞的处理方式
前面我们说非阻塞,就是直接返回嘛,那么就是轮询了
poll, epoll, select可以用于处理轮询
应用程序通过 select、epoll 或 poll 函数来查询设备是否可以操作,如果可以操作的话就从设备读取或者向设备写入数据
原来我们while read,是不停的读,这里他是不停的查询是否可读。相当于不停的读是否可读的标志位。
当应用程序调用 select、epoll 或 poll 函数的时候设备驱动程序中的 poll 函数就会执行,因此需要在设备驱动程序中编写 poll 函数
所以,用户态的select,epoll,poll, 都是靠内核态的poll函数来实现的。
用户态的轮询api
select
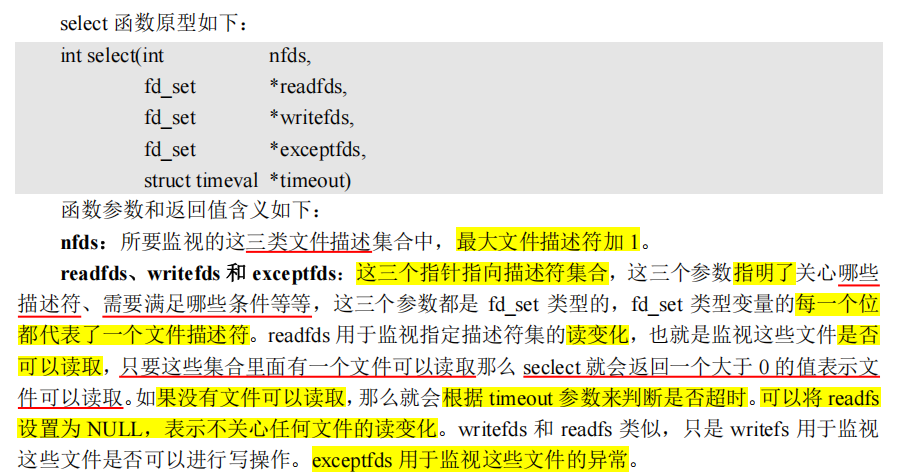
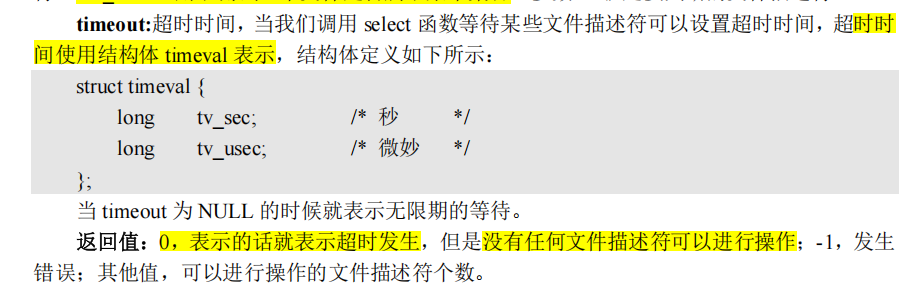
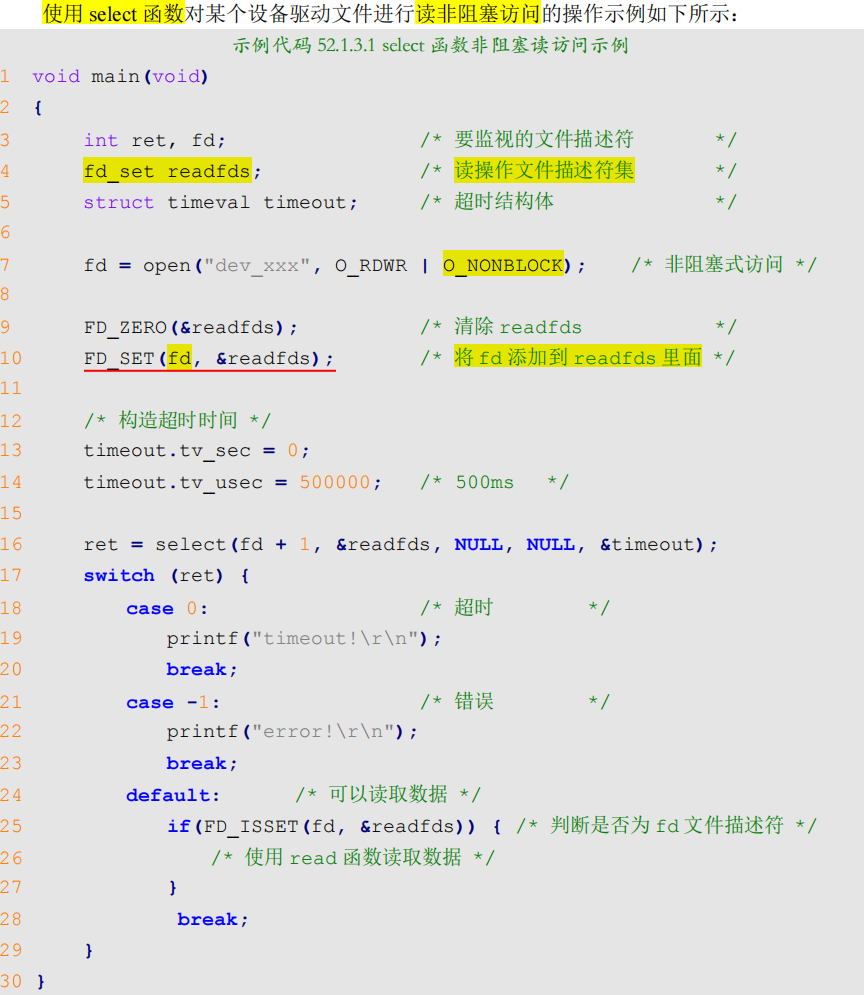
可以看到,select其实可以通过超时时间的设置,来实现阻塞/非阻塞的轮询
我们这里说的轮询,本质上是基于等待队列机制的唤醒机制,是阻塞等待 + 批量检查,
不是我们用while循环的主动轮询
select底层实现机制
下面来看一下select的底层实现机制。
用户态代码
fd_set readfds; |
场景设定
- 监听:
读集合:设备 A(fd_a)、设备 B(fd_b)写集合:设备 C(fd_c)异常集合:无
- 超时:1 秒
- 实际唤醒:300ms 时,设备 A 可读
步骤 1:用户态→内核态,参数拷贝
select是系统调用,会触发sys_select内核函数;- 内核把用户态的 fd_set(监听的 fd 集合)、timeout 拷贝到内核空间(避免用户态篡改);
- 内核会先做合法性检查:fd 是否有效、是否超出进程的 fd 限制(默认 1024)。
步骤 2:初始化 “等待队列”,挂起当前进程
这是
select不 “轮询” 的核心:
- 内核为当前进程创建一个
struct wait_queue_entry(等待队列项); - 遍历用户监听的所有 fd(这里是 fd),把这个等待队列项挂到每个 fd 对应的等待队列上;
- 比如
串口 fd的等待队列,由串口驱动维护,当串口有数据时,驱动会唤醒这个队列上的所有进程;
- 比如
- 内核修改当前进程的状态为 TASK_INTERRUPTIBLE(可中断睡眠),并调用 schedule() 让出 CPU;
- 此时进程不再占用 CPU,直到被唤醒。
步骤 3:进程睡眠,等待唤醒
进程睡眠期间,CPU 去执行其他任务,直到以下任一事件发生:
- 有fd 就绪:比如串口收到数据,驱动会调用 wake_up() 唤醒对应 fd 的等待队列,当前进程被唤醒;
- 超时:内核有一个定时器,超时时间到后,定时器触发,唤醒当前进程;
- 信号打断:比如进程收到 SIGINT 信号,也会被唤醒。
步骤 4:进程被唤醒,检查 fd 状态
进程被唤醒后,内核会做两件事:
- 把进程的这个等待队列项从所有 fd 的等待队列中移除(避免重复唤醒);
- 前面我们一个进程的等待队列项,被加入到两个读,一个写的对应的驱动的等待队列里面了,现在要全部清除掉,防止被重复唤醒
- 一次性遍历所有监听的 fd,检查每个 fd 的状态(可读 / 可写 / 异常):
- 内核通过 fd 对应的 file_operations 结构体里的 poll 函数(比如串口驱动的 uart_poll),获取
fd的就绪状态; - 把就绪的 fd 标记到 fd_set 中。
- 内核通过 fd 对应的 file_operations 结构体里的 poll 函数(比如串口驱动的 uart_poll),获取
步骤 5:计算超时剩余时间(可选)
此时仍在内核态
如果是 “超时唤醒”,内核会更新 timeout 结构体,把剩余时间写回用户态(比如原本 1 秒超时,300ms 就被唤醒,用户态能拿到剩余的 700ms);如果是 “fd 就绪唤醒”,
超时时间会被清空。
步骤 6:内核态→用户态,结果返回
- 内核把更新后的
fd_set(标记了就绪的 fd)、返回值(就绪 fd 数量 / 0/-1)拷贝回用户态; - 用户态代码从 select 返回,继续执行后续逻辑(比如 判断哪个可读,read 读取数据)
- 用户态代码继续执行,通过
FD_ISSET(fd_a, &readfds)检查,发现 fd_a 可读,于是调用read(fd_a, ...)读取数据
- 用户态代码继续执行,通过
select的缺陷: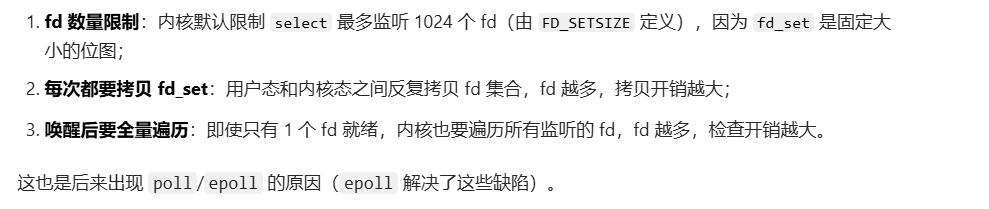
poll
因为前面分析的select能够监视的fs的数量最大是1024,而且要遍历检查,所以开销太大。
因此,有了poll函数。
poll函数和select本质上没有太大的差别
poll函数没有最大文件描述符的限制
应用层的poll函数原型如下:
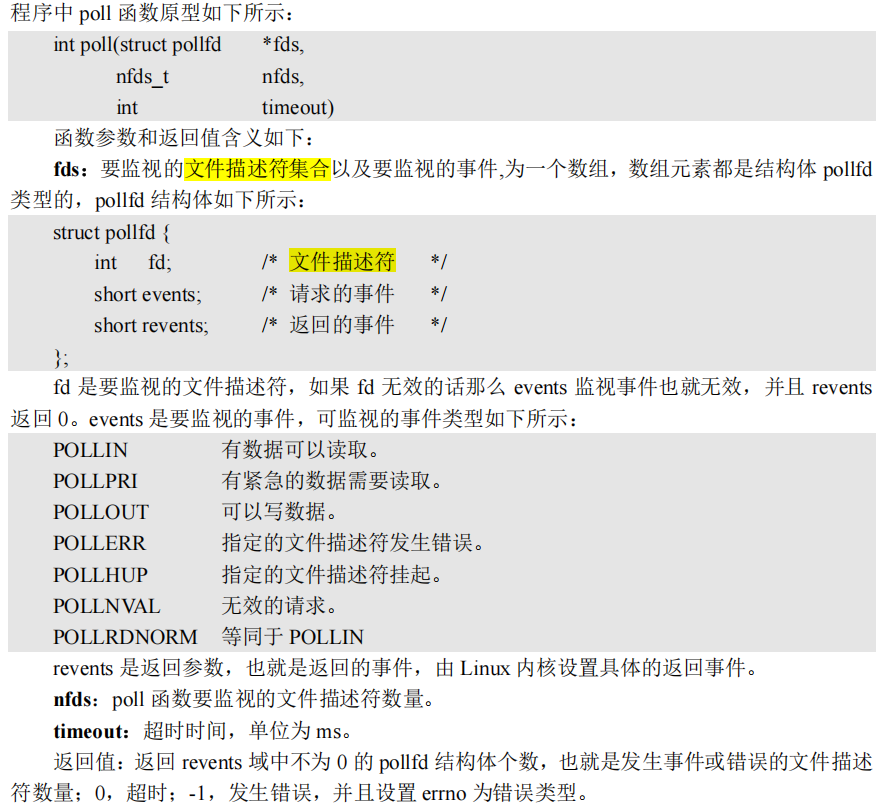
使用示例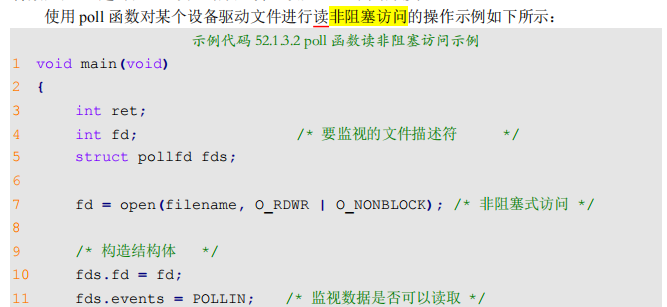
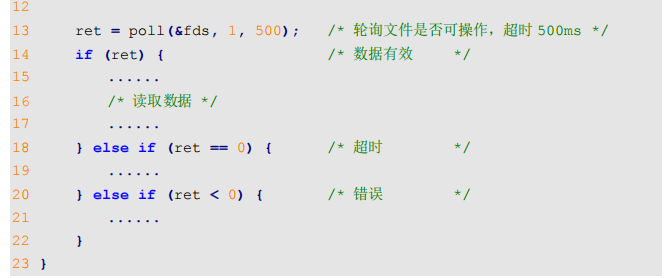
我们这里的 “非阻塞访问”,指的是 read 操作本身不阻塞,而不是 poll 不阻塞
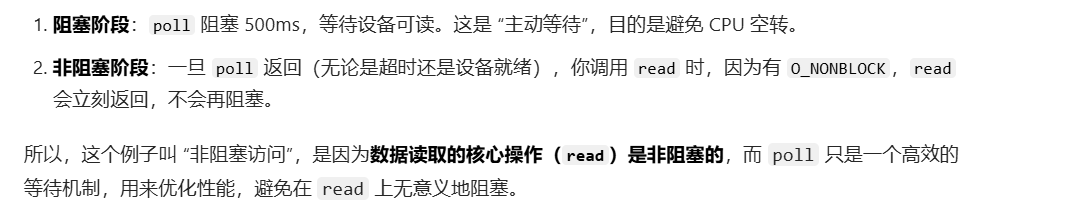
使用
poll实现批量监听
poll 的
- 第一个参数是
struct pollfd *fds,它是一个数组指针,而不是单个结构体。 - 第二个参数
nfds就是这个数组的长度。所以,如果你要监听多个 fd,只需要定义一个 struct pollfd 数组,把所有要监听的 fd 填进去,然后把数组首地址和长度传给 poll 即可:
struct pollfd fds[3]; // 监听3个fd |
poll 返回后,你遍历这个数组,检查每个元素的 revents 字段,就能知道哪个 fd 发生了什么事件。
各种情况对比
目前,我们学习了等待队列,轮询的select,以及他的升级版本poll。
这里要说明一点,阻塞是一件好事情,因为可以休眠等待,不占用cpu。我们的目的就是用上阻塞来在IO的时候节约资源。
而阻塞本质上全部依赖等待队列的机制
- 1.我们在open时以阻塞打开,那么在读取的时候,就直接在read里面wait_event实现阻塞就行了
- 注意,这个的弊端是单路阻塞,进程因为要读就阻塞住了,也不能写。
- 我们在open时以非阻塞方式打开,那么在读取的时候:
- 2.如果应用层不需要阻塞
- 直接read,驱动read即时返回即可。
- 3.如果应用层仍然需要阻塞:
- 就需要依赖poll/select,额外加入一层中间件,用于阻塞,监听。
- 2.如果应用层不需要阻塞
下面具体来分析一下这三种情况
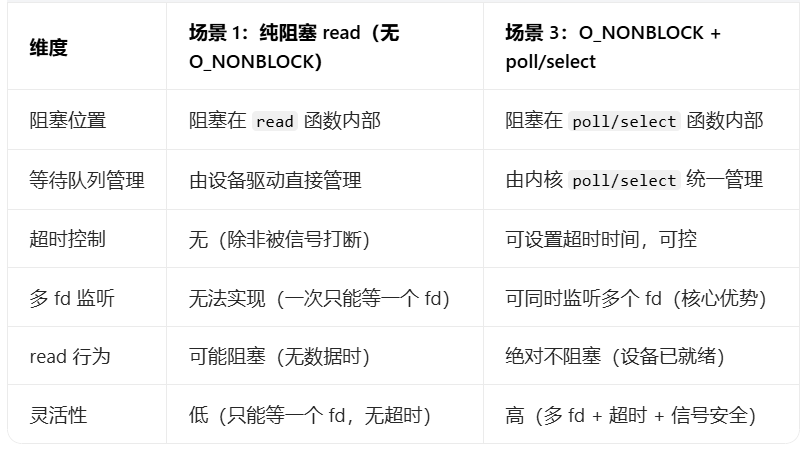
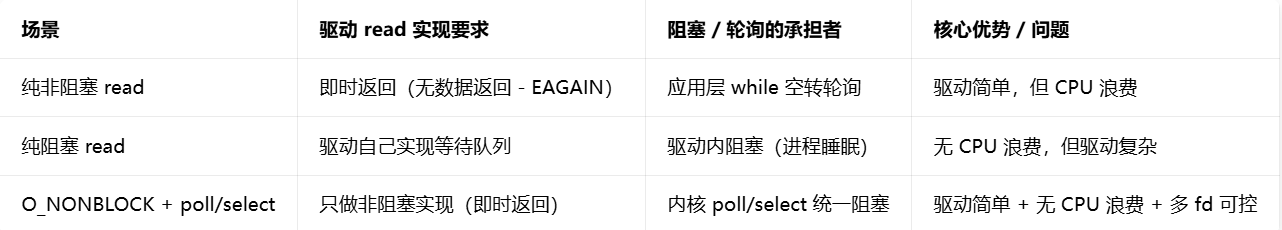
当我们在读设备数据的时候,使用open 以阻塞/非阻塞方式打开,然后read。一般有3中使用情况:
- 仅
read指定O_NONBLOCK(纯非阻塞读,while 空转)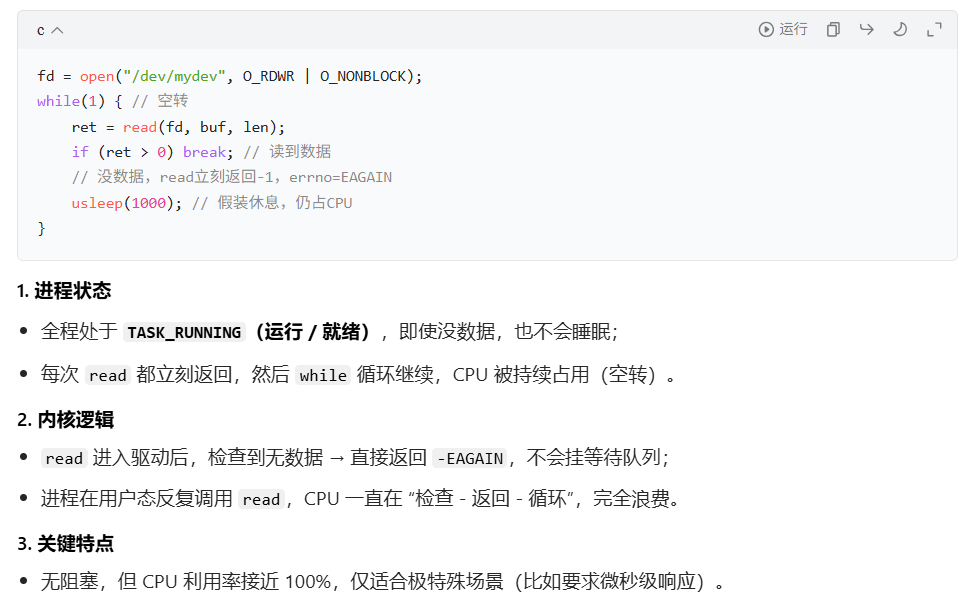
这里就是驱动里面的read不包含等待机制,即时返回。
- 仅
read不指定O_NONBLOCK(纯阻塞读)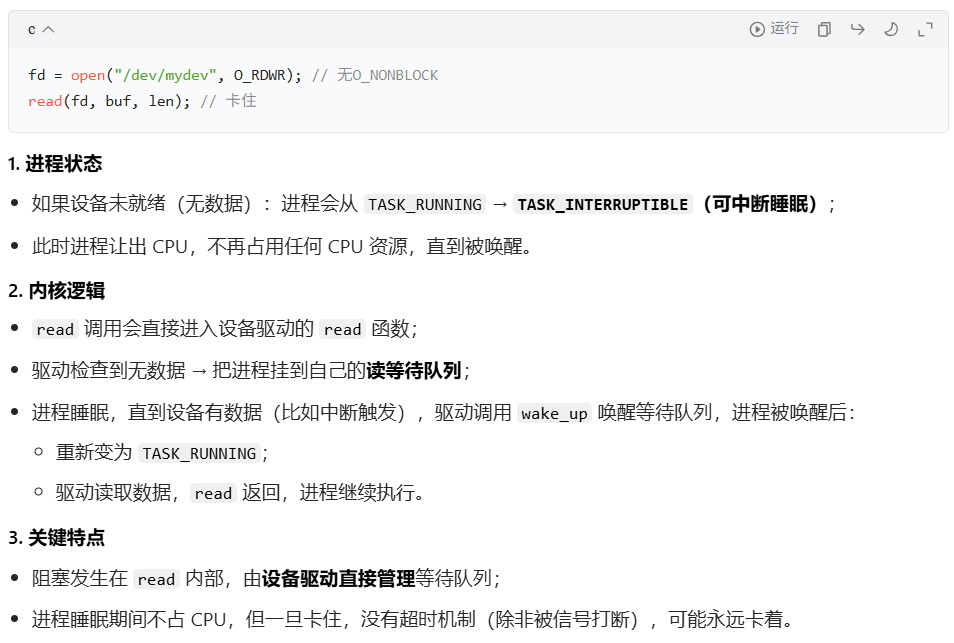
所以这个的本质,是驱动在read里面利用等待机制来替你实现的阻塞读。
O_NONBLOCK+poll/select(非阻塞读 + 多路复用)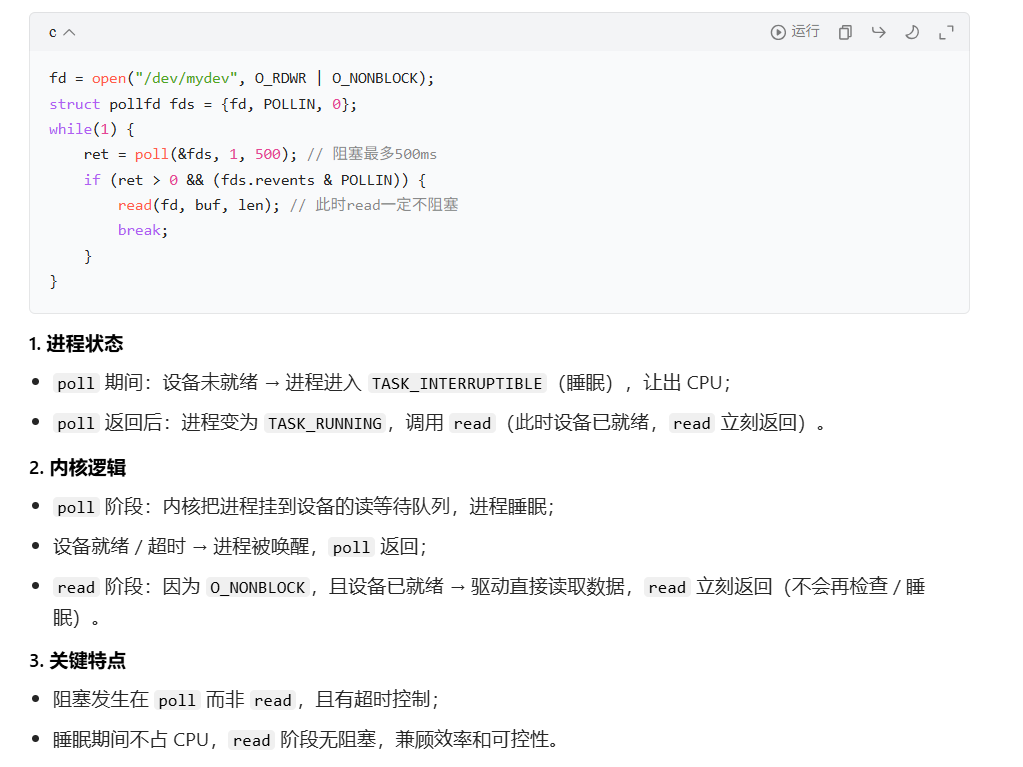
这里就是,read指定非阻塞,即时返回,把等待机制单独抽象出来放到poll里面来实现。
纯阻塞read 和 非阻塞read + 阻塞poll 对比
- 三种阻塞/非阻塞IO方式对比
为什么select和poll效率低下
虽然两者都能批量监听,但它们的底层实现有两个共同的效率瓶颈:
- 每次调用都要全量拷贝
- select:把整个 fd_set 位图从用户态拷贝到内核态。
- poll:把整个 struct pollfd 数组从用户态拷贝到内核态。
- 监听的 fd 越多,拷贝的数据量就越大,开销越高。
- 每次返回都要全量遍历
- 当有事件发生、进程被唤醒后,内核都要遍历所有你监听的 fd,逐个检查它们的状态。
- 即使只有 1 个 fd 就绪,也要遍历全部 N 个 fd,时间复杂度是 O (N)。
- 当 N 很大(比如几千个)时,这个遍历开销就会变得非常大。
这就是为什么当监听的 fd 数量很多时,select 和 poll 的效率会急剧下降,而 epoll 能高效处理大量连接的原因 ——epoll 在内核中维护了一个就绪列表,只返回活跃的 fd,避免了全量遍历。
epoll
为了解决select, poll的全量拷贝和返回遍历的问题,提出了epoll,epoll 就是为处理大并发而准备的,一般常常在网络编程中使用 epoll 函数
使用
应用层的使用epoll的api如下
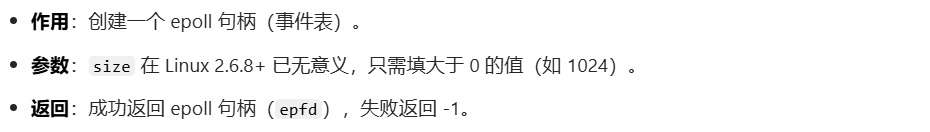
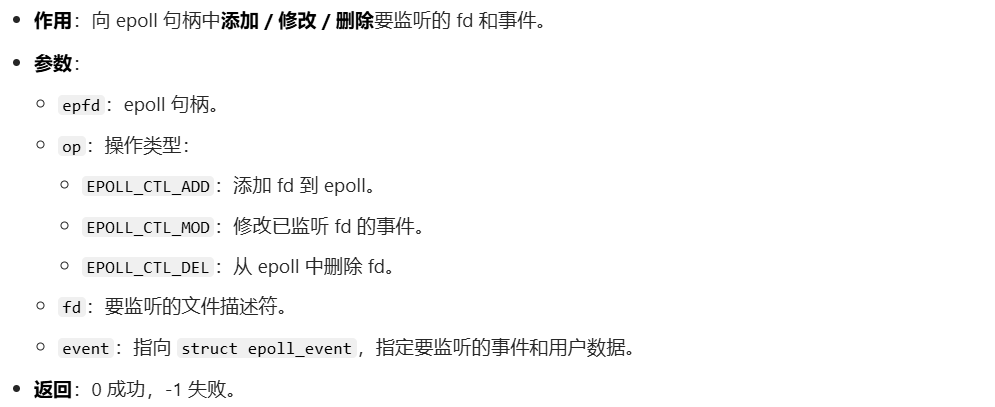
int epoll_create(int size)int epoll_ctl(int epfd, int op, int fd, struct epoll_event *event)int epoll_wait(int epfd, struct epoll_event *events, int maxevents, int timeout)
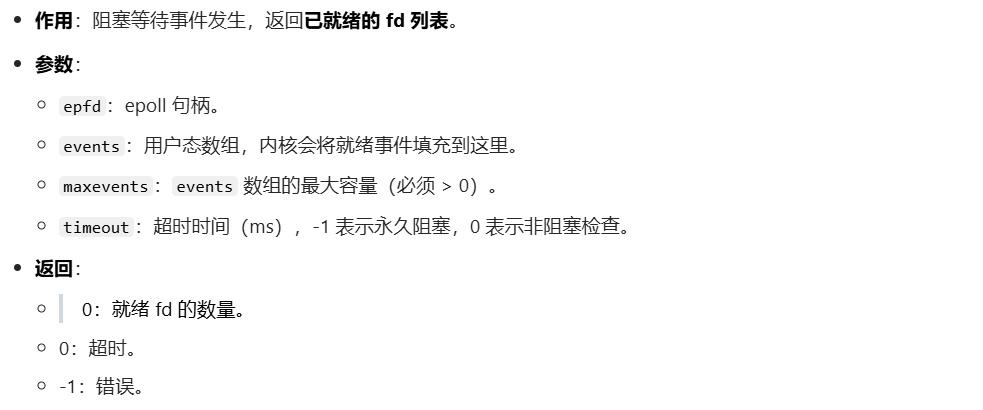
关键结构体struct epoll_event
struct epoll_event { |
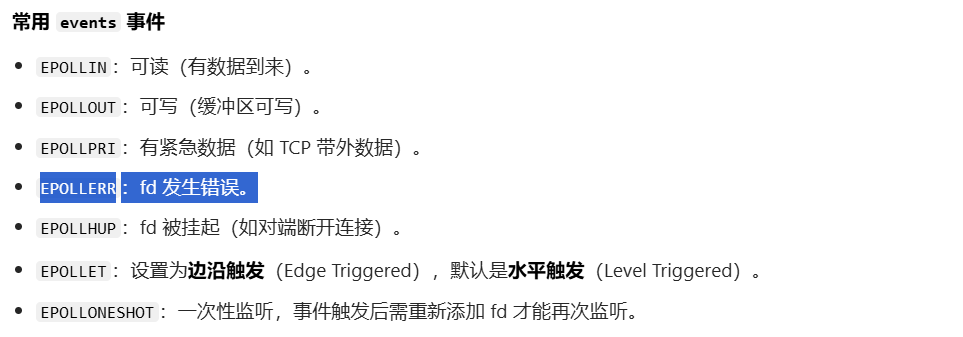
示例代码:
|
Linux 驱动下的 poll 操作函数
见面我们将的都是应用层用的对应的系统调用
对应底层,这个实际的阻塞,等待队列,肯定是需要驱动自己支持才能使用的。
驱动poll函数核心定位
- 触发时机:
- 当应用层调用
select/poll/epoll等多路复用函数时,内核会回调驱动 file_operations 中注册的.poll函数。
- 当应用层调用
- 核心职责:
- 告诉内核 “这个设备对应的等待队列头” 是什么(通过 poll_wait)。
- 向应用层返回设备当前的就绪状态(如可读、可写、错误等)。
- 本质:驱动的 .poll 函数是内核和设备驱动之间的 “桥梁”,让多路复用机制能统一管理所有设备的等待队列。
驱动poll函数原型
unsigned int (*poll)(struct file *filp, struct poll_table_struct *wait); |
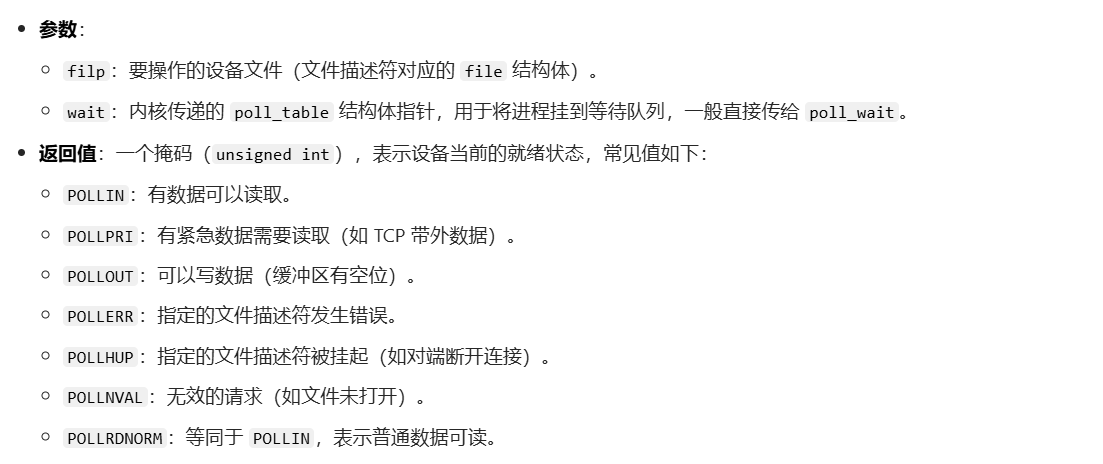
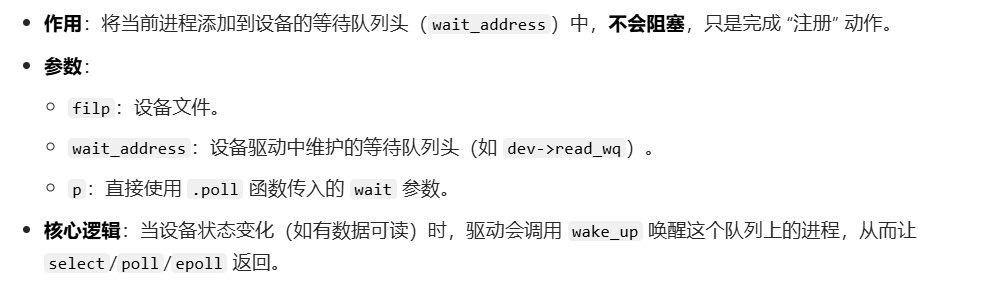
关键辅助函数 poll_wait
void poll_wait(struct file *filp, wait_queue_head_t *wait_address, poll_table *p); |
模板
// 假设设备结构体中维护了读/写等待队列头 |
.poll里面有两个poll_wait, 整个.poll仅仅只是把进程加入到相应的队列里面,然后再判断一下当前是否有数据,并返回,就是返回到poll系列系统调用中,根据返回值来判断要不要真的进入阻塞休眠,如果返回发现有数据,那我们就不进入休眠
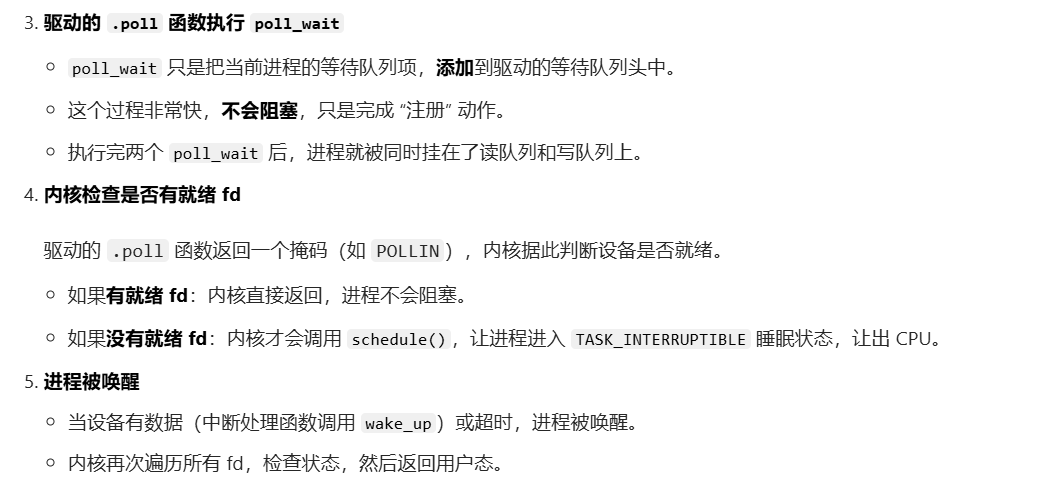
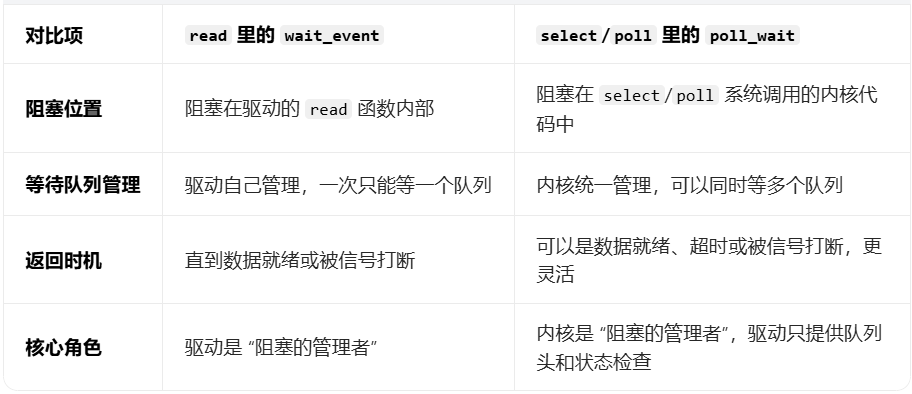
read里面wait_event 和 select/poll中的poll_wait 对比
如果我在应用层open的时候指定,阻塞方式read,那么就要在read里面wait_event实现阻塞。
如果我在应用层open的时候指定,非阻塞方式read, 那么我就要在read里面即时返回,但是实际上我们的应用层还是还是想要数据,又不可能直接用while来主动轮询,所以只能用select, poll,来外置一个等待队列机制。
可以看到,
驱动的read里面的wait_event是真的利用等待队列机制库,来让自己的进程进入休眠了。
而select/poll是在系统调用里面,等.poll返回后,才判断是否调用等待队列的机制库,让自己的进程进入休眠。
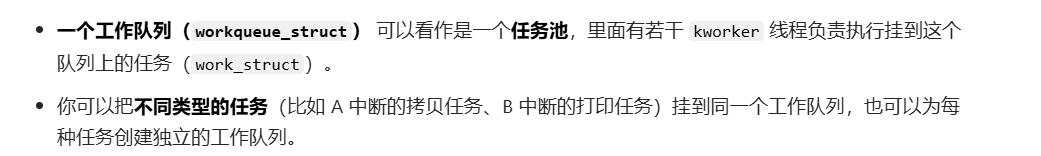
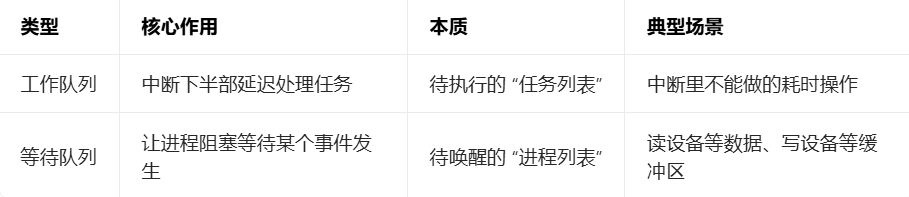
工作队列 vs 等待队列
这两个不是一个维度的东西:
- 工作队列:
- 中断下半部的一种机制,表示一个通道,一个告示牌
- 等待队列:
- 是一个进程链表,把进程作为队列项,加入队列
- 一个队列表示一种等待事件,对应一种唤醒条件
等待队列详细补充:
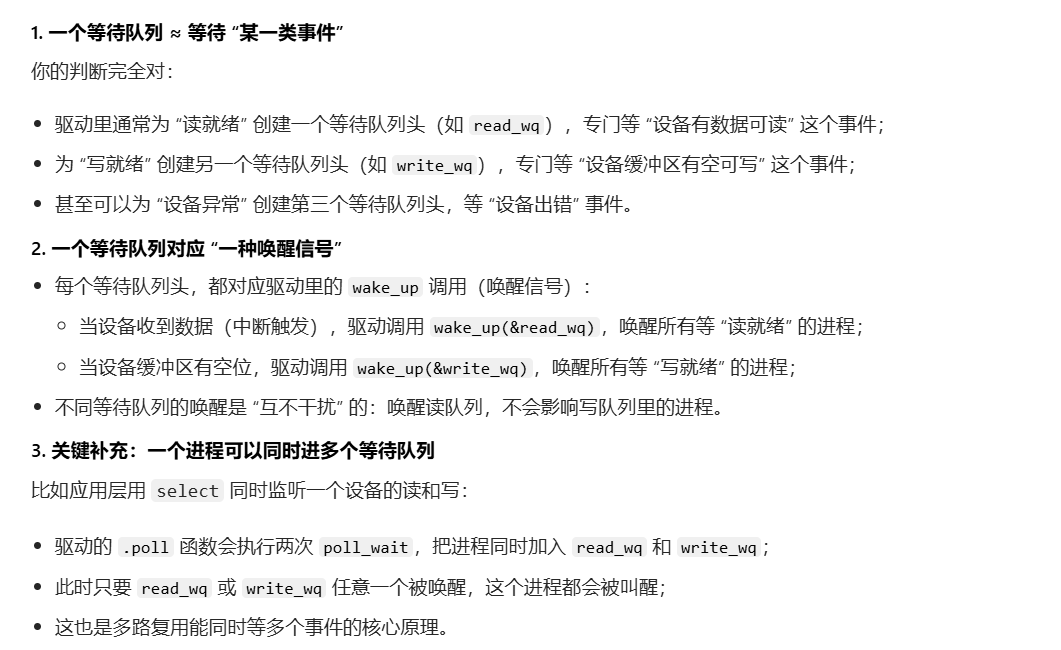
工作队列:
工作队列其实就是工作流,任务栏, A中断下半部,就可以把A任务挂到自己创建的专属队列,B中断下半部也可以把B的任务挂到这个专属队列,如果想要自己分开工作流,就可以创建两个工作队列具体可以参考linux中断那一节里面的工作队列的方案3