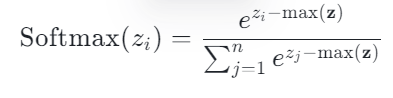GPU内存模型 首先,GPU是单任务,多数据的类型(同一套代码指令,输入不同的数据)
所以,你编写一个核函数,这个核函数会被执行很多次,输入不同的数据,这个一个核函数的执行,就是一个thread。
编程架构:
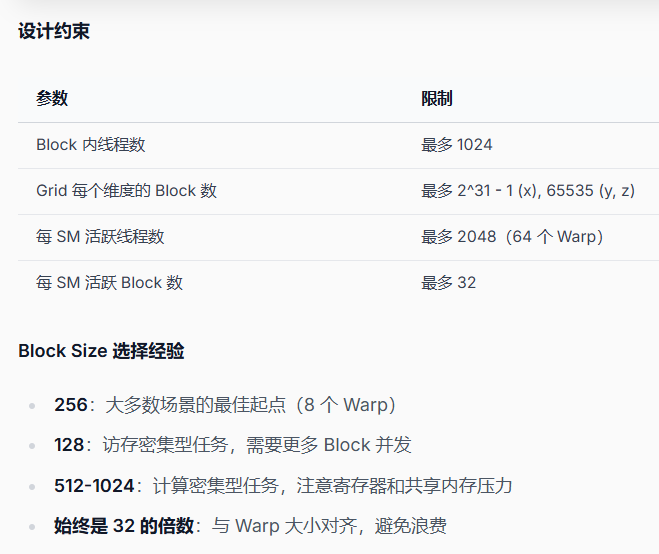
block之间相互独立,thread是最小执行单元,warp是一些thread的打包,是最小调度单元
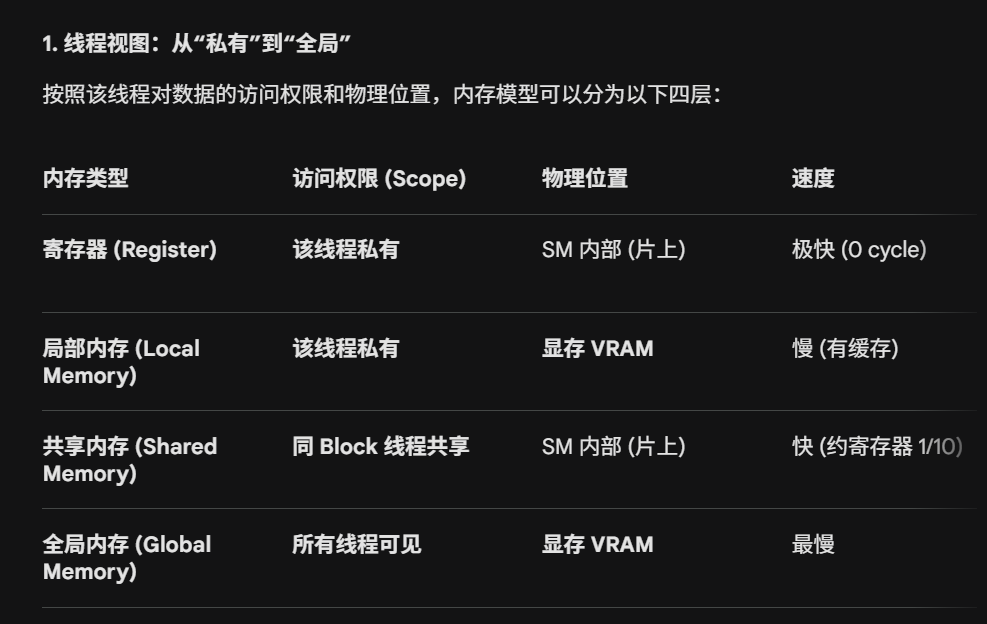
一个thread,他的内存模型是:
一个thread, 由:
寄存器
局部内存 (Local Memory)
存储内容: 1. 寄存器溢出 (Spilling): 当你写的代码太复杂,寄存器不够用了,编译器会把多出来的变量偷偷挪到这里。 2. 大数组: 在线程内部定义的、无法完全放入寄存器的局部数组。注意: 它是逻辑局部,物理全局 。虽然名字带 Local,但它跑在显存(HBM/VRAM)上,访问它和访问 Global Memory 一样慢。其实是充当栈区的补充
共享内存
全局内存
全局区,数据段 ,rwdata
是用来输入数据,输出结果的
常量内存
纹理/表面内存
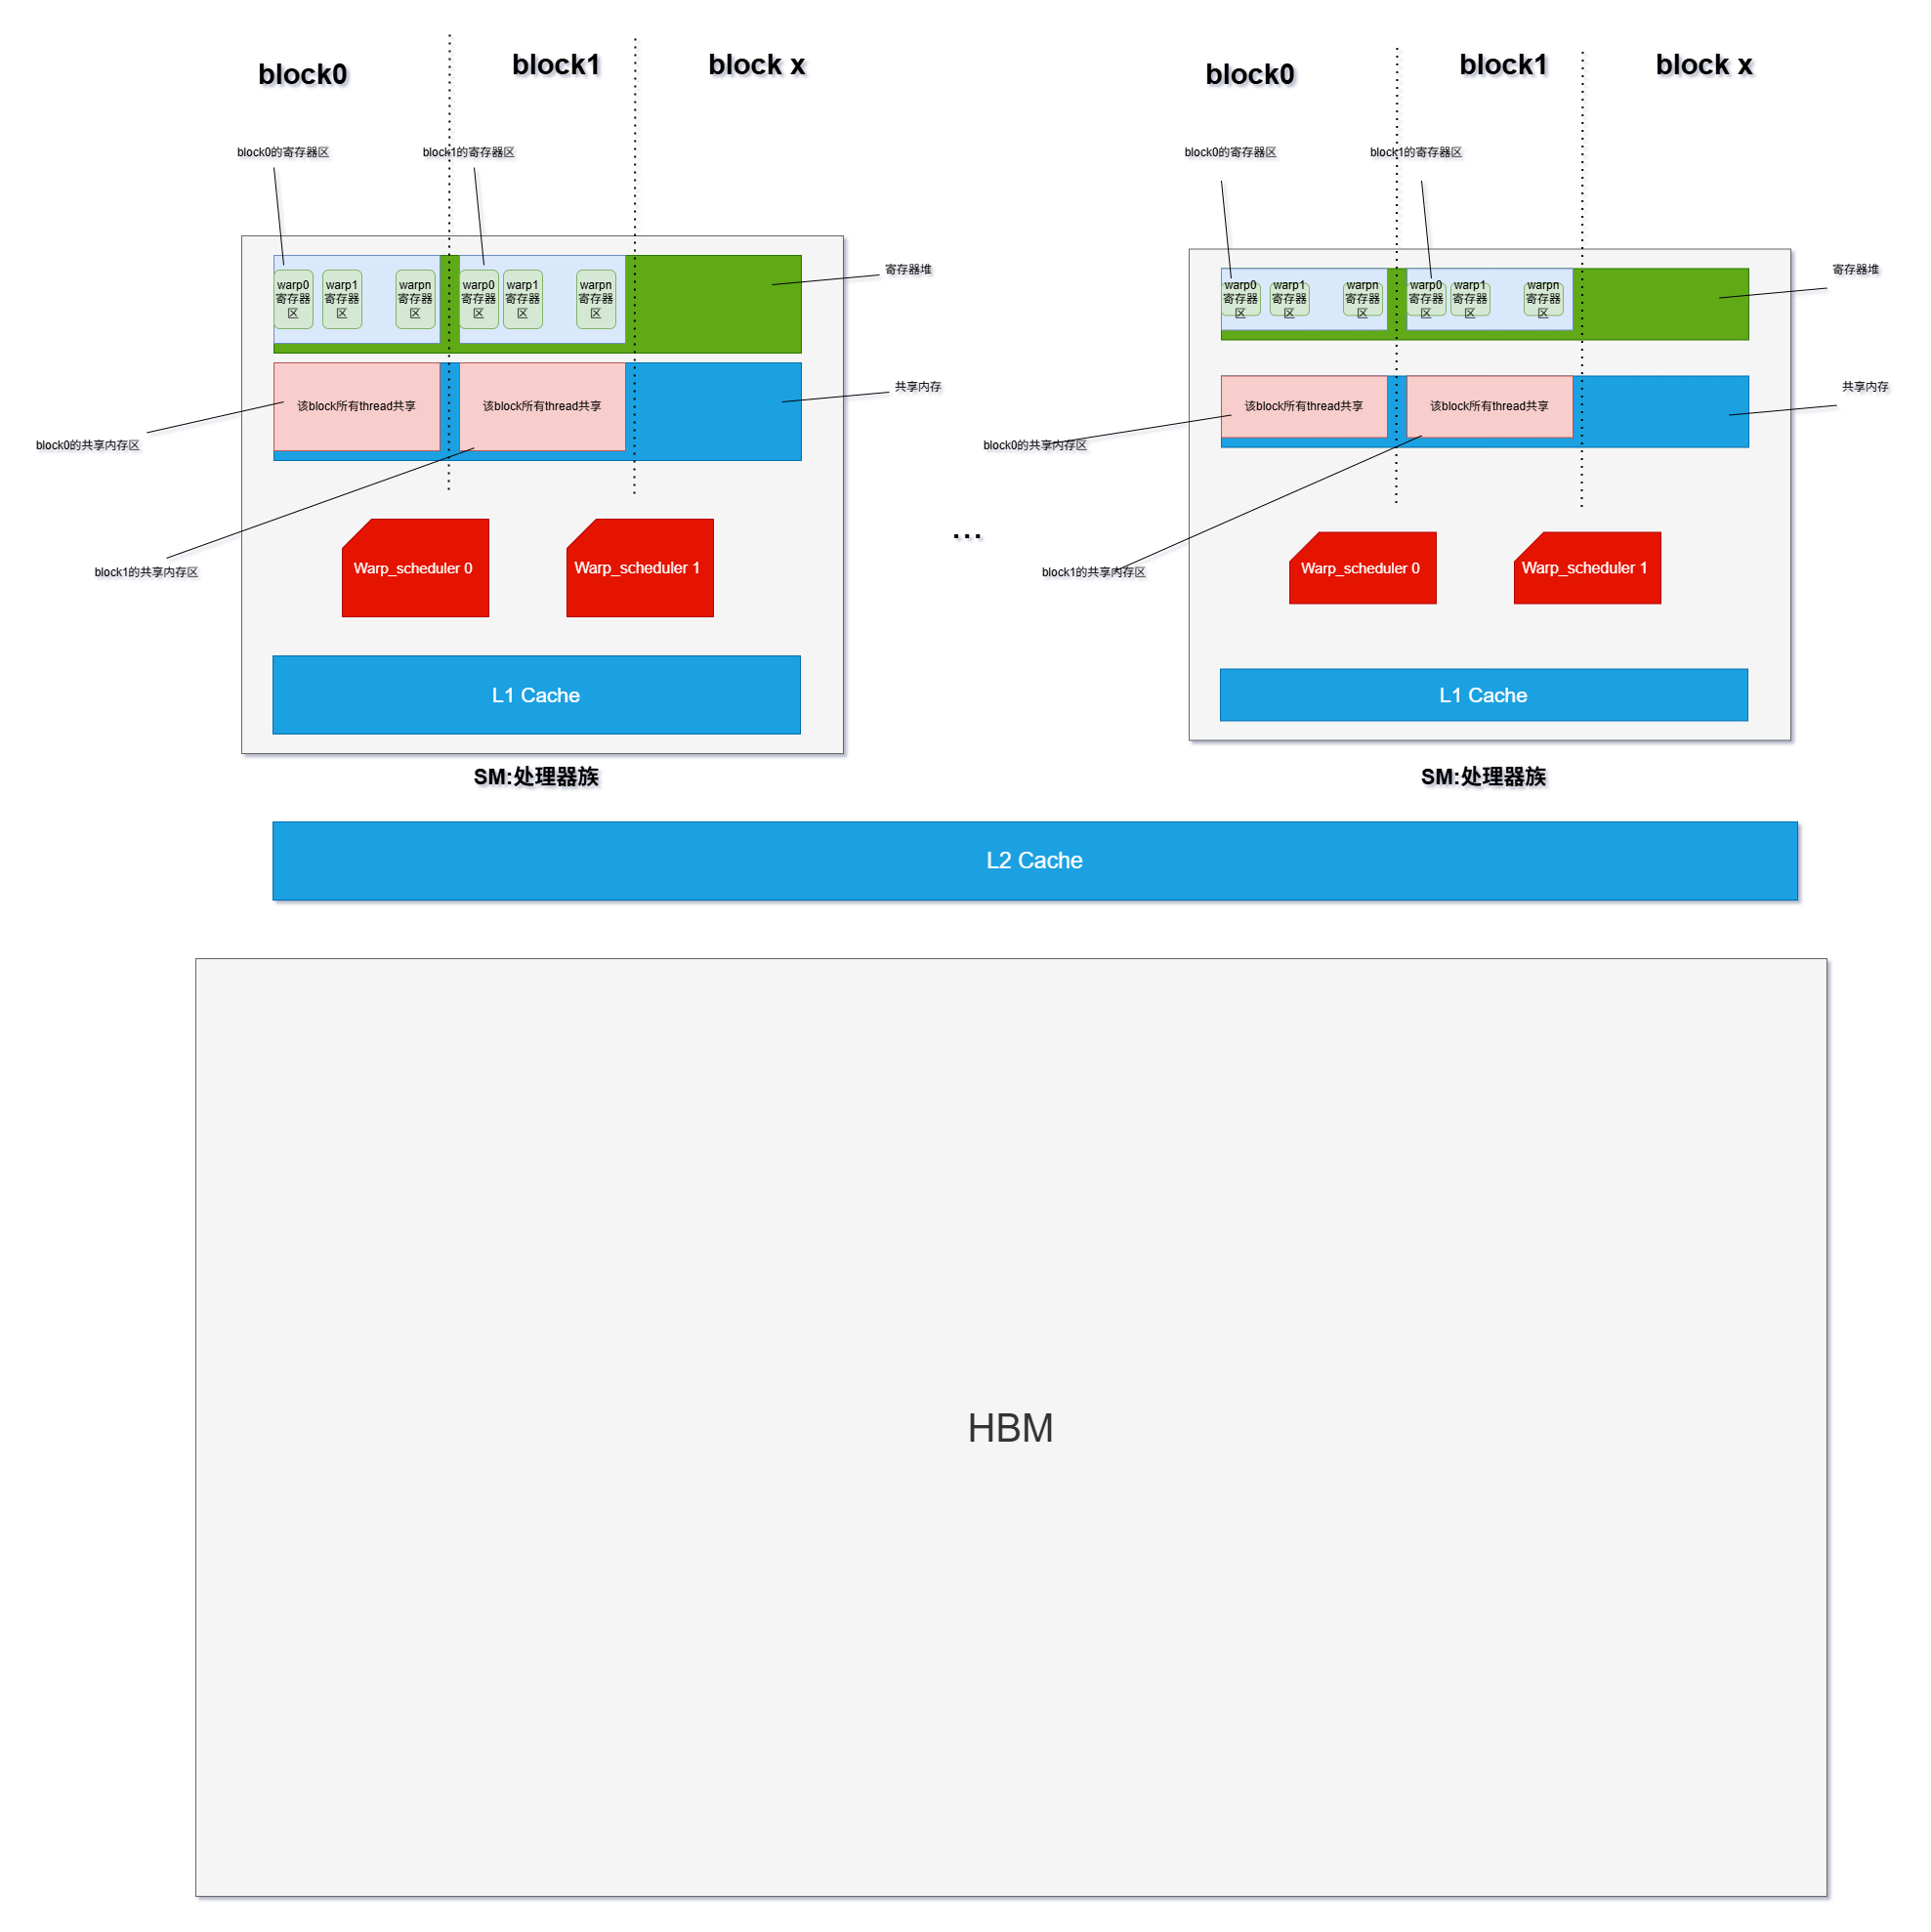
L1缓存
L2 缓存
GPU 存储介质 你的理解 对应传统内存段 核心技术细节补遗
寄存器 (Registers) 栈区 (主) Stack / CPU Registers 线程执行的第一优先级。不可取地址(No pointers)。
局部内存 (Local) 栈区补充 Stack (Overflow) 当局部数组下标是动态变量,或寄存器不够(Spilling)时使用。
共享内存 (Shared) 通信用 IPC / User Cache 逻辑上类似一个“手动控制的 L1”,用于 Block 内线程协作。
全局内存 (Global) 全局/数据段 .data / .bss / Heap CPU 与 GPU 交换数据的唯一窗口,容量最大,延迟最高。
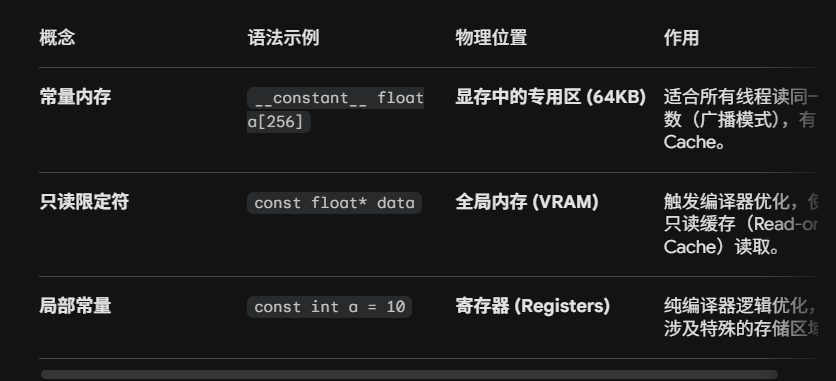
常量内存 (Constant) 只读数据段 .rodata 物理上在显存,但 SM 内部有专用 Cache,全 Warp 读取同一地址时极快。
纹理内存 (Texture) 特殊用途 Video Memory 硬件自带插值、边界处理能力,具有 2D/3D 空间局部性缓存。
L1 缓存 (L1) 片上缓存 L1 Cache 现代架构中,L1 常与 Shared Memory 共享同一块硬件 SRAM 资源。
L2 缓存 (L2) 片外缓存 L2 Cache 所有 SM 共享,是显存之前的最后一道高速防线。
下图展示了并行计算的内存模型,在物理硬件上的分布
CUDA编程 核函数(kernel) 核函数,就是thread里面执行的内容,根据输入的数据不同,产生同样的计算行为,输出不同的结果。
每个核函数内部可以访问:
blockIdx.x (block的id号:0 ~ gridDim-1)
blockDim.x ( 就是获取blockDim)
threadIdx.x (thread的id号,0 ~ blockDim-1)
__global__ void myKernel (float * data, int n) { int idx = blockIdx.x * blockDim.x + threadIdx.x; if (idx < n) { data[idx] *= 2.0f ; } } myKernel<<<128 , 256 >>>(data, n);
我们launch一次kernel,产生一个grid,表示并行任务的集合
注意看,这里的float* data, 这个指针变量在寄存器区,但是指向的内容在显存(全局内存区),所以每次thread读取和输出,都要访存,效率很差
修饰符: __global__ 指明函数是核函数,CPU调用,GPU上执行 __device__ 指明设备函数,GPU上被核函数/其他设备函数调用执行 __host__ 普通函数,CPU上执行 __shared__ 指明内存在共享内存上,否则会在栈区(SM的寄存器区)
维度索引 对于硬件来说,她并不关心thead, block的排布,在内存上都是顺序存放的。
<<<128 , 256 >>> dim3 blockDim (16 , 16 ) dim3 gridDim ((width+15 )/16 ,(height+15 )/16 )
内存管理 cuda需要显示管理CPU的内存,还有显存
float *d_data; cudaMalloc(&d_data, n*sizeof (float )); cudaMemcpy(d_data, h_data, n*sizeof (float ), cudaMemcpyHostToDevice); myKernel<<<gridDim, blockDim>>>(d_data, n); cudaMemcpy(h_data, d_data, n*sizeof (float ), cudaMemcpyDeviceToHost); cudaFree(d_data);
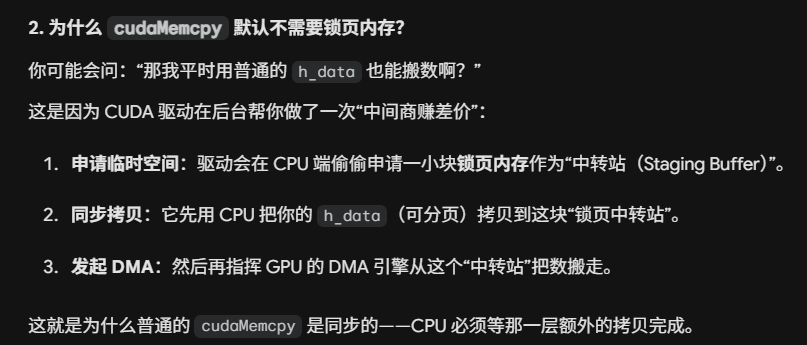
异步传输与stream 正常情况下,cudaMemcpy 是用cpu进行拷贝的,所以会阻塞,我们希望更高效的使用异步传输,也就是非阻塞,比如DMA
cudaMemcpy 的本质就是通过 PCIe 总线进行的 DMA(Direct Memory Access)传输
用Stream可以实现异步传输与计算难道重叠
cudaStream_t stream; cudaStreamCreate(&stream); cudaMemcpyAsync(d_data, h_data, size, cudaMemcpyHostToDevice, stream); myKernel<<<gridDim, blockDim, 0 , stream>>>(d_data, n); cudaMemcpyAsync(h_data, d_data, size, cudaMemcpyDeviceToHost, stream); cudaStreamSynchronize(stream); cudaStreamDestroy(stream);
在操作系统里面,我们申请的内存,叫做可分页内存 ,逻辑上是连续的虚拟地址,物理上是分在不连续的物理也框里面的。可能会被swap到磁盘上。
这对于软件没事,顶多等一等磁盘,重新SWAP回来。
但是DMA只知道物理地址,所以物理地址不能改变,且这块内存不能被swap到磁盘。
float * h_pinned;cudaMallocHost(&h_pinned, size); cudaFreeHost(h_pinned);
错误处理 #define CUDA_CHECK(call) do { \ cudaError_t err = call; \ if (err != cudaSuccess) { \ fprintf(stderr, "CUDA error at %s:%d: %s\n" , \ __FILE__, __LINE__, cudaGetErrorString(err)); \ exit(EXIT_FAILURE); \ } \ } while(0) CUDA_CHECK(cudaMalloc(&d_data, size)); CUDA_CHECK(cudaMemcpy(d_data, h_data, size, cudaMemcpyHostToDevice)); myKernel<<<gridDim, blockDim>>>(d_data, n); CUDA_CHECK(cudaGetLastError()); CUDA_CHECK(cudaDeviceSynchronize());
thread 障碍同步 __global__ void sharedMemDemo (float * input, float * output, int n) { __shared__ float smem[256 ]; int idx = blockIdx.x * blockDim.x + threadIdx.x; if (idx < n) { smem[threadIdx.x] = input[idx]; } __syncthreads(); if (idx < n && threadIdx.x > 0 ) { output[idx] = smem[threadIdx.x] + smem[threadIdx.x - 1 ]; } }
这里的__syncthreads()
thread运行到这里就阻塞,等待block上的所有的thread都运行到这里,才一起往下
静态共享内存/动态共享内存 __global__ void sharedMemDemo (float * input, float * output, int n) { __shared__ float smem[256 ]; }
extern __shared__ float dynamic_smem[];kernel<<<gridDim, blockDim, sharedMemBytes>>>(args);
全局内存 全局内存就是”显存”,容量最大但速度最慢。cudaMalloc 分配的内存、kernel 参数中的指针都指向全局内存。
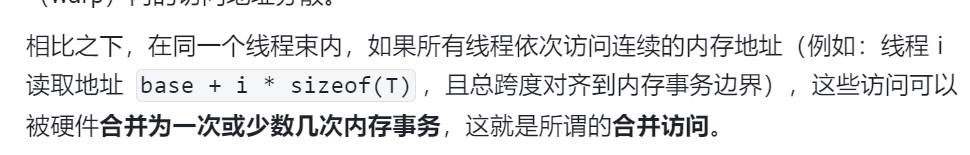
合并访问(Coalesced Access) 是全局内存优化的黄金法则:同一个 Warp 内的 32 个线程应该访问连续的内存地址,这样硬件可以将多次访问合并为少量内存事务
因为warp是一起执行的,他们都需要输入对吧,都需要输出对吧,那么肯定要一整块的拷贝内存到L1缓存才快,所以,要合并访问
float val = data[threadIdx.x]; float val = data[threadIdx.x * stride]; float val = data[random_index[threadIdx.x]];
数据布局优化: SoA
通俗说,就是按照属性合并
struct Particle {float x, y, z, w; };Particle particles[N]; struct Particles { float x[N]; float y[N]; float z[N]; float w[N]; };
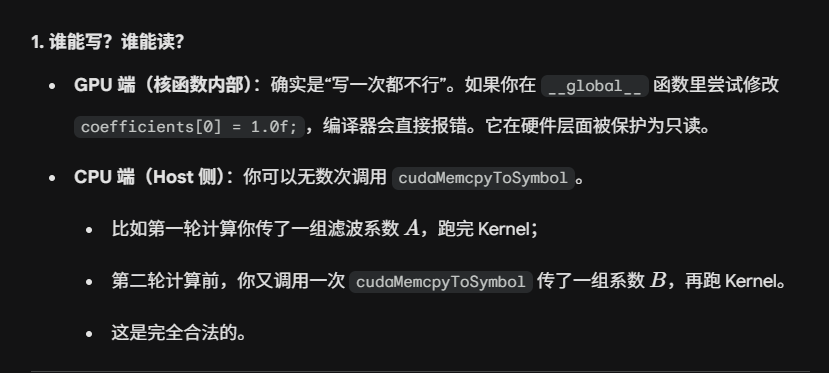
常量内存 这里的常量内存,的常量,其实是对GPU来说的,CPU来说还是可以写入的
__constant__ float coefficients[256 ]; cudaMemcpyToSymbol(coefficients, h_coeffs, 256 * sizeof (float )); float c = coefficients[idx];
warp warp是GPU的最小调度单位,=32个thread,他们一起执行相同的指令来处理数据。
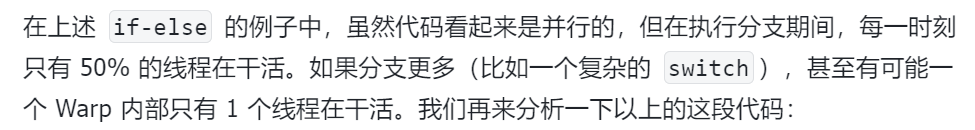
如果出现分支,那么两个分支就必须串行执行,性能减半。
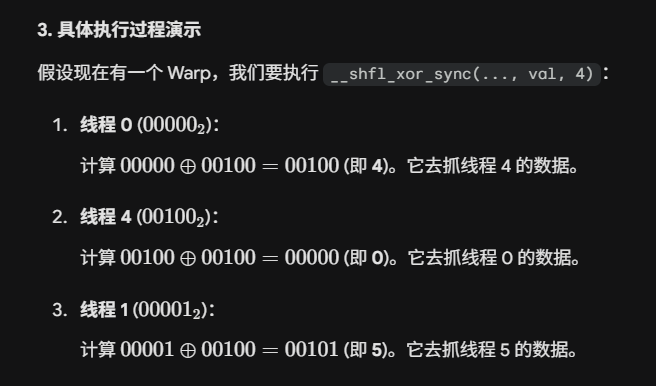
warp级原语 warp内的线程,可以直接交换寄存器的数据 ,连共享内存都不用
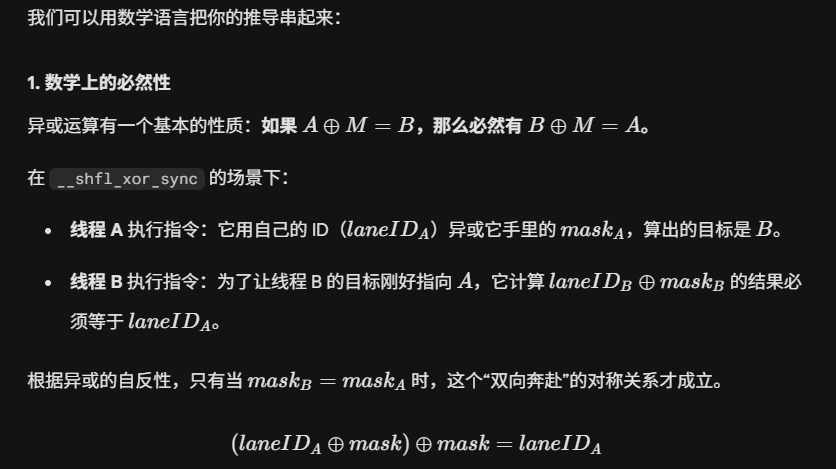
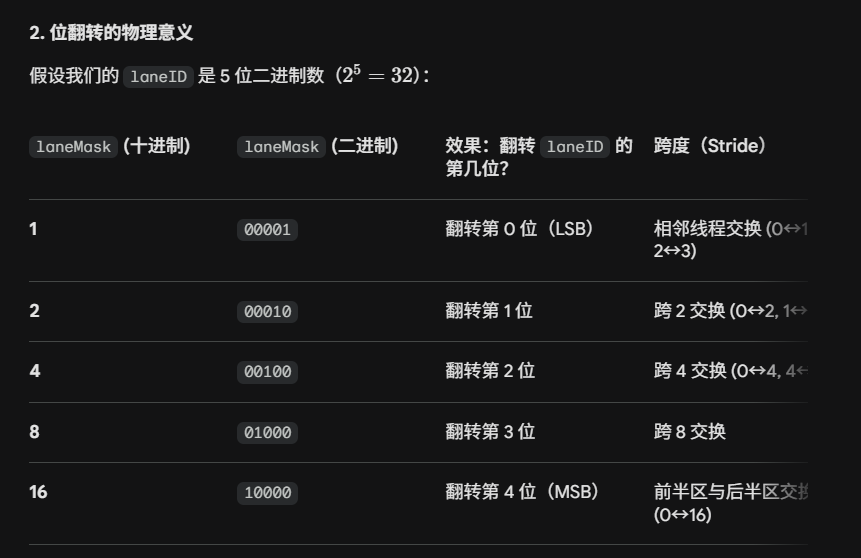
float val = __shfl_down_sync(0xFFFFFFFF , myVal, delta);float val = __shfl_xor_sync(0xFFFFFFFF , myVal, mask);float sum = __reduce_add_sync(0xFFFFFFF , myVal);
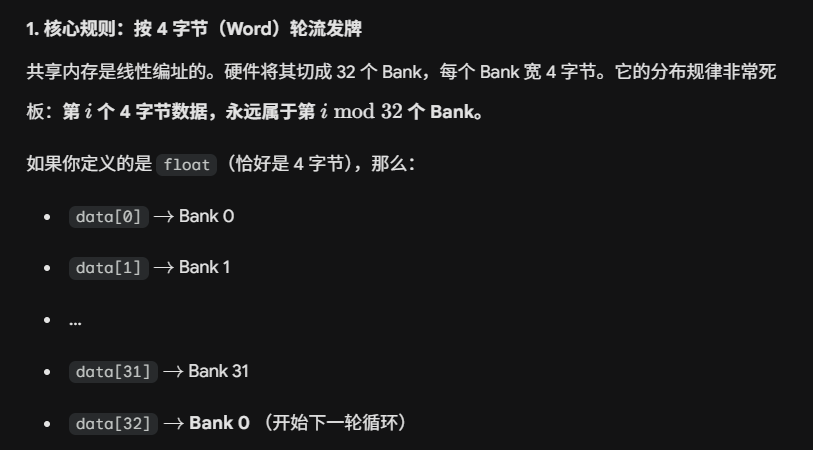
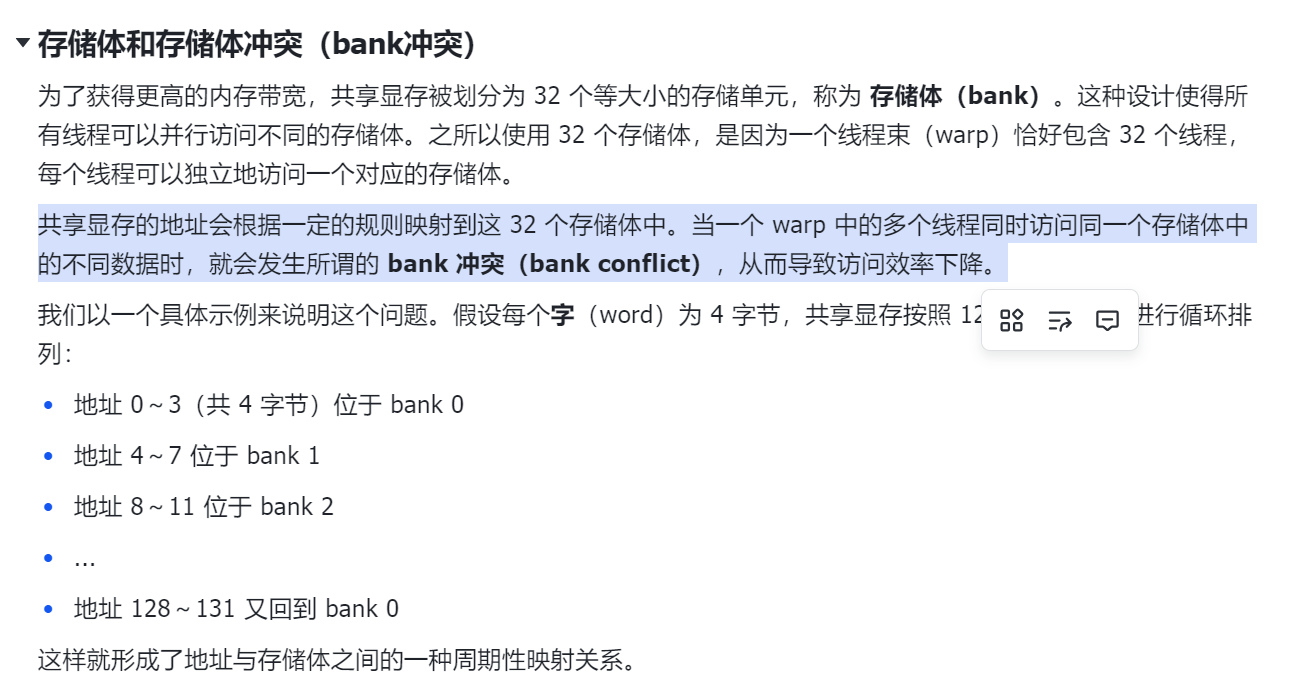
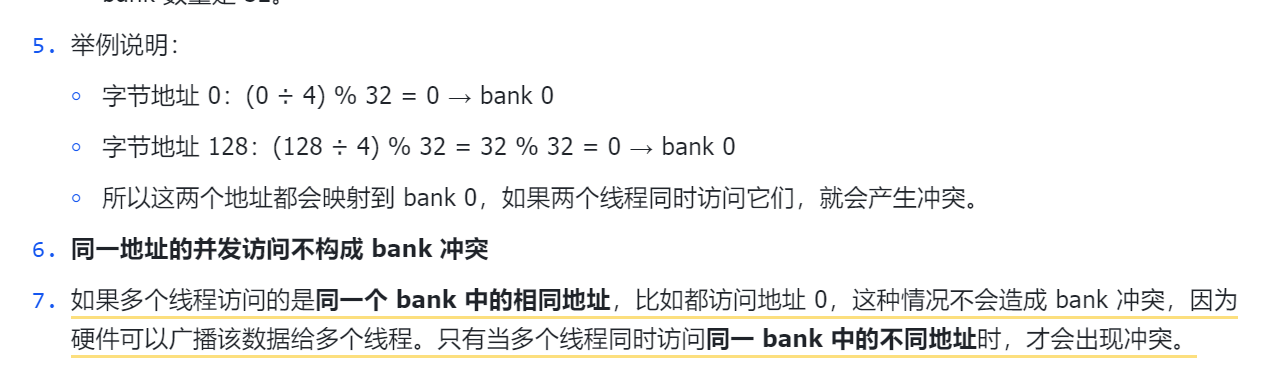
共享内存的bank 这里先解释一下共享内存的bank,也就是数据在shared memory上是如何存储的
第0个4字节,在bank0 第一个4字节,在bank1
第二个4字节,在bank2
…
第31个4字节,在bank31
第32个4字节,在bank0
所以这就会带来bank conflict问题
首先,同一个block的所有thread共享一块共享内存空间。
但是bank conflict 仅仅会发生在warp内,不同warp的thread不会争抢一个bank,下面解释原因
在物理层面,一个 SM 内部的共享内存(Shared Memory)逻辑单元,在一个时钟周期内通常只能响应一个 Warp 的访存请求
Block 之间是并发的 :它们共用 SM 资源,不分先后。
Warp 之间是独立调度的 :调度器只选当下最能跑的 Warp。
资源是硬伤 :如果你一个 Block 占用了 100% 的共享内存,那这个 SM 就只能跑这一个 Block。这时候才会有你说的“顺序关系”——等这个 Block 跑完了撤场,下一个 Block 才能进来。
所以回到同一个warp内的bank conflict
__shared__ float smem[32 ][32 ]; float val = smem[0 ][threadIdx.x]; float val = smem[threadIdx.x][0 ]; __shared__ float smem[32 ][33 ]; float val = smem[threadIdx.x][0 ]
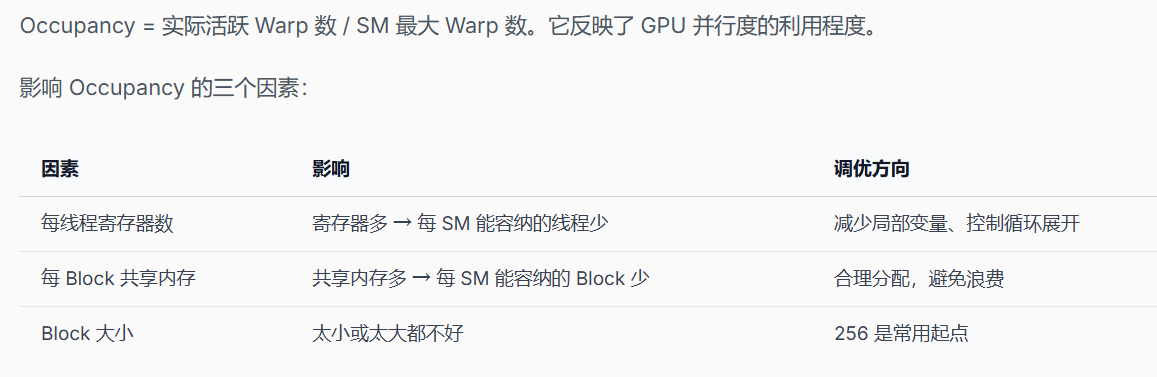
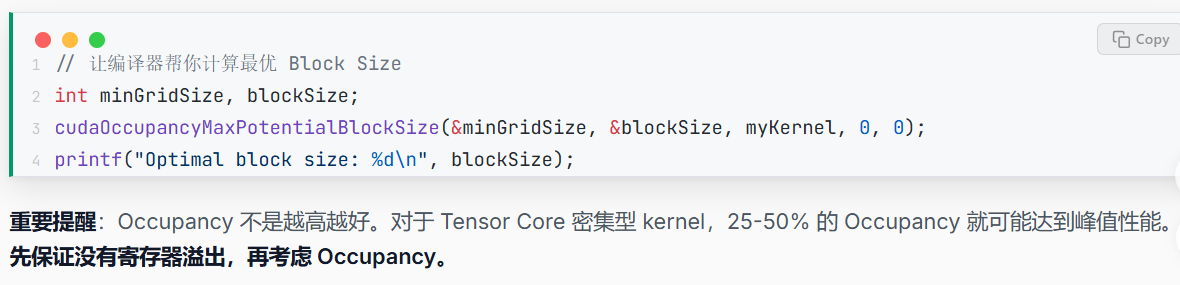
occupancy 即实际活跃warp数/SM最大warp数
总结GPU的流,异步,同步的区别 GPU通过多个流来实现并行,单个流里面,相当于顺序的工作队列,只能顺序执行,同步异步这里的概念都是针对cpu,同步的数据拷贝,该进程会阻塞,具体是进入睡眠等待cuda驱动拷贝完唤醒吗?异步的启动核函数,就是相当于在cuda驱动里面增加了一个任务,然后继续向下执行
#include <stdio.h> #include <cuda_runtime.h> #define CUDA_CHECK(call) do { \ cudaError_t err = call; \ if (err != cudaSuccess) { \ fprintf(stderr, "CUDA error at %s:%d: %s\n" , \ __FILE__, __LINE__, cudaGetErrorString(err)); \ exit(EXIT_FAILURE); \ } \ } while(0) __global__ void vector_add (const float * a, const float * b, float * c, int n) { int idx = blockIdx.x * blockDim.x + threadIdx.x; if (idx < n){ c[idx] = a[idx] + b[idx]; } } int main () { const int N = 1 << 20 ; size_t bytes = N* sizeof (float ); float * h_a = (float *)malloc (bytes); float * h_b = (float *)malloc (bytes); float * h_c = (float *)malloc (bytes); for (int i = 0 ; i<N; i++){ h_a[i] = 1.0f ; h_b[i]=1.0f ; } float * d_a, *d_b, *d_c; CUDA_CHECK(cudaMalloc(&d_a, bytes)); CUDA_CHECK(cudaMalloc(&d_b, bytes)); CUDA_CHECK(cudaMalloc(&d_c, bytes)); CUDA_CHECK(cudaMemcpy(d_a, h_a, bytes, cudaMemcpyHostToDevice)); CUDA_CHECK(cudaMemcpy(d_b, h_b, bytes, cudaMemcpyHostToDevice)); int blockSize = 256 ; int gridSize = (N+blockSize -1 )/ blockSize; vector_add<<<gridSize, blockSize>>>(d_a, d_b, d_c, N); CUDA_CHECK(cudaGetLastError()); CUDA_CHECK(cudaMemcpy(h_c, d_c, bytes, cudaMemcpyDeviceToHost)); for (int i = 0 ; i<N; i++){ if (h_c[i] != 3.0f ){ printf ("Error calcute in thread idx = %d, %f\n" , i, h_c[i]); break ; } } printf ("Vector addition completed successfully\n" ); free (h_a); free (h_b); free (h_c); cudaFree(d_a); cudaFree(d_b); cudaFree(d_c); return 0 ; }
基础算子学习 softmax算子
计算过程分析: 首先,所有的数据是放在全局内存里面的,
以cpu的视角来分析
我们需要计算这些浮点数的max最大值,因此需要一个遍历O(n)
我们需要计算每个float经过max的归一化之后的exp, 需要一个遍历O(n)
我们需要计算分母:所有exp的求和,需要一个遍历O(n)
我们需要计算所有exp除以求和的分母,得到每个的分数,需要一遍O(n)
以gpu并行的视角来分析 :
我们需要计算这些浮点数的max最大值,因此需要一个遍历O(n)
可以用几个thread来并行计算,需要交互数据
交互数据:求最大值
我们需要计算每个float经过max的归一化之后的exp, 需要一个遍历O(n)
可以用几个thread来并行计算,无需交互数据
我们需要计算分母:所有exp的求和,需要一个遍历O(n)
可以用几个thread来并行计算,需要交互数据
交互数据:求和
我们需要计算所有exp除以求和的分母,得到每个的分数,需要一遍O(n)
可以用几个thread来并行计算,无需交互数据
所以,这里涉及两种thread交互数据的需求 :本质都是thread交互数据 。(所有thread都属于一个block )
warp间thread交换数据
warp内thread交换数据
而这种靠thread交互数据,来得到我们最终的计算结果的方法,叫归约
注意,因为我们的数据很大,所以一般数据都放在全局内存里面
几种thread的遍历方式 无需交互
采样处理
for(int i = tid; i<C ; i += blockDim.x)
平分处理
因为无需交互,所以每个thread的处理结果一般就放在寄存器里面
需要交互(归约)
warp内(先算)
固定32个thread,用__shrf_xxx来warpReduce
几次循环之后,只有lane0的结果才是warp内归约的最后结果,其他的都是中间结果
warp间
共享内存暂存,然后选择一个tid来遍历共享内存。合并warp间的结果
通用归约逻辑:
thread指定范围
if(tid == 0)
if(tid < xxx)
cpu实现 void softmax_cpu (float * input, float * output,int N, int C) for (int i = 0 ; i< N ; i++){ const float * input_row = input + i*C; float * out_row = output + i*C; float maxval = -INFINITY; for (int j = 0 ; j<C;j++){ if (maxval < input_row[j]) maxval = input_row[j]; } float sum = 0.0f ; for (int j =0 ; j<C;j++){ out_row[j] = expf (input_row[j]-maxval); sum += out_row[j]; } float norm = 1.0f /sum; for (int j = 0 ; j<C; j++){ out_row[j] *= norm; } } }
cuda朴素实现 __global__ void softmax_gpu_native (float * input_gpu, float * output_gpu, int N, int C) { int i = threadIdx.x + blockIdx.x * blockDim.x; if (i<N){ const float * input_row = input_gpu + C*i; float * output_row = output_gpu + C*i; float maxval = -INFINITY; for (int n = 0 ; n<C ; n++){ if (maxval < input_row[n]) maxval = input_row[n]; } float sum = 0.0f ; for (int j = 0 ; j<C ;j++){ float val = expf (input_row[j] - maxval); output_row[j] = val; sum += val; } float norm = 1 /sum; for (int j = 0 ; j<C;j++){ output_row[j] *= norm; } } }
cpu cost time = 568.371 ms
优化1:block内多thread归约+共享内存 核函数 里面,写的线程行为,分为两种作用范围:
归约 ,从形式上来看,有两种循环:
抽样周期归约:for(int i = tid; i < C; i+=block_size){
等分归约:for(int j = 0; j<C;j++){
共享内存 里面,主要放归约之后的结果:
__global__ void softmax_v1 (float * input_gpu, float * output_gpu, int N, int C) { extern __shared__ float smem[]; int idx = blockIdx.x; int tid = threadIdx.x; int block_size = blockDim.x; const float * x = input_gpu + idx*C; float maxval = -INFINITY; for (int i = tid; i < C; i+=block_size){ maxval = fmaxf (maxval, x[i]); } smem[tid] = maxval; __syncthreads(); for (int stride = block_size / 2 ; stride >= 1 ; stride /=2 ){ __syncthreads(); if (tid<stride){ smem[tid] = fmaxf (smem[tid], smem[tid + stride]); } } __syncthreads(); float offset = smem[0 ]; for (int i = tid; i<C; i+=block_size){ output_gpu[idx*C + i] = expf (x[i] - offset); } __syncthreads(); float * y = output_gpu + idx*C; float sum = 0.0f ; for (int i = tid; i<C;i+=block_size){ sum += y[i]; } smem[tid]=sum; __syncthreads(); for (int stride = block_size /2 ; stride >=1 ; stride /=2 ){ __syncthreads(); if (tid < stride) smem[tid] += smem[tid+stride]; } __syncthreads(); float sum_2 = smem[0 ]; for (int i = tid; i<C; i+=block_size){ output_gpu[idx*C+i] = y[i]/sum_2; } }
cpu cost time = 568.371 ms
优化2: warp内归约+共享内存 __device__ float warpReduceMax (float val) { for (int offset = 16 ; offset>0 ;offset /=2 ){ val = fmaxf (val, __shfl_down_sync(0xFFFFFFFF , val, offset)); } return val; } __device__ float warpReduceSum (float val) { for (int offset = 16 ; offset > 0 ; offset /= 2 ){ val = val + __shfl_down_sync(0xFFFFFFFF , val, offset); } return val; } __global__ void softmax_v2 (float * input_gpu, float * output_gpu, int N, int C) { extern __shared__ float shared[]; int bid = blockIdx.x; int tid = threadIdx.x; int warpId = threadIdx.x / 32 ; int lanId = threadIdx.x % 32 ; int warpsPerBlock = blockDim.x / 32 ; float * maxvals = shared; float * sumvals = &shared[warpsPerBlock]; const float * x = input_gpu + bid*C; float maxval = -INFINITY; for (int i = tid; i<C; i += blockDim.x){ maxval = fmaxf (maxval, x[i]); } maxval = warpReduceMax (maxval); if (lanId == 0 ){ maxvals[warpId] = maxval; } __syncthreads(); if (tid == 0 ){ float val = maxvals[tid]; for (int i = 1 ; i<warpsPerBlock; i++){ val = fmaxf (val, maxvals[i]); } maxvals[0 ] = val; } __syncthreads(); float * y = output_gpu + bid*C; for (int i = tid; i<C; i+=blockDim.x){ y[i] = expf (x[i] - maxvals[0 ]); } __syncthreads(); float sum = 0.0f ; for (int i = tid; i<C; i+=blockDim.x){ sum += y[i]; } sum = warpReduceSum (sum); if (lanId == 0 ){ sumvals[warpId] = sum; } __syncthreads(); if (tid == 0 ){ float sum_all = sumvals[0 ]; for (int i =1 ; i<warpsPerBlock; i++){ sum_all += sumvals[i]; } sumvals[0 ] = sum_all; } __syncthreads(); float norm = 1 /sumvals[0 ]; for (int i = tid; i<C; i += blockDim.x){ y[i] *= norm; } }
cpu cost time = 571.986 ms
总结:优化手段:
小批量并行
一个block针对一个样本(向量)
一个block内的thread数为32的倍数,凑够warp来调度。
warp内归约(寄存器归约)
warp间合并(共享内存)
Reduce算子 这里就是把上面softmax的归约方式进一步总结
前面讲了,我们的归约,本质就是thread的交互计算 。
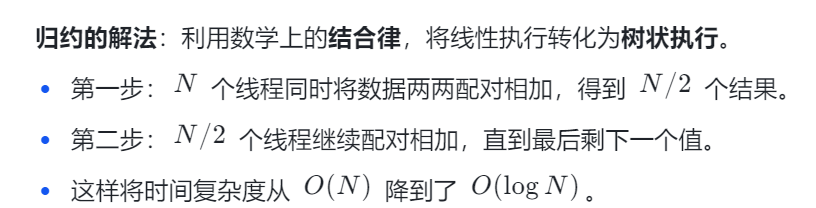
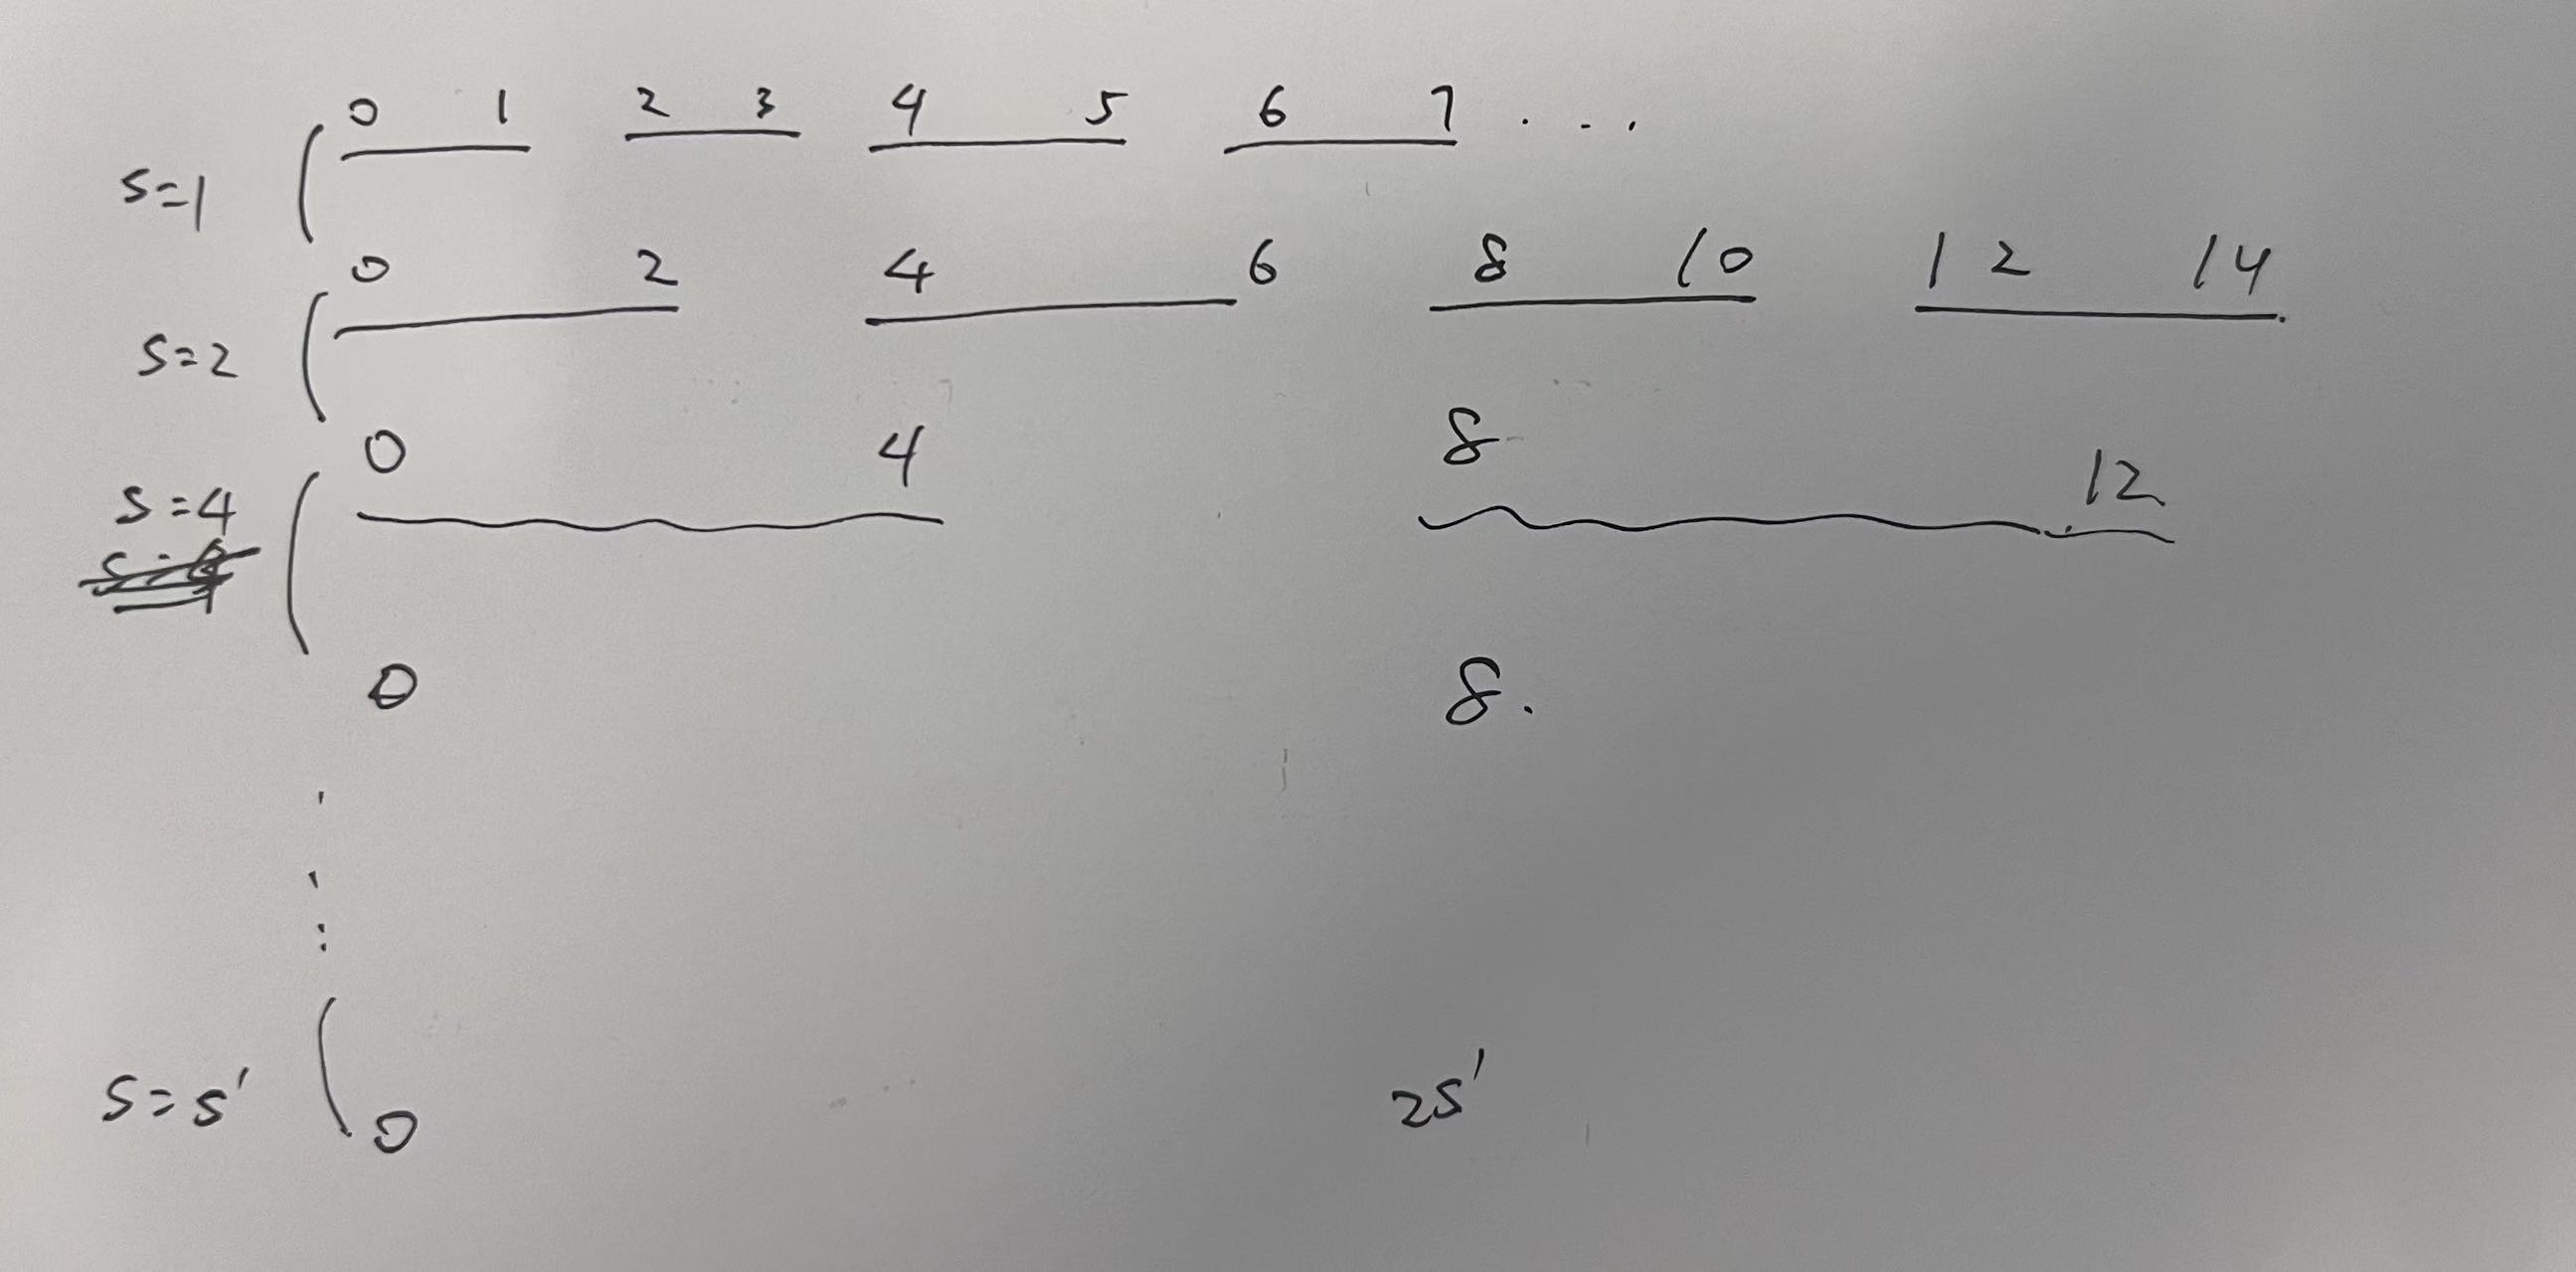
本质就是利用数学的结合率 ,来把线性执行 转化为树状执行 。
总的来说,归约有三种方式
跨线程块归约 :如何将多个线程块(CTA)的局部结果进一步聚合为最终结果;warp 内归约 :利用 warp-level 原语(如 __shfl_down_sync)实现高效的 warp 内部数据聚合;单 warp 循环展开策略 :通过循环展开提升指令级并行性(ILP),优化计算吞吐和内存访问效率。
我们之前softmax用到的是第二种归约方式。
朴素归约reduce实现(分块归约)
#include <iostream> #include <cuda_runtime.h> #include <chrono> #include <numeric> #include <vector> using namespace std;const int BLOCK_SIZE = 1024 ;const int N = 1024 * 1024 ; __global__ void reduce_v0 (float * g_idata, float *g_odata) { __shared__ float sdata[BLOCK_SIZE]; unsigned int tid = threadIdx.x; unsigned int i = blockIdx.x * blockDim.x + threadIdx.x; sdata[tid] = g_idata[i]; __syncthreads(); for (unsigned int s = 1 ; s<blockDim.x; s*=2 ){ if (tid%(2 *s) == 0 ) sdata[tid] += sdata[tid+s]; __syncthreads(); } if (tid == 0 ){ g_odata[blockIdx.x] = sdata[0 ]; } } float reduce_cpu (const std::vector<float > &data) float sum = 0.0f ; for (float val : data) { sum += val; } return sum; } int main () int num_blocks = (N + BLOCK_SIZE - 1 ) / BLOCK_SIZE; std::vector<float > h_data (N) ; for (int i = 0 ; i < N; i++) { h_data[i] = 1.0f ; } auto cpu_start = std::chrono::high_resolution_clock::now (); float cpu_result = reduce_cpu (h_data); auto cpu_end = std::chrono::high_resolution_clock::now (); std::chrono::duration<double , std::milli> cpu_duration = cpu_end - cpu_start; std::cout << "CPU result: " << cpu_result << std::endl; std::cout << "CPU time: " << cpu_duration.count () << " ms" << std::endl; float *d_data, *d_result; float *d_final_result; float gpu_result; cudaMalloc (&d_data, N * sizeof (float )); cudaMalloc (&d_result, num_blocks * sizeof (float )); cudaMalloc (&d_final_result, 1 * sizeof (float )); cudaMemcpy (d_data, h_data.data (), N * sizeof (float ), cudaMemcpyHostToDevice); cudaEvent_t start, stop; cudaEventCreate (&start); cudaEventCreate (&stop); cudaEventRecord (start); reduce_v0<<<num_blocks, BLOCK_SIZE>>>(d_data, d_result); reduce_v0<<<1 , num_blocks>>>(d_result, d_final_result); cudaEventRecord (stop); cudaEventSynchronize (stop); float milliseconds = 0 ; cudaEventElapsedTime (&milliseconds, start, stop); std::cout << "GPU kernel time: " << milliseconds << " ms" << std::endl; cudaMemcpy (&gpu_result, d_final_result, sizeof (float ), cudaMemcpyDeviceToHost); std::cout << "GPU result: " << gpu_result << std::endl; if (abs (cpu_result - gpu_result) < 1e-5 ) { std::cout << "Result verified successfully!" << std::endl; } else { std::cout << "Result verification failed!" << std::endl; } cudaFree (d_data); cudaFree (d_result); cudaFree (d_final_result); cudaEventDestroy (start); cudaEventDestroy (stop); return 0 ; }
CPU result: 1.04858e+06
CPU time: 4.79212 ms
GPU kernel time: 0.101632 ms
GPU result: 1.04858e+06
Result verified successfully!
从上述 CUDA 实现可以看出,该归约核函数采用的是分块归约(block-wise reduction)策略:每个线程块独立处理输入数据的一个子集,并将该子集的归约结果写入输出数组 g_odata[blockIdx.x]
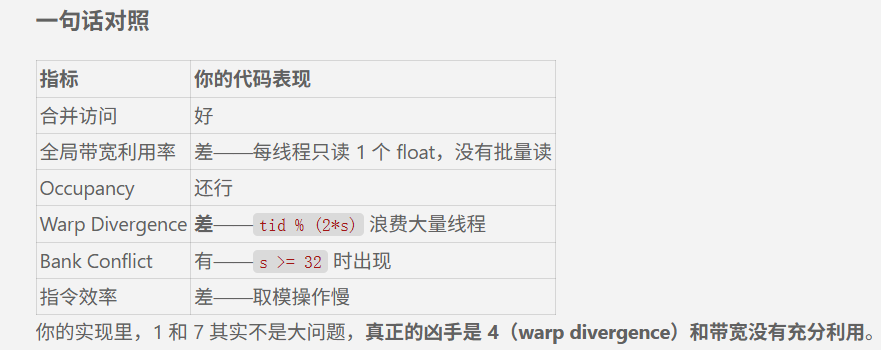
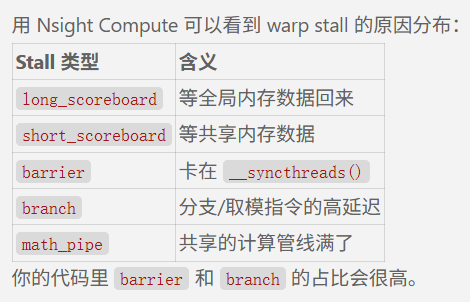
问题分析 从 Nsight Compute 的分析结果可以看出,计算效率 和访存效率 双低,均不到40%。
先解释一下各个性能标准
全局内存带宽利用率
是什么 :实际带宽 / GPU 理论峰值带宽 × 100%为什么关键 :归约是典型的访存密集型操作,算术强度(~0.25 FLOP/Byte)极低,瓶颈全在带宽上如何衡量 :(读 + 写的字节数)/ kernel 执行时间,和 cudaMemcpy 的纯带宽对比优化方向 :合并访问、减少访问次数(每线程 load 多个元素)、对齐
合并访问
是什么 :一个 warp 的 32 个线程访问的全局内存地址落在同一个 128-byte cache line 内你的代码 :g_idata[blockIdx.x * 1024 + threadIdx.x] —— 相邻线程访问相邻地址,已经合并了如果不合并 :比如 stride 访问,一次 transaction 只能取回 1/32 的数据,带宽利用率暴跌
Occupancy(SM占用率)
是什么 :每个 SM 上活跃 warp 数 / 理论最大 warp 数公式 :active_warps = min(blocks * threads/32, 寄存器限制, 共享内存限制)为什么重要 :活跃 warp 越多,SM 越有机会在等待访存时切换到其他 warp,隐藏延迟你的代码 :1024 线程/block,每个线程只用一个 float 共享内存(4KB/block),寄存器也很少,occupancy 其实不低
Warp Divergence(Warp分支分化) (warp内活跃thread数占比 )
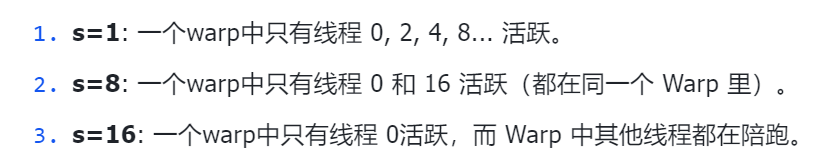
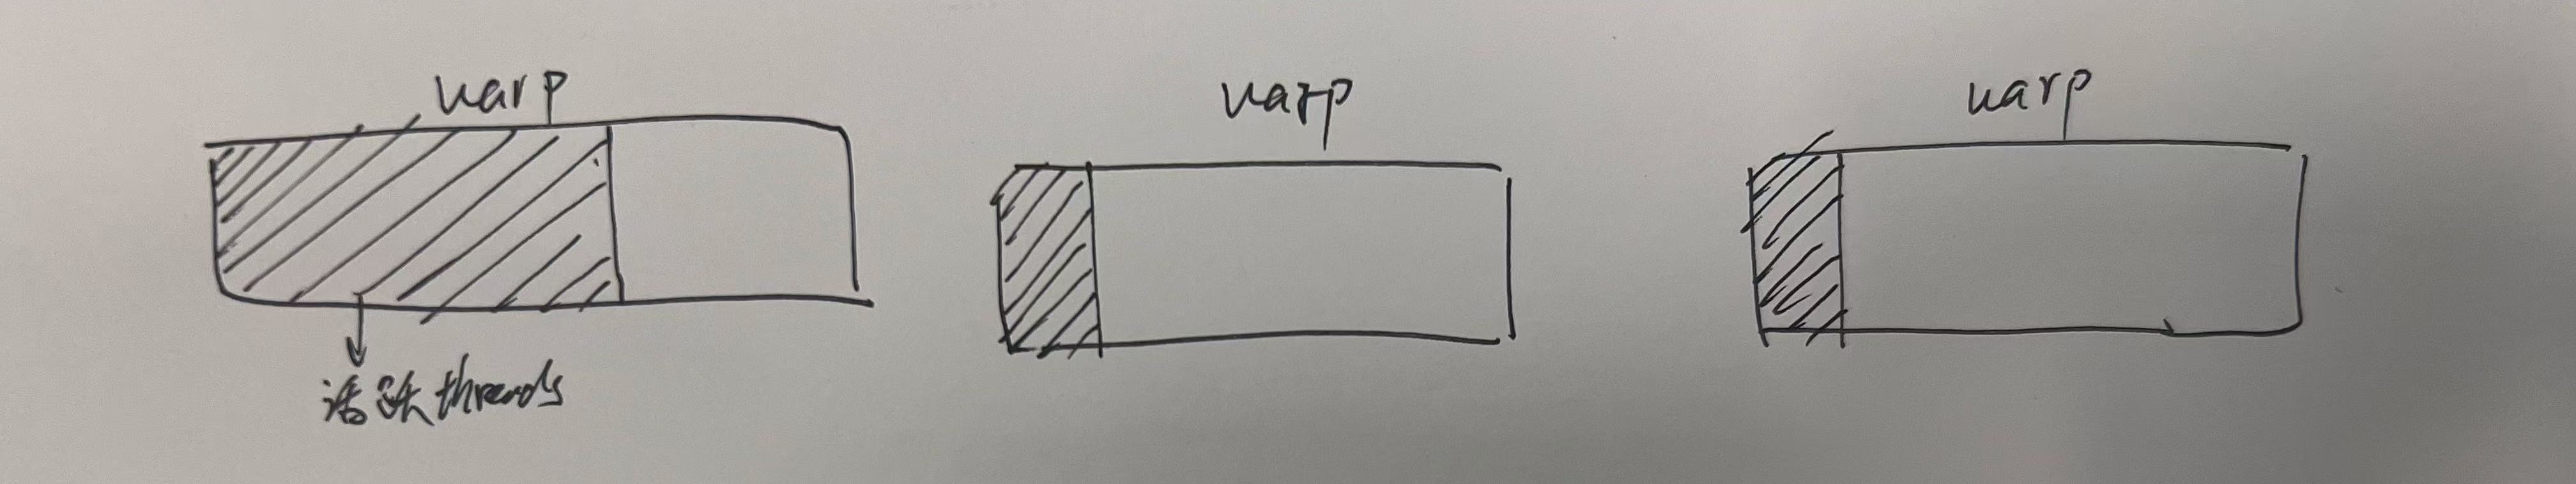
是什么 :warp 内 32 个线程走了 if/else 不同分支,导致部分线程闲置你的代码 :if(tid % (2*s) == 0) —— 越往后越惨,最后只有 1/32 的线程在干活衡量 :SIMD 效率 = 活跃线程数 / 32优化 :用跨步递减(s >>= 1)替代跨步递增,让活跃线程集中在 warp 前半部
共享内存Bank conflict
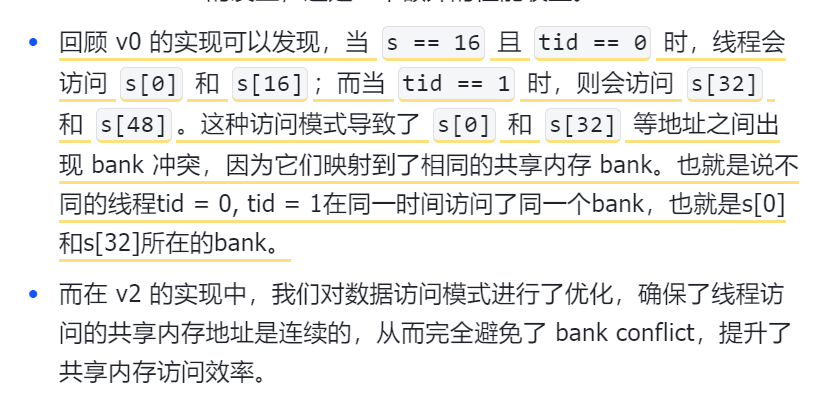
是什么 :shared memory 有 32 个 bank(每个 4 bytes),同一 warp 内 ≥2 个线程访问同一 bank 的不同地址时串行化你的代码 :当 s >= 32 时,sdata[tid] 和 sdata[tid+s] 可能落在同一 bankN-way bank conflict :最坏情况下 32 个线程全撞同一 bank,访问变成串行,延迟 ×32优化 :sequential addressing(连续地址访问)或 padding
算术强度
公式 :FLOP / Byte归约 :N 个元素做 N-1 次加法,读 N 个 float,写 1 个 float,约 N / (4N + 4) ≈ 0.25 FLOP/Byte含义 :每读 1 个字节只做 0.25 次浮点运算,GPU 算力再强也使不上劲,纯内存瓶颈
指令效率
%(取模)、/(除法)在 GPU 上比 + - * 慢 10~20 倍 浮点加法的吞吐通常为几十到上百个/时钟/SM
计算效率:
SM利用率
SM有多少时间真正在跑指令/等访存,同步,空闲
__syncthreads(), 取模,会导致SM利用率低
IPC(每SM的每时钟执行几条指令)
理论峰值取决于GPU架构(4-8)
warp stall, 等访存,等barrier, 等指令依赖,会降低IPC
Warp内活跃thread占比
指令吞吐
取模指令会被编译成一长串整数指令序列,特别是对非 2 的幂取模
对 1024 线程来说,这 10 轮迭代就是 10000+ 次取模
控制流开销
__syncthreads() 本身有开销(barrier 同步)你的代码在循环内 10 次 __syncthreads(),每次都要等最慢的那个 warp
访存效率
全局内存带宽利用率
每个thread读的数据不多,导致每次访存明明最多可以拿128字节,但是你就拿了32字节,跑不满
L1/L2 cache 缓存命中率
全局内存 Access Pattern / Transaction 效率
指标 :gld_efficiency(global load efficiency)、gst_efficiency(global store efficiency)实际用到的字节 / 实际传输的字节
你的代码 :g_idata[blockIdx.x * 1024 + threadIdx.x] 是顺序访问,一个 warp(32线程)读 128 bytes,刚好是一个 cache line,gld_efficiency 接近 100%你写的 g_odata[blockIdx.x] 每个 block 只写 4 bytes——而 GPU 一次最少写 32 bytes,浪费了 28 bytes,gst_efficiency 很差
共享内存 bank conflict
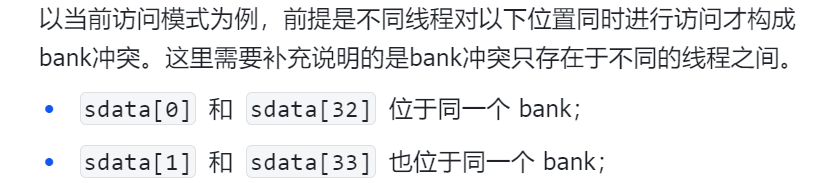
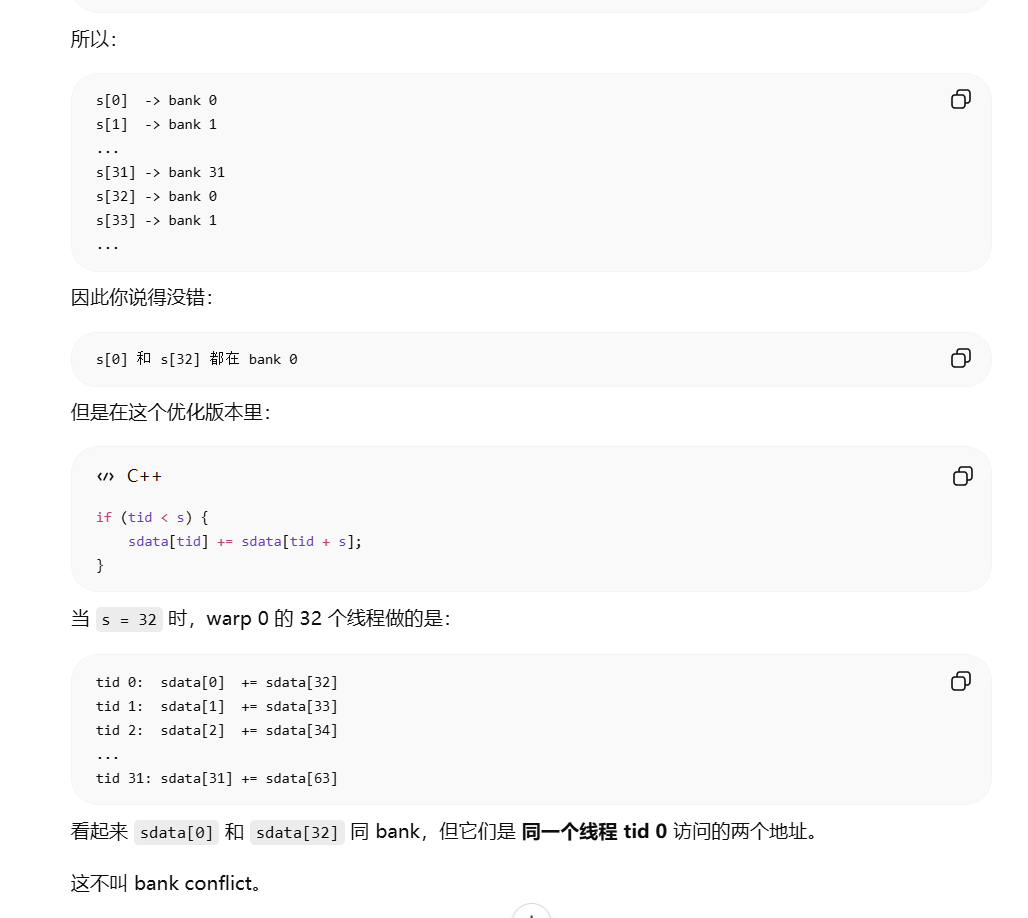
指标 :shared_load_transactions / shared_store_transactions(越多冲突,transaction 越多)32 个 bank,每个 4 bytes :同一 warp 内两个线程访问同一 bank 的不同地址 → 一次变两次传输你的代码 s=32 时,thread 0 读 bank 0 (sdata[0]) 和 bank 0 (sdata[32]) → 2-way conflict
一个bank读一个float, 一次读最多32个float,否则就会有bank conflict
访存延迟隐藏
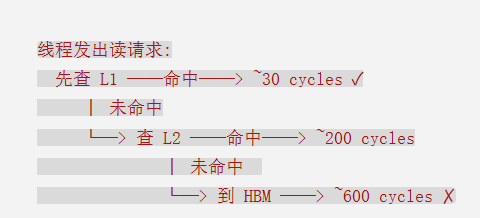
原理 :SM 在等一个 warp 的数据时,立刻切到另一个已就绪的 warp 继续干活关键 :活跃 warp 越多,越能掩盖 ~600 cycles 的 HBM 延迟你的代码 :occupancy 不低,但 __syncthreads() 把所有 warp 都卡在 barrier,硬件没法切换,访存延迟完全暴露
因此,本朴素实现,可能优化的点有 :
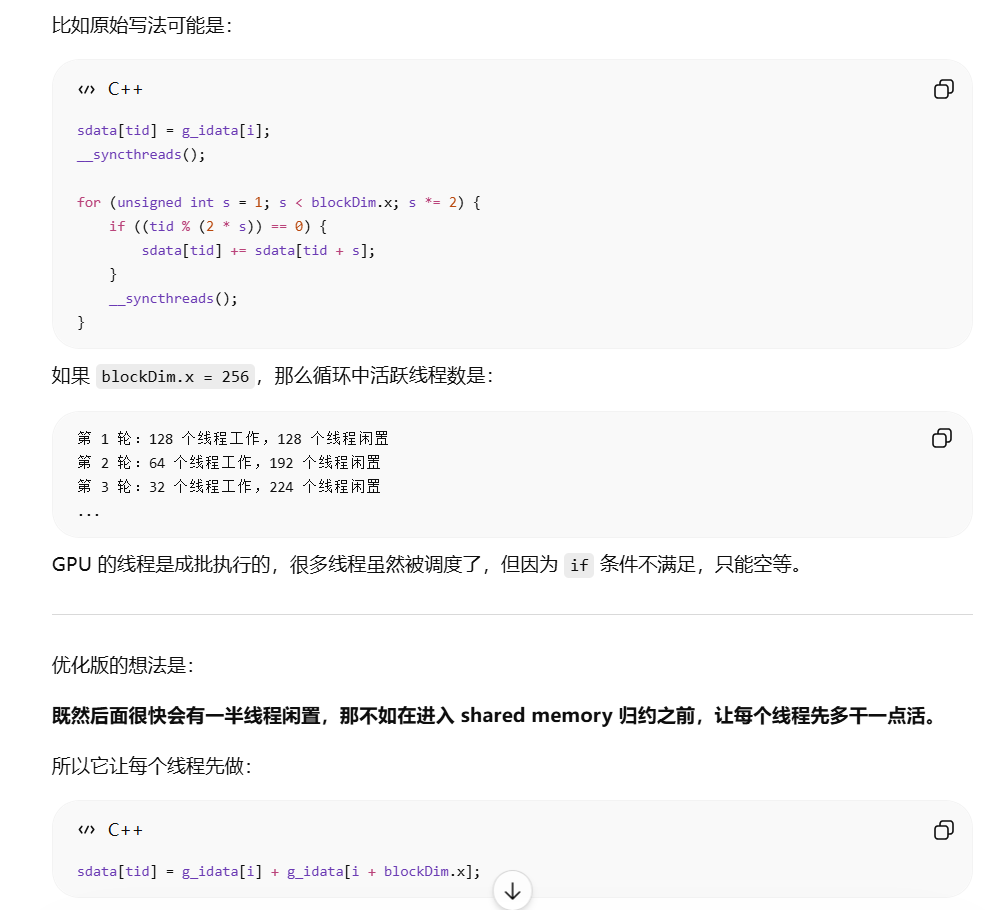
线程闲置 (从block的总体的thread来看)(活跃thread总数越来越少 )
因为采用两两归约方式,从最开始block所有thread/2, 后面每次减半
总的来说就是参与计算的线程数过少。
warp 线程束分化 ,导致warp的效率低(每个warp内的活跃线程越少 )
导致warp效率不高
存储体冲突 (bank conflict)
因为活跃线程间隔分散,导致不同warp的同位置活跃
循环展开最后一个warp 当逐渐归约到只剩下编号在0-31的thread之后,其实就只剩下一个warp在SM里面执行了。
此时,这些线程在硬件层面是以 SIMT(Single Instruction, Multiple Thread) 模式同步执行的
所以此时,已经没有必要 再调用__syncthreads()来进行同步了。
在这个阶段,也没必要条件判断来筛选计算的线程了,直接算得了 ,没必要两两归约了
所以在归约的循环的后期,(tid < 32)对归约操作进行手动展开,直接执行对应的加法操作,从而消除分支判断和同步开销。
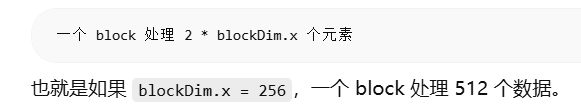
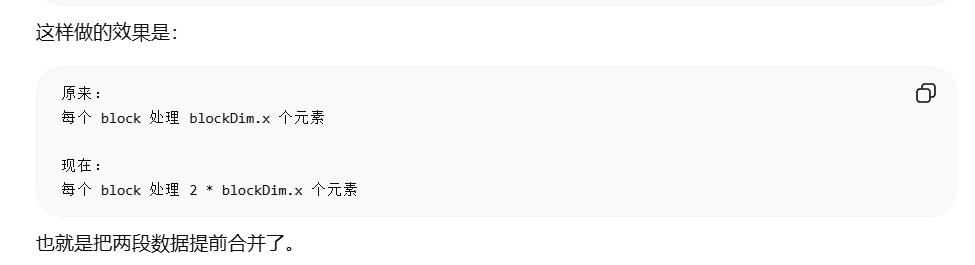
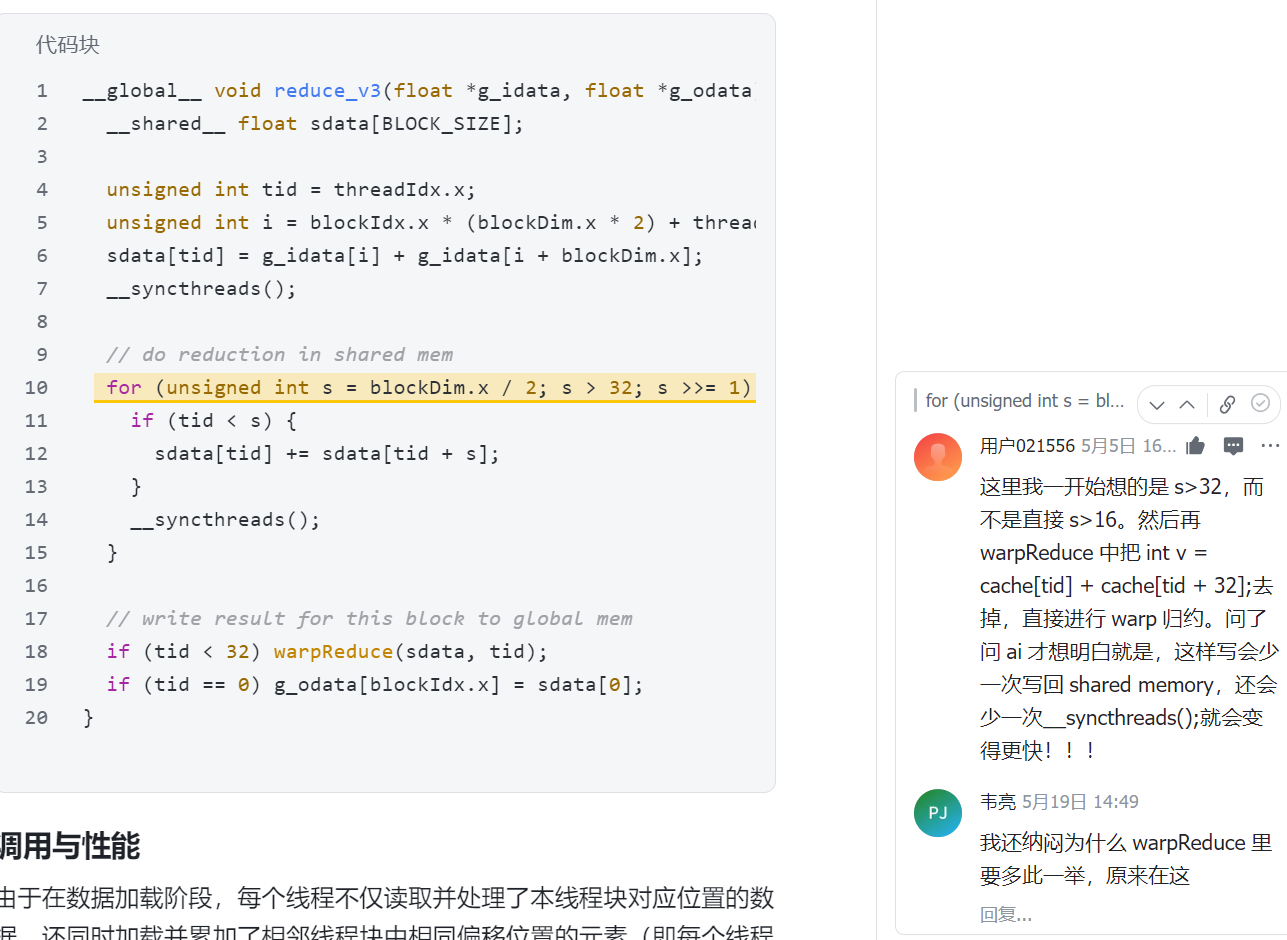
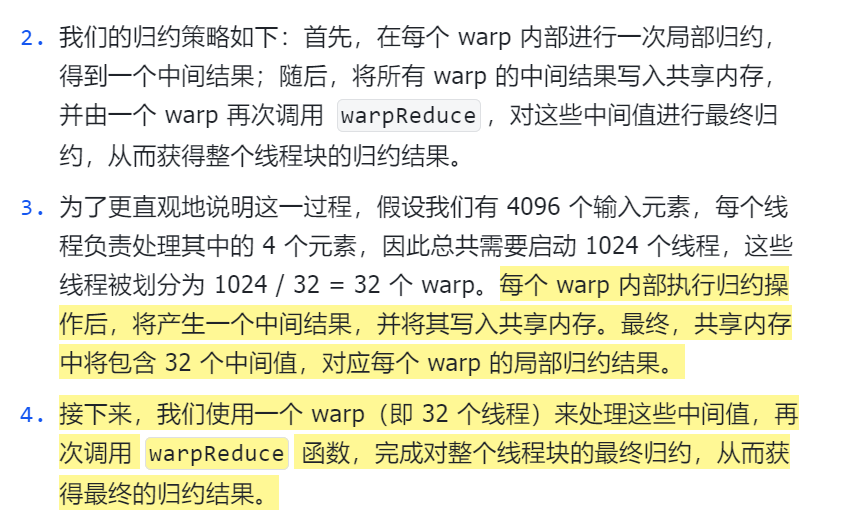
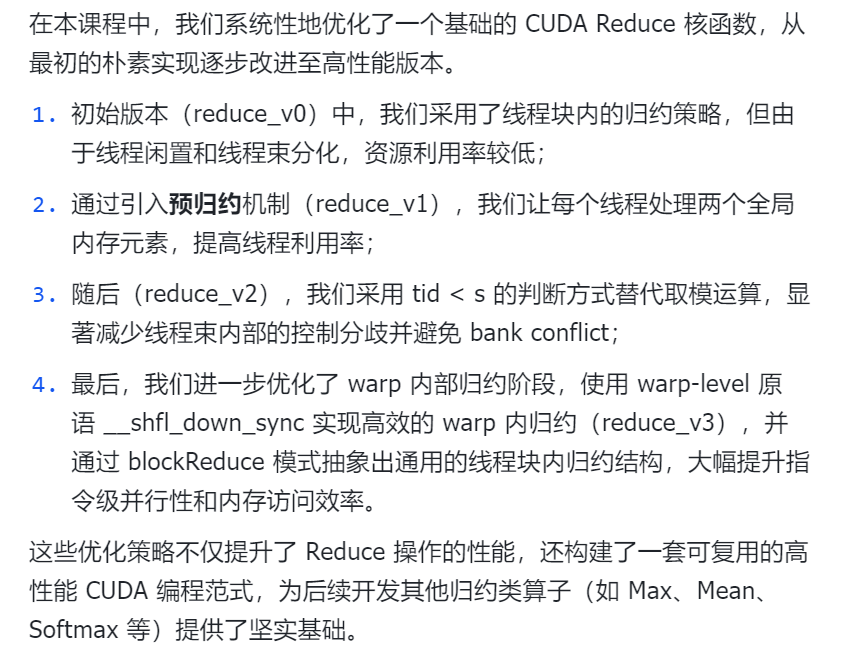
优化1:线程闲置(活跃越来越少) 策略:在归约循环前增加一次额外的预归约 操作。
#include <iostream> #include <cuda_runtime.h> #include <chrono> #include <numeric> #include <vector> using namespace std;const int BLOCK_SIZE = 1024 ;const int N = 1024 * 1024 ; __global__ void reduce_v1 (float * g_idata, float * g_odata) { __shared__ float sdata[BLOCK_SIZE]; unsigned int tid = threadIdx.x; unsigned int i = blockIdx.x * blockDim.x*2 + threadIdx.x; sdata[tid] = g_idata[i] + g_idata[i + blockDim.x]; __syncthreads(); for (int s=1 ; s<blockDim.x;s*=2 ){ if (tid % (2 *s) == 0 ){ sdata[tid] += sdata[tid + s]; } __syncthreads(); } if (tid == 0 ) g_odata[blockIdx.x] = sdata[0 ]; } float reduce_cpu (const std::vector<float > &data) float sum = 0.0f ; for (float val : data) { sum += val; } return sum; } int main () int num_blocks = ((N + BLOCK_SIZE - 1 ) / BLOCK_SIZE)/2 ; cout << "num_blocks = " <<num_blocks <<endl; std::vector<float > h_data (N) ; for (int i = 0 ; i < N; i++) { h_data[i] = 1.0f ; } auto cpu_start = std::chrono::high_resolution_clock::now (); float cpu_result = reduce_cpu (h_data); auto cpu_end = std::chrono::high_resolution_clock::now (); std::chrono::duration<double , std::milli> cpu_duration = cpu_end - cpu_start; std::cout << "CPU result: " << cpu_result << std::endl; std::cout << "CPU time: " << cpu_duration.count () << " ms" << std::endl; float *d_data, *d_result; float *d_final_result; float gpu_result; cudaMalloc (&d_data, N * sizeof (float )); cudaMalloc (&d_result, num_blocks * sizeof (float )); cudaMalloc (&d_final_result, 1 * sizeof (float )); cudaMemcpy (d_data, h_data.data (), N * sizeof (float ), cudaMemcpyHostToDevice); cudaEvent_t start, stop; cudaEventCreate (&start); cudaEventCreate (&stop); cudaEventRecord (start); reduce_v1<<<num_blocks, BLOCK_SIZE>>>(d_data, d_result); reduce_v1<<<1 , num_blocks/2 >>>(d_result, d_final_result); cudaEventRecord (stop); cudaEventSynchronize (stop); float milliseconds = 0 ; cudaEventElapsedTime (&milliseconds, start, stop); std::cout << "GPU kernel time: " << milliseconds << " ms" << std::endl; cudaMemcpy (&gpu_result, d_final_result, sizeof (float ), cudaMemcpyDeviceToHost); std::cout << "GPU result: " << gpu_result << std::endl; if (abs (cpu_result - gpu_result) < 1e-5 ) { std::cout << "Result verified successfully!" << std::endl; } else { std::cout << "Result verification failed!" << std::endl; } cudaFree (d_data); cudaFree (d_result); cudaFree (d_final_result); cudaEventDestroy (start); cudaEventDestroy (stop); return 0 ; }
num_blocks = 512
CPU result: 1.04858e+06
CPU time: 2.79929 ms
GPU kernel time: 0.054144 ms
GPU result: 1.04858e+06
Result verified successfully!
此时有两点改进:
显存带宽利用率显著提升:
每个block的thread都被利用了,读取全局内存+相加+写入寄存器同一条流水线,消除空泡
每个thread每次读两个float,读取效率翻倍
但是此时,线程束分化的问题还是存在。
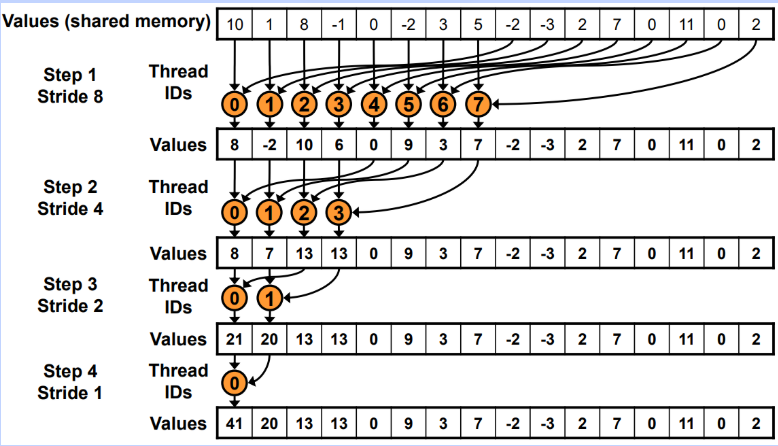
优化2:线程束分化(活跃thread分散)+ bank conflict 解决办法就是越来越集中。
原来是相邻两个活跃thread进行归约,
现在是二分后,等分的后半部分的thread,归约到前半段。
其实这里也优雅的解决了bank conflict的问题
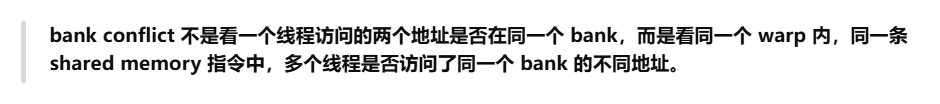
我们说的bank conflict 是多个thread,访问同一个bank
#if 0 for (int s=1 ; s<blockDim.x;s*=2 ){ if (tid % (2 *s) == 0 ){ sdata[tid] += sdata[tid + s]; } __syncthreads(); } #else for (int s = blockDim.x / 2 ; s >=1 ; s >>=1 ){ if (tid < s){ sdata[tid] += sdata[tid + s]; } __syncthreads(); } #endif
这里改动后,这一版的线程不再发散了,SM利用率和调度器发射率显著提升。
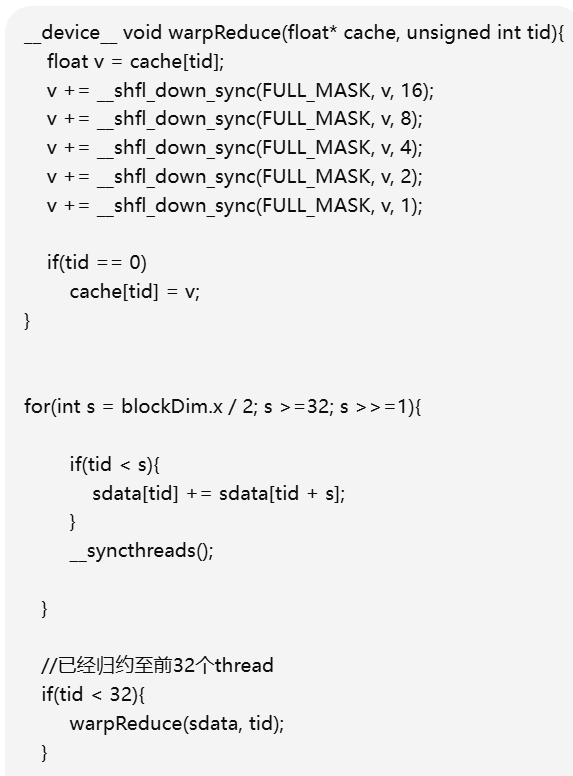
优化3:展开最后一个warp 就是说,当归约到就剩前32个thred之后,就已经处于一个warp里面了,这样就不需要再每次一半访问共享内存了,而是直接warp内归约,直接用寄存器
但是教程里面还有一点技巧
另一种实现方式:BlockReduce 用warp内归约,warpReduce的基础上,进一步构建blockReduce,来实现整个block内的归约操作。
__inline__ __device__ float block_reduce (float val) { const int tid = threadIdx.x; const int warpSize = 32 ; #pragma unroll for (int offset = warpSize / 2 ; offset > 0 ; offset /= 2 ) val += __shfl_down_sync(0xFFFFFFFF , val, offset); __shared__ float warpSum[32 ]; if (tid % warpSize == 0 ) { warpSum[tid / warpSize] = val; } __syncthreads();
#pragma unroll 告诉 nvcc 强制展开 这个循环。
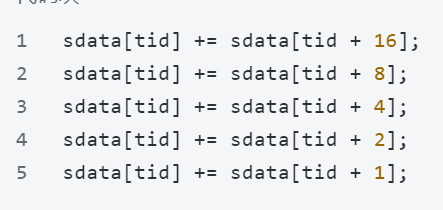
这个循环只有 5 次迭代(offset = 16, 8, 4, 2, 1),展开后等价于:
val += __shfl_down_sync(0xFFFFFFFF, val, 16);
val += __shfl_down_sync(0xFFFFFFFF, val, 8);
val += __shfl_down_sync(0xFFFFFFFF, val, 4);
val += __shfl_down_sync(0xFFFFFFFF, val, 2);
val += __shfl_down_sync(0xFFFFFFFF, val, 1);
三个好处:
消除循环开销 — 不用计数器、不用比较、不用跳转,5 条指令直接排开编译期优化 — offset 变成编译期常量,nvcc 可以更好地做指令调度和寄存器分配确定性 — 虽然 nvcc 对小循环通常会自动展开,但加 #pragma unroll 是强制保证,避免编译器”犯懒”
总结
矩阵乘 Matmul 基础 基础实现
我们认为,当前的实现方式带来了3个显著的性能瓶颈:
全局内存访问延迟高 :每个线程都要从全局内存中加载输入矩阵 A 和 B 的数据,访问延迟较高,严重限制了整体吞吐效率;
计算密度低,硬件利用率差 :每个线程仅执行一次规约计算(即一次点积中的部分乘加),却需要多次访问全局内存,造成计算/访存比(compute-to-memory ratio)极低;
两次浮点运算,需要两次访问全局内存,效率极低
缺乏对共享显存的有效利用 :访问模式缺乏数据复用,GPU 的缓存机制无法发挥应有的加速作用。
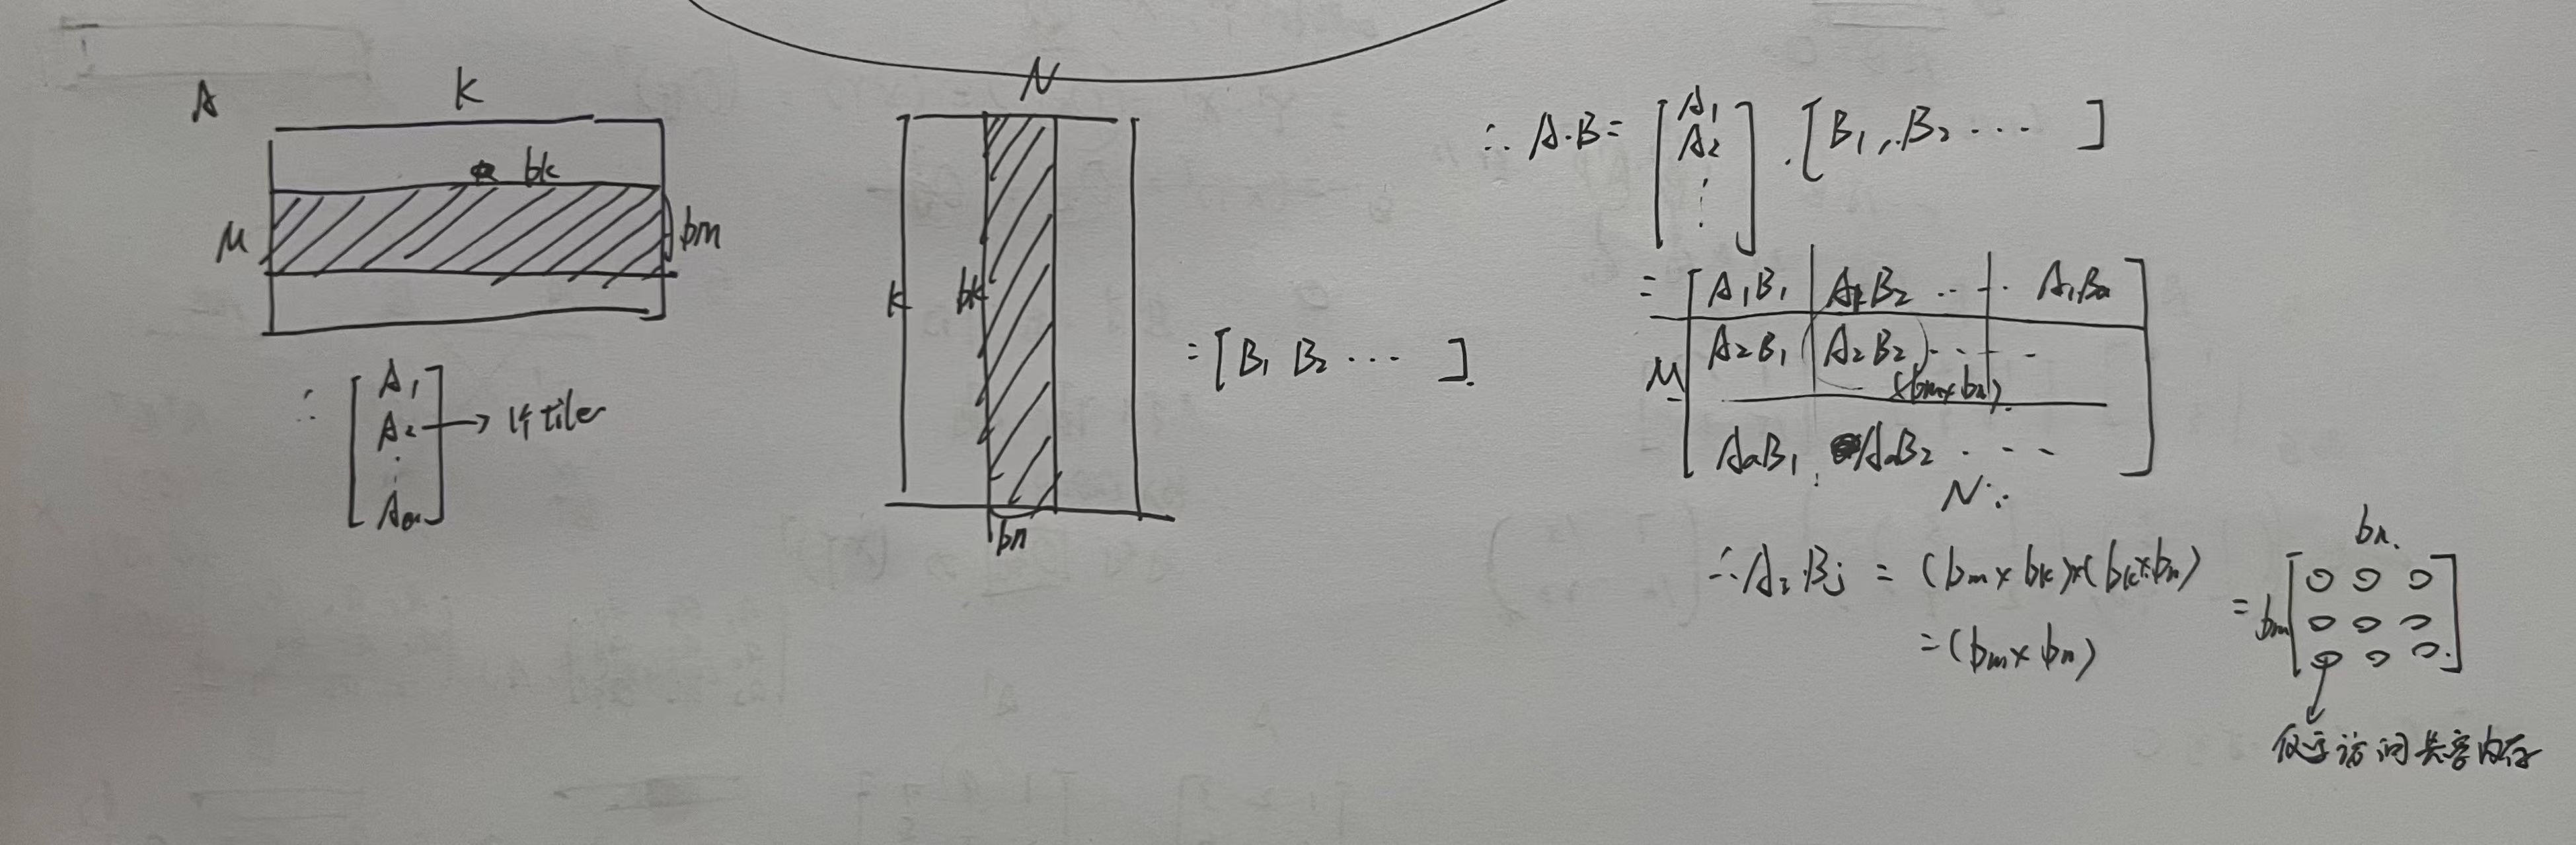
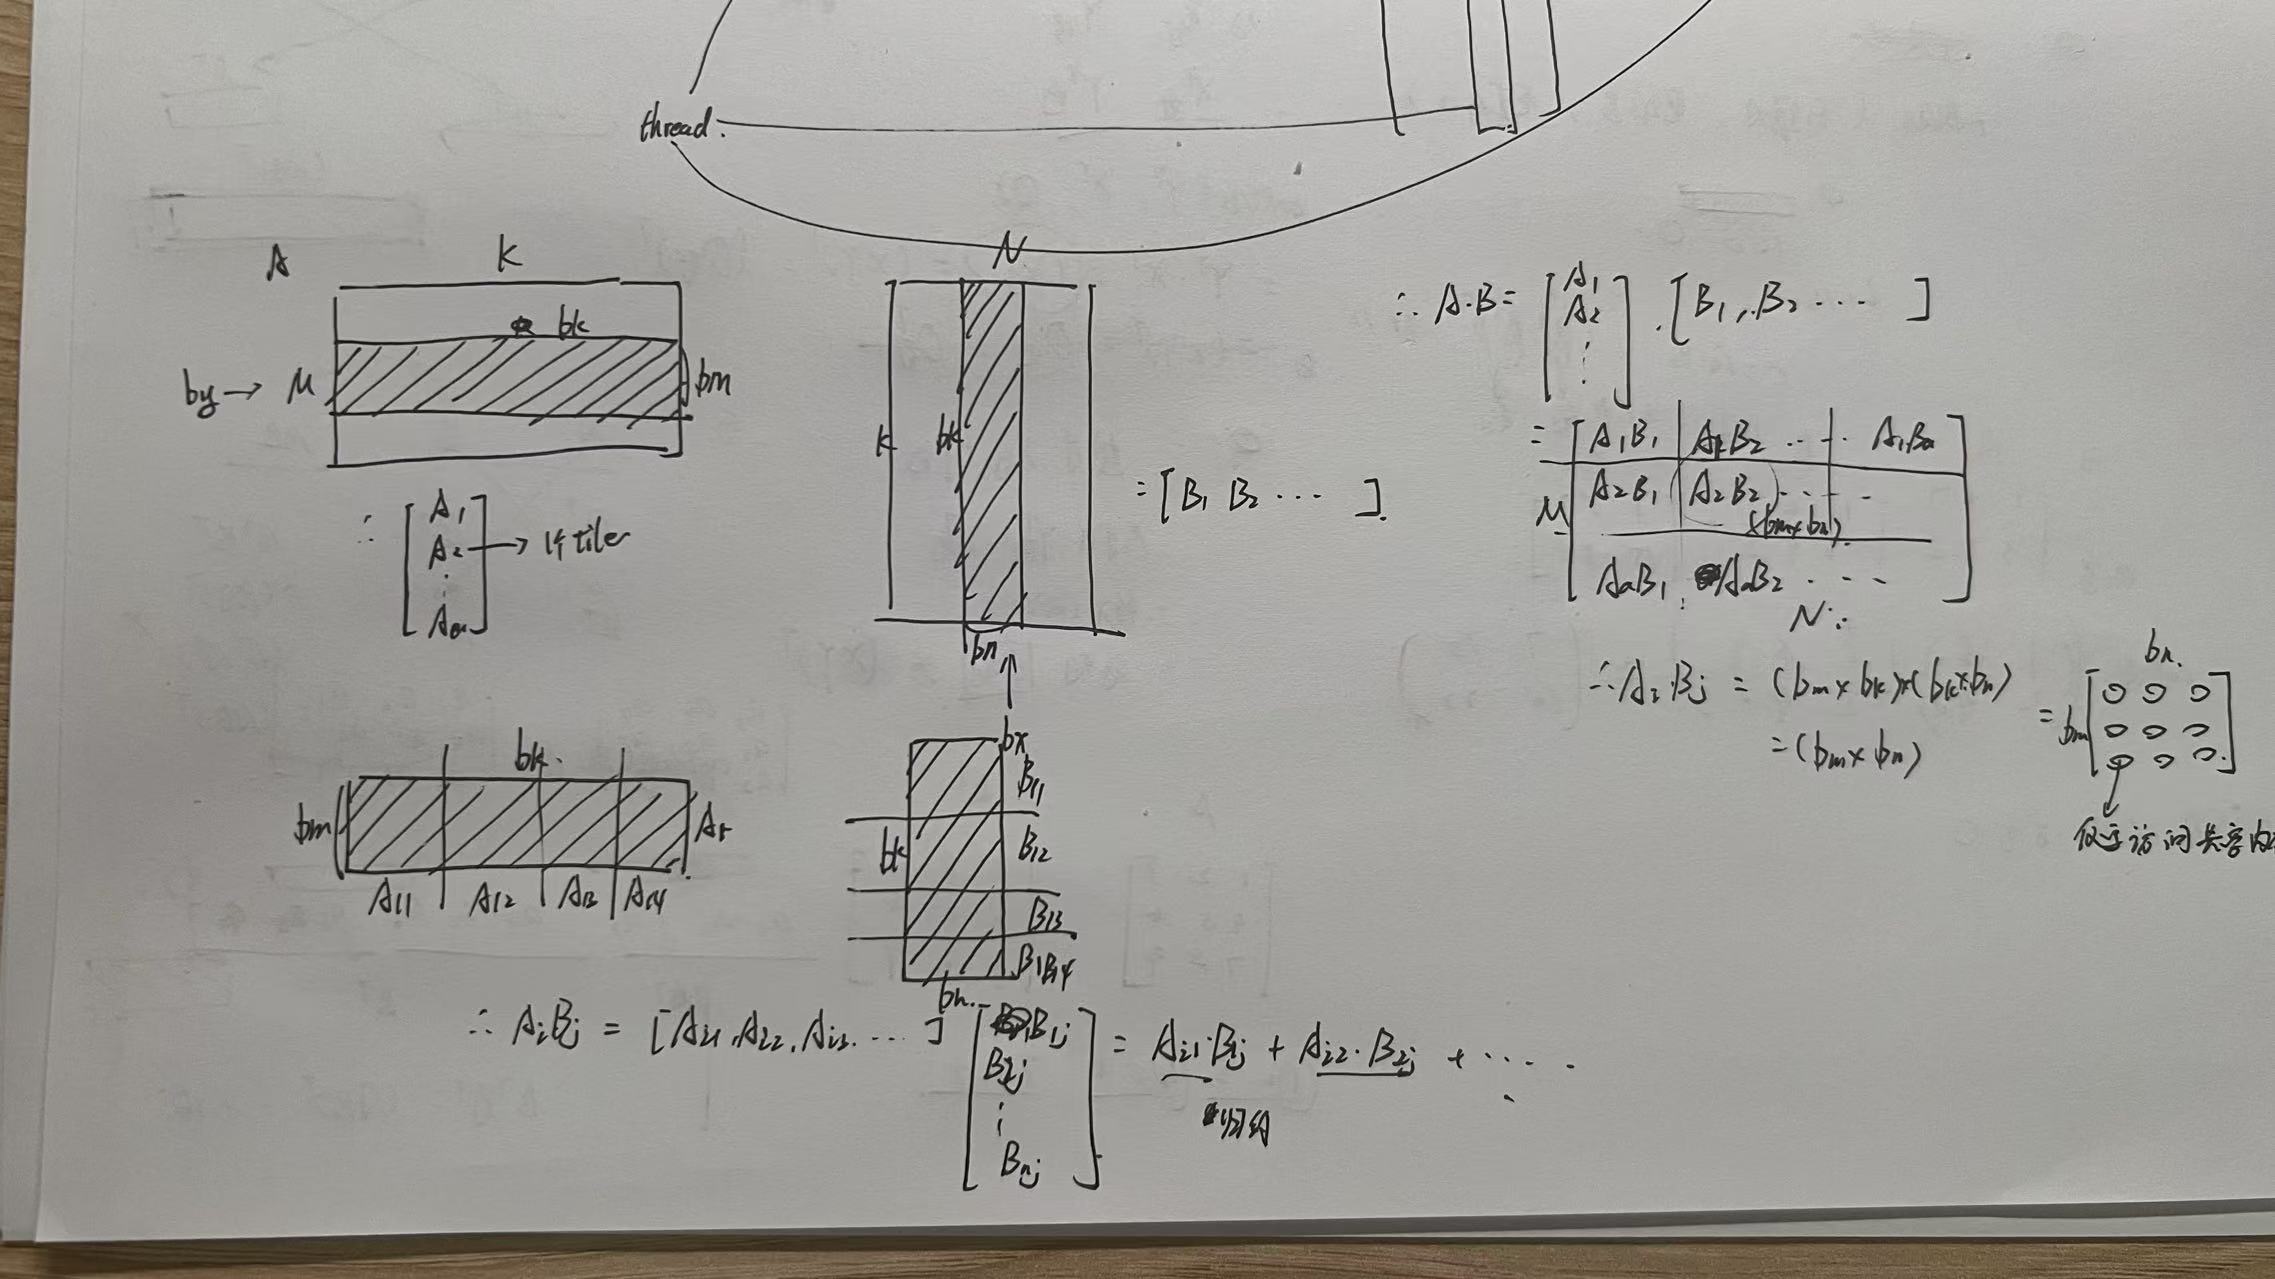
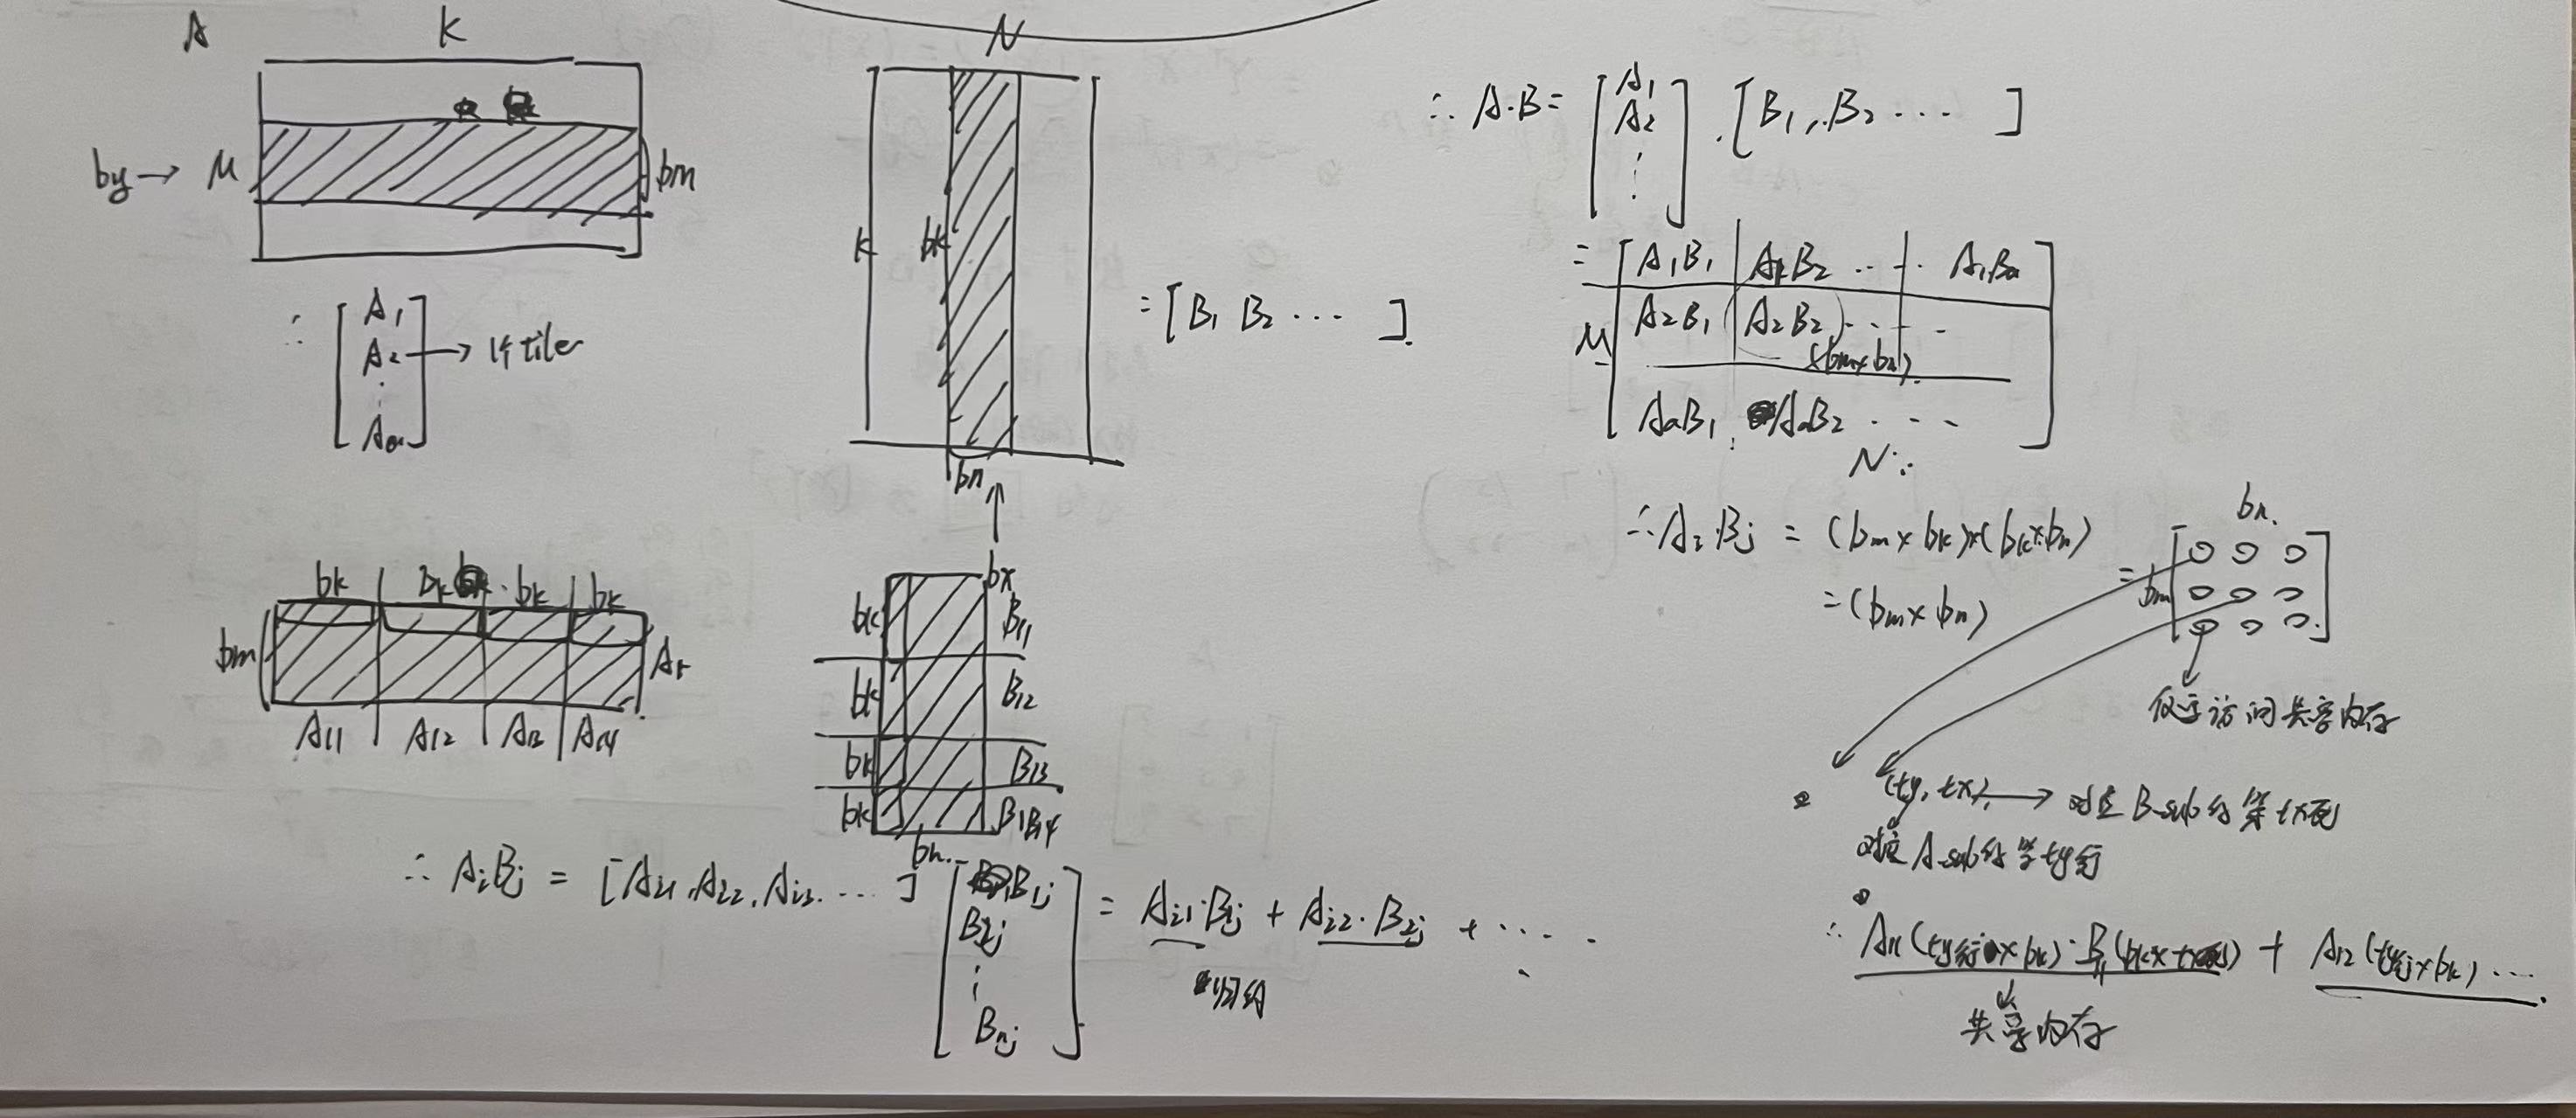
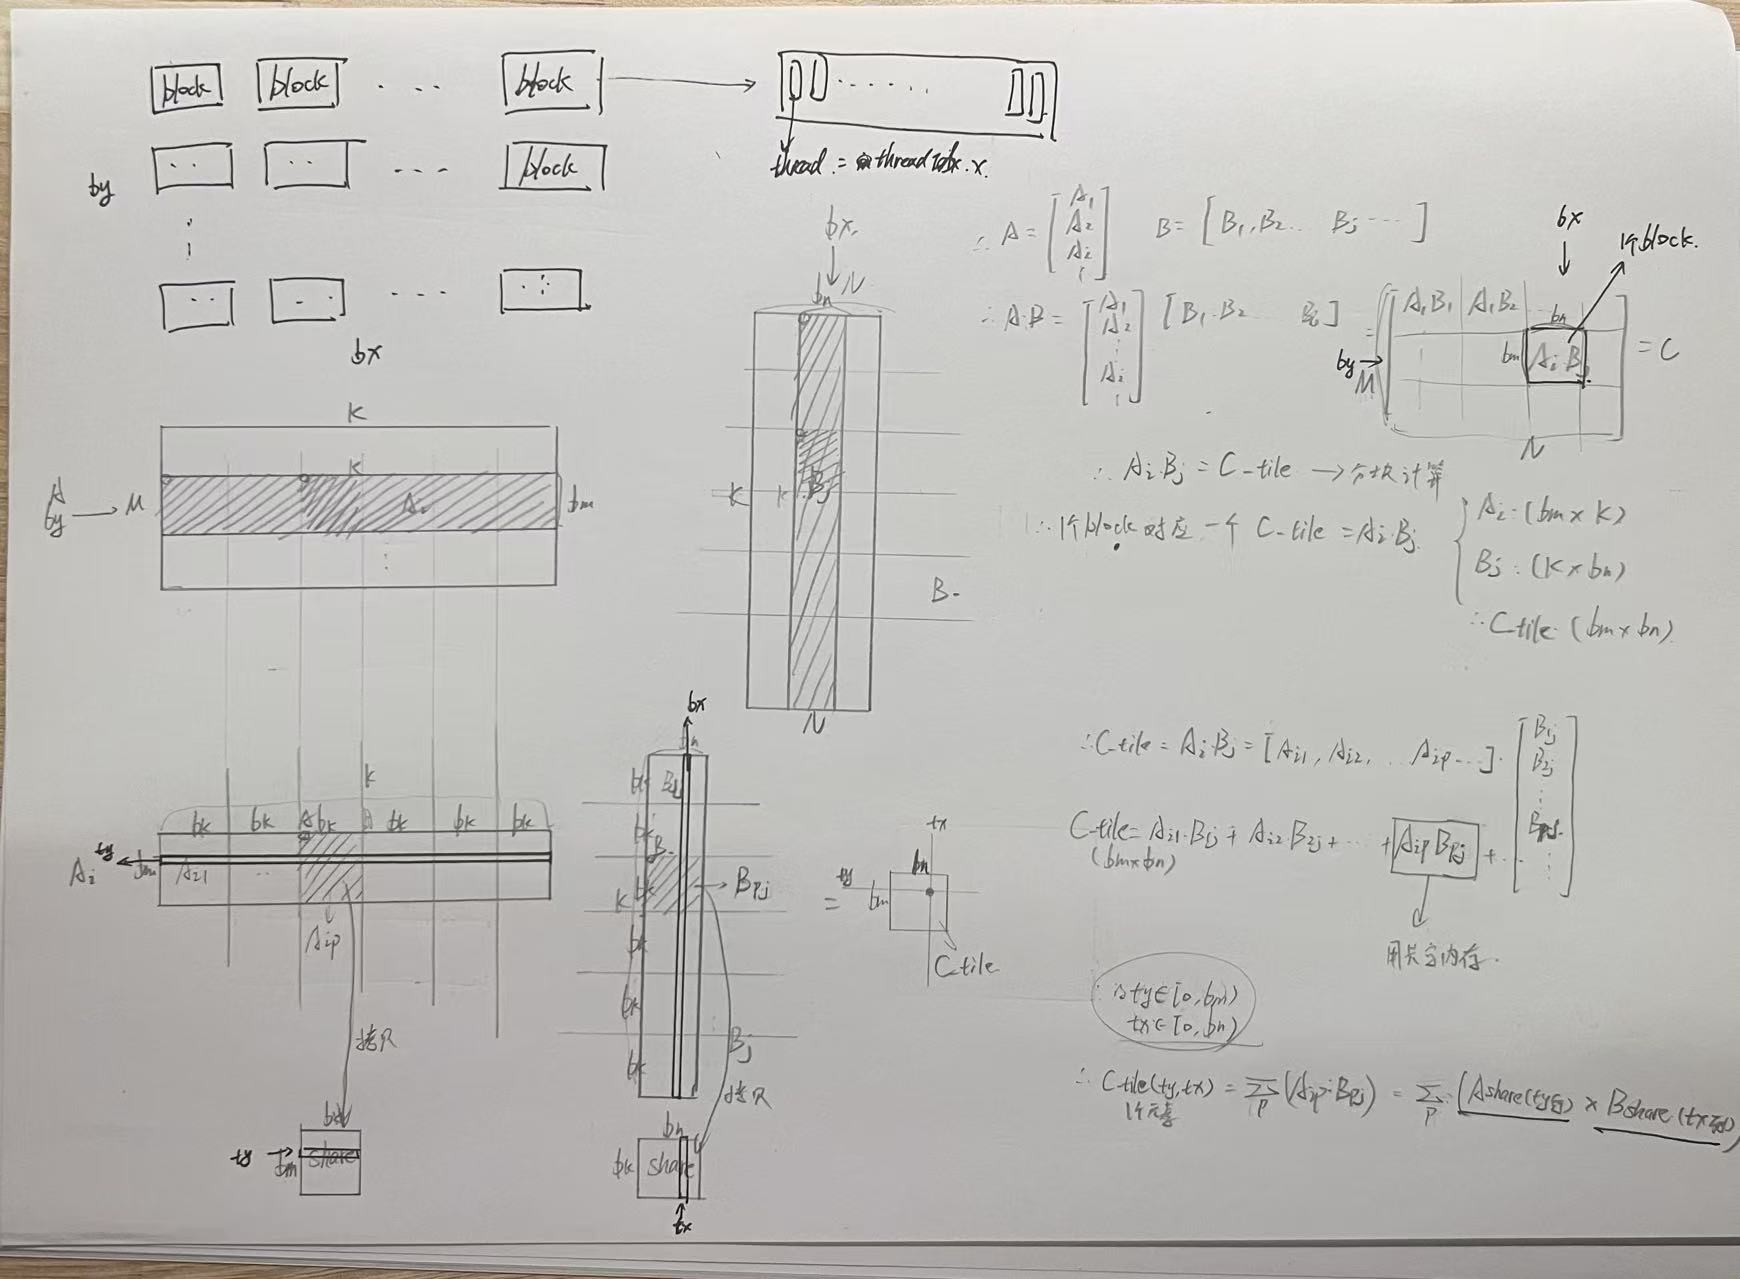
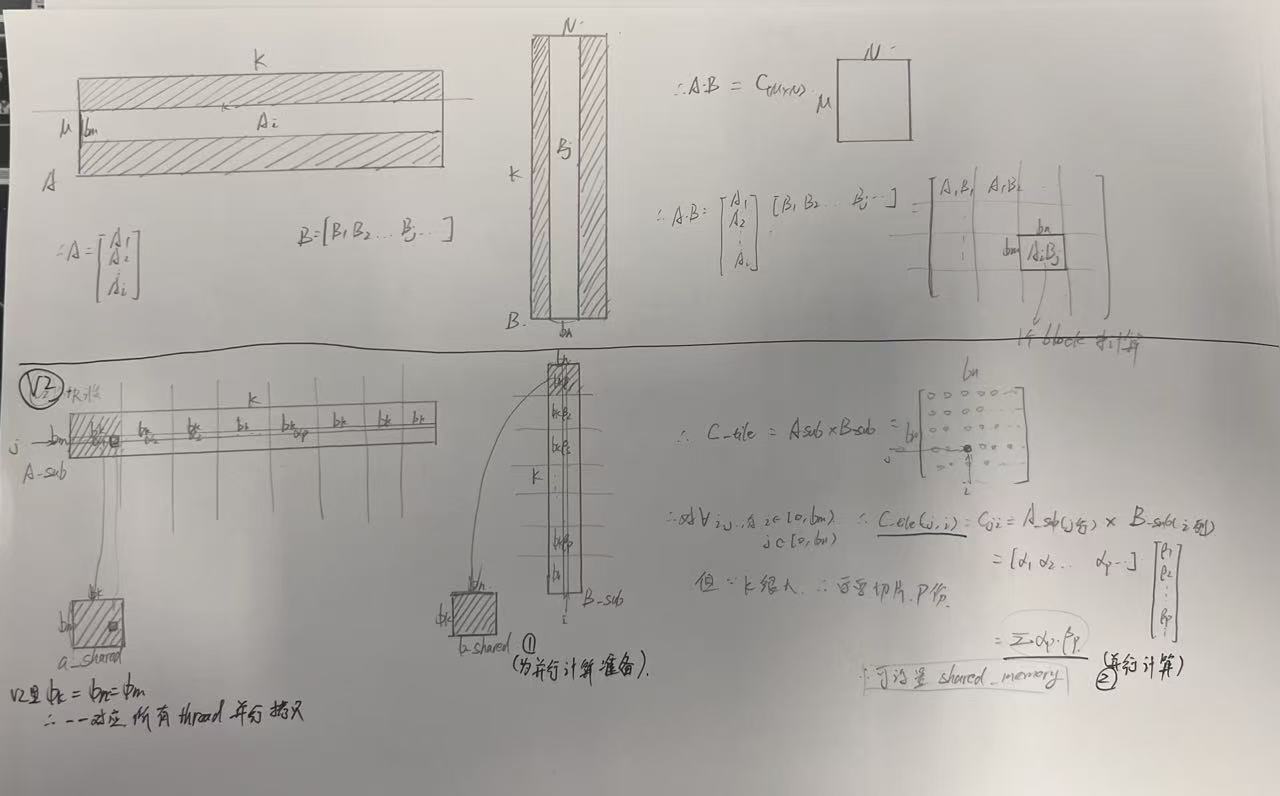
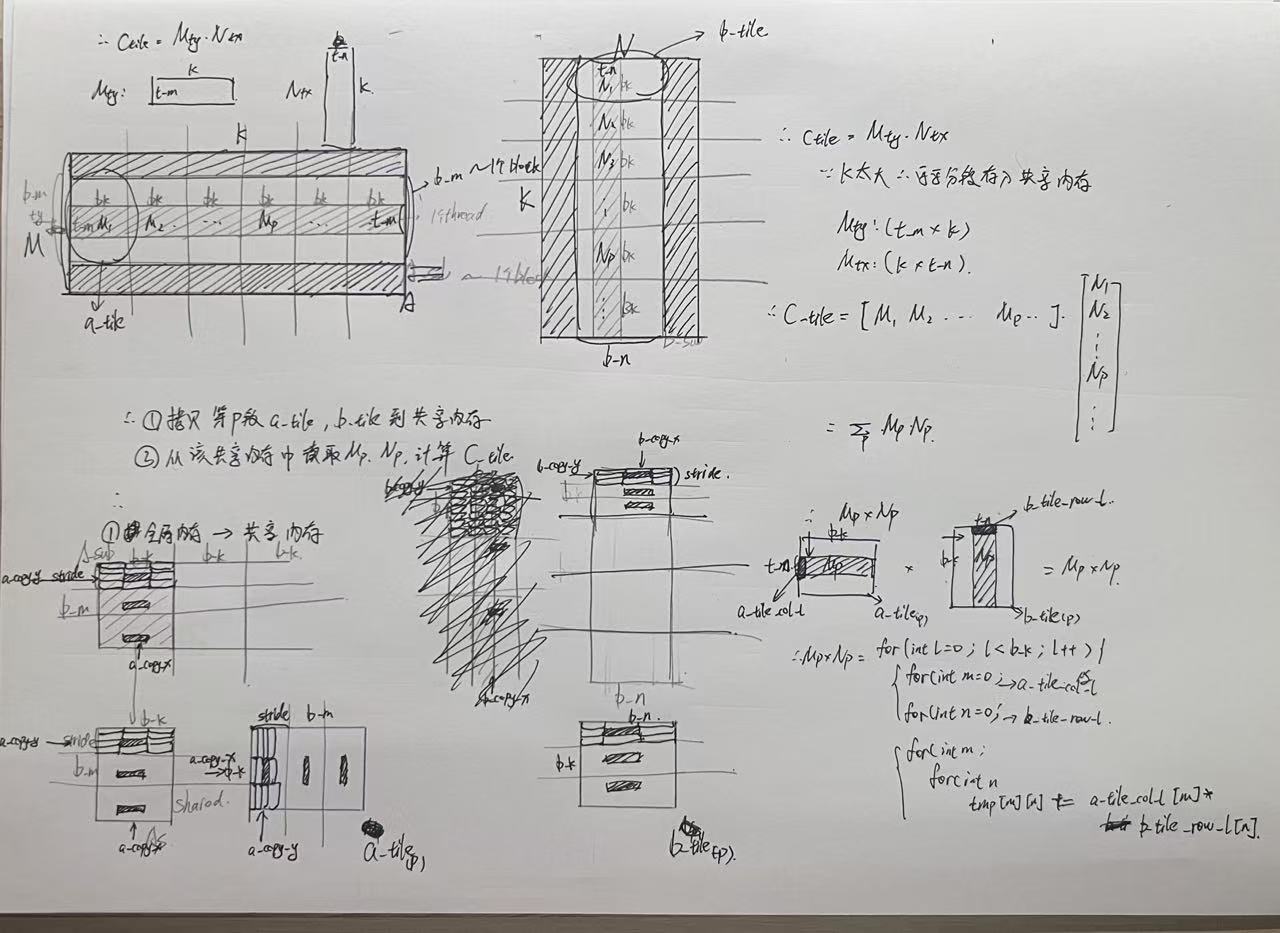
优化:共享内存 核心思路就是:不要让每个 thread 每次都直接从 global memory 读 A 和 B,而是让一个 block 先把一小块 A 和一小块 B 搬到 shared memory,然后 block 内的 thread 反复复用这些数据
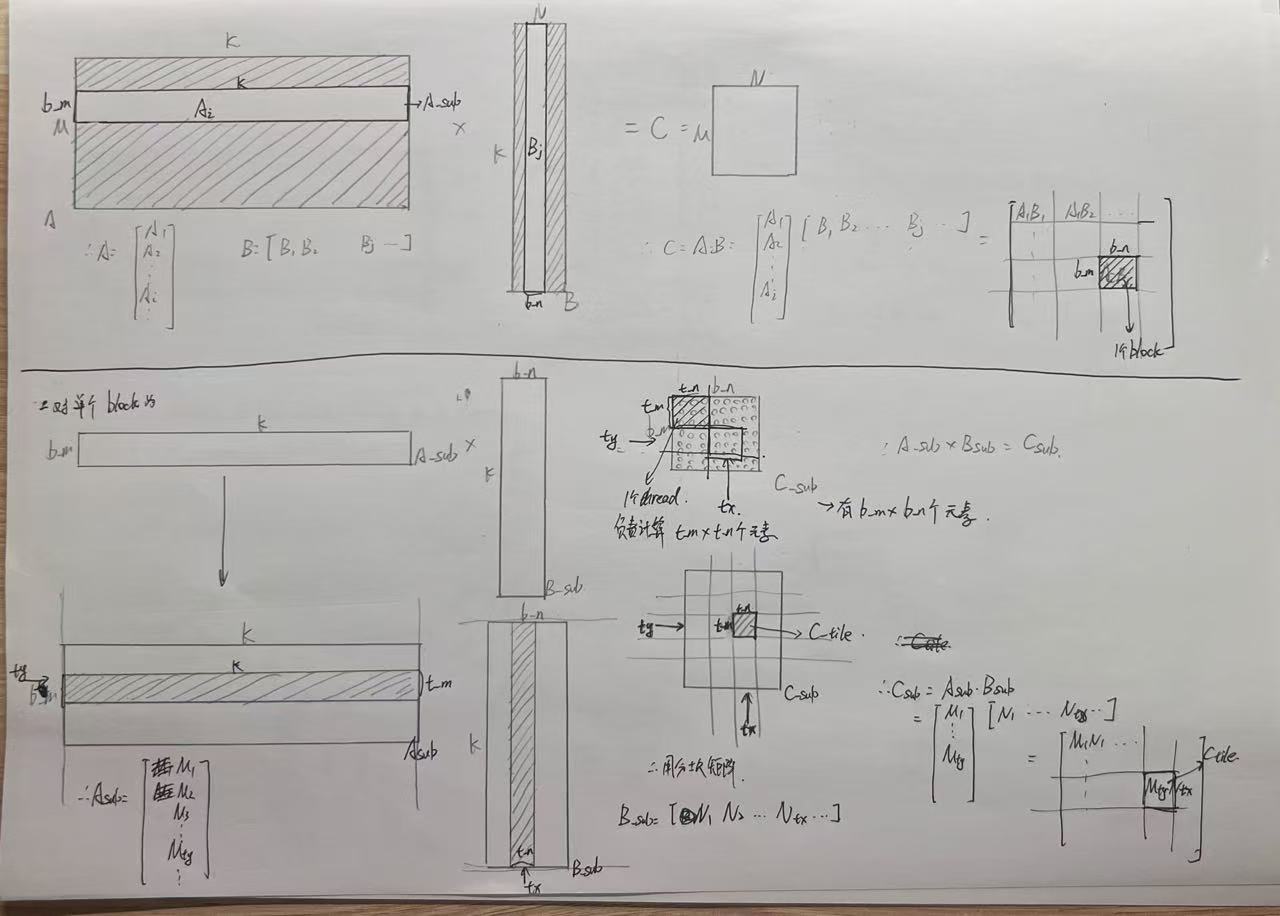
本质上就是利用分块矩阵的乘法 ,一个block来计算一个分块矩阵的乘法,
这样对于某一个 block 正在处理的这一轮 K 分块,A_tile 和 B_tile 从 global memory 加载一次到 shared memory,然后被 block 内很多线程反复复用。
这样输出矩阵中这个分块矩阵里面所有元素的计算都仅需要访问共享内存即可
假设每个A的子矩阵是(32x1024)
但是这样有一个需要注意的点,如果需要一个block来计算C_tile (b_m x b_n)
那么所需要的共享内存为2 x (32 x 1024) 太大了。
所以这里每个block不是一次性拷贝A,B的分块。而是分批拷贝
所以定义的共享内存是 2 x (32 x 32)
重新梳理一下就是:
#define SUB_SIZE 32 __global__ void mysgemm_v2 (int M, int N, int K, float alpha, float *A, float * B, float beta, float *C) int blocks_x = blockIdx.x; int blocks_y = blockIdx.y; const int b_m = SUB_SIZE; const int b_n = SUB_SIZE; const int b_k = SUB_SIZE; int ty = threadIdx.x / b_n; int tx = threadIdx.x % b_n; __shared__ float As[b_m * b_k]; __shared__ float Bs[b_k * b_n]; A = &A[blocks_y*b_m*K]; B = &B[blocks_x*b_n]; C = &C[blocks_y*b_m*N+blocks_x*b_n]; float tmp = 0.0f ; for (int k = 0 ; k<K; k+=b_k){ As[ty*b_k + tx] = A[ty*K + tx]; Bs[ty*b_n + tx] = B[ty*N + tx]; __syncthreads(); A += b_k; B += N*b_k; for (int i =0 ; i<b_k; i++){ tmp += As[ty*b_k + i] * Bs[i*b_n + tx]; } __syncthreads(); } C[tx + ty*N] = alpha*tmp + beta*C[tx + ty*N]; }
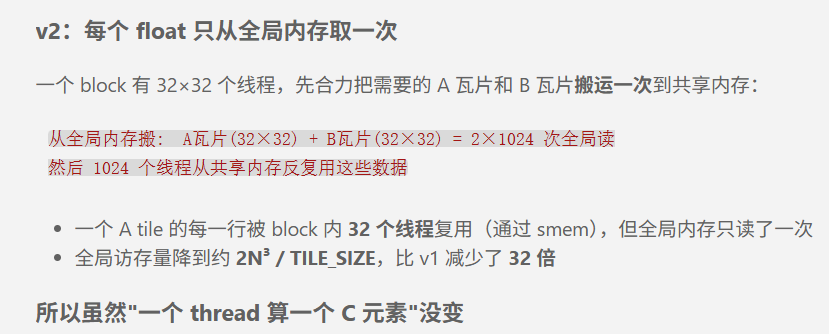
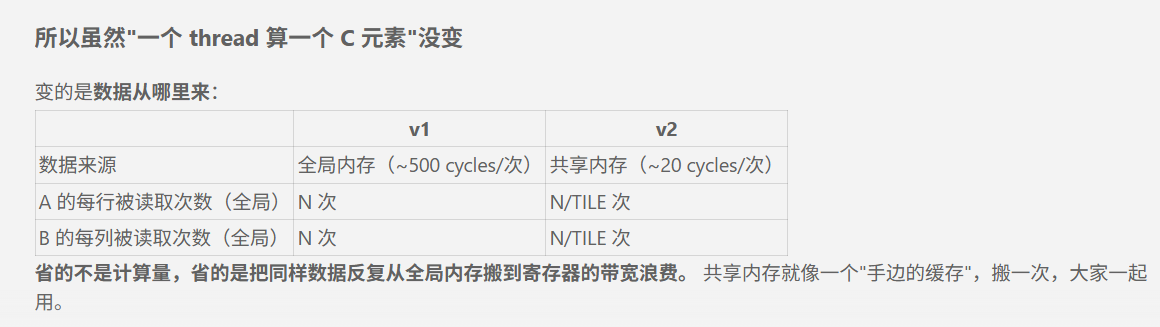
这样可以减少拷贝重复 ,v2里面,每个thread仅仅拷贝对应位置的float ,所以整个全局内存的每个float仅仅被访问过一次 。
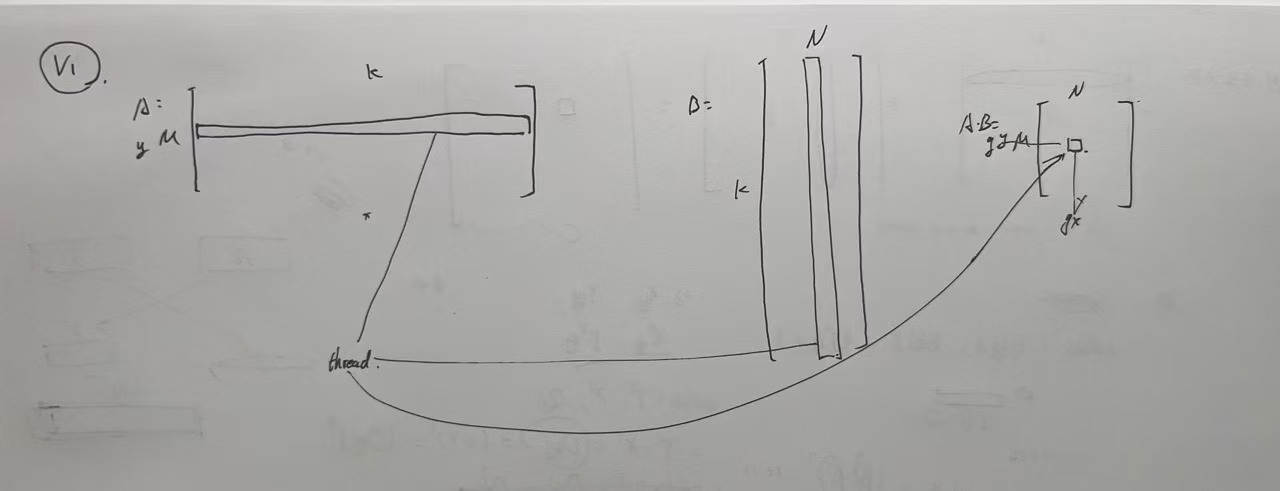
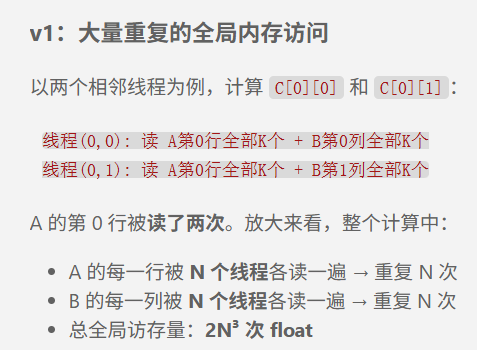
v1里面,相邻两个C元素的计算,访问的全局内存,有一半都是重复的。
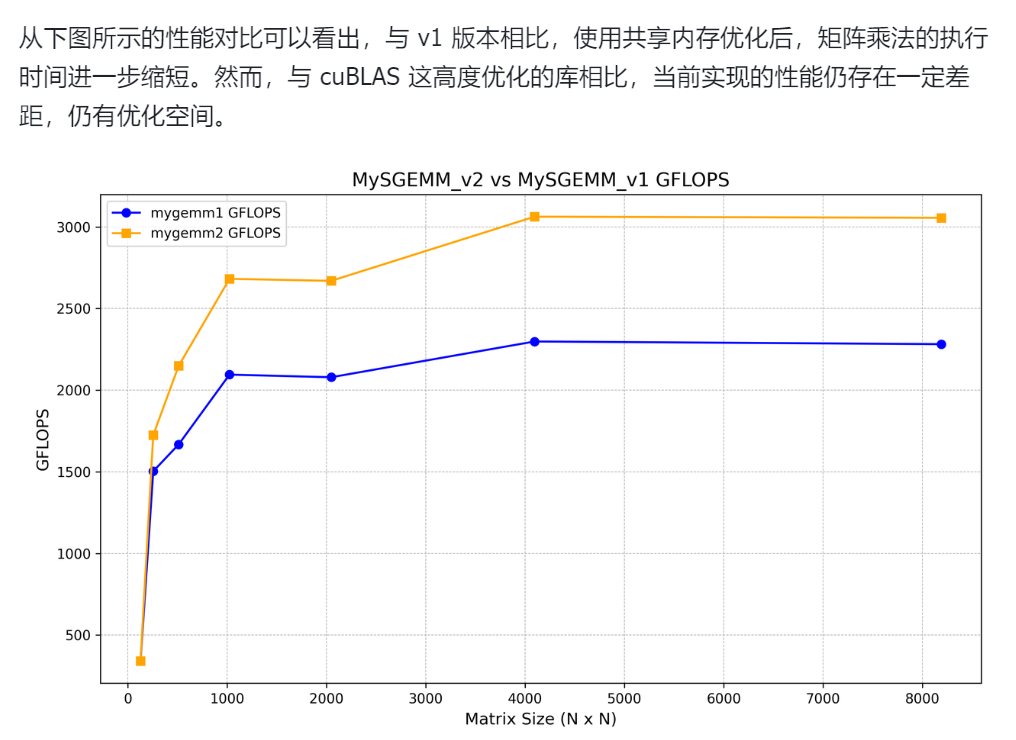
分析软件也给出了优化建议
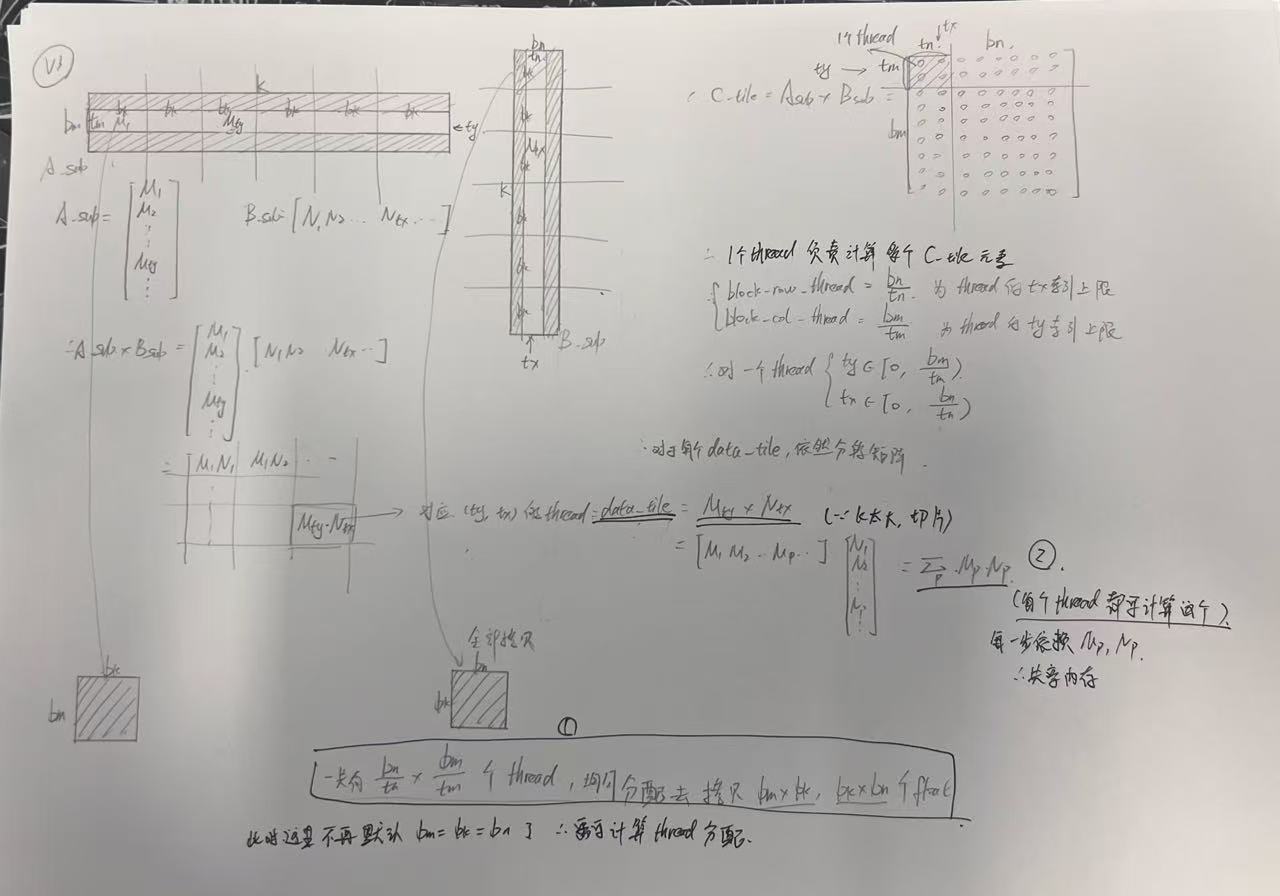
优化:Thread Tile 上面的两种优化实现思路,我们依然是保持,每个thread仅计算C中的一个元素 。这会导致计算访存比 (Compute-to-Memory Ratio)并未得到明显改善,因为每个计算迭代依然需要两次访存操作 (加载 A 和 B 的数据)和一次计算操作,访存瓶颈依然存在
大白话就是说:现在每个thread计算C的元素,依然要从全局内存中访问对应的A的一行,B的一列,只不过,把他们打包然后一起拷贝到共享内存中一起算。但是每个thread都需要访存 。
现在引入了 thread tile(线程瓦片) 技术
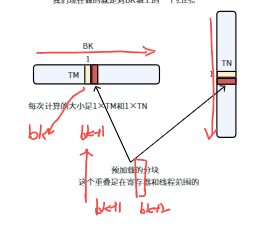
不再让一个线程处理一个数据元素,而是让每个线程负责处理一个大小为 TM×TN 的数据 tile
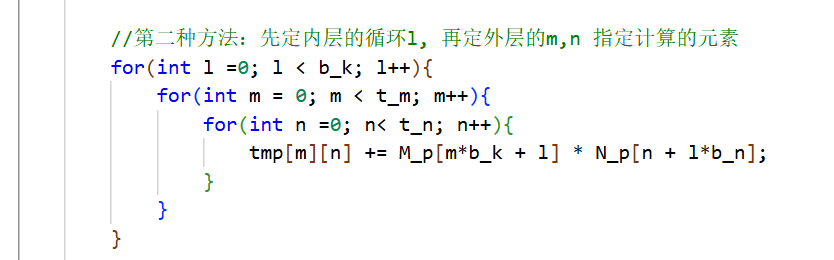
template <const int b_m, const int b_k, const int b_n, const int t_m, const int t_n>__global__ void mysgemm_v3 (int M, int N, int K, float alpha, float *A, float * B, float beta, float *C) { int blocks_y = blockIdx.y; int blocks_x = blockIdx.x; int thread_num = (b_n / t_n) * (b_m / t_m); if (threadIdx.x >= thread_num){ return ; } A = &A[blocks_y *b_m* K]; B = &B[blocks_x*b_n]; int ty = threadIdx.x / (b_n / t_n); int tx = threadIdx.x % (b_n / t_n); C = &C[blocks_y*b_m*N + blocks_x*b_n + ty*t_m*N + tx*t_n]; __shared__ float As[b_m*b_k]; __shared__ float Bs[b_k*b_n]; int a_copy_y = threadIdx.x / b_k; int a_copy_x = threadIdx.x % b_k; int a_copy_stride = thread_num/b_k; int b_copy_y = threadIdx.x / b_n; int b_copy_x = threadIdx.x % b_n; int b_copy_stride = thread_num / b_n; float tmp[t_m][t_n] = {0.0f }; float * M_p = &As[ty*t_m*b_k]; float * N_p = &Bs[tx*t_n]; for (int i = 0 ; i<K; i+=b_k){ for (int s=0 ; s<b_m;s+=a_copy_stride){ As[(a_copy_y + s)*b_k + a_copy_x]=A[(a_copy_y + s)*K + a_copy_x]; } for (int s=0 ; s<b_k; s+=b_copy_stride){ Bs[(b_copy_y + s)*b_n + b_copy_x] = B[(b_copy_y + s)*N + b_copy_x]; } __syncthreads(); A += b_k; B += b_k*N; for (int l =0 ; l < b_k; l++){ for (int m = 0 ; m < t_m; m++){ for (int n =0 ; n< t_n; n++){ tmp[m][n] += M_p[m*b_k + l] * N_p[n + l*b_n]; } } } __syncthreads(); } for (int i = 0 ; i<t_m;i++){ for (int j =0 ; j<t_n;j++){ C[i*N+j] = alpha*tmp[i][j] + beta*C[i*N + j]; } } }
优化:向量化加载+转置hit
可以看到,前面三个版本,对于每个输出元素,都需要挨个取A向量,B向量的元素,然后乘加。
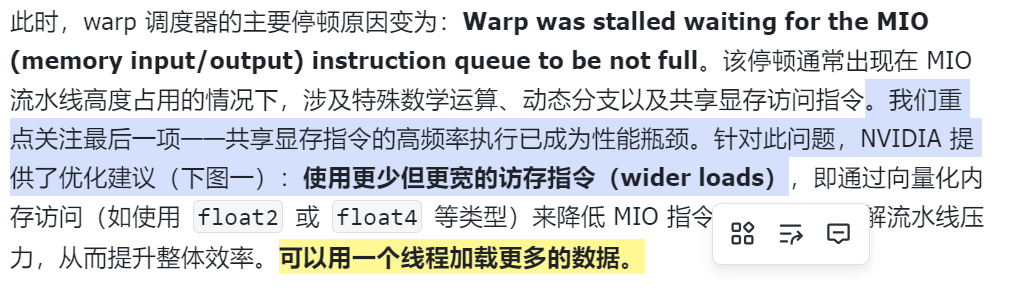
使用向量访存指令 ,一次性读取同一行中的多个元素
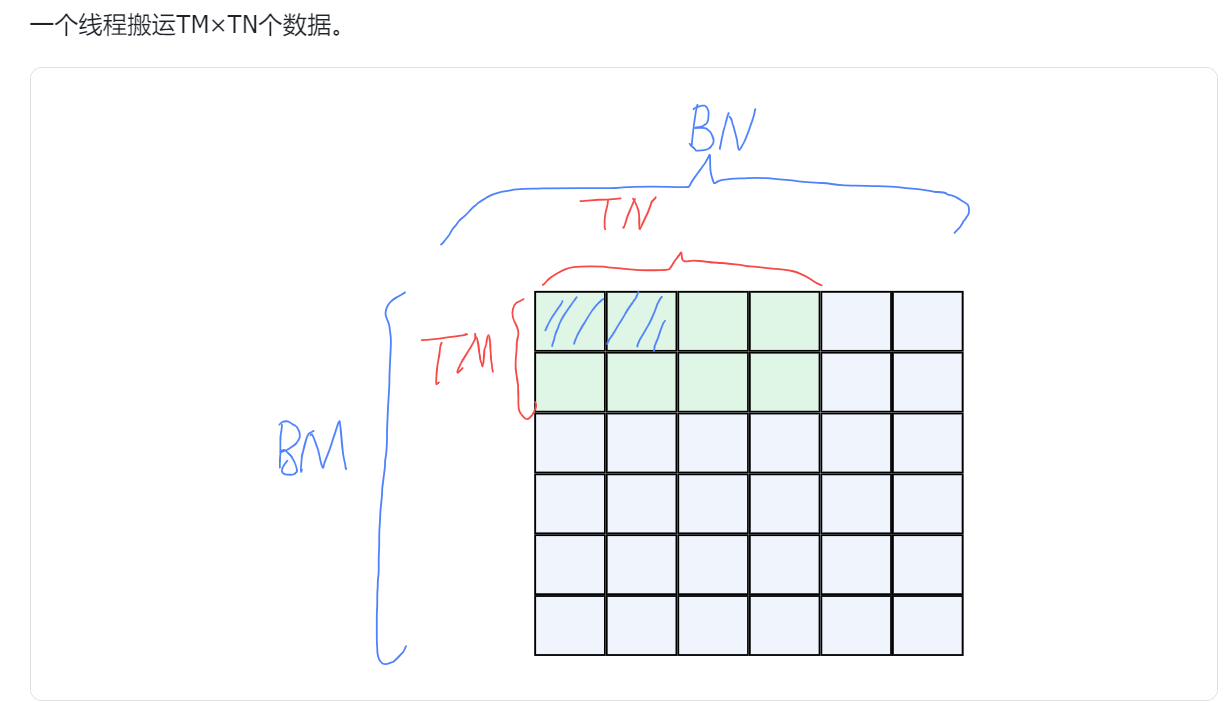
一个线程不仅要读取TM×TN数量的数据,还要用更少的指令进行加载
V4 中,我们的优化重点从计算并行转向了访存向量化
因为是优化的读取全局内存,所以是优化的从A_tile,拷贝到共享内存的这一个部分
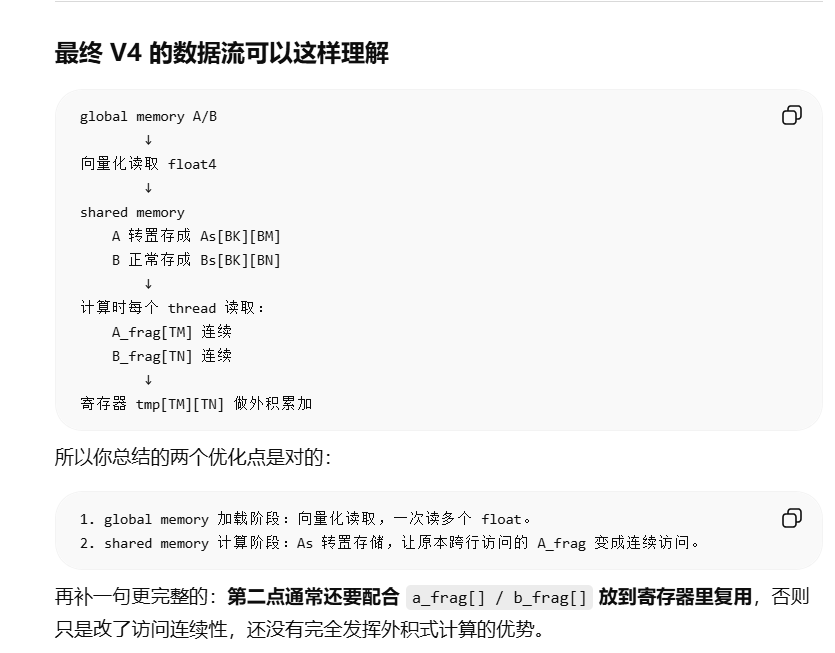
所以,第一个优化点:拷贝全局内存到共享内存阶段:一次读多个float
也就是说,你在拷贝阶段拷贝出来的As,我在用的阶段,是访问一列的。而Bs,在用的时候,主要是n在变,所以是访问一行
所以第二个优化点:在从共享内存里面读取数据来使用:As更频繁的访问是访问一列数据,所以这里在前一个阶段,可以直接存转置的
template <const int b_m, const int b_k, const int b_n, const int t_m, const int t_n>__global__ void mysgemm_v4 (int M, int N, int K, float alpha, float beta, float *A, float *B, float *C) { int blocks_y = blockIdx.y; int blocks_x = blockIdx.x; A = &A[blocks_y*b_m*K]; B = &B[blocks_x*b_n]; int thread_sum = (b_n/t_n)*(b_m/t_m); if (threadIdx.x >= thread_sum) return ; int ty = threadIdx.x / (b_n/t_n); int tx = threadIdx.x % (b_n/t_n); C = &C[blocks_y*b_m*N + blocks_x*b_n + ty*t_m*N + tx*t_n]; __shared__ float As[b_k * b_m]; __shared__ float Bs[b_k * b_n]; int a_copy_y = threadIdx.x / (b_k / 4 ); int a_copy_x = threadIdx.x % (b_k / 4 ); int a_copy_stride = thread_sum / (b_k / 4 ); int b_copy_y = threadIdx.x / (b_n / 4 ); int b_copy_x = threadIdx.x % (b_n / 4 ); int b_copy_stride = thread_sum / (b_n / 4 ); float tmp[t_m][t_n] = {0.0f }; for (int k =0 ; k < K; k+=b_k){ float4 src = {0.0f }; float * dst = nullptr ; for (int s = 0 ; s < b_m; s+=a_copy_stride){ src = *(float4*)&A[s*K + a_copy_y*K + a_copy_x*4 ]; As[a_copy_x*4 *b_m + s + a_copy_y] = src.x; As[a_copy_x*4 *b_m + s + a_copy_y + b_m] = src.y; As[a_copy_x*4 *b_m + s + a_copy_y + b_m*2 ] = src.z; As[a_copy_x*4 *b_m + s + a_copy_y + b_m*3 ] = src.w; } for (int s = 0 ; s<b_k; s += b_copy_stride){ *(float4*)&Bs[s*b_n + b_copy_y*b_n + b_copy_x*4 ] = *(float4*)&B[s*N + b_copy_y*N + b_copy_x*4 ]; } __syncthreads(); A += b_k; B += b_k*N; float * M_p = &As[ty*t_m]; float * N_p = &Bs[tx*t_n]; float a_tile_col_l[t_m]; float b_tile_row_l[t_n]; for (int l = 0 ; l<b_k; l++){ for (int m =0 ; m<t_m;m+=4 ){ *(float4*)&a_tile_col_l[m] = *(float4*)&M_p[l*b_m + m]; } for (int n = 0 ; n<t_n; n+=4 ){ *(float4*)&b_tile_row_l[n] = *(float4*)&N_p[l*b_n + n]; } for (int m = 0 ; m < t_m; m++){ for (int n = 0 ; n < t_n; n++){ tmp[m][n] += a_tile_col_l[m] * b_tile_row_l[n]; } } } __syncthreads(); } __syncthreads(); for (int m =0 ; m<t_m; m++){ for (int n = 0 ; n<t_n; n+=4 ){ float4 C_temp = *(float4*)&C[m*N + n]; C_temp.x = alpha*tmp[m][n] + beta*C_temp.x; C_temp.y = alpha*tmp[m][n+1 ] + beta*C_temp.y; C_temp.z = alpha*tmp[m][n+2 ] + beta*C_temp.z; C_temp.w = alpha*tmp[m][n+3 ] + beta*C_temp.w; *(float4*)&C[m*N + n] = C_temp; } } }
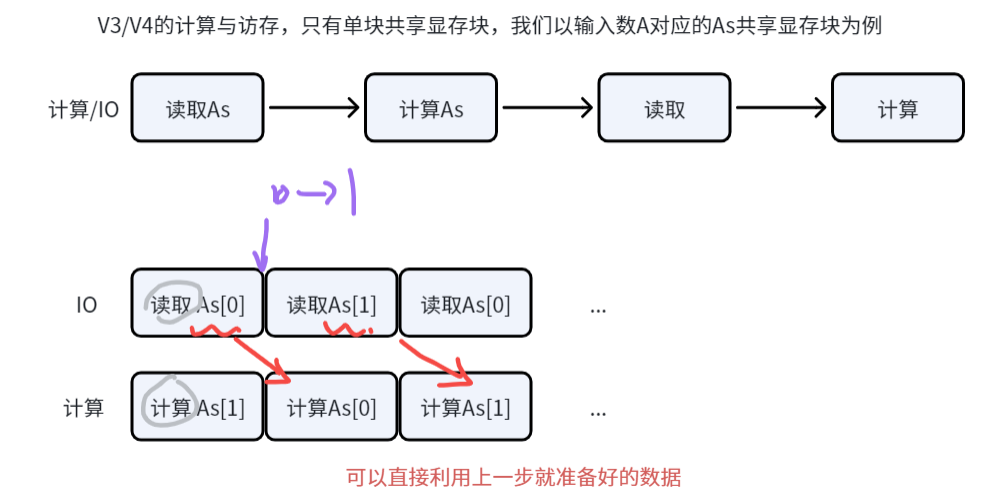
优化:双缓冲队列 在V4的优化版本中,我们主要是在
全局->共享
共享->寄存器
但是整体的计算,都串行在访存的指令后面,必须严格等待访存结束后,__syncthreads(),才能使用这些数据进行计算。
这导致访存与计算完全串行 ,GPU 的计算单元在等待数据时大量空闲 ,造成算力浪费。为解决这一问题,我们将引入一种经典且高效的优化技术:双缓冲(Double Buffering)
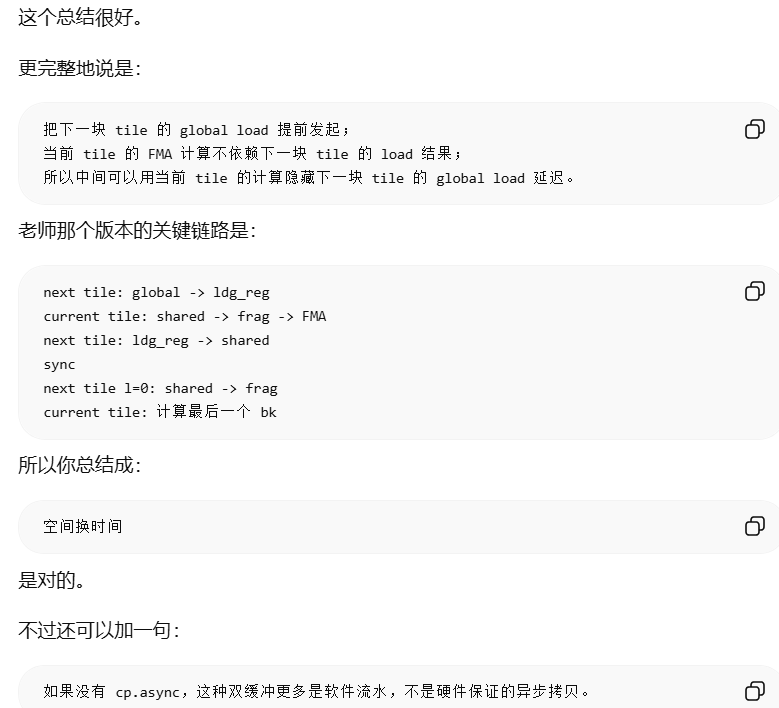
核心优化思想 是将访存与计算阶段进行重叠——当一组数据正在被计算时,另一组数据可以提前从显存中异步加载到缓冲区
所以,这里的双缓冲区,也涉及两个地方 :
全局->共享内存
读全局的下一个时刻数据到共享内存2,下面计算用共享内存1中当前时刻的数据。
共享内存->寄存器
读共享内存中下一时刻的数据到寄存器2,下面计算用寄存器1中当前时刻的数据。
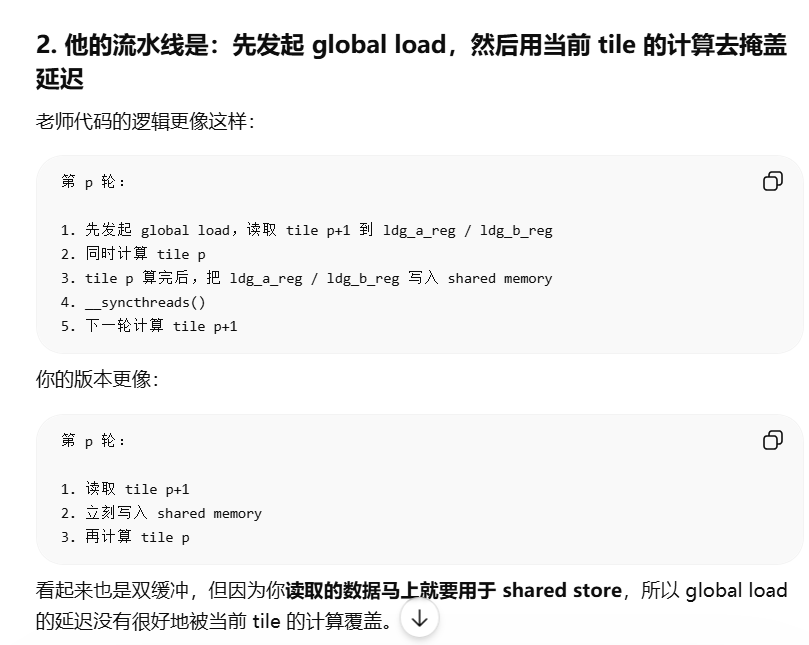
这是根据自己的逻辑的理解,写的一版,但是只是框架对了,并没有并行,所以效果很烂
#define OFFSET(row, col, row_dim) ((row)*(row_dim) + (col)) #define FETCH_FLOAT4(pointer) (reinterpret_cast<float4*> (&(pointer))[0]) template <const int b_m, const int b_k, const int b_n, const int t_m, const int t_n>__global__ void mysgemm_v5 (int M, int N, int K, float alpha, float *A, float *B, float beta, float * C) { int blocks_x = blockIdx.x; int blocks_y = blockIdx.y; A = &A[OFFSET (blocks_y*b_m, 0 ,K)]; B = &B[OFFSET (blocks_x*b_n, 0 , 1 )]; int thread_num = (b_n/t_n) * (b_m/t_m); int ty = threadIdx.x / (b_n/t_n); int tx = threadIdx.x % (b_n/t_n); C = &C[OFFSET (blocks_y*b_m + ty * t_m, blocks_x*b_n + tx*t_n, N)]; __shared__ float As[2 ][b_k*b_m]; __shared__ float Bs[2 ][b_k*b_n]; int a_copy_y = threadIdx.x / (b_k / 4 ); int a_copy_x = threadIdx.x % (b_k / 4 ); int a_copy_stride = thread_num / (b_k / 4 ); int b_copy_y = threadIdx.x / (b_n/4 ); int b_copy_x = threadIdx.x % (b_n/4 ); int b_copy_stride = thread_num / (b_n/4 ); int buffer_index = 0 ; for (int s = 0 ; s<b_m; s+=a_copy_stride){ float4 src = FETCH_FLOAT4 (A[OFFSET (s+a_copy_y, 4 *a_copy_x,K)]); As[buffer_index][OFFSET (a_copy_x*4 , a_copy_y + s,b_m)] = src.x; As[buffer_index][OFFSET (a_copy_x*4 + 1 , a_copy_y + s,b_m)] = src.y; As[buffer_index][OFFSET (a_copy_x*4 + 2 , a_copy_y + s,b_m)] = src.z; As[buffer_index][OFFSET (a_copy_x*4 + 3 , a_copy_y + s,b_m)] = src.w; } for (int s = 0 ; s<b_k; s+=b_copy_stride){ FETCH_FLOAT4 (Bs[buffer_index][OFFSET (s+b_copy_y, b_copy_x*4 ,b_n)]) = FETCH_FLOAT4 (B[OFFSET (s+b_copy_y,b_copy_x*4 ,N)]); } A += b_k; B += OFFSET (b_k, 0 , N); __syncthreads(); float tmp[t_m][t_n] = {0.0f }; for (int k = 0 ; k<K; k+=b_k){ buffer_index = 1 - buffer_index; if (k < K-b_k){ for (int s = 0 ; s<b_m; s+=a_copy_stride){ float4 src = FETCH_FLOAT4 (A[OFFSET (s+a_copy_y, 4 *a_copy_x,K)]); As[buffer_index][OFFSET (a_copy_x*4 , a_copy_y + s,b_m)] = src.x; As[buffer_index][OFFSET (a_copy_x*4 + 1 , a_copy_y + s,b_m)] = src.y; As[buffer_index][OFFSET (a_copy_x*4 + 2 , a_copy_y + s,b_m)] = src.z; As[buffer_index][OFFSET (a_copy_x*4 + 3 , a_copy_y + s,b_m)] = src.w; } for (int s = 0 ; s<b_k; s+=b_copy_stride){ FETCH_FLOAT4 (Bs[buffer_index][OFFSET (s+b_copy_y, b_copy_x*4 ,b_n)]) = FETCH_FLOAT4 (B[OFFSET (s+b_copy_y,b_copy_x*4 ,N)]); } A += b_k; B += OFFSET (b_k, 0 , N); } int reg_buffer_index = 0 ; float a_tile_reg[2 ][t_m] = {0.0f }; float b_tile_reg[2 ][t_n] = {0.0f }; for (int m = 0 ; m<t_m; m+=4 ){ FETCH_FLOAT4 (a_tile_reg[reg_buffer_index][m]) = FETCH_FLOAT4 (As[1 -buffer_index][OFFSET (0 ,ty*t_m+m,b_m)]); } for (int n =0 ; n<t_n; n+=4 ){ FETCH_FLOAT4 (b_tile_reg[reg_buffer_index][n]) = FETCH_FLOAT4 (Bs[1 -buffer_index][OFFSET (0 ,tx*t_n + n,b_n)]); } for (int l = 1 ; l < b_k; l++) { reg_buffer_index = 1 - reg_buffer_index; for (int m =0 ; m<t_m; m+=4 ){ FETCH_FLOAT4 (a_tile_reg[reg_buffer_index][m]) = FETCH_FLOAT4 (As[1 -buffer_index][OFFSET (l,ty*t_m+m,b_m)]); } for (int n =0 ; n<t_n; n+=4 ){ FETCH_FLOAT4 (b_tile_reg[reg_buffer_index][n]) = FETCH_FLOAT4 (Bs[1 -buffer_index][OFFSET (l,tx*t_n + n,b_n)]); } for (int m = 0 ; m < t_m; m++){ for (int n = 0 ; n < t_n; n++){ tmp[m][n] += a_tile_reg[1 -reg_buffer_index][m] * b_tile_reg[1 -reg_buffer_index][n]; } } } reg_buffer_index = 1 - reg_buffer_index; for (int m = 0 ; m < t_m; m++){ for (int n = 0 ; n < t_n; n++){ tmp[m][n] += a_tile_reg[1 -reg_buffer_index][m] * b_tile_reg[1 -reg_buffer_index][n]; } } __syncthreads(); } for (int m =0 ; m<t_m; m++){ for (int n=0 ; n<t_n; n+=4 ){ float4 C_temp = FETCH_FLOAT4 (C[OFFSET (m,n,N)]); C_temp.x = alpha*tmp[m][n] + beta*C_temp.x; C_temp.y = alpha*tmp[m][n+1 ] + beta*C_temp.y; C_temp.z = alpha*tmp[m][n+2 ] + beta*C_temp.z; C_temp.w = alpha*tmp[m][n+3 ] + beta*C_temp.w; FETCH_FLOAT4 (C[OFFSET (m,n,N)]) = C_temp; } } }
但是实际测试发现,这个效果并不好:所以发现,这个写法其实是错误的。
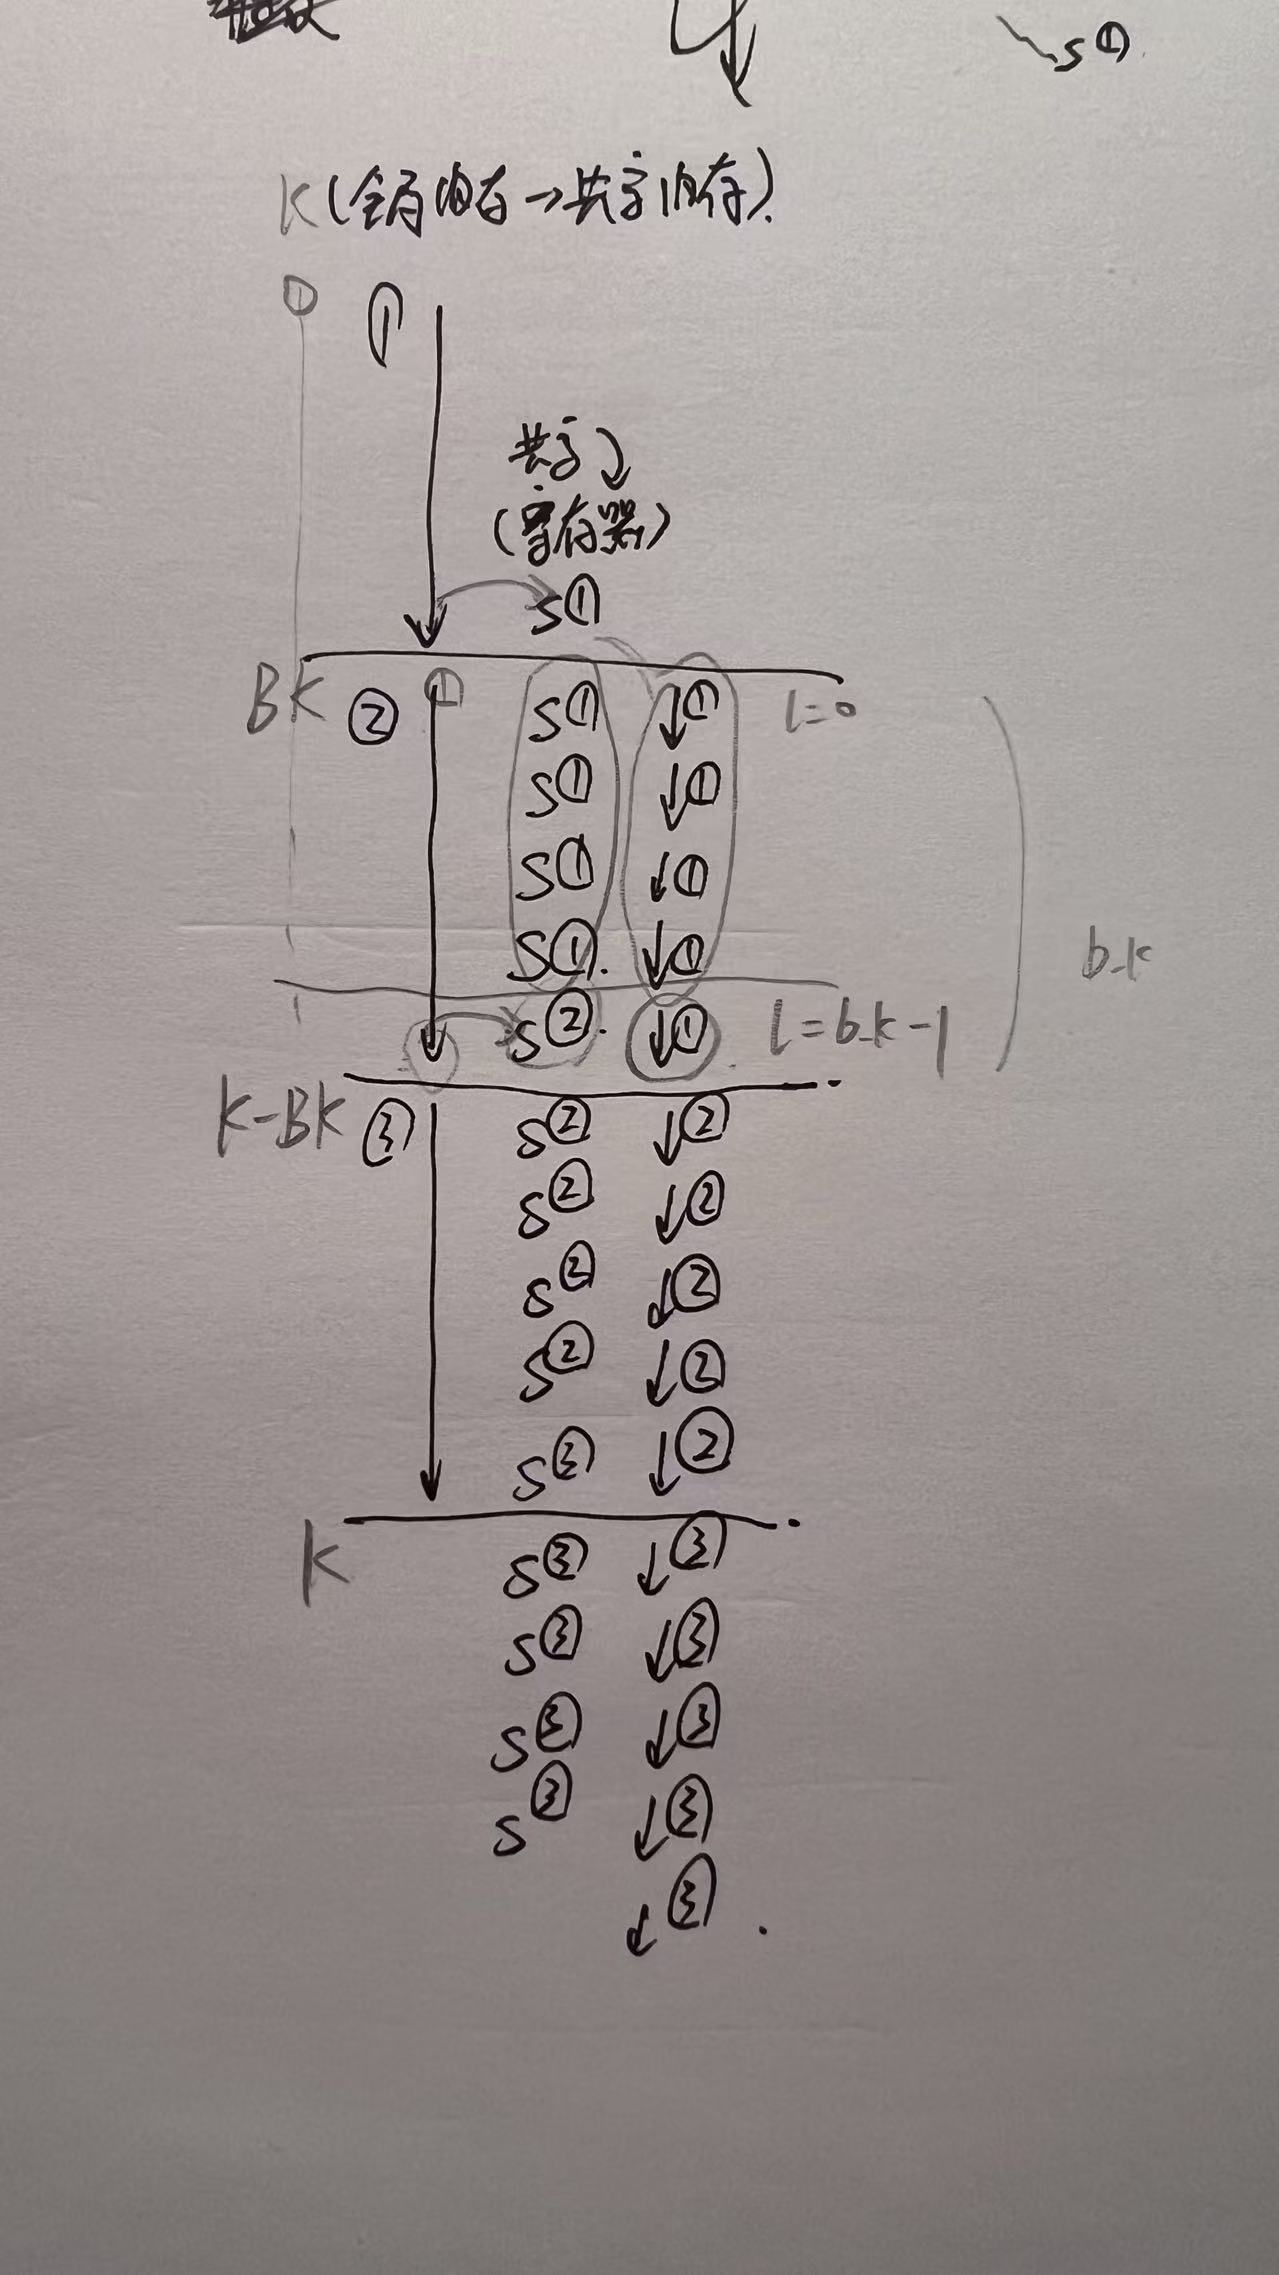
所以,真正能够使用流水线指令重叠的流程应该是这样子的:
根据上图,可以看到,
除了一开始,先完成
一个tile的从全局内存->共享内存
共享内存->寄存器缓冲区
因为中间涉及写共享内存/读共享内存,所以必须要sync
循环后面【BK, 2BK, …, K】(剩余的K个tile要处理,因为一开始的tile也没有处理)
启动下一个tile的全局内存->寄存器 【BK,…, K-BK】(K-1个要拷贝)
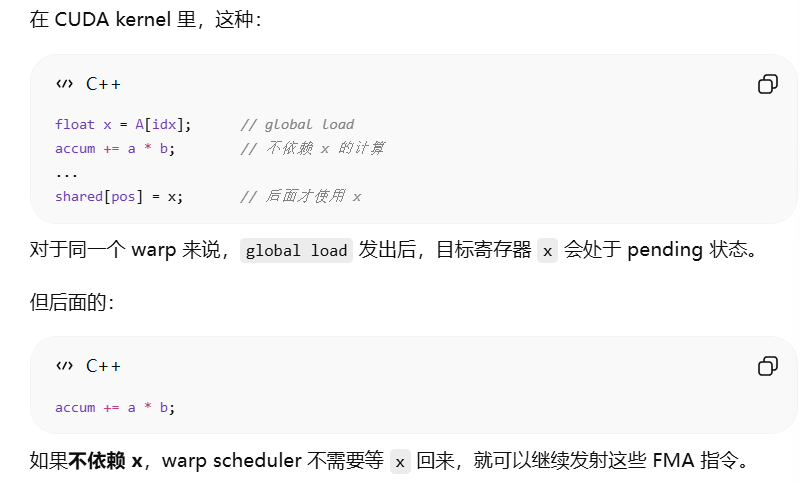
这里就是指令并行,因为下面的指令执行并不依赖上面,所以FMA指令直接发射
共享内存->寄存器 ,(l : 【0:BK-2】)寄存器->计算 (l : 【0:BK-2】)启动下一个tile的寄存器->共享内存【BK,…, K-BK】(K-1个要拷贝)
sync,等下一个tile的共享内存写完 下一个tile共享内存->寄存器缓冲区(l=0)
最后完成本次最后一个寄存器->计算(l = BK-1)
关于为什么能够指令重叠的详细解释:
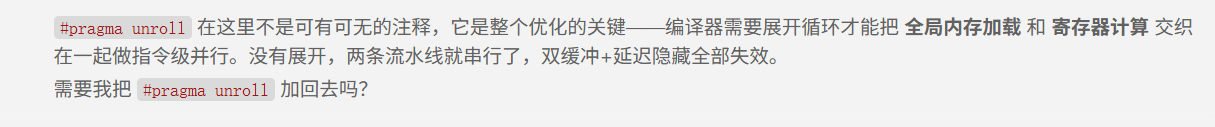
但是要注意,刚写了指令重叠的逻辑,还不够,要需要unroll编译展开
来拆开循环,这样指令才能进行重叠
所以,最终实现如下
template <const int b_m, const int b_k, const int b_n, const int t_m, const int t_n>__global__ void mysgemm_v5_2 (int M, int N, int K, float alpha, float *A, float *B, float beta, float * C) { int blocks_x = blockIdx.x; int blocks_y = blockIdx.y; A = &A[OFFSET (blocks_y*b_m, 0 ,K)]; B = &B[OFFSET (blocks_x*b_n, 0 , 1 )]; const int thread_num = (b_n/t_n) * (b_m/t_m); int ty = threadIdx.x / (b_n/t_n); int tx = threadIdx.x % (b_n/t_n); C = &C[OFFSET (blocks_y*b_m + ty * t_m, blocks_x*b_n + tx*t_n, N)]; __shared__ float As[2 ][b_k*b_m]; __shared__ float Bs[2 ][b_k*b_n]; int a_copy_y = threadIdx.x / (b_k / 4 ); int a_copy_x = threadIdx.x % (b_k / 4 ); const int a_copy_stride = thread_num / (b_k / 4 ); const int a_stride_num = b_m / a_copy_stride; int b_copy_y = threadIdx.x / (b_n/4 ); int b_copy_x = threadIdx.x % (b_n/4 ); const int b_copy_stride = thread_num / (b_n/4 ); const int b_stride_num = b_k / b_copy_stride; int shared_index = 0 ; int register_index = 0 ; float a_reg_l[2 ][t_m] = {0.0f }; float b_reg_l[2 ][t_n] = {0.0f }; float4 A_tile_src[a_stride_num] = {0.0f }; float4 B_tile_src[b_stride_num] = {0.0f }; float tmp[t_m][t_n] = {0.0f }; #pragma unroll for (int s = 0 ; s<b_m;s+=a_copy_stride){ A_tile_src[s/a_copy_stride] = FETCH_FLOAT4 (A[OFFSET (s+a_copy_y, 4 *a_copy_x, K)]); As[0 ][OFFSET (a_copy_x*4 ,s + a_copy_y, b_m)] = A_tile_src[s/a_copy_stride].x; As[0 ][OFFSET (a_copy_x*4 + 1 ,s + a_copy_y, b_m)] = A_tile_src[s/a_copy_stride].y; As[0 ][OFFSET (a_copy_x*4 + 2 ,s + a_copy_y, b_m)] = A_tile_src[s/a_copy_stride].z; As[0 ][OFFSET (a_copy_x*4 + 3 ,s + a_copy_y, b_m)] = A_tile_src[s/a_copy_stride].w; } #pragma unroll for (int s = 0 ; s< b_k; s+=b_copy_stride){ FETCH_FLOAT4 (Bs[0 ][OFFSET (s + b_copy_y, 4 *b_copy_x, b_n)]) = FETCH_FLOAT4 (B[OFFSET (s + b_copy_y, 4 *b_copy_x, N)]); } A += b_k; B += b_k*N; __syncthreads(); #pragma unroll for (int m =0 ; m<t_m; m+=4 ){ FETCH_FLOAT4 (a_reg_l[0 ][m]) = FETCH_FLOAT4 (As[0 ][OFFSET (0 , ty*t_m + m, b_m)]); } #pragma unroll for (int n=0 ; n<t_n; n+=4 ){ FETCH_FLOAT4 (b_reg_l[0 ][n]) = FETCH_FLOAT4 (Bs[0 ][OFFSET (0 , tx*t_n + n, b_n)]); } #pragma unroll for (int k = b_k; k<K+b_k; k+=b_k){ shared_index = 1 - shared_index; if (k<K){ #pragma unroll for (int s=0 ; s<b_m; s+=a_copy_stride){ A_tile_src[s/a_copy_stride] = FETCH_FLOAT4 (A[OFFSET (s+a_copy_y, 4 *a_copy_x, K)]); } #pragma unroll for (int s=0 ; s<b_k; s+=b_copy_stride){ B_tile_src[s/b_copy_stride] = FETCH_FLOAT4 (B[OFFSET (s+b_copy_y, 4 *b_copy_x, N)]); } A += b_k; B += b_k*N; } #pragma unroll for (int l = 0 ; l<b_k - 1 ; l++){ register_index = 1 - register_index; #pragma unroll for (int m = 0 ; m<t_m; m+=4 ){ FETCH_FLOAT4 (a_reg_l[register_index][m]) = FETCH_FLOAT4 (As[1 - shared_index][OFFSET (l+1 ,ty*t_m +m,b_m)]); } #pragma unroll for (int n = 0 ; n<t_n; n+=4 ){ FETCH_FLOAT4 (b_reg_l[register_index][n]) = FETCH_FLOAT4 (Bs[1 - shared_index][OFFSET (l+1 ,tx*t_n + n,b_n)]); } #pragma unroll for (int m =0 ; m<t_m; m++){ #pragma unroll for (int n =0 ; n<t_n; n++){ tmp[m][n] += a_reg_l[1 - register_index][m] * b_reg_l[1 -register_index][n]; } } } register_index = 1 - register_index; if (k < K ){ #pragma unroll for (int s = 0 ; s<b_m; s+=a_copy_stride){ As[shared_index][OFFSET (4 *a_copy_x, s+a_copy_y, b_m)] = A_tile_src[s/a_copy_stride].x; As[shared_index][OFFSET (4 *a_copy_x + 1 , s+a_copy_y, b_m)] = A_tile_src[s/a_copy_stride].y; As[shared_index][OFFSET (4 *a_copy_x + 2 , s+a_copy_y, b_m)] = A_tile_src[s/a_copy_stride].z; As[shared_index][OFFSET (4 *a_copy_x + 3 , s+a_copy_y, b_m)] = A_tile_src[s/a_copy_stride].w; } #pragma unroll for (int s=0 ; s<b_k; s+=b_copy_stride){ FETCH_FLOAT4 (Bs[shared_index][OFFSET (s+b_copy_y, 4 *b_copy_x, b_n)]) = B_tile_src[s/b_copy_stride]; } __syncthreads(); #pragma unroll for (int m =0 ; m<t_m; m+=4 ){ FETCH_FLOAT4 (a_reg_l[register_index][m]) = FETCH_FLOAT4 (As[shared_index][OFFSET (0 , ty*t_m + m, b_m)]); } #pragma unroll for (int n =0 ; n<t_n; n+=4 ){ FETCH_FLOAT4 (b_reg_l[register_index][n]) = FETCH_FLOAT4 (Bs[shared_index][OFFSET (0 , tx*t_n + n, b_n)]); } } #pragma unroll for (int m= 0 ; m<t_m; m++){ #pragma unroll for (int n =0 ; n<t_n; n++){ tmp[m][n] += a_reg_l[1 - register_index][m] * b_reg_l[1 -register_index][n]; } } } #pragma unroll for (int m =0 ; m<t_m; m++){ #pragma unroll for (int n=0 ; n<t_n; n+=4 ){ float4 C_temp = FETCH_FLOAT4 (C[OFFSET (m,n,N)]); C_temp.x = alpha*tmp[m][n] + beta*C_temp.x; C_temp.y = alpha*tmp[m][n+1 ] + beta*C_temp.y; C_temp.z = alpha*tmp[m][n+2 ] + beta*C_temp.z; C_temp.w = alpha*tmp[m][n+3 ] + beta*C_temp.w; FETCH_FLOAT4 (C[OFFSET (m,n,N)]) = C_temp; } } }
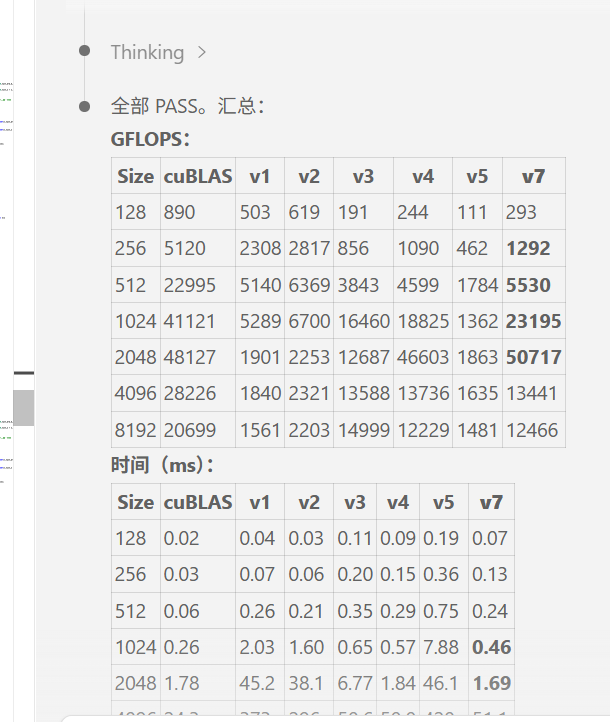
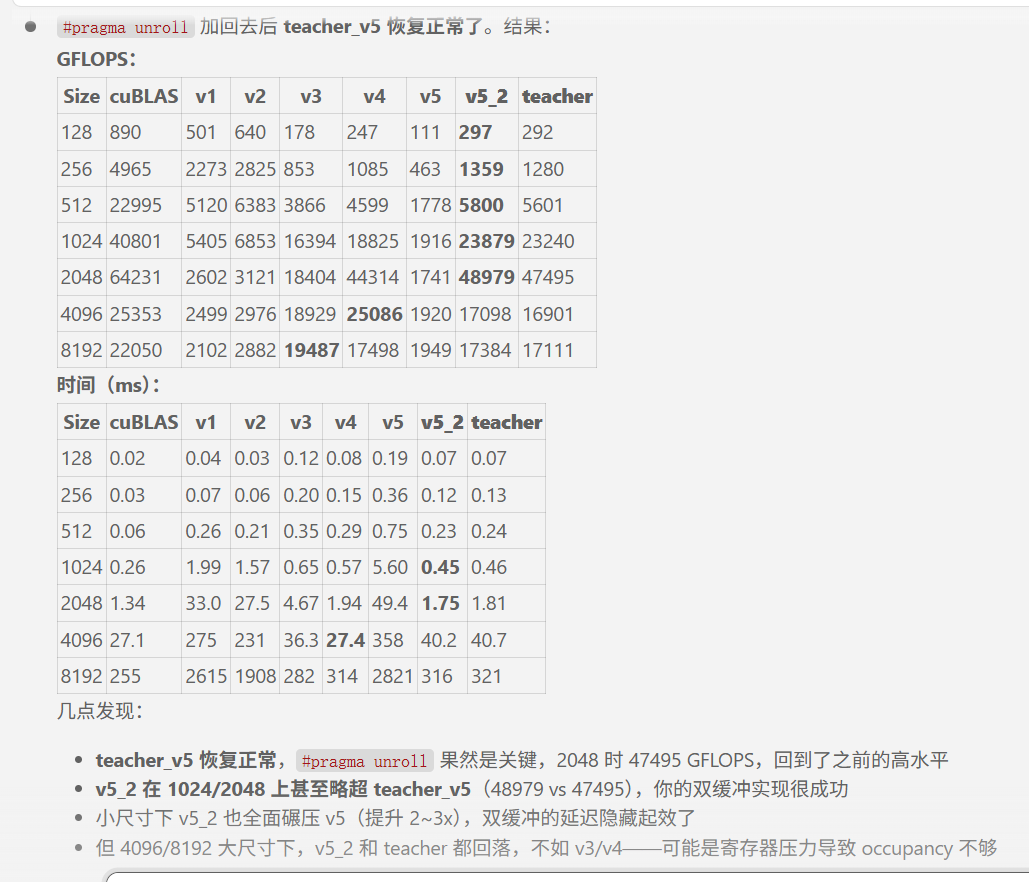
可以看到,这回根据自己的理解写的V5_2,性能已经比老师的要好了
优化:warp tiling 下面进一步进行优化
这里的warptile, 我说一下我的理解:
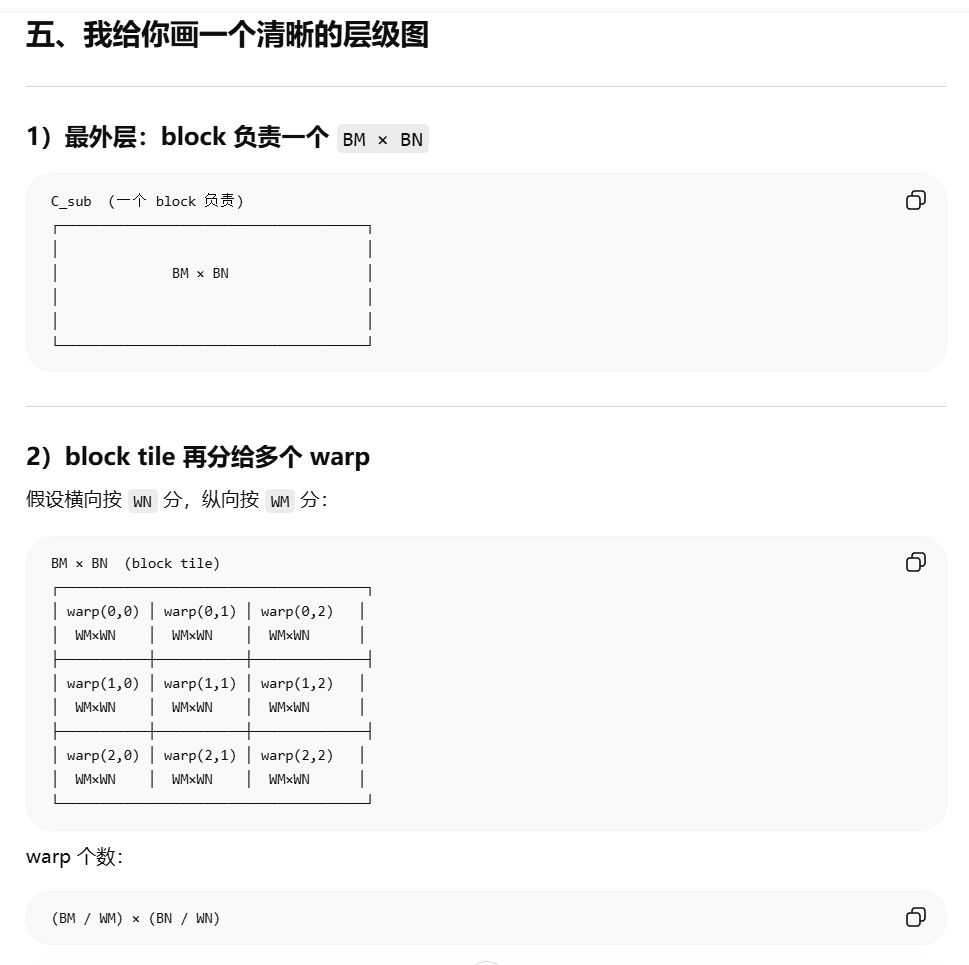
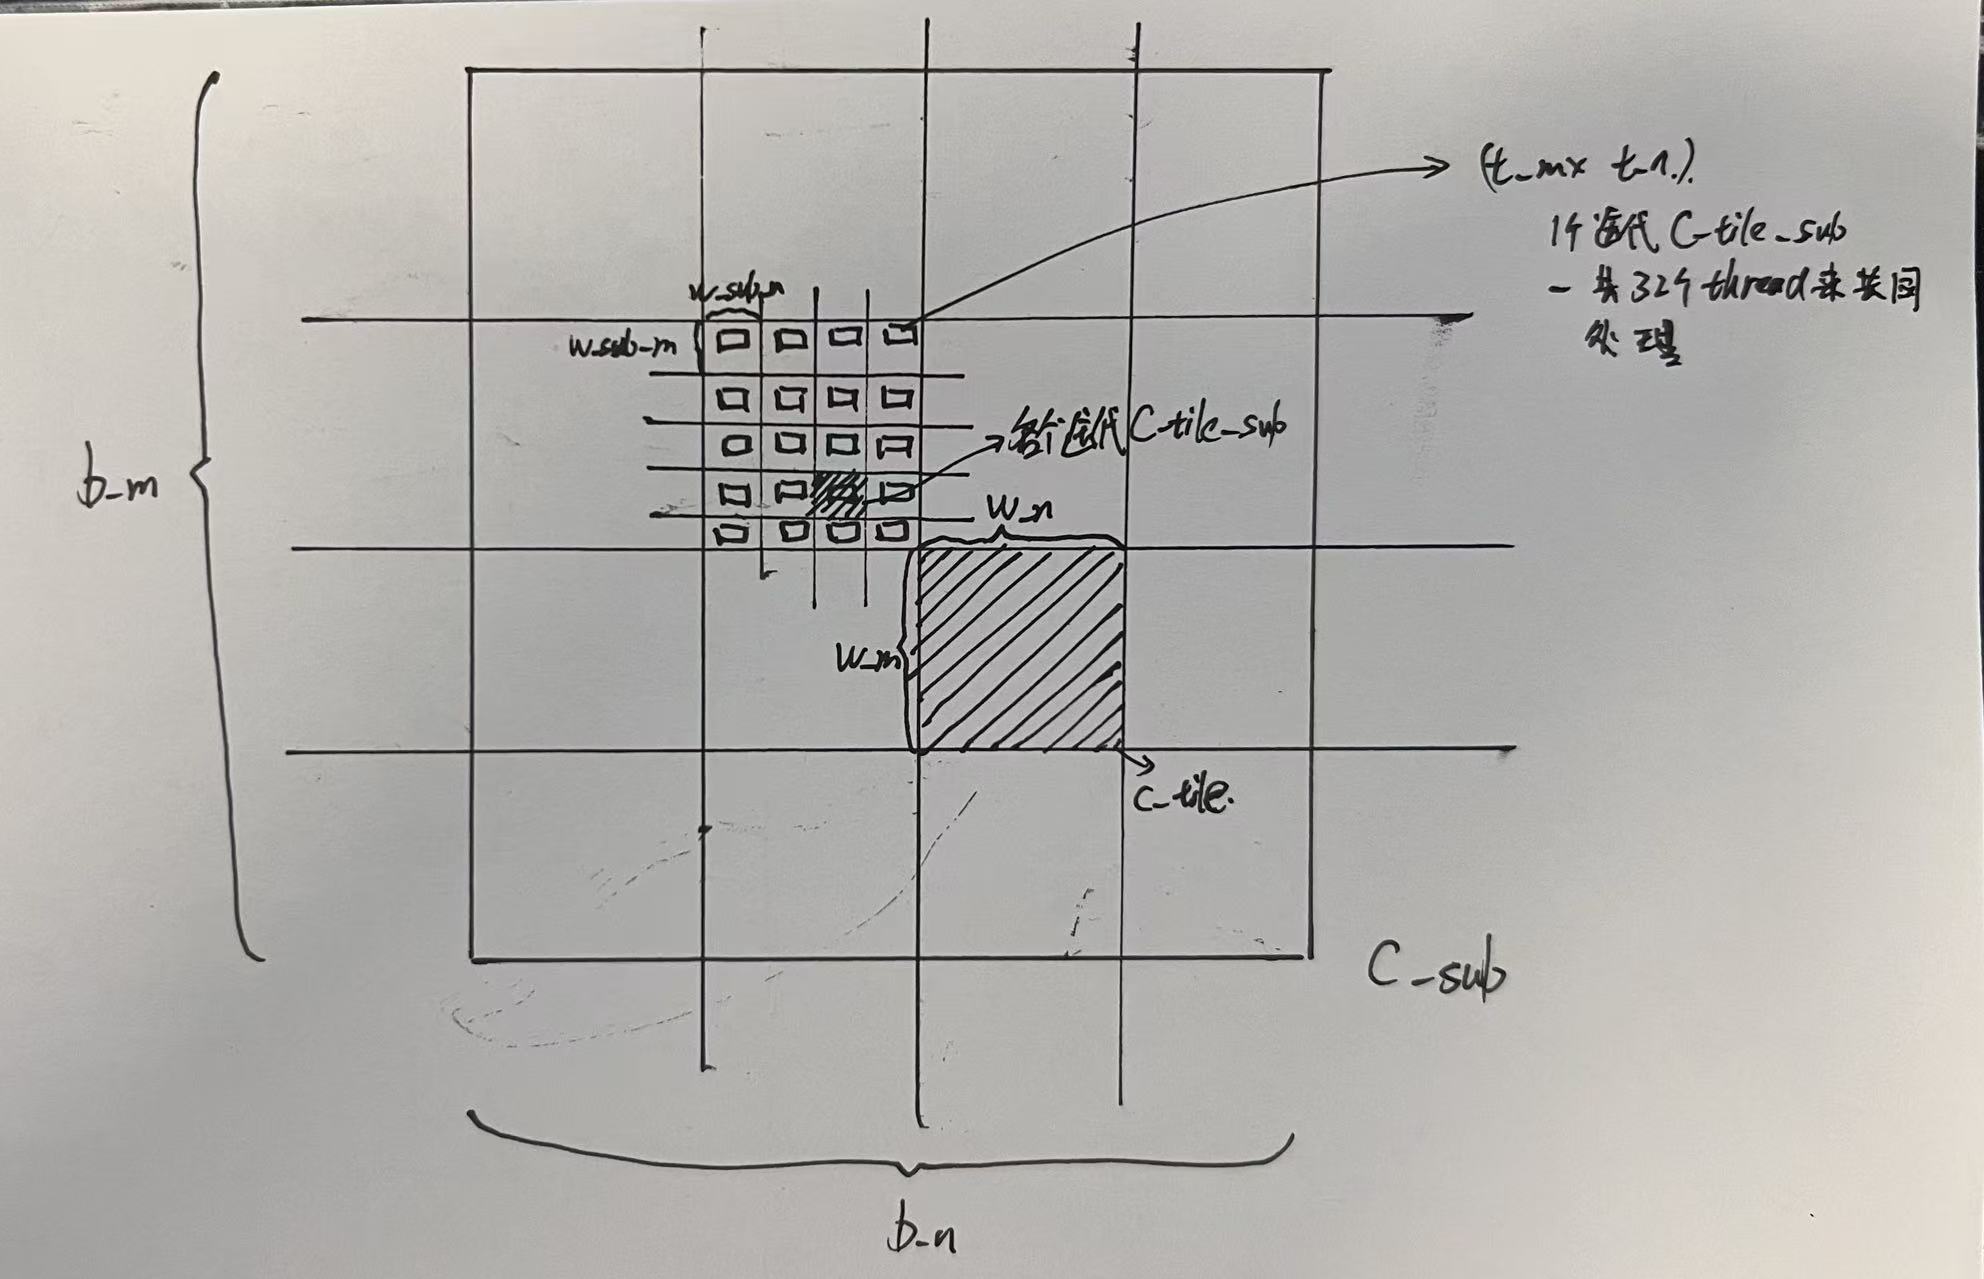
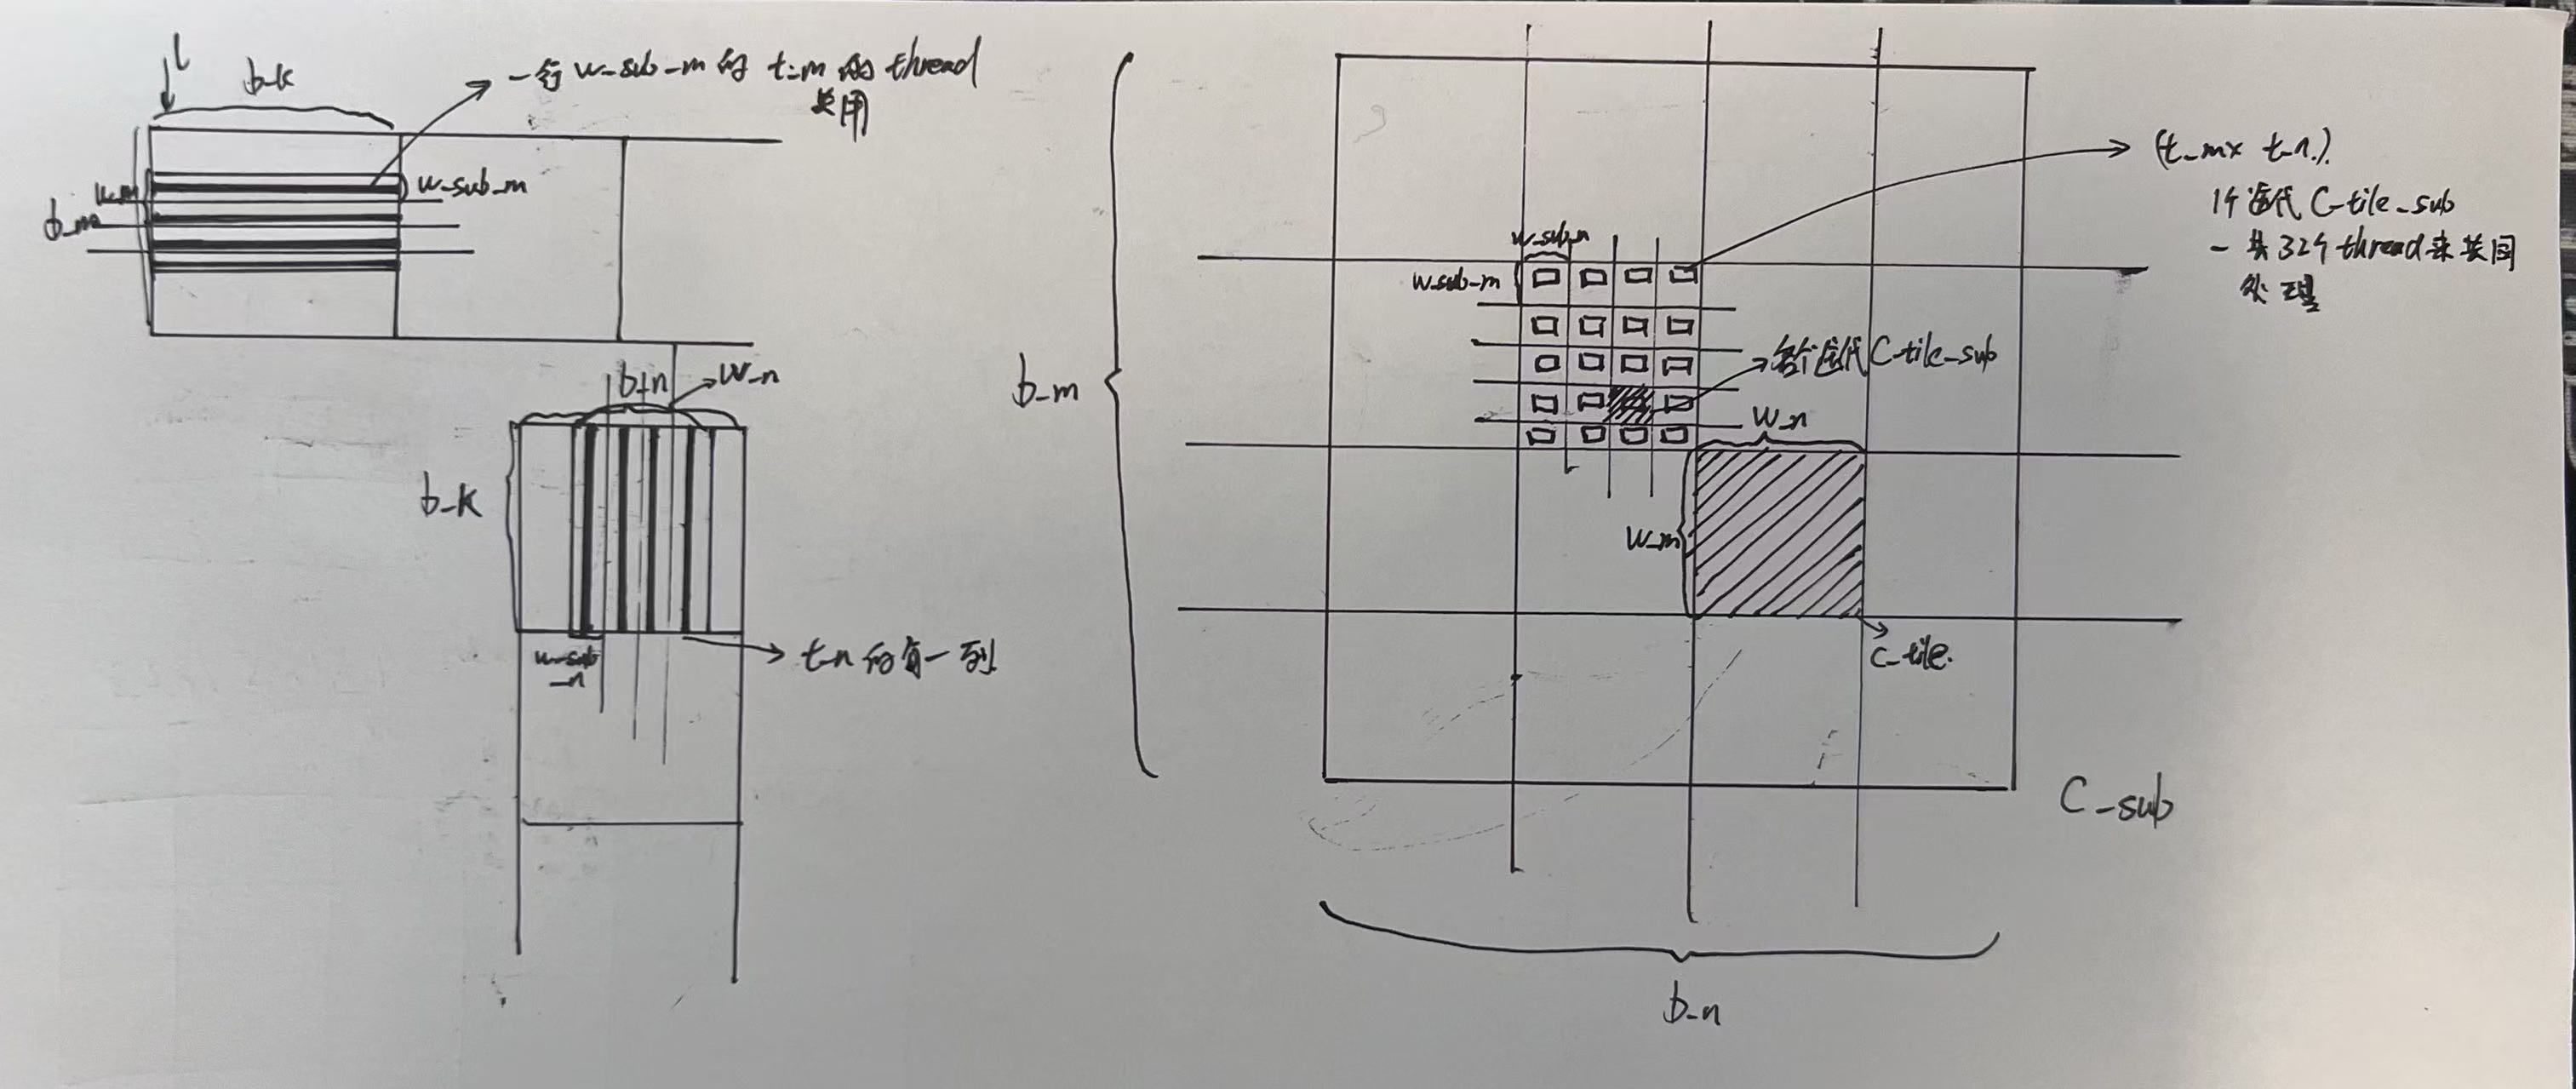
原来我们一个block, 负责计算C_sub(b_m x b_n), 然后
但是,当时所有的thread,都是执行一样的流程,处理各自的C_tile,所以,理想情况,一个thread阻塞,所有thread都阻塞。调度的整体是block。
因为GPU里面是warp = 32个thread为调度单位的,所以,
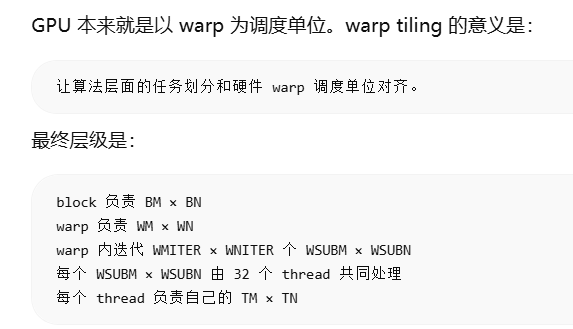
每个warp负责的C_tile(w_m x w_n) ,里面是32个thread来处理的,
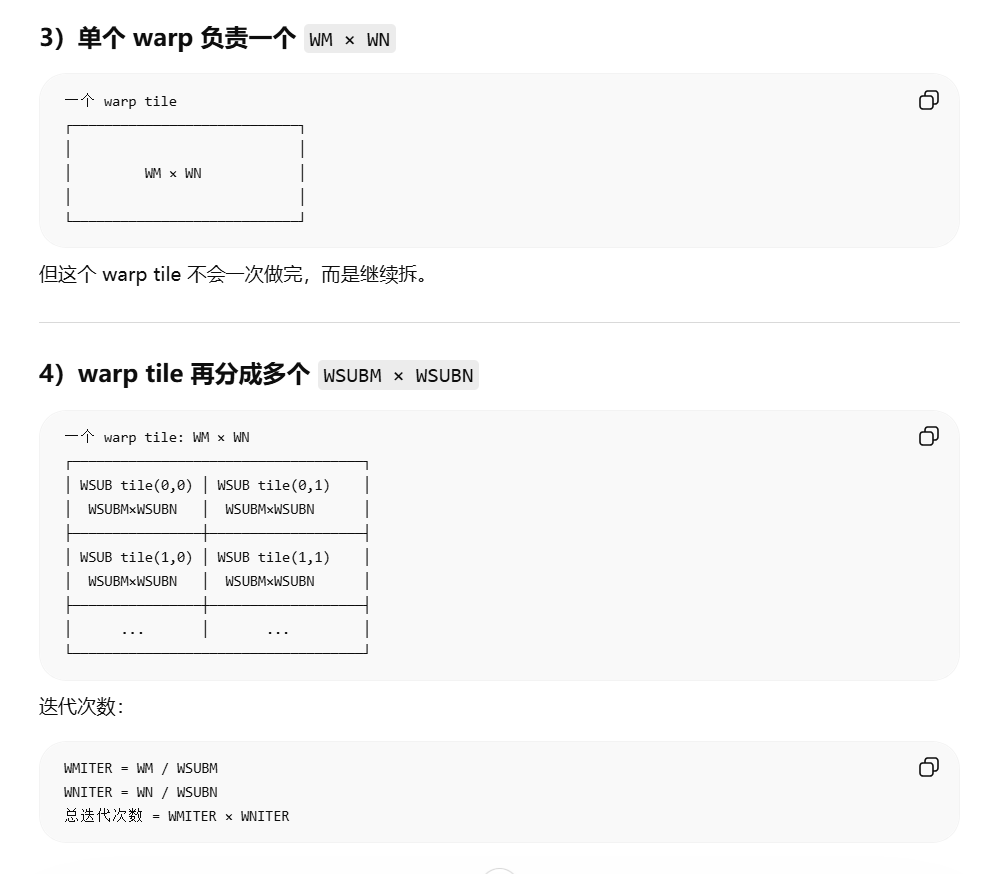
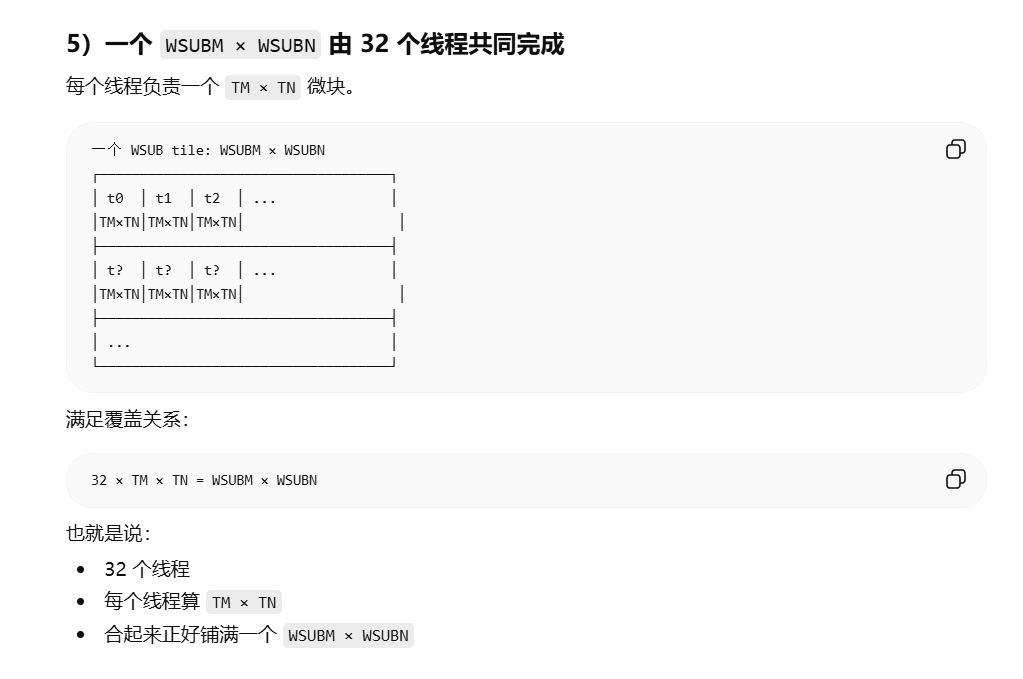
这个C_tile内部又划分C_tile_sub(w_sub_m x w_sub_n) (迭代单位),所有C_tile_sub都是32个线程来处理进行迭代的。32个thread一起处理一个C_tile_sub, 处理完这个C_tile_sub, 迭代处理下一个C_tile_sub,
所以一共迭代WMITER x WNITER次,每个thread针对一个C_tile_sub内的一个自己的小块(t_m x t_n), 32个thread共同计算一个C_tile_sub。
你现在的主线理解,可以概括成:
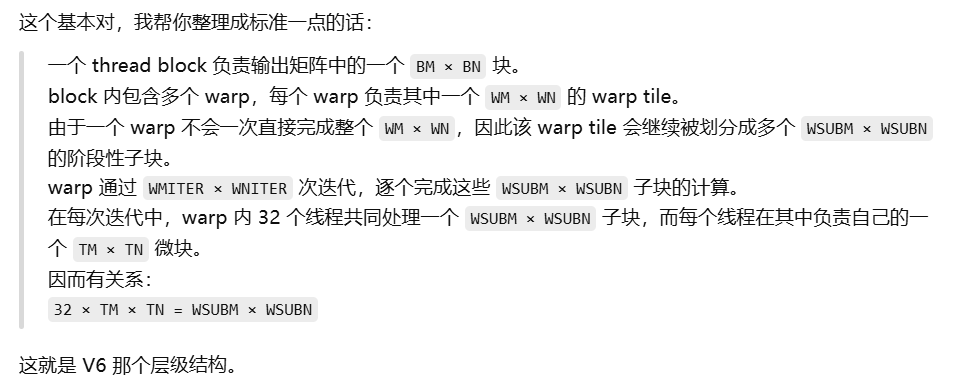
一个 block 先负责一个大的输出块 C_sub = BM × BN这个 C_sub 再分给多个 warp
每个 warp 负责一个更小的输出块 warp tile = WM × WN但是一个 warp 一次也不会直接把整个 WM × WN 全算完
所以 WM × WN 还要继续分成多个阶段性的小块 WSUBM × WSUBN
每次迭代里,32 个线程共同处理一个 WSUBM × WSUBN
而在这个 WSUBM × WSUBN 内部,每个线程再负责自己的 TM × TN 微块
所以 warp 需要迭代:
WMITER = WM / WSUBMWNITER = WN / WSUBN一共 WMITER × WNITER 次,才能完成整个 WM × WN
这个主线是 对的 。
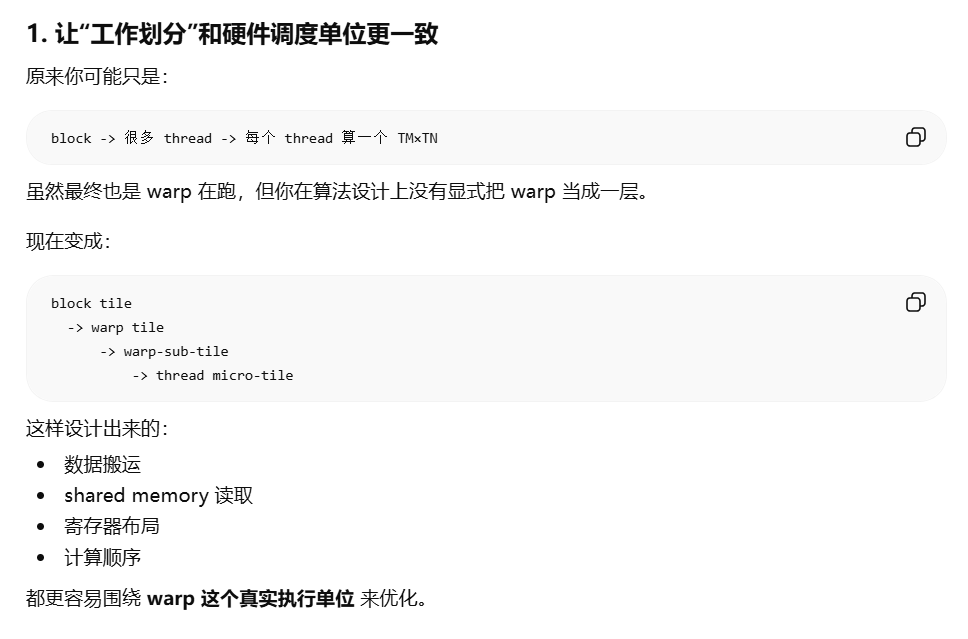
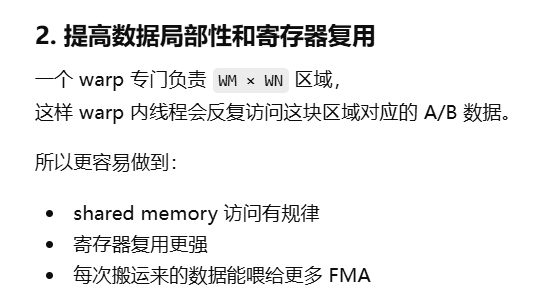
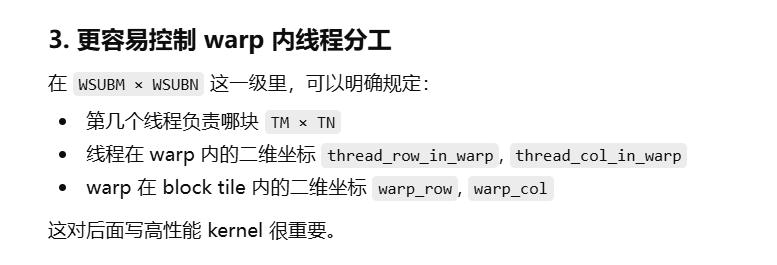
warp tiling 真正带来的好处是 :
所以最后总结为
那thread划分好了,那整个矩阵运算,其实就是两个大的部分:
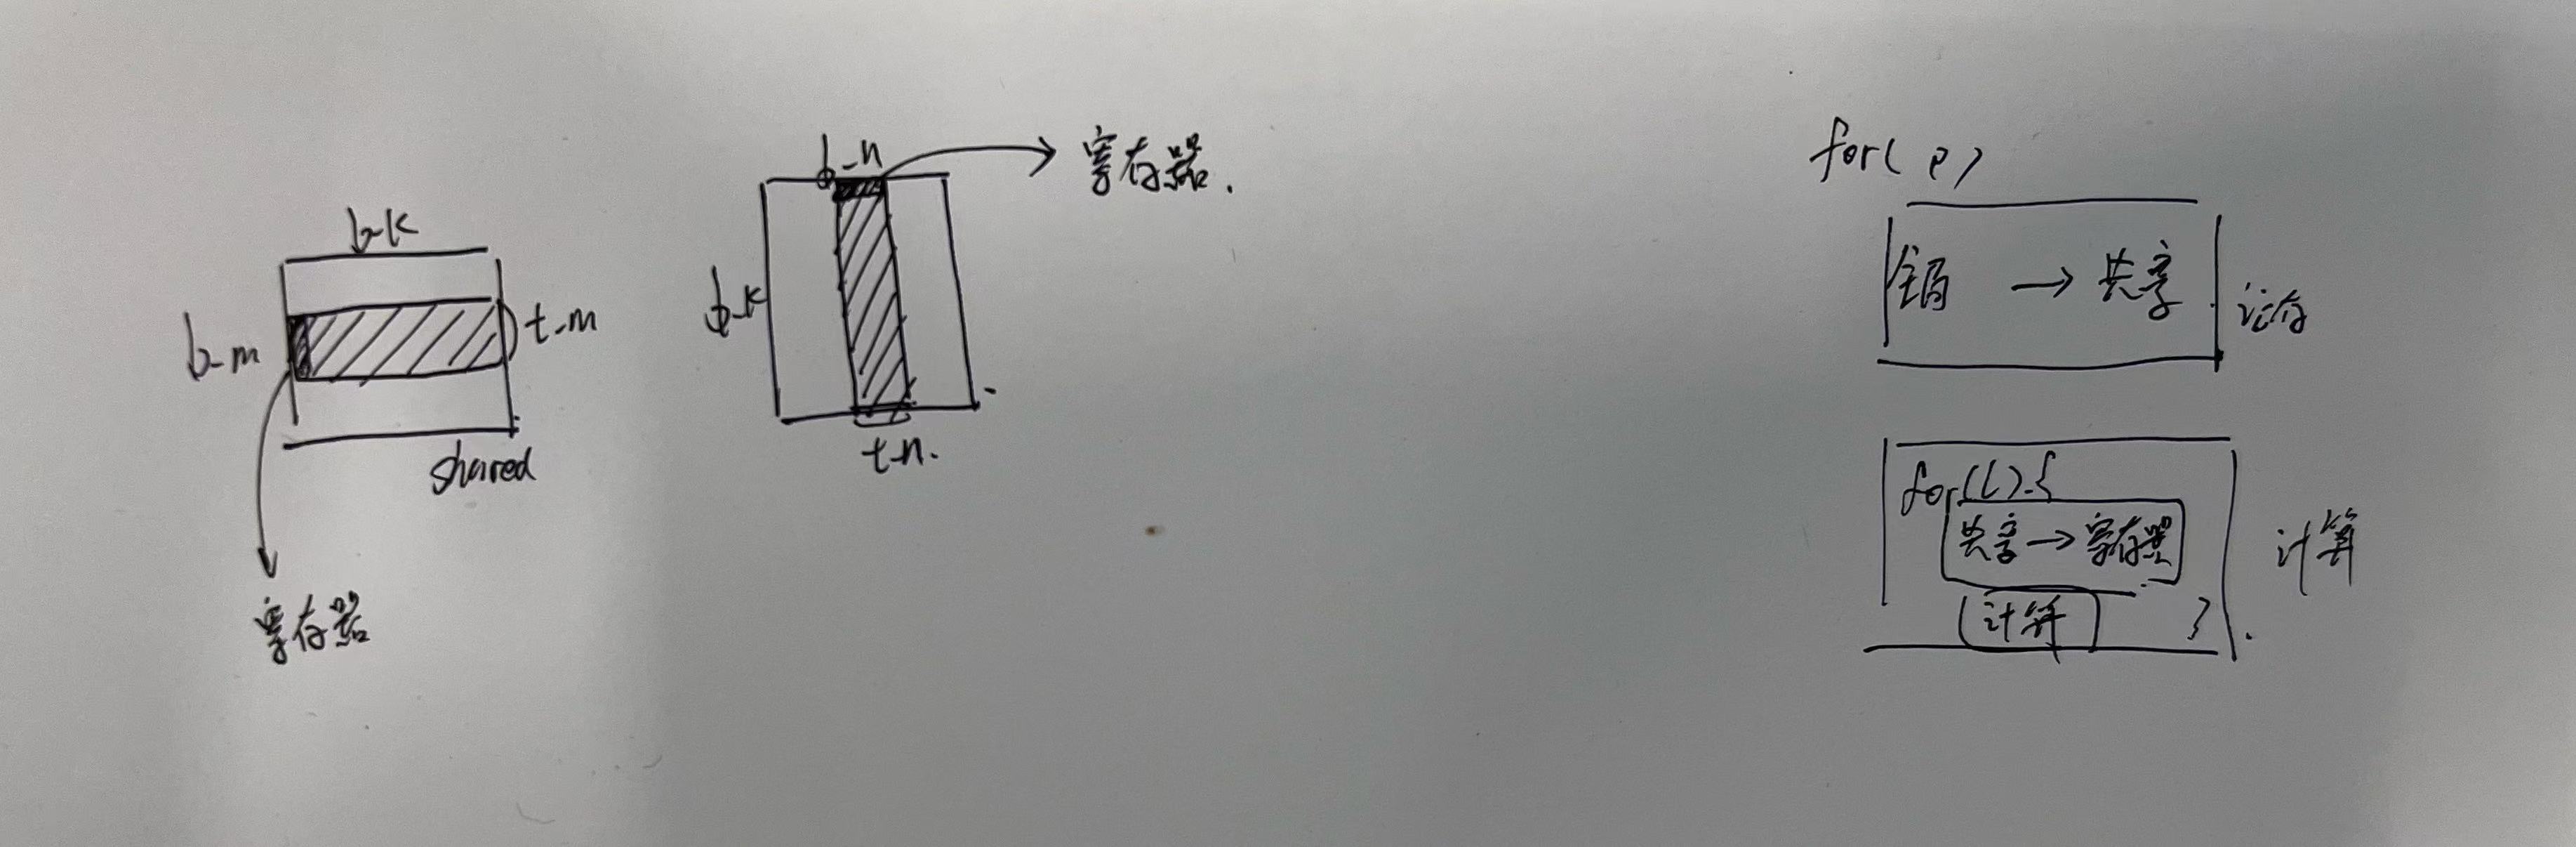
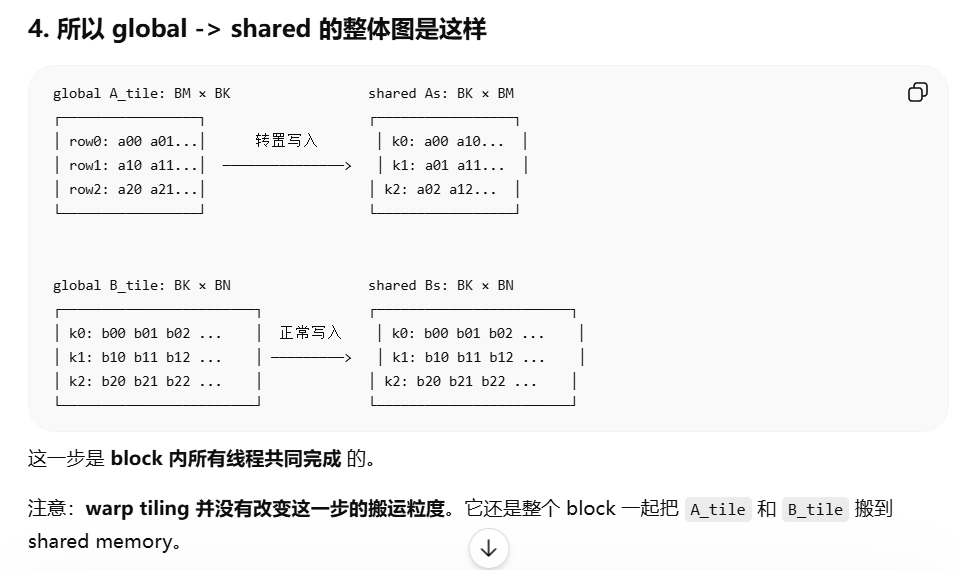
全局内存->共享内存(拷贝A_tile, B_tile)
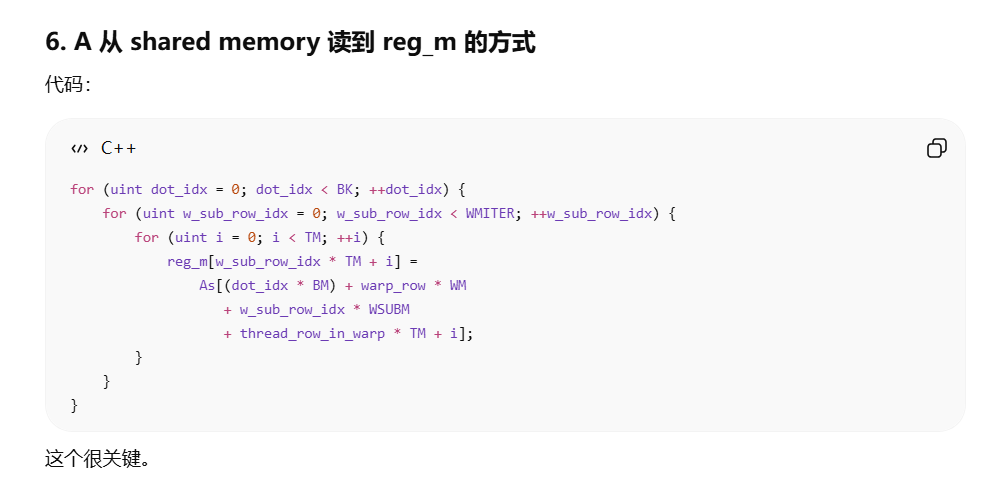
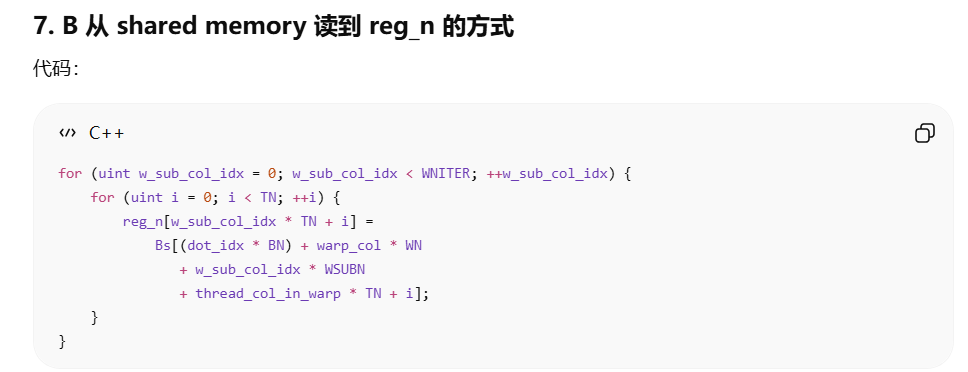
共享内存->寄存器(拷贝l步的As的t_m行,Bs的t_n列)
那么在warp tiling优化中,第一个全局内存 -> 共享内存是没有变化的 。
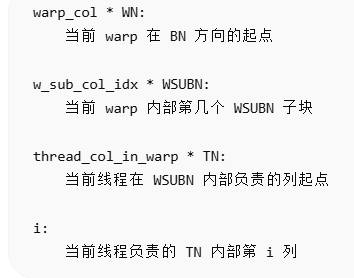
真正的变化是共享内存->寄存器这一步,多了C_tile内的C_tile_sub迭代这一个细粒度
constexpr int WARP_SIZE = 32 ;template <const int b_m, const int b_n, const int b_k, const int w_m, const int w_n, const int w_n_iter_num, const int t_m, const int t_n, const int num_threads > __global__ void mysgemm_v6 (int M, int N, int K, float alpha, float * A, float * B, float beta, float * C) { const int b_y = blockIdx.y; const int b_x = blockIdx.x; const int warp_id = threadIdx.x / WARP_SIZE; const int w_y = warp_id / (b_n / w_n); const int w_x = warp_id % (b_n / w_n); const int w_m_iter_num = (w_m * w_n) / (WARP_SIZE*t_m*t_n * w_n_iter_num); const int w_sub_m = w_m / w_m_iter_num; const int w_sub_n = w_n / w_n_iter_num; const int thread_id_in_c_tile_sub = threadIdx.x % WARP_SIZE; const int ty = thread_id_in_c_tile_sub /(w_sub_n / t_n); const int tx = thread_id_in_c_tile_sub %(w_sub_n / t_n); __shared__ float As[b_k * b_m]; __shared__ float Bs[b_k * b_n]; A = &A[OFFSET (b_y * b_m, 0 , K)]; B = &B[OFFSET (0 ,b_x * b_n,N)]; C = &C[OFFSET (b_y * b_m + w_y * w_m, b_x * b_n + w_x*w_n, N)]; const int a_copy_y = threadIdx.x / (b_k / 4 ); const int a_copy_x = threadIdx.x % (b_k / 4 ); const int a_copy_stride = num_threads / (b_k / 4 ); const int b_copy_y = threadIdx.x / (b_n / 4 ); const int b_copy_x = threadIdx.x % (b_n / 4 ); const int b_copy_stride = num_threads / (b_n / 4 ); float thread_result[t_m][t_n][w_m_iter_num][w_n_iter_num] = {0.0f }; float a_reg_l[w_m_iter_num * t_m] = {0.0f }; float b_reg_l[w_n_iter_num * t_n] = {0.0f }; for (int k =0 ; k<K; k+= b_k){ for (int s = 0 ; s<b_m; s+=a_copy_stride){ float4 src = FETCH_FLOAT4 (A[OFFSET (s + a_copy_y, 4 *a_copy_x,K)]); As[OFFSET (4 *a_copy_x, a_copy_y + s,b_m)] = src.x; As[OFFSET (4 *a_copy_x + 1 , a_copy_y + s,b_m)] = src.y; As[OFFSET (4 *a_copy_x + 2 , a_copy_y + s,b_m)] = src.z; As[OFFSET (4 *a_copy_x + 3 , a_copy_y + s,b_m)] = src.w; } for (int s =0 ; s<b_k; s+=b_copy_stride){ FETCH_FLOAT4 (Bs[OFFSET (s + b_copy_y, 4 *b_copy_x,b_n)]) = FETCH_FLOAT4 (B[OFFSET (s+b_copy_y, 4 *b_copy_x, N)]); } A += b_k; B += b_k*N; __syncthreads(); for (int l = 0 ; l < b_k; l++){ for (int iter=0 ; iter < w_m_iter_num; iter++){ for (int m =0 ; m<t_m;m++){ a_reg_l[OFFSET (iter,m,t_m)] = As[OFFSET (l,w_y*w_m + iter*w_sub_m + ty*t_m + m, b_m)]; } } for (int iter=0 ; iter < w_n_iter_num; iter++){ for (int n =0 ; n<t_n; n++){ b_reg_l[OFFSET (iter,n,t_n)] = Bs[OFFSET (l,w_x*w_n + iter*w_sub_n + tx*t_n + n,b_n)]; } } for (int iter_y =0 ; iter_y < w_m_iter_num; iter_y++){ for (int iter_x =0 ; iter_x < w_n_iter_num; iter_x++){ for (int m =0 ; m < t_m; m++){ for (int n =0 ; n < t_n; n++){ thread_result[m][n][iter_y][iter_x] += a_reg_l[OFFSET (iter_y,m,t_m)] * b_reg_l[OFFSET (iter_x,n,t_n)]; } } } } } __syncthreads(); } for (int iter_y = 0 ; iter_y < w_m_iter_num; iter_y++){ for (int iter_x =0 ; iter_x < w_n_iter_num; iter_x++){ float * C_write = &C[OFFSET (iter_y*w_sub_m, iter_x*w_sub_n,N)]; for (int m =0 ; m < t_m; m++){ for (int n=0 ; n< t_n; n+=4 ){ float4 temp = FETCH_FLOAT4 (C_write[OFFSET (ty*t_m + m, tx*t_n + n, N)]); temp.x = alpha*thread_result[m][n][iter_y][iter_x] + beta*temp.x; temp.y = alpha*thread_result[m][n+1 ][iter_y][iter_x] + beta*temp.y; temp.z = alpha*thread_result[m][n+2 ][iter_y][iter_x] + beta*temp.z; temp.w = alpha*thread_result[m][n+3 ][iter_y][iter_x] + beta*temp.w; FETCH_FLOAT4 (C_write[OFFSET (ty*t_m + m,tx*t_n + n,N)]) = temp; } } } } }
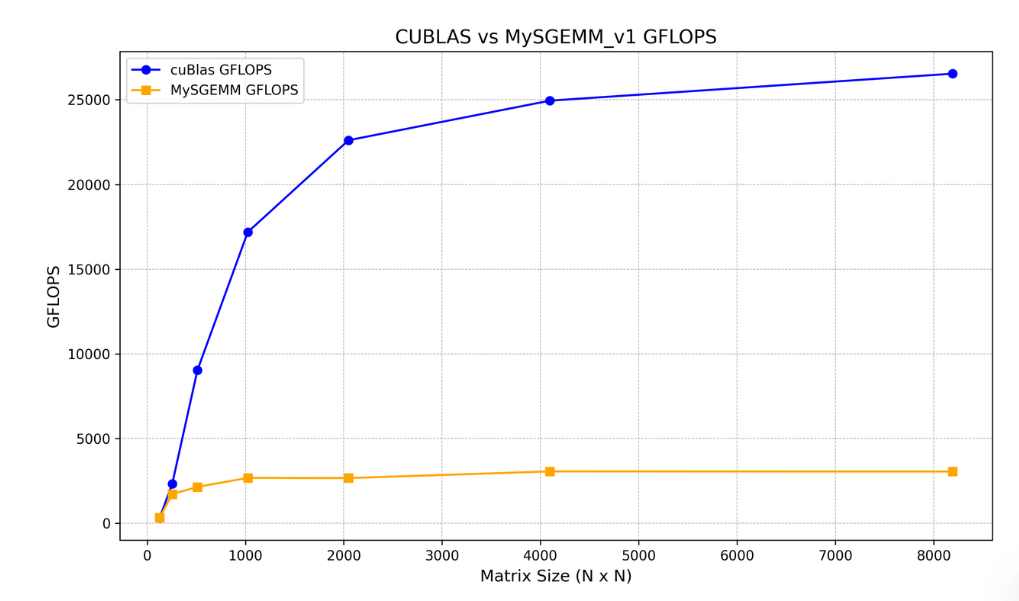
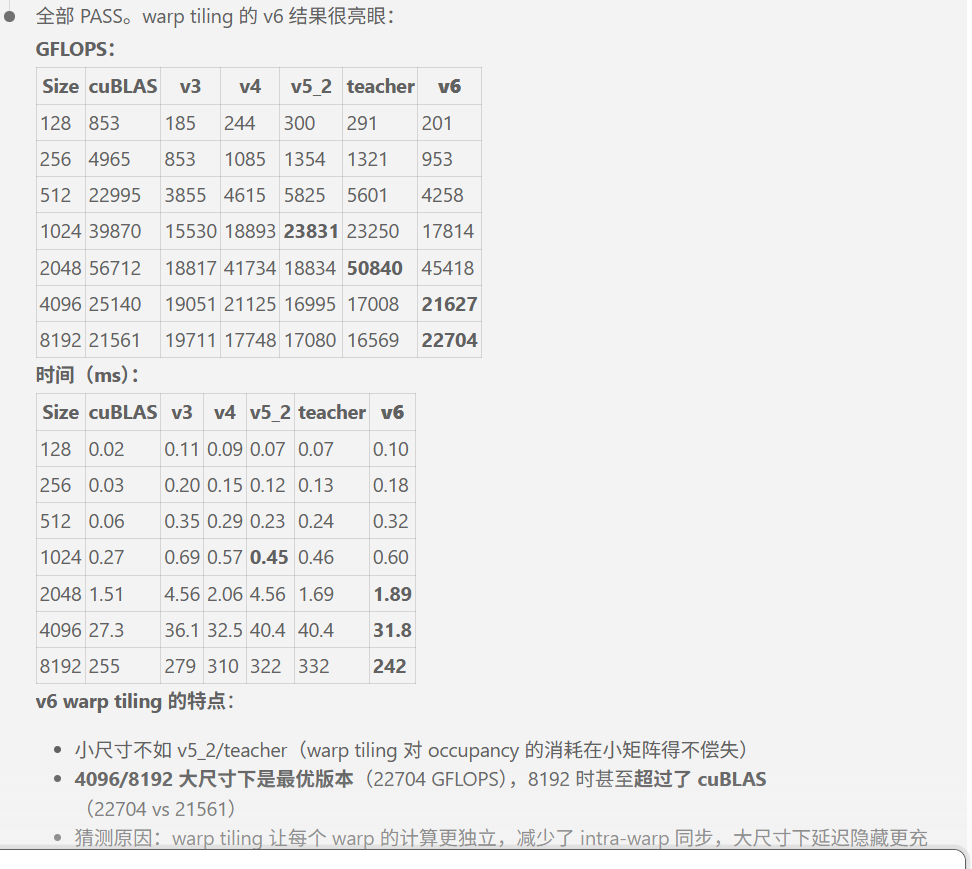
可以看到,效果非常的nice。
总结 至此,我们总结一下目前学到的优化策略:
共享内存优化
一口气多读一些全局内存到共享内存,然后这部分计算用共享内存
向量化访存
优化访存密度,原来一次访问全局内存一个float的时间 = 访问全局内存4个float的时间
thread tiling(warp tiling的简易版) + 共享内存转置
共享内存转置:(利用计算访存的特性,减少bank conflict)
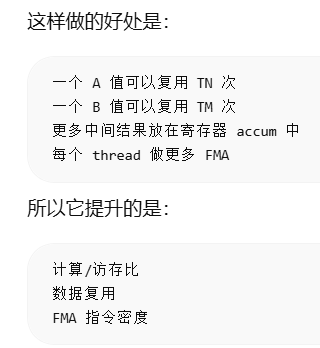
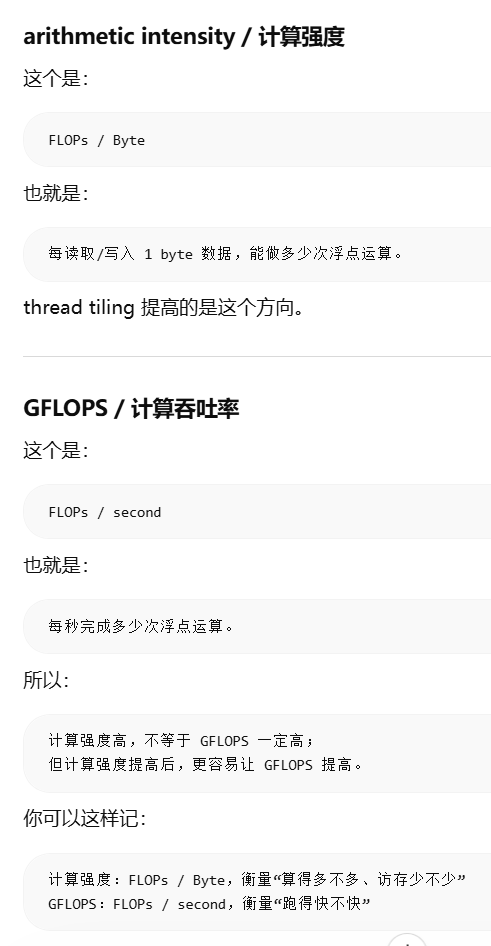
把thread数和要计算的float元素分离,一个thread计算多个float元素,计算效率上升,GFLOPs提高(这叫什么?计算密度?也就是单位时间内发生的浮点数计算次数?)
双缓冲区
利用双缓冲区+指令重叠(FMA指令执行上下不依赖),空间换时间
warp tiling
按照GPU的warp调度的特性,来划分计算的工作,所以,一个block确定后,先按照warp来分配工作量(C_tile),然后里面用32个thread(一个warp)来处理,同时里面根据warp调度的特性,划分成各个迭代分区C_tile_sub, 然后每个C_tile_sub内,再划分出32个thread各自的(t_m, t_n)的工作任务。
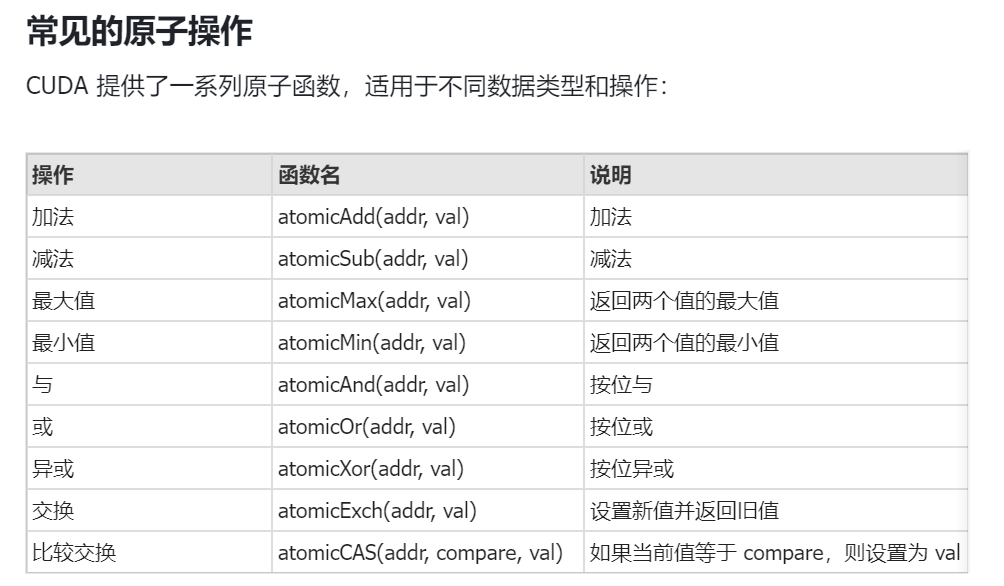
Cuda原子操作 就是我们CUDA编程,是并行计算,多个thread一起工作,当他们操作一个共享内存的时候,就容易出现并发与争抢的情况。
所以需要原子操作,保证指令级不会被中断。
#include <iostream> #include <cuda_runtime.h> using namespace std;__global__ void race_condition_kernel (int * data) { atomicAdd (data, 1 ); } __global__ void hist (int8_t *input, int *hist, int n) { int i = threadIdx.x + blockIdx.x*blockDim.x; for (int idx = i; idx < n; idx +=gridDim.x * blockDim.x){ int8_t in = input[idx]; if (in >= 0 && in <256 ){ atomicAdd (&hist[in], 1 ); } } } __global__ void hist_v2 (int8_t *input, int *hist, int n) { __shared__ int histo_private[256 ]; for (int j = threadIdx.x; j<256 ; j+=blockDim.x){ histo_private[j] = 0 ; } __syncthreads(); int i = threadIdx.x + blockIdx.x * blockDim.x; for (int idx = i; idx < n ; idx +=gridDim.x*blockDim.x){ int8_t in = input[idx]; if (in >=0 && in < 256 ){ atomicAdd (&histo_private[in], 1 ); } } __syncthreads(); for (int j=threadIdx.x ; j<256 ; j+=blockDim.x) { atomicAdd (&hist[j], histo_private[j]); } } int main () const int size = 1024 * 1024 ; int8_t *input = new int8_t [size]; for (int i = 0 ; i < size; i++){ input[i] = i % 256 ; } int * h_hist_v1 = new int [256 ](); int * h_hist_v2 = new int [256 ](); int8_t * d_input; int * d_hist_v1; int * d_hist_v2; cudaMalloc (&d_input, size * sizeof (int8_t )); cudaMalloc (&d_hist_v1, 256 * sizeof (int )); cudaMalloc (&d_hist_v2, 256 * sizeof (int )); cudaMemcpy (d_input, input, sizeof (int8_t ) * size, cudaMemcpyHostToDevice); dim3 block_size (256 ) ; dim3 grid_size (256 ) ; cudaEvent_t start, stop; cudaEventCreate (&start); cudaEventCreate (&stop); cudaMemset (d_hist_v1, 0 , 256 * sizeof (int )); cudaEventRecord (start); hist<<<grid_size, block_size>>>(d_input, d_hist_v1, size); cudaEventRecord (stop); cudaEventSynchronize (stop); float ms_v1 = 0 ; cudaEventElapsedTime (&ms_v1, start, stop); cudaDeviceSynchronize (); cudaMemcpy (h_hist_v1, d_hist_v1, sizeof (int ) * 256 , cudaMemcpyDeviceToHost); cudaMemset (d_hist_v2, 0 , 256 * sizeof (int )); cudaEventRecord (start); hist_v2<<<grid_size, block_size>>>(d_input, d_hist_v2, size); cudaEventRecord (stop); cudaEventSynchronize (stop); float ms_v2 = 0 ; cudaEventElapsedTime (&ms_v2, start, stop); cudaDeviceSynchronize (); cudaMemcpy (h_hist_v2, d_hist_v2, sizeof (int ) * 256 , cudaMemcpyDeviceToHost); bool correct = true ; for (int i = 0 ; i < 256 ; i++){ if (h_hist_v1[i] != h_hist_v2[i]){ cout << "MISMATCH at bin " << i << ": v1=" << h_hist_v1[i] << " v2=" << h_hist_v2[i] << endl; correct = false ; } } if (correct){ cout << "Result: PASS - both kernels produce identical histograms" << endl; } else { cout << "Result: FAIL - histograms differ" << endl; } cout << endl; cout << "hist (global atomic): " << ms_v1 << " ms" << endl; cout << "hist_v2 (shared atomic): " << ms_v2 << " ms" << endl; cout << "Speedup: " << ms_v1 / ms_v2 << "x" << endl; cout << endl << "First 16 bins (should be " << size / 256 << " each):" << endl; for (int i = 0 ; i < 16 ; i++){ cout << " bin " << i << ": v1=" << h_hist_v1[i] << " v2=" << h_hist_v2[i] << endl; } cudaEventDestroy (start); cudaEventDestroy (stop); cudaFree (d_hist_v1); cudaFree (d_hist_v2); cudaFree (d_input); delete [] input; delete [] h_hist_v1; delete [] h_hist_v2; return 0 ; }
Result: PASS - both kernels produce identical histograms

hist    (global atomic): 0.022528 ms
hist_v2 (shared atomic): 0.009216 ms
Speedup: 2.44444x
Transpose转置算子,数据排布优化 这里主要来解释当初的共享内存访问问题,为什么需要转置写。
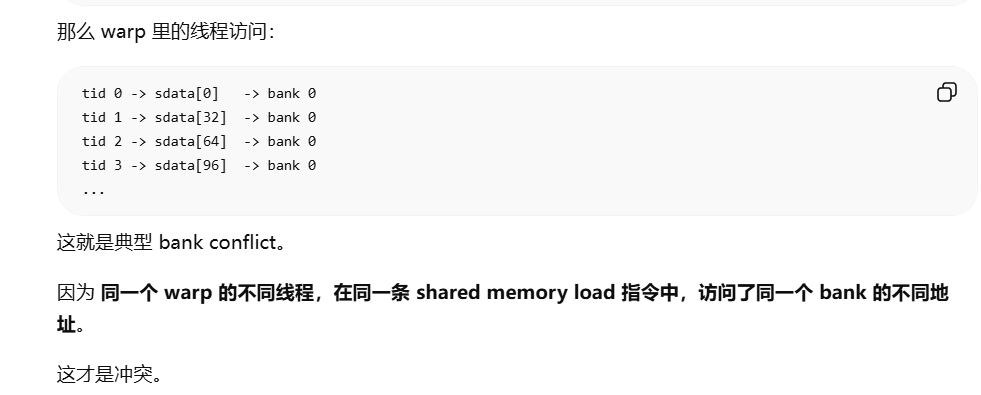
不同thread访问不同地址但同一bank,会出现bank conflict
注意,访问同一地址,不会构成bank conflict
朴素实现
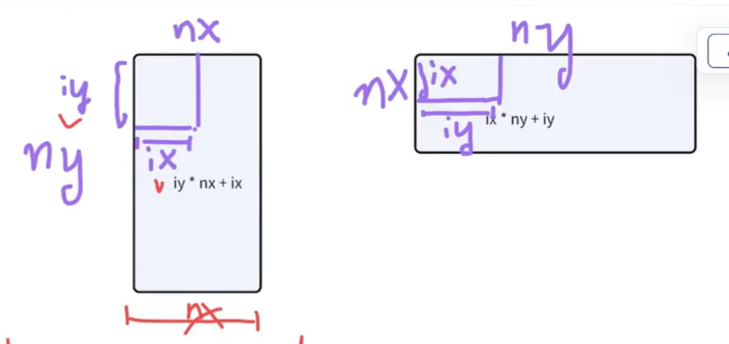
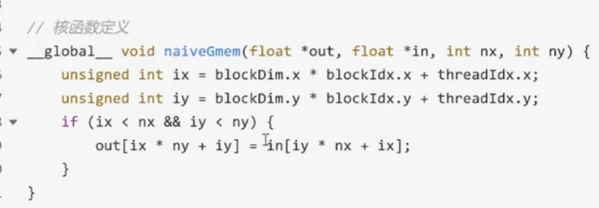
#define OFFSET(row, col, ld) ((row)*(ld) + (col)) __global__ void naiveGmem (float * out, float * in, int nx, int ny) { int ix = blockDim.x * blockIdx.x + threadIdx.x; int iy = blockDim.y * blockIdx.y + threadIdx.y; if (iy < ny && ix < nx){ out[OFFSET (ix,iy,ny)] = in[OFFSET (iy, ix, nx)]; } } void call_naiveGmem (float *d_out, float *d_in, int nx, int ny) dim3 blockSize (16 ,16 ) ; dim3 gridSize ((nx + blockSize.x - 1 )/blockSize.x, (ny + blockSize.y - 1 )/blockSize.y) naiveGmem<<<gridSize, blockSize>>>(d_out, d_in, nx, ny); }
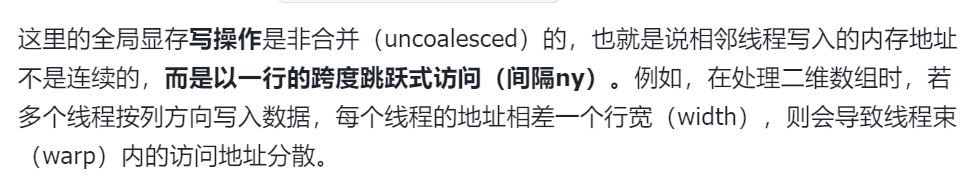
从Nsight分析来看,计算效率很低,只有10%不到,说明执行的thread的大部分时间都是在阻塞等待全局内存的数据的读写。尤其是非合并写入
注意点:
我们这里的转置任务,特地配置了总的thread数量是等于nx * ny的,所以一个thread只需要拷贝它对应iy, ix 处的float即可。
所以这里的主要问题 有两个:
没有共享显存的加速
非合并的写入
我们的相邻线程是ix是连续的,iy是不连续的 ,所以变动频繁的是ix
所以,读全局显存的时候,ix没有乘系数,所以可以合并访问
写全局显存的时候,ix乘了系数,所以对out这个全局显存的访问跨度是很大的,所以不是合并访问
所以,相邻线程,ix变动频繁,会导致我们的写入全局内存是非合并的。
全局显存的合并写入/非合并写入
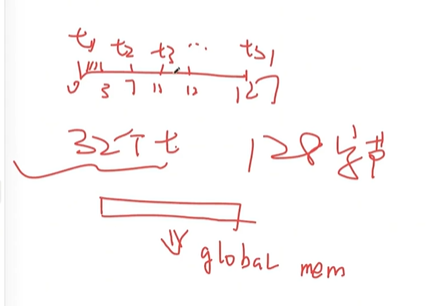
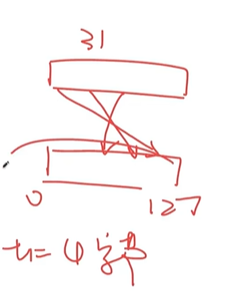
合并访问 :
此时就可以做一个合并的访问,把这32个请求同步发给全局显存的设备哪怕他是在128字节范围内随机访问,也可以合并访问
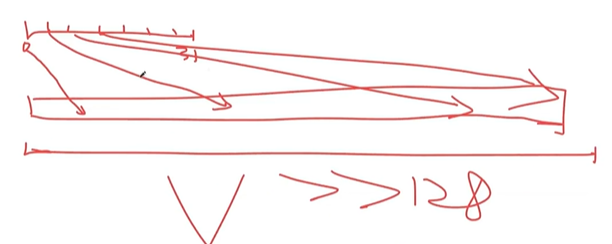
非合并访问
这种情况下,没有办法合并,显存的利用率非常的低下,就只能挨个发射访问请求 , 这个就是上面的out的写入,因为ix变化平凡,所以没办法合并优化。
所以朴素实现,它的瓶颈在于:drain stall
就是说,每个kernel的thread最后一句指令执行完了,还要等到才能退出。因为全局内存写入。
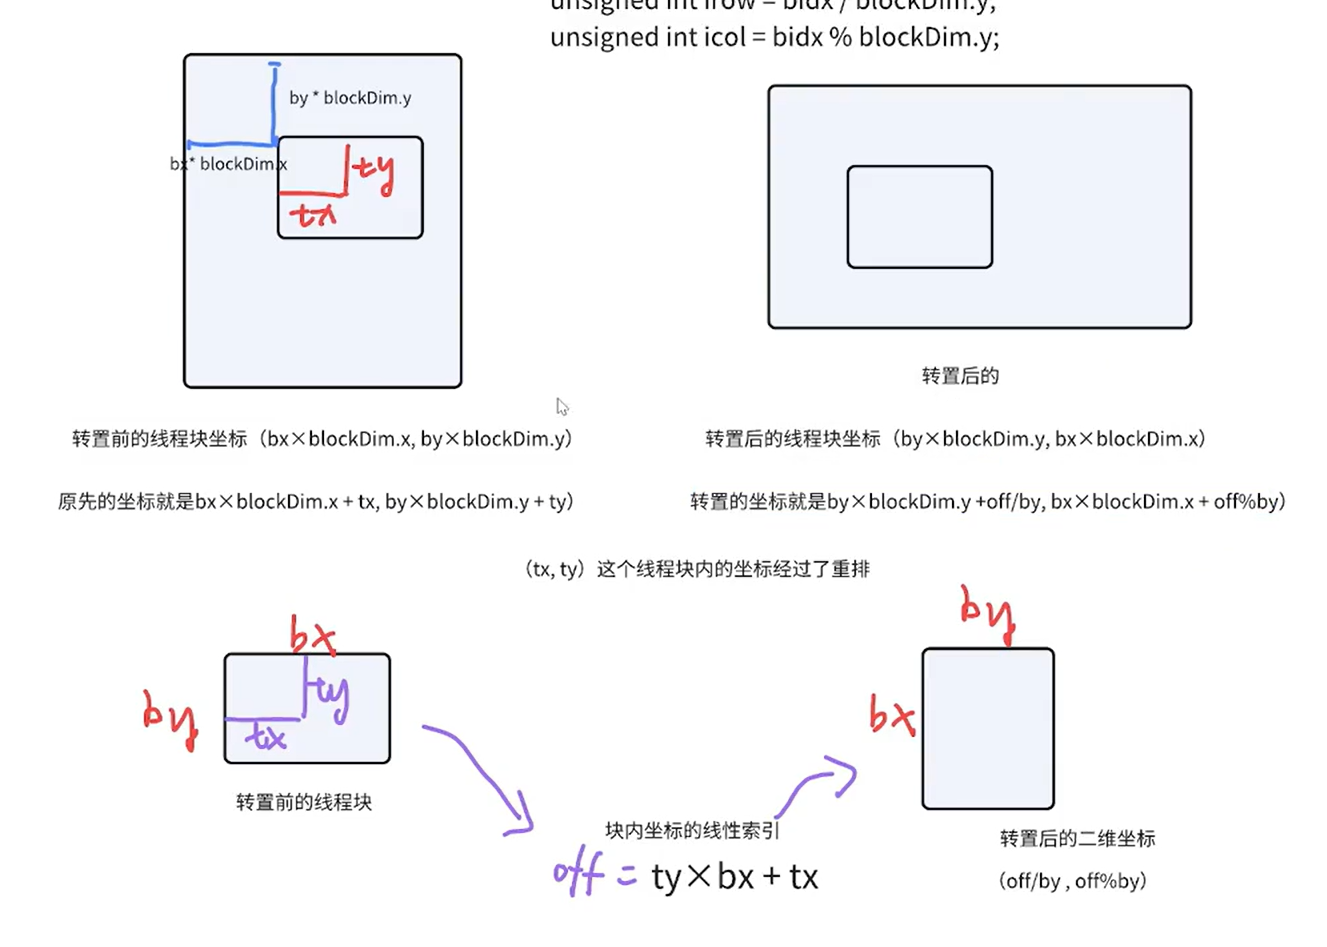
优化:用共享显存 前面的朴素实现的问题在于,假设我们已知在原来的A中的坐标是(tx, ty)
直接的想法是在转置后的B中的坐标是(ty, tx),但是这样会有一个问题。就是在写入out的时候,会导致对一维的显存写入,不能够合并访问。
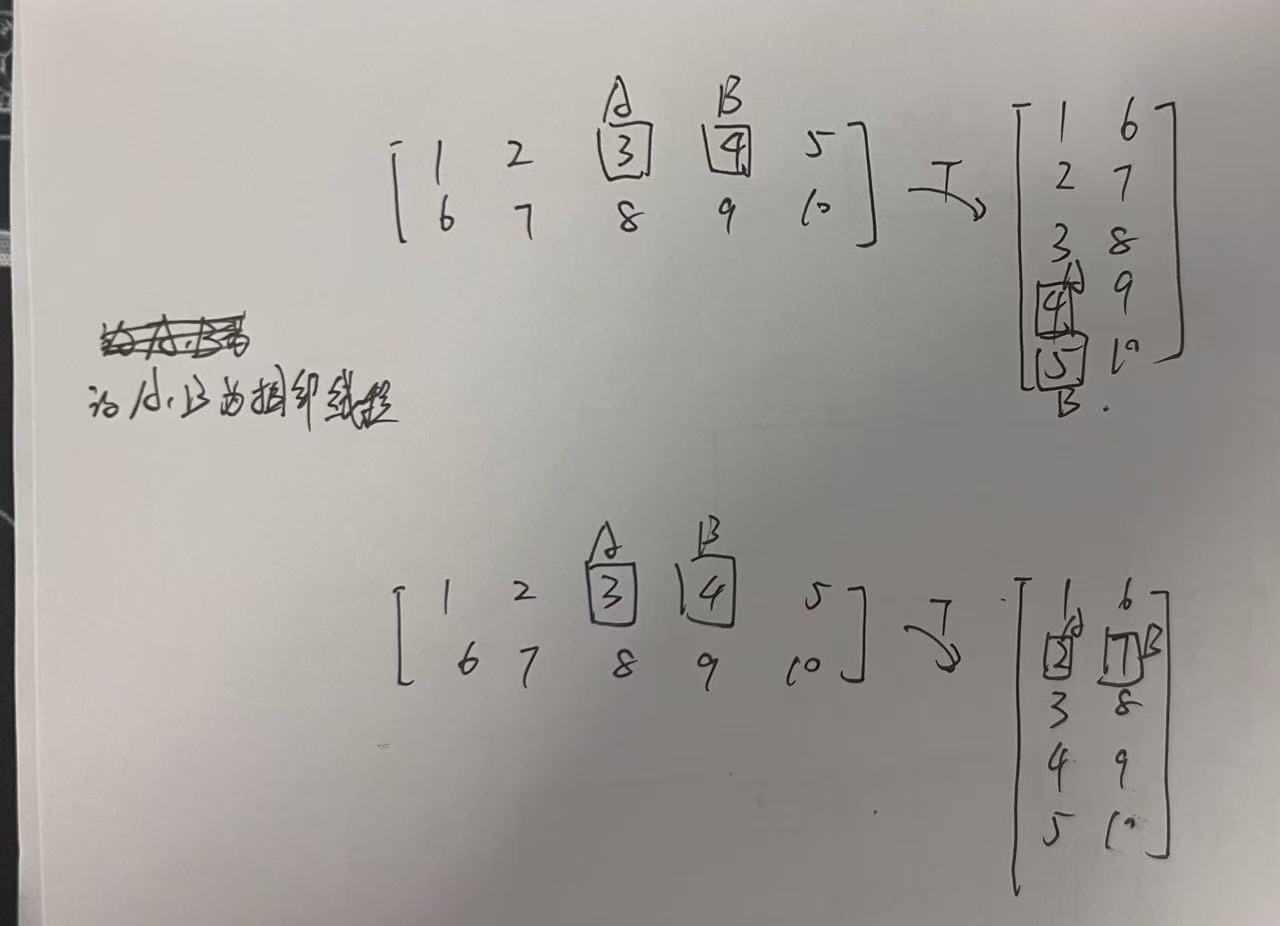
所以,这里的思路就是 :每个线程,不是和float元素值绑死,而是和拷贝位置绑死。
原来朴素实现,每个线程是和值绑死的,thread读出的是3,就负责把这个3写入到全局内存的对应位置
现在的共享显存优化:每个线程和内存位置绑死,thread只负责读/写[4]这个位置,读的时候这个位置是3,写的时候这个位置可能就是2了,这就要去共享内存里面去获得这个值(转置之后的值)
我先从固定的顺序位置 ,拷贝当前的值,写入共享显存,
然后从共享显存里面,找到别的thread写的,我接下来要写入固定顺序位置 的值
#define BDIMX 32 #define BDIMY 16 template <const int b_m 16 , const int b_n = 32 >__global__ void transposeSmen (float *out, float *in, const int nx, const int ny){ __shared__ float tile[b_m][b_n]; int M = ny; int N = nx; int t_id = OFFSET (threadIdx.y, threadIdx.x,b_n); int t_y_in = threadIdx.y; int t_x_in = threadIdx.x; int t_y_out = t_id / b_m; int t_x_out = t_id % b_m; int b_y = blockIdx.y; int b_x = blockIdx.x; in = &in[OFFSET (b_y * b_m, b_x * b_n,N)]; out = &out[OFFSET (b_x*b_n, b_y*b_m,M)]; tile[t_y_in][t_x_in] = in[OFFSET (t_y_in, t_x_in,N)]; __syncthreads(); out[OFFSET (t_y_out, t_x_out, M)] = tile[t_x_out][t_y_out]; }
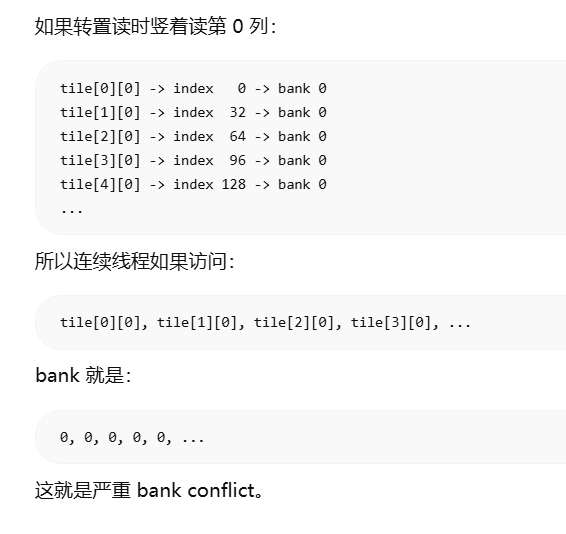
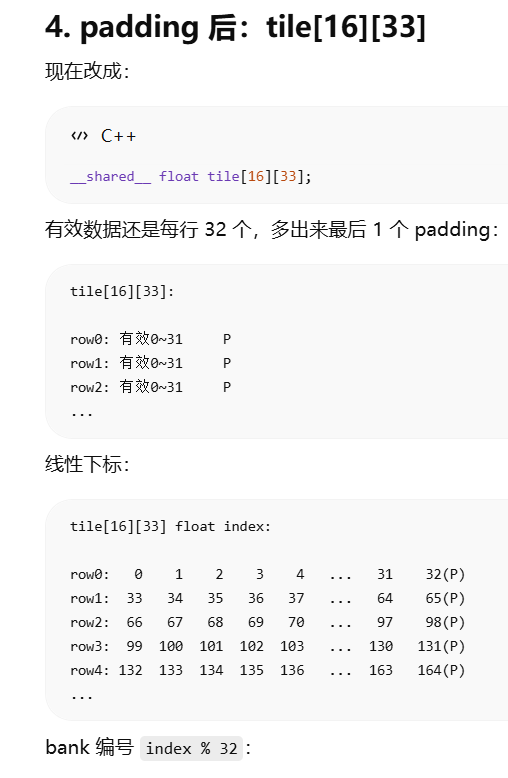
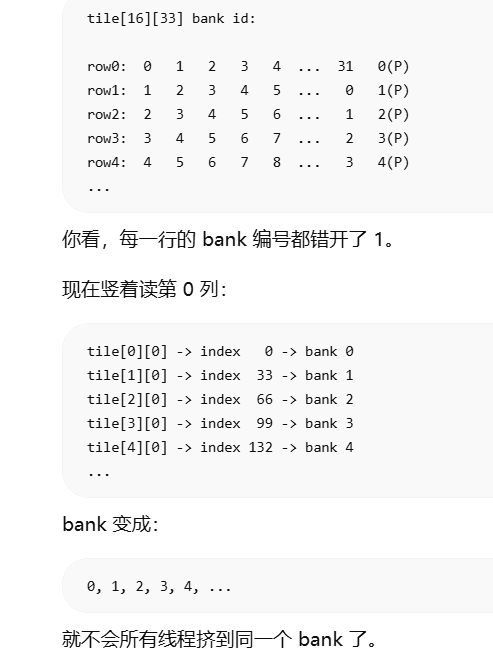
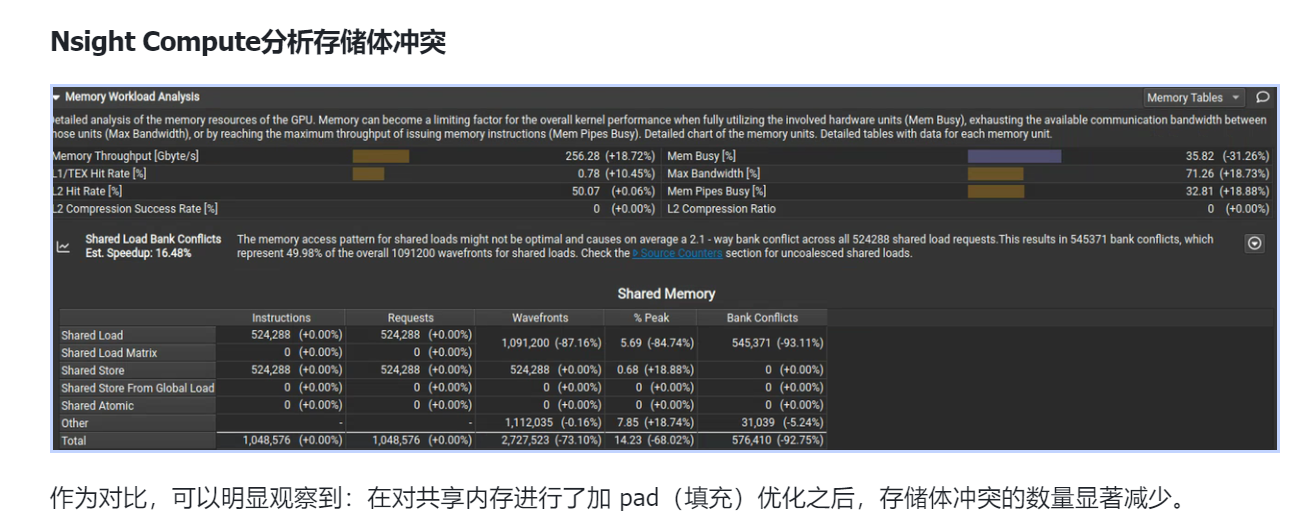
优化:共享内存(解决bank conflict问题)(填充=破坏一维线性下标) 上面的共享内存优化,在最后一句,读共享内存的时候,频繁变动的是t_x_out, 所以实际上是竖着访问共享内存中的每一个数据的。
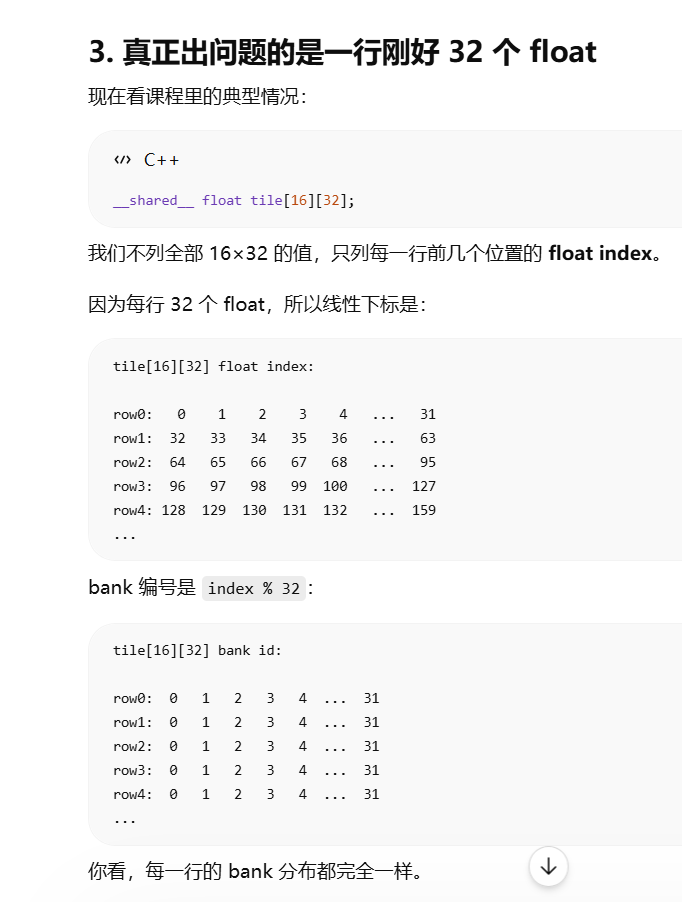
首先说明一下bank conflict的出现的原因:
共享内存的硬件设计上,是32个bank,每个bank一次访问的带宽是一个float。
所以只有当你的共享内存的跨度是32个float=128字节的时候,才会出现bank conflict的问题。
全局内存的合并写入的判定范围好像也是32个float
所以,如果我的共享显存是5x5的形状,那么就算我竖着访问,也不会触发bank conflict。只有当共享显存的一行有32个float的时候,竖着访问就会触发bank conflict。
注意,bank conflict本质上不是一列访问导致,而是在一维的索引上间隔32个导致
解决办法 :填充,来打破周期,不让两个线路的thread访问的位置在共享内存中出现在同一列。
那么它填充是什么办法呢?
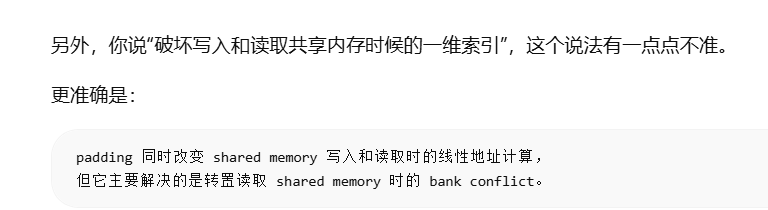
所谓填充,其实是破环原来的一维索引下的32个间隔的关系,变成33个间隔。 破坏的是线性下标
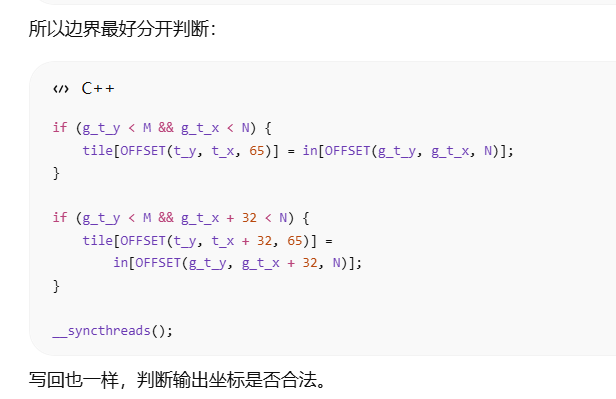
template <const int b_m 16 , const int b_n = 32 >__global__ void transposeSmempad (float *out, float *in, const int N, const int M){ int b_y = blockIdx.y; int b_x = blockIdx.x; int t_y = threadIdx.y; int t_x = threadIdx.x; in = &in[OFFSET (b_y * b_m, b_x * b_n,N)]; out = &out[OFFSET (b_x * b_n, b_y * b_m,M)]; __shared__ float tile[b_m * (b_n + 1 )]; int g_ty = threadIdx.y + blockDim.y * blockIdx.y; int g_tx = threadIdx.x + blockDim.x * blockIdx.x; int t_id = OFFSET (threadIdx.y, threadIdx.x, b_n); int t_y_out = t_id / b_m; int t_x_out = t_id % b_m; if (g_ty < M && g_tx < N){ tile[OFFSET (t_y, t_x, b_n + 1 )] = in[OFFSET (t_y,t_x, N)]; __syncthreads(); out[OFFSET (t_y_out, t_x_out, M)] = tile[OFFSET (t_x_out, t_y_out, b_n + 1 )]; } }
优化:共享显存和循环展开
该核函数通过让每个线程同时处理两个数据元素的方式来提升性能。这种优化策略旨在提高内存访问的并行性,从而更高效地利用设备的内存带宽
template <const int b_m 16 , const int b_n = 64 >__global__ void transposeSmemUnrollPad (float *out, float *in, int N, int M) { int b_y = blockIdx.y; int b_x = blockIdx.x; int t_y = threadIdx.y; int t_x = threadIdx.x; int t_id = t_y * blockDim.x + t_x; __shared__ float tile[b_m * (b_n + 1 )]; int g_t_y = t_y + b_y * b_m; int g_t_x = t_x + b_x * b_n; int t_y_out = t_id / blockDim.y; int t_x_out = t_id % blockDim.y; in = &in[OFFSET (b_y*b_m, b_x * b_n,N)]; out = &out[OFFSET (b_x * b_n, b_y * b_m,M)]; if (g_t_y < M && (g_t_x + blockDim.x) < N){ tile[OFFSET (t_y, t_x,b_n + 1 )] = in[OFFSET (t_y, t_x,N)]; tile[OFFSET (t_y, t_x + blockDim.x, b_n + 1 )] = in[OFFSET (t_y, t_x + blockDim.x,N)]; } __syncthreads(); if (g_t_y < M && (g_t_x + blockDim.x) < N){ out[OFFSET (t_y_out, t_x_out,M)] = tile[OFFSET (t_x_out, t_y_out,b_n+1 )]; out[OFFSET (t_y_out + blockDim.x, t_x_out, M)] = tile[OFFSET (t_x_out,t_y_out + blockDim.x, b_n + 1 )]; } }
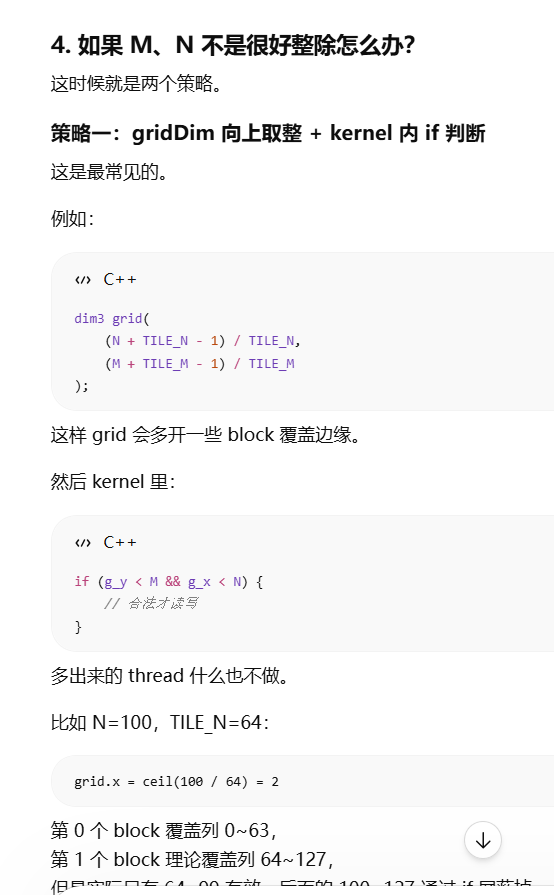
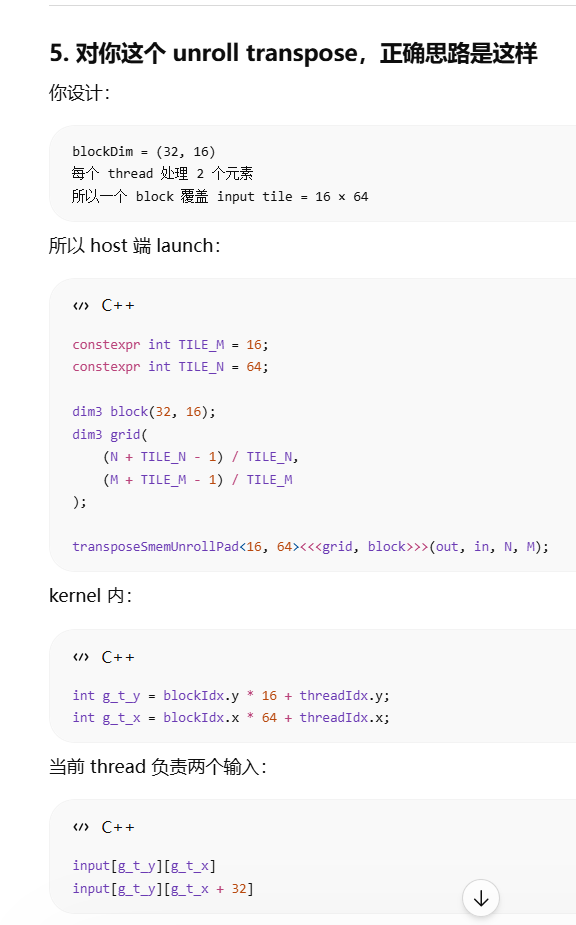
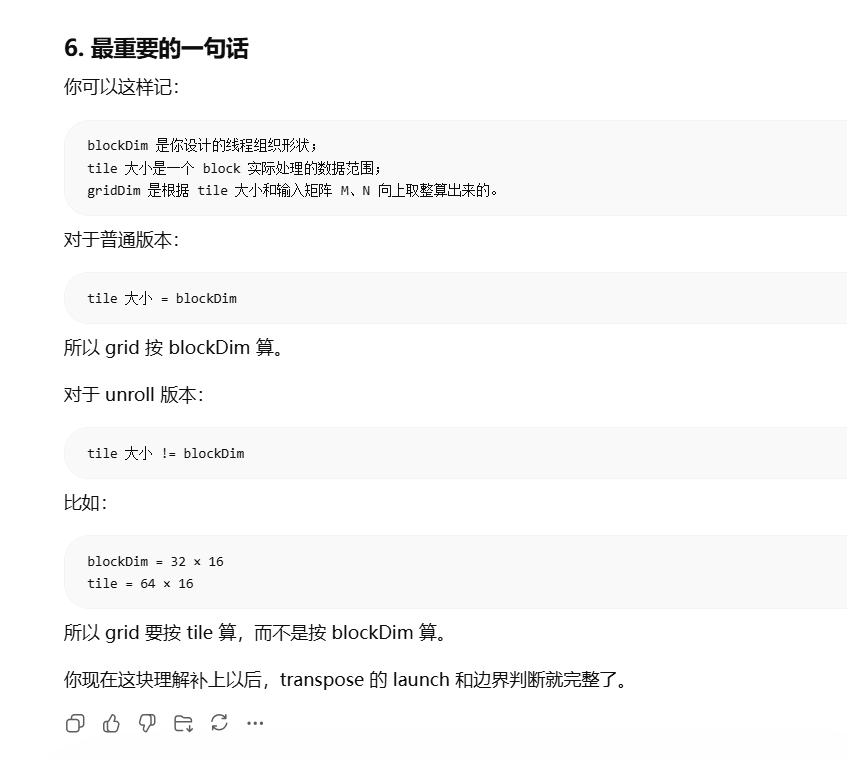
但是 unroll 版本里,一个 block 覆盖范围不等于 blockDim
你现在这个版本:
但是一个 thread 处理两个 x 方向元素:
input [row] [tx] input [row] [tx + 32]
所以一个 block 实际覆盖:
也就是:
所以 launch 时不能写:
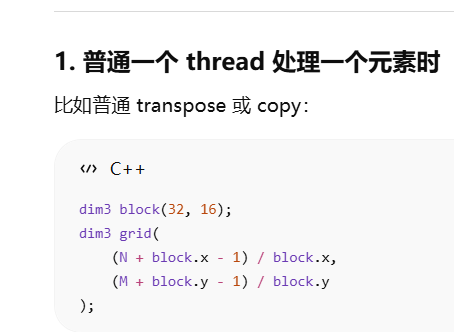
grid.x = (N + blockDim.x - 1 ) / blockDim.x ;
而应该写:
dim3 block(32 , 16 );dim3 grid( (N + 64 - 1 ) / 64 , (M + 16 - 1 ) / 16 );
或者写得通用一点:
constexpr int TILE_M = 16 ;constexpr int TILE_N = 64 ;dim3 block(32 , 16 );dim3 grid( (N + TILE_N - 1 ) / TILE_N, (M + TILE_M - 1 ) / TILE_M);
所以重点是:
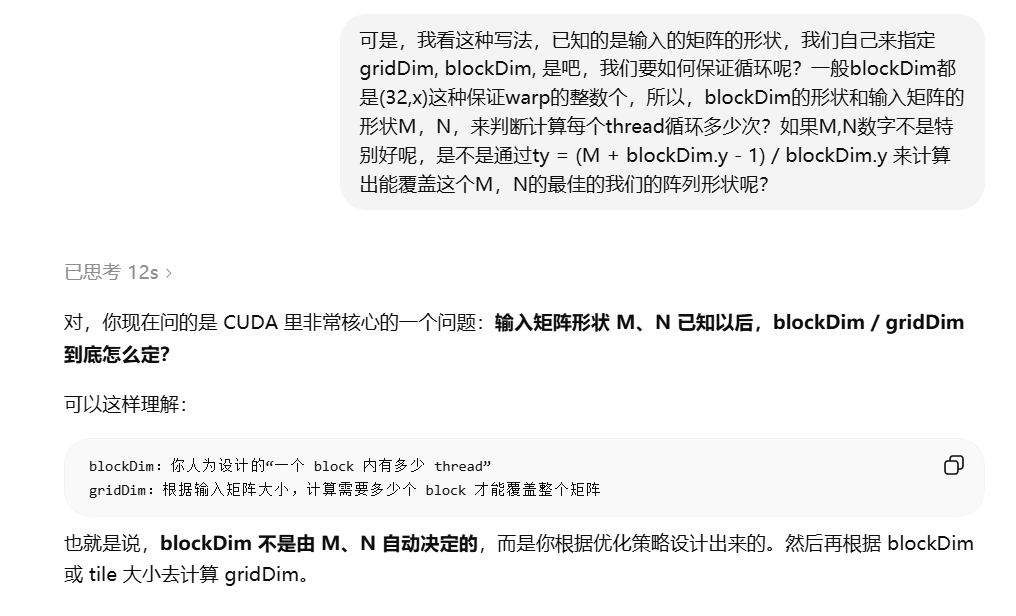
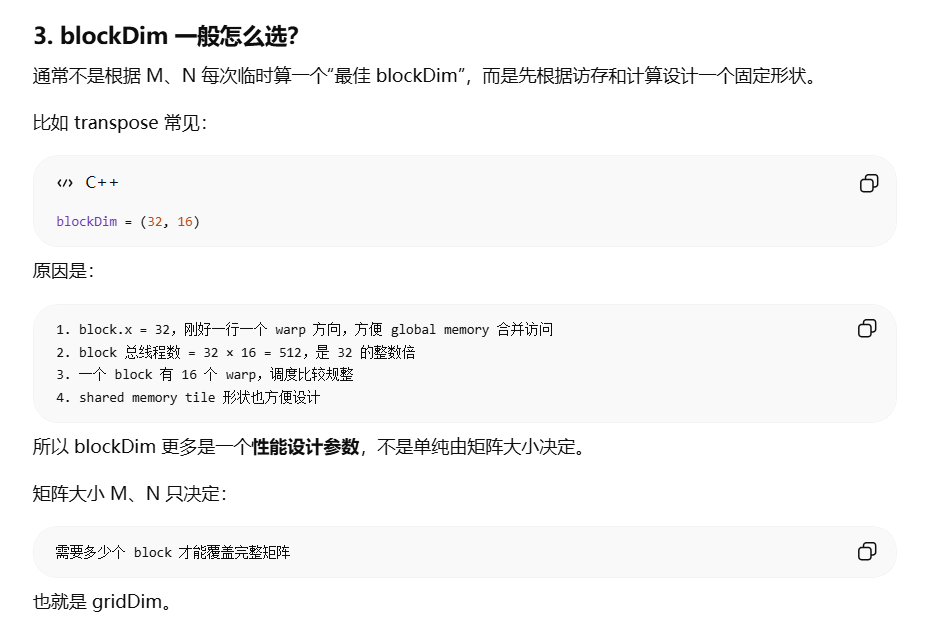
gridDim 不是一定按 blockDim 算,而是按“一个 block 实际覆盖多少数据”来算。