stm32-esp32s3-imx 存储架构讨论
介绍
这篇文档,主要记录我在初步认识esp32s3开发板的存储架构的时候,和stm32, imx6ull的存储架构的不同的讨论
借这个机会,了解启动流程,代码运行,mmu,哈佛架构,数据总线,指令总线,寻址地址,块设备,存储架构,cache这些的了解。
存储架构对比
下面先来对比一下,stm32,esp32s3,imx的存储器架构
stm32f103zet6
这个的存储器架构,之前就已经分析过了,就是内部ROM,内部RAM。
[ ARM Cortex-M3 ] |
stm32的bin用户代码,就烧录在内部ROM里面,上电后,start.S会把.data,.bss拷贝到内部RAM中,这样来运行。
由于都是内部ROM,RAM,所以无需mmu映射,单纯靠总线矩阵,就可以实现存储空间到寻址空间的映射
esp32s3-N16R8
[ Xtensa® Dual-Core LX7 ] |
esp32和单片机stm32的存储架构有些不同,他和跑linux的系统,有些类似,但是同时具备单片机的轻量和系统a核的那种性能,他同时具备:
- 内部ROM(384KB)
- 内部相当于存放bootROM代码
- 内部RAM
- 内存要求不高时,充当内存ram
- 外部ROM
- 实际bin文件存储的位置
- 外部RAM
- 用于扩展内存,比如需要存储很大的图片,原来的512KB肯定不够。
esp32s3和imx不同,他的外部存储器(ROM,RAM)都是通过SPI来进行访问的,所以:
- 如果没有启用MMU,那么外部存储器全部都是普通的块设备。
- 如果开启MMU,则外部存储器,比如外部ROM,就可以通过MMU来把物理存储空间,映射到寻址空间中
为什么esp32s3不像imx一样,用外部RAM?
ESP32-S3 支持外接高达 1GB 的外部 RAM(通常是 PSRAM,即伪静态随机存储器)。
为什么你在基础教程里没看到? 因为内置的 512KB SRAM 对跑一个简单的 Wi-Fi 联网或 LED 闪烁程序已经绰绰有余了。
什么时候会用? 当你要跑 LVGL 图形界面、摄像头拍照、AI 语音识别或者本地 Web 服务器时,512KB 瞬间就会满,这时候你买的开发板通常会带一个 8MB 或 16MB 的 PSRAM 颗粒。
当你按下复位键,ESP32-S3 的内存会经历这个过程:
代码段 (.text): 留在外部 Flash 里,通过 ICache 映射到 0x4200_0000。
常量 (.rodata): 留在外部 Flash 里,通过 DCache 映射到 0x3C00_0000。
变量 (.data / .bss): 必须搬运到 内部 SRAM,地址在 0x3FC8_0000 附近。
如果你开启了
PSRAM(外部RAM): 那么你可以通过heap_caps_malloc(MALLOC_CAP_SPIRAM) 在外部 RAM 里开辟巨大的缓冲区。
imx6ull
[ ARM Cortex-A7 ] |
这个架构就是标准的linux开发板的架构,具体不多说了。
imx的外部存储器和esp32不太一样。
- 外部ROM,imx的是sd卡,emmc这些,因为存储空间非常大,16G,32G,寻址空间没这么多,所以一般不用MMU映射到寻址空间,而是单纯的用作块设备。
- 外部RAM,也就是DDR,imx是有独立的ddr总线进行连接,所以是可以映射到寻址空间的。
注意,这三个都是哈佛架构,也就是CPU有数据总线和指令总线,具体使用在下面讲
总结对比
特性, STM32 (F1系列), ESP32-S3 (及类似芯片), i.MX (及其他 MPU) |
为什么 ESP32-S3 的过程感觉像 i.MX?
你感觉像 i.MX 是因为它们都引入了 MMU (内存管理单元) 和 Cache (缓存)。
i.MX 的逻辑: 外部存储(Flash/SD卡)太慢,必须在上电后把整个 Linux 内核和大程序全部搬运到外部 DDR RAM 里跑。
ESP32-S3 的逻辑 (XIP): 外部 Flash 虽然慢,但我有一个聪明的 Cache。CPU 想读哪段代码,Cache 就去 Flash 搬哪段,映射到虚拟地址空间。
这就是为什么 ESP32 即使不接外部 RAM 也能跑: 它把内部 SRAM 的一部分临时当成了外部 Flash 的“窗口”。
既然像 i.MX,为什么不默认全用外部 RAM?
既然可以外接 1GB,为什么不干脆像 i.MX 那样全跑在外部 RAM?主要有三个考量:
功耗控制: 访问外部总线(SPI/QPI)非常耗电。单片机首要任务是低功耗,能用内部 SRAM 解决的就绝不出门。
延迟 (Latency): 内部 SRAM 是单周期访问(快如闪电);外部 RAM 即使有 Cache,也存在未命中时的等待时间。
引脚资源: i.MX 为了接 DDR 动辄占用几十个引脚;ESP32-S3 常用 SPI 接口,虽然节省了引脚,但带宽上限封死了。
cache
上面,已经整理了stm32,esp32,imx的存储架构的区别。下面来具体讨论,经常看到说,cache可以加速访问RAM,ROM,为什么?
如果最终都要从慢速的外部 ROM 搬东西,那 Cache 凭什么能快?
- Cache 聪明的点在于:它不是“按需取一个”,而是“顺便带一堆”
第一次读取 (
Cache Miss): 当 CPU 第一次要读某个地址的代码时,Cache 确实得苦哈哈地去外部 Flash 搬运。这时候 CPU 必须等待(Stall),速度确实慢。空间局部性 (
Spatial Locality): 你的代码通常是顺序执行的。当你读地址 0x01 时,Cache 预判你马上要读 0x02, 0x03… 所以它会一次性从 Flash 搬回一个缓存行 (Cache Line),比如 32 字节或 64 字节。时间局部性 (
Temporal Locality): 代码里有很多 for 循环或函数调用。一段代码被搬进 Cache 后,循环 1000 次,除了第一次是慢的,剩下的 999 次都是直接从内部 SRAM 读。
cache,相当于是内部RAM中,对于外部ROM的一段动态窗口映射
在 ESP32-S3 中,确实会划出一部分 Internal SRAM(比如 SRAM 0 的一部分)专门给 Cache 使用。但这块 SRAM 并不是死死地对应 Flash 的某一段,而是一个动态池子。
标签 (Tag) 机制: Cache 内部会维护一张表。它记录了:“我现在这块 SRAM 里存的到底是从 Flash 哪个地址搬过来的东西?”
动态替换: 比如你划了
32KB的 SRAM 做Cache。当你运行程序 A 段时,这 32KB 填满了 A 段的代码。
当你突然跳转到程序 B 段(在 Flash 另一个很远的地方),Cache 发现这 32KB 里没有 B,它就会把旧的 A 代码踢出去,从 Flash 搬 B 段进来覆盖掉。
ESP32-S3 的特殊性:ICache 与 DCache
ESP32-S3 把这个“替身”分得更细:
ICache (Instruction Cache): 专门给指令总线用。CPU 读代码去执行时走这里。它只读不写,所以逻辑简单,速度极快。DCache (Data Cache): 专门给数据总线用。如果你在 Flash 里存了一些大的图片、常量表,CPU 读取它们时走这里。
注意: 在 ESP32-S3 中,你可以通过配置,决定到底拿多少 SRAM 出来当 Cache。
如果你不设 Cache,那这部分 SRAM 就能当普通的 RAM 存变量。
如果你设了 Cache,这部分 SRAM 就不再受你控制,而是受
MMU(内存管理单元)自动管理,专门负责和外部 Flash 对接。
–
以上就是对cache的一些认识,它本质上是一块SRAM区域,只不过这里面不是存储固定的内容,而是对其他存储器空间的一个动态映射。这样一次拷贝,可以把一整个映射区域的内容都拷贝过来,cpu读取内容就是在SRAM的cache中,而不是每次等待长时间来访问外部ROM
总线,数据总线,指令总线
既然上面提到了总线,我看stm32,imx里面都没有提到数据总线,指令总线,当时就只是单纯的说cpu取PC指针的指令,执行。
事实是:STM32 和 i.MX 都有指令总线和数据总线,只是它们的表现形式和重视程度不同
两种基础架构:冯·诺依曼 vs. 哈佛
冯·诺依曼架构 (Von Neumann): 指令和数据全都挤在一根总线上。就像一条单行道,CPU 要么取指令,要么取数据,不能同时干。
哈佛架构 (Harvard): 指令和数据有各自独立的总线。就像双向八车道,CPU 可以一边取下一条指令,一边读内存里的变量。
stm32的总线
在 STM32F103 (Cortex-M3) 中:
其实它也是哈佛架构。如果你翻开《STM32参考手册》的“存储器架构”一节,你会看到三根总线:
I-Code 总线: 专门去 Flash 取指令。
D-Code 总线: 专门去 Flash 取常量(Literal data)。
System 总线: 去 SRAM 读写变量。
为什么你没感觉? 因为 STM32 内部有一个叫 总线矩阵 (Bus Matrix) 的东西。它像一个交通警察,自动把这些请求分流了。对开发者来说,你只需要操作地址空间(0x0800… 或 0x2000…),感觉好像只有一套内存。
imx中的总线
在 i.MX (Cortex-A 系列) 中:
i.MX 这种高性能处理器更是彻头彻尾的哈佛架构。它的 L1 Cache(一级缓存) 是严格分成 I-Cache 和 D-Cache 的。
为什么你没感觉? 因为 i.MX 运行的是 Linux 或复杂的系统,这些底层的总线路由完全由内核和硬件 MMU 自动处理了,应用层根本碰不到。
esp32的总线
为什么 ESP32-S3 显得这么“显眼”?
ESP32-S3 把指令总线和数据总线拎出来强调,是因为它的外部存储架构太特殊了:
物理上的割裂: ESP32-S3 的代码存在片外 Flash。CPU 想运行代码,必须通过指令总线走
ICache去 Flash 搬运。地址映射的强制划分:
当你访问
0x4200_0000开头的地址,硬件雷达就会识别:“这是指令总线请求!”,然后去触发ICache。当你访问
0x3C00_0000开头的地址,硬件雷达会识别:“这是数据总线请求!”,然后去触发DCache。
这些都是硬件自动执行的,软件OS只需关注访问寄存器即可
- 开发者的控制权: 在 ESP32 中,你可以手动决定把一段代码放进 SRAM(为了快)还是留在 Flash(为了省空间)。由于 SRAM 0/1/2 的访问限制不同,你必须清楚哪根总线能通向哪块内存。
哈佛架构的工作模式
CPU 可以一边通过“指令总线”抓取下一条指令,一边通过“数据总线”读取当前指令需要的数据
举例:
工厂有两条独立的传送带:指令带和数据带。
时刻 1: 指令带把“指令 1”运给工人 B。
时刻 2(高潮来了):
工人 B 正在执行“指令 1”(比如:把变量 X 加 1)。他通过数据总线去 SRAM 里读变量 X。
与此同时,工人 A 通过指令总线把“指令 2”运了过来。
结果: 两个动作同时发生,CPU 永远有指令可以跑,不用停下来等总线。
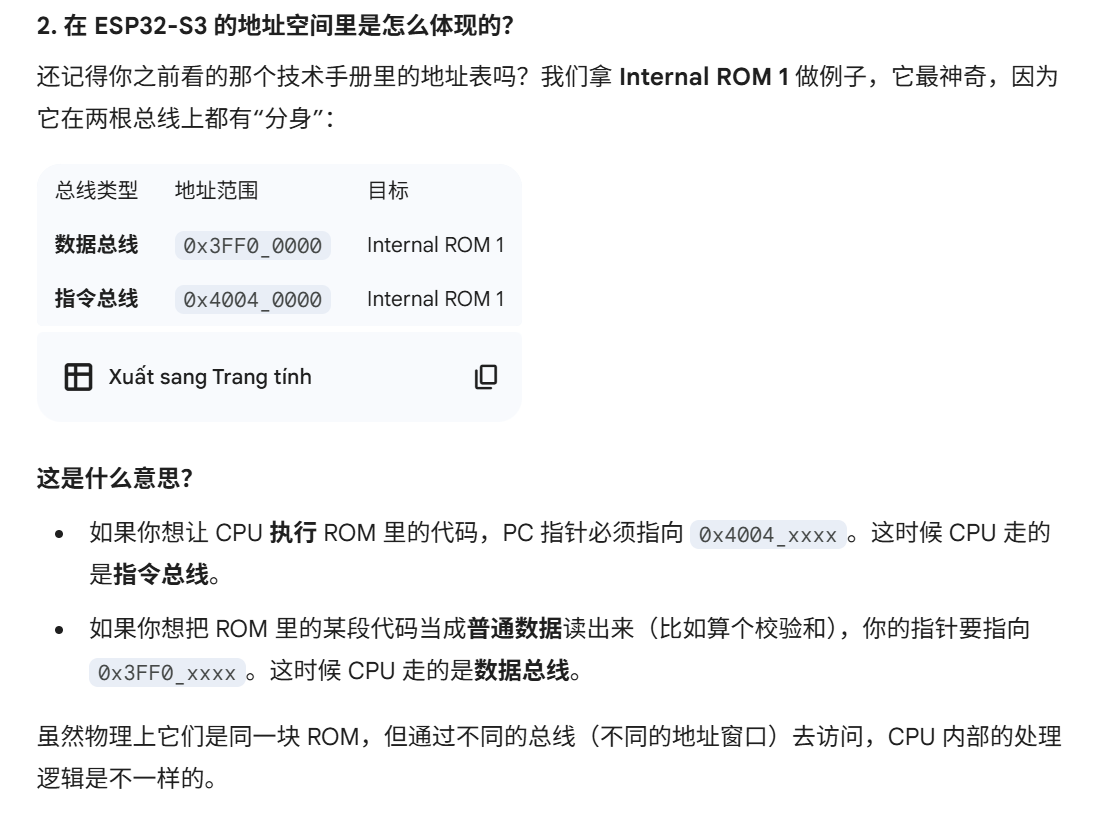
可以看到,CPU会根据你的指针指向的地址,自动判断,是走指令总线,还是数据总线。
=========================================================== |
可以看到,当设置了Cache,那么SRAM中的cache部分,就不再由用户控制,而是受总线和mmu控制。
Cache 的“动态搬运”过程
这是你之前最纠结的地方。请看图中的 外部 Flash:
CPU 想运行地址 0x4200_1000 的代码。
ICache 检查自己:“我这儿有这段代码吗?”
如果没有 (Miss): ICache 会通过外部 SPI 接口,从 Flash 猛吸一大块代码(比如 32 字节)存入 Cache(这部分其实占用了内部 SRAM 的一部分空间)。
如果有 (Hit): CPU 直接从 ICache 拿,速度和读内部 SRAM 一样快(1 个时钟周期)。
程序段和存储器
下面来看看实际存储器的存储空间,是如何映射到寻址空间上的。
下图是esp32s3的寻址空间映射表:
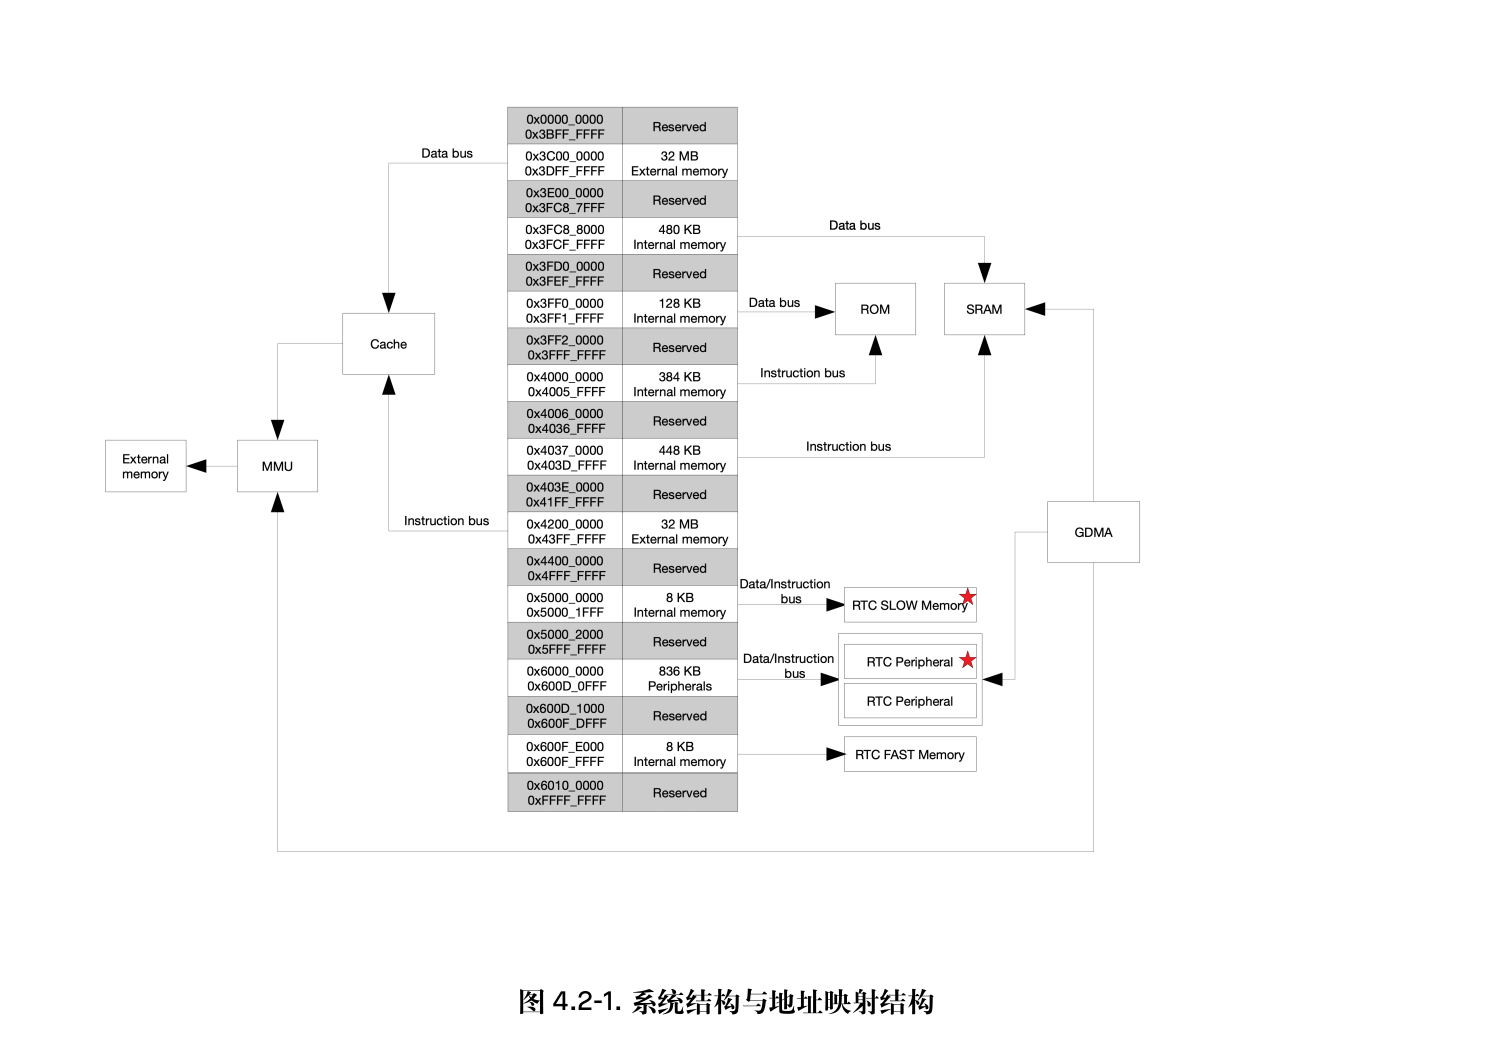
可以看到,实际内部ROM应该只有384KB,但是他这两段加起来都不止了。这是因为地址重叠
1. 为什么内部 ROM 地址是分成两块的?
在传统的 STM32 认知里,ROM 就是一块连续的地址。但在 ESP32-S3 中,ROM 地址的分开其实是为了总线分工:
物理上: 内部 ROM 确实是一块完整的 384 KB 硅片。
逻辑上(地址映射):
Internal ROM 0 (0x4000_0000 开始):专门映射到指令总线 (Instruction Bus)。CPU 只有通过这个地址段才能“执行” ROM 里的代码。
Internal ROM 1 (0x3FF0_0000 和 0x4004_0000):它是一个双端口映射。它既可以从数据总线访问(读数据),也可以从指令总线访问(运行程序)。
为什么要分开? 这样设计的目的是为了实现并行访问。当 CPU 通过
指令总线在 ROM 0 执行一段程序时,它依然可以通过数据总线从 ROM 1 读取一些预存的常量,两条总线互不干扰,效率最高。
2. ICache 和 DCache 是从内部 RAM 分出来的吗?
是的,你的理解完全正确。 它们不是独立的硬件存储器,而是“借用”了内部 SRAM 的空间。
借用关系:
ICache 借用的是 Internal SRAM 0 的一部分空间(最高可达 32 KB)。
DCache 借用的是 Internal SRAM 2 的一部分空间(最高可达 64 KB)。
配置的代价:
- 当你通过软件配置开启了 32 KB 的 ICache 后,你可用的通用 SRAM 指令空间就会减少 32 KB。
- 如果你关掉 Cache,这部分空间就可以当作普通的 RAM 来存数据或跑程序。
为什么不设计独立的 Cache 硬件?
- 为了灵活性。如果你开发的程序很小,根本不需要外部 Flash,那你就可以关掉 Cache,把所有 SRAM 都拿来当内存用,不浪费一点资源。
同一块存储空间,既走指令总线,又走数据总线
这种既能走指令总线(IBUS)又能走数据总线(DBUS)的设计,主要服务于以下几种真实的开发场景:
1. 查找表与常量数据(Literal Pools)
这是最常见的情况。在编写 C 语言代码时,如果你定义了一个巨大的常量数组:const char my_table[] = { ... };
编译器视角:它通常把这个数组放在
.rodata(只读数据段)里。CPU 执行视角:当 CPU 运行到
x = my_table[i]时,它是通过数据总线去读取这个地址的。ESP32-S3 的特殊性:如果这个数组被编译器优化放到了代码段(
.text)附近,或者就在 ROM 里。如果没有“数据总线访问代码区”的能力,CPU 只能执行代码,却无法读取代码中间夹杂的数据,程序就会崩溃。
为什么地址要映射成两份?(消除竞争)
你上传的技术手册里提到,Internal ROM 1 的物理内容完全相同,但映射到了两段地址。
这种设计被称为双端口访问(Dual-port access):
如果只有一段地址,当 CPU 正在通过这根总线取指令时,如果突然要读数据,总线就得停下来切换,这叫“流水线停顿”。
映射成两段后,CPU 可以同时从指令地址取指,从数据地址读数。虽然物理上是同一个 ROM 单元,但逻辑上它们像是在两个不同的车道上跑,互不打扰。
stm32也有,但是硬件自动处理了,保证了高带宽,但是esp32,它把指令通道(IBUS)和数据通道(DBUS)直接摆在你面前,甚至通过不同的地址空间让你手动选择“超车道”,从而压榨出每一分性能
esp32s3介绍
我目前手头上的这个esp32S3,MODEL XH-S3E,WIFI + BT N16R8
- 内部ROM(384KB)
- 内部RAM(512KB)
- 外部ROM(16MB flash)
- 外部RAM(8MB)
存储类型, 容量, 对应你文档中的位置, 物理位置, 用途 |
为什么 N16R8 这种型号更需要 Cache?
你现在拥有 16MB Flash 和 8MB RAM,但 CPU 的地址总线能直接“摸”到的内部空间只有 512KB SRAM。这就完美解释了你之前看的文档里为什么要提 ICache 和 DCache:
分流 (Mapping):
- 由于
外部 Flash和PSRAM都是通过SPI连接的,物理地址不连续。ESP32-S3 的 MMU 会把这16MB Flash映射到指令总线的0x4200_0000窗口,把8MB PSRAM映射到数据总线的0x3C00_0000窗口。
- 由于
缓存 (Caching):
- ICache: 负责从
16MB Flash里预取代码到SRAM 0中,让 CPU 跑起来。 - DCache: 负责从
8MB PSRAM里预取数据到SRAM 2中,解决 SPI 速度慢的问题。
- ICache: 负责从
内存,堆的申请
堆(Heap)的申请:随心所欲的选择
对于你手上的 N16R8(8MB PSRAM),ESP-IDF 提供了非常灵活的内存分配函数。
默认 malloc():通常会优先申请内部 SRAM,因为速度最快。
显式申请外部 RAM:
- 如果你要处理一张 4K 图片,内部 SRAM 肯定放不下,你可以调用:
// 强制在外部 PSRAM 中申请内存 |
- 显式申请内部 RAM:
- 如果是给中断服务程序用的缓冲区,必须极快,则调用:
char *fast_buf = (char *)heap_caps_malloc(1024, MALLOC_CAP_INTERNAL); |
访问速度
存储类型, 速度等级, 访问成本 (周期), 访问路径 |
mmu,总线矩阵
总线
“总线”在物理层面就是一排平行的导线,但在逻辑层面,它是一套通信协议和身份证明。
1. 物理层面
就是排线
2. 逻辑层面
如果你只是把 16 根线连在一起,那叫“并排导线”。之所以叫“总线”,是因为它有一套地址分配机制。
想象一条大街(总线),街边有很多房子(存储器):
STM32 的总线:像是一条内部大街。
- CPU、内部 SRAM、内部 Flash 都在这条街上。
- 因为大家都在芯片内部,距离极短,线可以铺得非常多(比如 32 位甚至 64 位),所以速度极快。
ESP32-S3 的总线:它面临一个挑战。它的“大仓库”(16MB Flash 和 8MB PSRAM)在芯片外面。
- 限制:芯片引脚有限,不可能在 PCB 上铺 32 根线去连 Flash。
- 现状:所以它用了 SPI/QPI/OPI。你的 N16R8 型号中的 R8(PSRAM)通常使用的是 OPI (Octal SPI),物理上只有 8 根数据线。
- 魔法:虽然物理上只有 8 根线(串行/并行组合),但 CPU 内部的总线矩阵会把这 8 根线“伪装”成 32 位的内部地址空间
【芯片内部 (高速、宽阔)】 【芯片引脚】 【外部 PCB (窄、长)】 |
为什么外部 RAM 感觉“慢”?
当你申请外部 RAM 时,数据要经历:
- CPU 发出 32 位指令。
- 总线矩阵识别出地址属于外部映射区。
- Cache 检查是否命中。
- SPI 控制器 把 32 位数据拆成 4 次(8位宽时)发给外部颗粒。
- 外部颗粒感应、充放电、传回。
esp32的外部RAM 对比 imx的ddr
同样是外部RAM,
- esp32还是依靠外设来访问,依靠mmu来实现块设备->地址空间的映射,MMU 是为了“伪装”
- 在 ESP32 中,外部 RAM(PSRAM)在物理上确实是一个**“块设备”**(通过 SPI 这种一问一答的协议通信)。
- 没有 MMU 的话:你必须写类似
spi_ram_read(address, buffer, len)的代码。这太痛苦了,也没法跑 C 语言的指针。 - 有了 MMU 的作用:它把 SPI 的通信逻辑硬件化了。当你访问 0x3C00_0000 时,MMU 拦截这个地址,自动把它转成 SPI 指令发给外部芯片。
- 没有 MMU 的话:你必须写类似
- 在 ESP32 中,外部 RAM(PSRAM)在物理上确实是一个**“块设备”**(通过 SPI 这种一问一答的协议通信)。
本质:这里的 MMU 是为了**“接口转换”,把非总线接口**(SPI)伪装成总线接口。
- i.MX 的 DDR:MMU 是为了“管理”
- i.MX 的 DDR 控制器(DDRC)本身就是总线的一部分。即便你不开 MMU,CPU 只要上电初始化好 DDR 控制器,就能直接通过物理地址访问 DDR。
既然硬件能直接访问,为什么还要 MMU?
在 i.MX(尤其是跑 Linux)这种高性能系统中,MMU 的作用不再是“伪装接口”,而是“虚拟化”和“权限控制”:
虚拟地址 (Virtual Addressing):让每个进程都以为自己拥有从 0x0000_0000 开始的完整 4GB 内存,而实际上它们分散在 DDR 的各个角落。
内存保护 (Protection):防止用户程序(App)乱改内核(Kernel)的数据。如果 App 越界,MMU 硬件会立刻触发异常(Segmentation Fault)。
缓存策略:告诉 CPU 哪块内存需要 Cache(比如代码区),哪块内存不需要 Cache(比如 DMA 缓冲区)。
映射到一套地址空间
要把各种存储、外设映射到一套地址空间,其实是总线矩阵-静态和 MMU-动态分工合作的结果。
总线矩阵(Bus Matrix)—— “交通指挥中心”:
作用:它决定了硬件上的固定物理地址。比如你手册里提到的 Internal SRAM 1 始终在 0x3FC8_8000。
本质:它是纯硬件电路。芯片设计时,工程师就把地址解码器焊死了。当 CPU 访问某个地址,矩阵就像拨动了物理开关,直接导向对应的设备。
无感性:它不需要你写代码去“开启”,上电就存在。
MMU(Memory Management Unit)—— “地址翻译官”:
作用:它把 CPU 想访问的“虚拟地址”翻译成“物理地址”。
开关区别:
关闭 MMU:CPU 直接访问物理内存(实模式)。指令 0x42000000 就是去读电路板上对应的那个物理点。
开启 MMU:CPU 发出 0x42000000,MMU 查表发现它对应外部 Flash 的第 100 个扇区,于是去发指令读取。
本质:它是纯硬件逻辑,但需要软件(OS 内核或 Bootloader)预先在内存里写好一张“映射表”。
地址映射 vs. 块设备:为什么 ESP32 映射,i.MX 却不映射?
你敏锐地察觉到了:ESP32 确实把“块设备”(Flash)伪装成了“内存”。
ESP32-S3 的做法(XIP - 就地执行):
它的 MMU 配合 Cache 做了一层特殊的映射。虽然 Flash 物理上是按“块”读写的,但 MMU 会以 64 KB 为单位把 Flash 映射到地址空间。
- 原因:ESP32 的内部 RAM 太小(512 KB),放不下动辄几 MB 的程序,必须让 CPU 能直接在外部 Flash 上“跑”代码。
i.MX 的做法(加载到 RAM 执行):
i.MX 也有 MMU,但它的 MMU 主要服务于 DDR RAM。
为什么不映射 SD/eMMC?
- 延迟:SD 卡访问一次要几毫秒,如果映射到总线上,CPU 每一条指令都要等几毫秒,系统就卡死了。
- 文件系统:SD 卡里有分区、目录。映射地址只能映射“原始字节”,没法映射“文件”。
- DDR 太强大:i.MX 有 1GB 的 DDR,它习惯先把程序一次性从 eMMC “搬运”到 DDR,然后在 DDR 里飞速运行。
BootROM 怎么找到“第一行代码”?
这是一个“先有鸡还是先有蛋”的问题。既然没映射,BootROM 怎么读 SD 卡?
答案是:BootROM 根本不查地址,它是在跑“驱动程序”。
固化的逻辑:Internal ROM 里的代码是出厂就写死的。它里面内置了一个极其简化的 SD/eMMC 驱动程序。
搬运工模式:
上电后,CPU 跑 Internal ROM。
它不是去“访问地址”,而是通过特定的寄存器给 SD 控制器下命令:“读取 SD 卡前 4KB 的数据到 SRAM 地址 0x3FC80000”。
搬完后,CPU 的 PC 指针跳转到 SRAM 的 0x3FC80000。
IVT 的秘密:
在 i.MX 中,这个过程叫 Bootloader 加载。IVT(指令向量表)就在被搬运的这几 KB 数据的开头。CPU 并不是在 SD 卡里直接读 IVT,而是在搬运到内部 SRAM 后才去读它的。
备注
讨论底层架构相关,主要是这些方面
- 存储器架构
- ROM,RAM
- 代码内存结构
- 代码段,数据段
- 总线:
- 指令总线,数据总线
- cache
- (ICache, DCache)
- MMU
- (寻址的地址空间的物理映射)
1. 内核架构(最顶层的“根”)
- ARM Cortex-M(STM32、ESP32)
- ARM Cortex-A(i.MX 系列)
- 指令集:Thumb / ARM / RISC-V
- 流水线、中断架构(NVIC)、异常模型
内核决定:能跑什么、速度、实时性、有没有 MMU/MPU
2. 存储器架构(你说的完全对)
- Flash(程序存储)
- RAM(SRAM/PSRAM)
- 片上 ROM(BootROM)
- 地址映射、存储器别名、奇偶校验/ECC
3. 总线架构(你抓住关键了)
- 系统总线(AHB/AXI)
- 外设总线(APB)
- 指令总线 / 数据总线(哈佛结构)
- 总线矩阵、多主机、优先级
- DMA 通路(底层性能关键)
4. 运行时内存模型(代码内存结构)
- .text 代码段
- .rodata 常量
- .data 已初始化数据
- .bss 未初始化数据
- 堆 / 栈
- 中断向量表位置
5. Cache(你写得很标准)
- ICache 指令缓存
- DCache 数据缓存
- Cache 行、一致性、旁路策略
6. 地址空间与地址翻译(你说的 MMU 属于这里)
- MCU(Cortex‑M):MPU / 保护单元
- MPU(Cortex‑A,如 i.MX):MMU + 虚拟地址 → 物理地址
- 外设寄存器地址映射
- 启动地址、异常入口地址
7. 时钟与复位(底层最基础的“心跳”)
- 时钟树:PLL、HSE/HSI、分频
- 时钟域、异步/同步
- 复位源、上电复位、系统复位
8. 外设与 IO 子系统
- GPIO、UART、SPI、I2C、ADC、PWM…
- 时钟使能、寄存器操作
- 中断路由
9. 启动与 Boot 流程(真正“底层到底”)
- BootROM 做什么
- 启动配置(BOOT 引脚)
- 重映射、向量表偏移
- 应用程序入口
一句话总结你原来的问题:
对!你列的 存储器、代码段、总线、Cache、MMU 就是芯片底层最核心的 5 大块。
再把 内核、时钟、启动、地址映射 补全,就是完整的芯片底层体系。
你现在的状态非常真实——这正是从“应用层调库工程师”向“底层系统开发者”跨越时的必经阶段。
其实,你不是不懂理论,你是卡在了**“软件代码”如何变成“硬件动作”**的那个边界上。
简单直接的回答是:如果你写的是普通的 Linux 应用层软件(App)或者简单的 RTOS 任务,你完全不需要关心;但如果你要做底层 BSP(板级支持包)、写 Linux 驱动、优化系统性能、或者写 Bootloader,你不但要关心,而且必须精通。
我们把你这四个困惑,像剥洋葱一样一层层解开:
1. MMU 是怎么控制的?页表在哪里提供给它?
这是操作系统内核最核心的魔法。你不需要手工拿着电烙铁去连线,你是通过写特定的 CPU 寄存器来控制 MMU 的。
以你熟悉的 i.MX(ARM 架构)运行 Linux 为例,软件和 MMU 的交互逻辑是这样的:
- 第一步:软件在内存(DDR)里建表
Linux 内核启动时,会在真正的物理内存(DDR)里开辟一块连续的空间,往里面填数据。填好的这块数据,就是页表(Page Table)。 - 第二步:把表的地址告诉 MMU(核心动作)
ARM 芯片内部有一个专门的协处理器寄存器,叫 TTBR(Translation Table Base Register,转换表基址寄存器)。
Linux 内核会用一段汇编代码,把刚才建好的页表的物理首地址写进这个 TTBR 寄存器。asm volatile("mcr p15, 0, %0, c2, c0, 0" : : "r" (page_table_physical_address)); - 第三步:软件打开 MMU 开关
内核再往另一个控制寄存器(SCTLR)的第 0 位写1。 - 交互逻辑完成!
从这一刻起,MMU 硬件就被激活了。以后 CPU 只要发出一个虚拟地址,MMU 硬件会自动去读取 TTBR 寄存器里的地址,然后顺藤摸瓜去 DDR 里查那张表。查表的过程完全是纯硬件完成的(叫 Hardware Table Walk),不需要软件插手。
2. 我需要自己指定走指令总线还是数据总线吗?
绝大多数情况下,不需要。是编译器和硬件帮你自动决定的。
- 硬件的自动判断:
当 CPU 的 PC(程序计数器)指针指向某个地址去取指令执行时,硬件总线控制器会自动走指令总线 (IBUS)。
当你的代码执行到int a = *ptr;去读写数据时,硬件会自动走数据总线 (DBUS)。 - 但是,地址是谁定的?(链接器的魔法)
在 ESP32-S3 中,我们之前讲过,同一个 ROM/RAM 有不同的地址段对应不同的总线。你是怎么告诉硬件去哪个地址的?
答案是:链接脚本(Linker Script,比如.ld文件)。
在 ESP-IDF 中,当你给一个函数加上IRAM_ATTR修饰符时:
void IRAM_ATTR my_fast_function() { ... } |
编译器看到这个标签,就会在链接阶段,强行把这个函数的机器码放到以 0x4037_0000(指令总线地址)开头的段里。你不需要手动干预总线,你只需要分配好内存的逻辑段,底层机制就自动闭环了。
3. 我需要灵活安排代码运行模式吗?
如果你只是点个灯、连个 Wi-Fi,跟着官方教程完全没问题。但遇到以下情况,你就必须“灵活安排”了:
- 场景 A:致命的中断(ESP32 常见大坑)
ESP32 的代码默认在外部 Flash 跑(XIP 模式)。如果你正在擦写 Flash(比如保存配置),此时 Flash 是被占用的,Cache 也会被禁用。如果这时候来了一个外部中断,CPU 跑去 Flash 取中断服务函数(ISR)的指令,就会直接内核崩溃(Core Panic)。
解决办法:你必须把中断服务函数和它用到的变量,强行安排到内部 RAM 里运行。这就是打破默认运行模式的典型场景。 - 场景 B:极限性能优化
一段音频解码算法,放在 Flash 里跑,Cache 没命中时会导致音频卡顿。你必须手动把它 Load 到内部高速 RAM 里去跑。
4. Linux 内核与 MMU 的终极交互:缺页异常 (Page Fault)
你说你知道页表怎么映射,但不知道交互逻辑。其实 Linux 内核和 MMU 之间最精彩的交互叫**“先上车,后补票”**。
- 你写了一个 C 程序:
malloc(100 * 1024 * 1024);(申请 100MB 内存)。 - Linux 操作系统是个“渣男”,它只会给你分配 100MB 的虚拟地址,但根本不在 MMU 页表里填真正的物理地址。
- 你的程序开始运行,往第一个字节写数据:
ptr[0] = 1;。 - MMU 硬件去查表,发现:“靠,这个虚拟地址没有对应的物理地址(或者权限不对)!”
- 交互发生:MMU 硬件立刻打断 CPU,触发一个缺页异常中断(Page Fault)。
- CPU 自动跳转到 Linux 内核的异常处理函数。内核这个时候才去物理 DDR 里找一块空闲的内存,把真正的物理地址填进 MMU 的页表里。
- 填完后,内核让 CPU 重新执行
ptr[0] = 1;这条指令。这一次,MMU 查表成功,数据顺利写入。
这一切发生得极快,你的应用层软件根本感觉不到,还以为自己真的独占了连续的 100MB 大内存。
总结:你的成长路径
你现在的困惑,是因为你站在了驱动开发与系统架构的门口。
- 以前的你:调用
malloc和printf,不关心数据放哪,反正能跑。 - 现在的你:开始知道底层有总线、有 Cache、有 MMU,但不知道怎么用。
- 下一步的你:去看看开发板里的
.ld(链接脚本) 文件,或者去看看 Linux 源码里的head.S(汇编启动代码)。那里就是软件第一次与总线、MMU 发生物理交互的“案发现场”。
你想先看懂 ESP32-S3 里面那个决定代码是放在 Flash 还是 RAM 里的“链接脚本(Linker Script)”长什么样吗?它能把你对内存地址的理论直接变成实际工程代码。