infra Nsight Compute学习笔记
这篇主要用来记录Nsight Compute的学习
测试背景
我主要使用的是矩阵乘法这个cuda kernel的不同优化版本来进行测试
__global__ void mysgemm_v1(int M,//A(M x K) B(K x N) C(M x N) |
不同版本kernel核函数对比如下:
- v1 朴素实现
- 每个thread,负责C的一个元素
- v2 共享内存优化
- 一个block,负责一个C_sub(搬运A_sub, B_sub 到 该block的shared_mem)
- 一个thread负责C_sub里面的一个元素
- 共享内存保存A_tile, B_tile
- 寄存器保存每个A_tile,B_tile的计算结果
- v3 thread_tile优化
- 基于v2
- 一个thread负责C_sub里多个元素 = C_tile
- 共享内存保存A_tile, B_tile
- 寄存器保存每个A_tile,B_tile的计算结果
- v4 向量预取指令
- 基于v3
- 写共享内存As直接写转置,读共享内存时,优化读取的效率
- v5 双缓冲+指令流水线重叠优化
- v6 warp tiling优化
benchmard的测试条件为:
- M=2048
- K=2048
- N=2048
测试结果为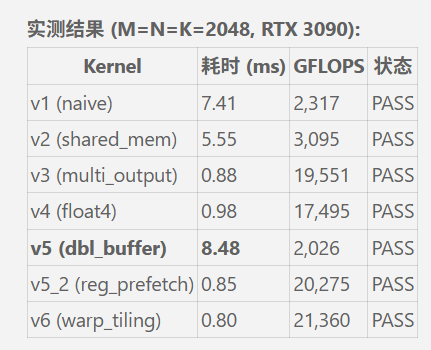
Nsight compute报告分析(以v1朴素实现的分析结果为例)
基本概念
吞吐量:单位时间内统计数量:
计算吞吐量 compute throughput: 单位时间内完成多少次计算
SM 所有运算单元(FMA/ALU/FP64/Tensor 等)完成的运算操作总次数
内存吞吐量 memory throughput: 单位时间传输的数据字节总量
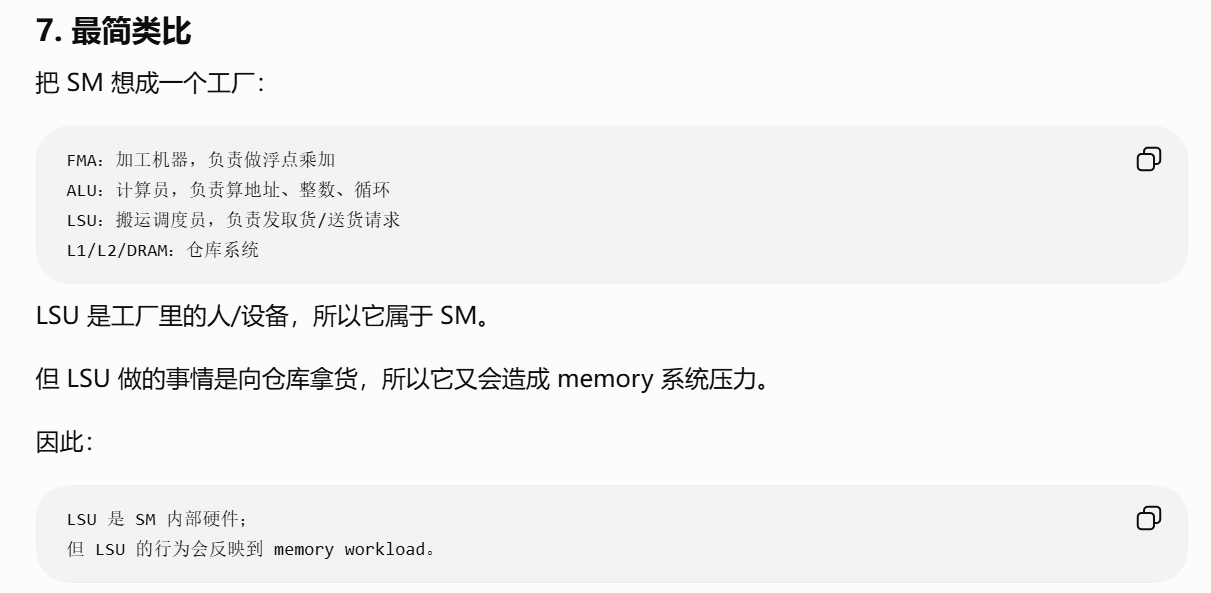
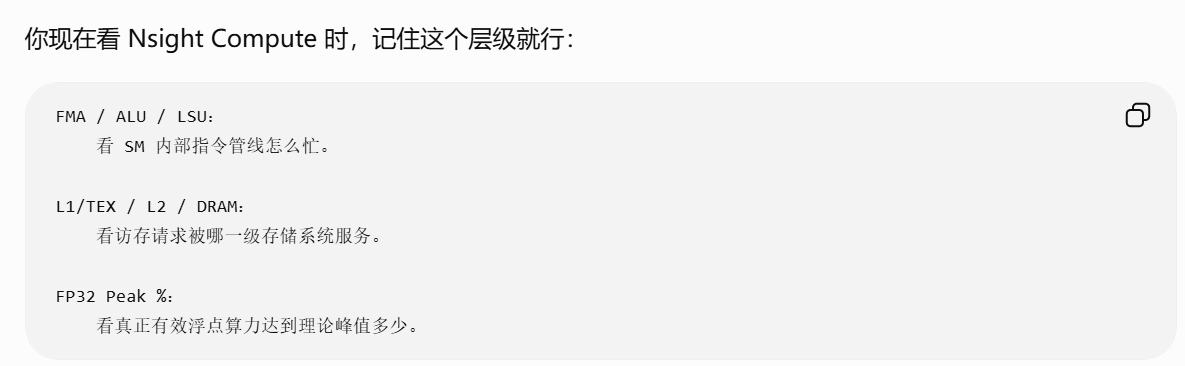
关于各种计算硬件单元,GPU里面有很多负责计算单元:
- LSU 加载 / 存储访存单元
- FMA 浮点数乘加单元
- ALU 整数运算单元
每个硬件单元,都有自己独立的指令流水线,每条流水线只处理对应类型指令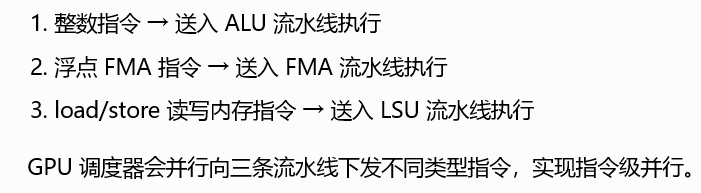
GPU Speed Of Light Throughput
GPU 理论峰值吞吐量分析面板
本面板整体展示 GPU 计算单元与显存资源的吞吐量概况。
每项硬件单元指标会输出当前实际吞吐量相对理论峰值的利用率百分比
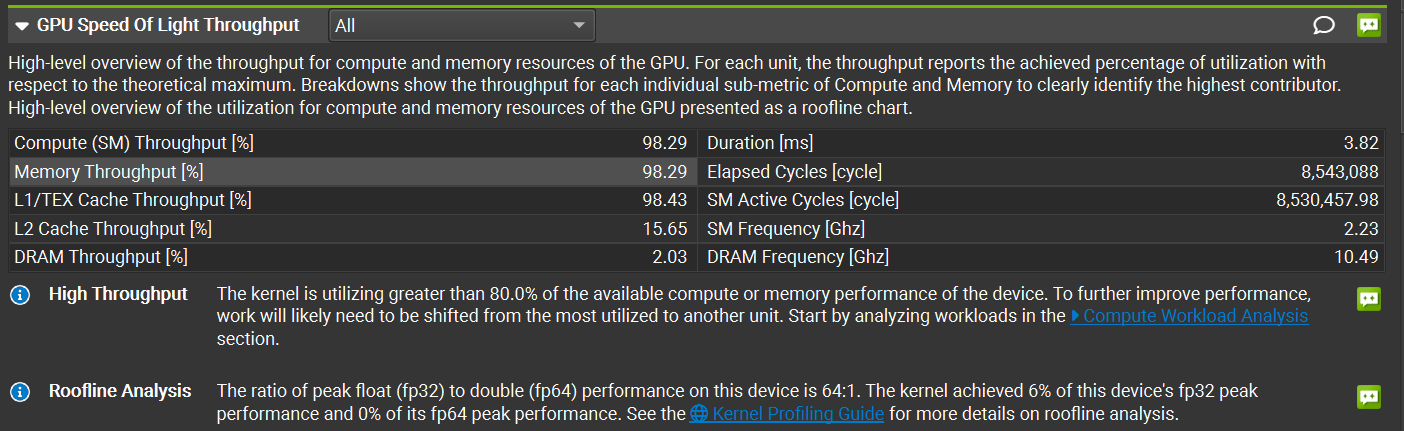
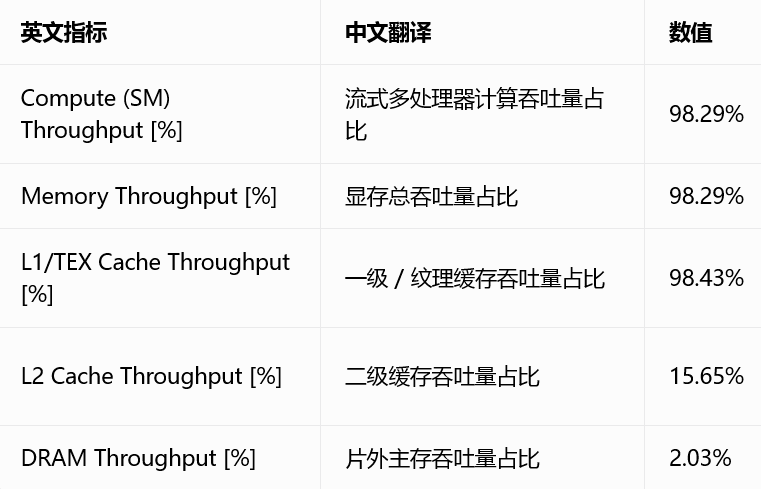
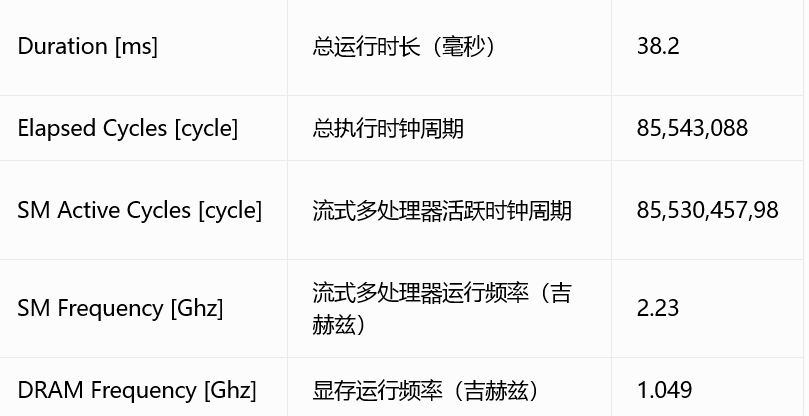
可以看到SM的计算单元指令吞吐量占满了,
显存访问吞吐量也占满了,其中主要是一级缓存在疯狂使用。
计算吞吐量只统计 FMA/ALU 等运算操作,和 LSU 访存无关
这里 98.29% 代表:只要 SM 处于活跃、没有阻塞等待的周期里,运算单元几乎跑满了理论算力上限。
 1. 高吞吐量提示(High Throughput)
当前内核程序占用设备 80% 以上的计算或显存峰值性能 (计算能力压榨的好像还不错)。若需进一步提升性能,建议将计算负载从当前高占用硬件单元迁移至其他模块。
可先前往「计算负载分析」板块分析程序负载特征。
 2. 屋顶线分析提示(Roofline Analysis)
本 GPU 设备单精度浮点(FP32)与双精度浮点(FP64)理论峰值性能比值为 64:1。
当前内核程序仅达到设备单精度峰值性能的 6%,双精度峰值性能利用率为 0%。
说明计算能力仅到达峰值的6%, 差的很多
Compute Workload Analysis
计算负载分析
本模块对流式多处理器(SM)的计算资源进行精细化分析,包含实际每周期执行指令数(IPC)与各类流水线的硬件利用率。流水线利用率过高时,会成为整体性能瓶颈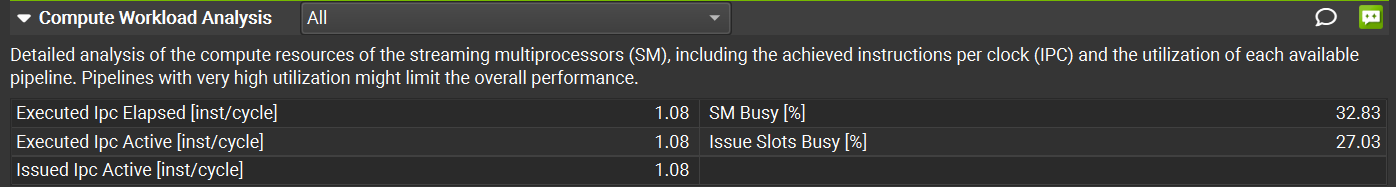
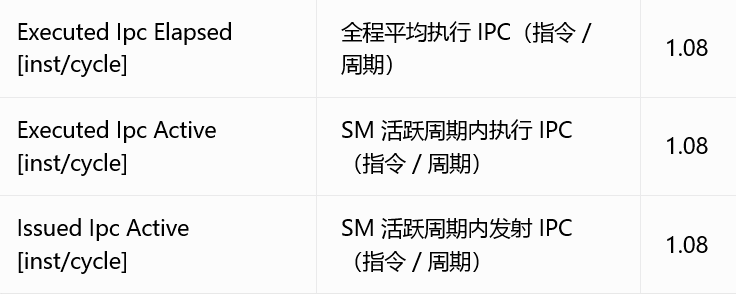
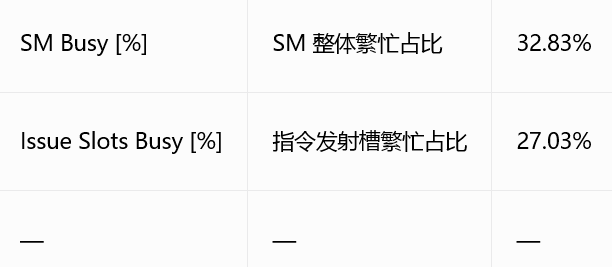
 ⚠️ 硬件利用率偏低
所有计算流水线均未充分利用。出现该现象有两种可能性:当前 GPU 内核计算量过小;或是调度器未生成足够多的线程束(warp)。
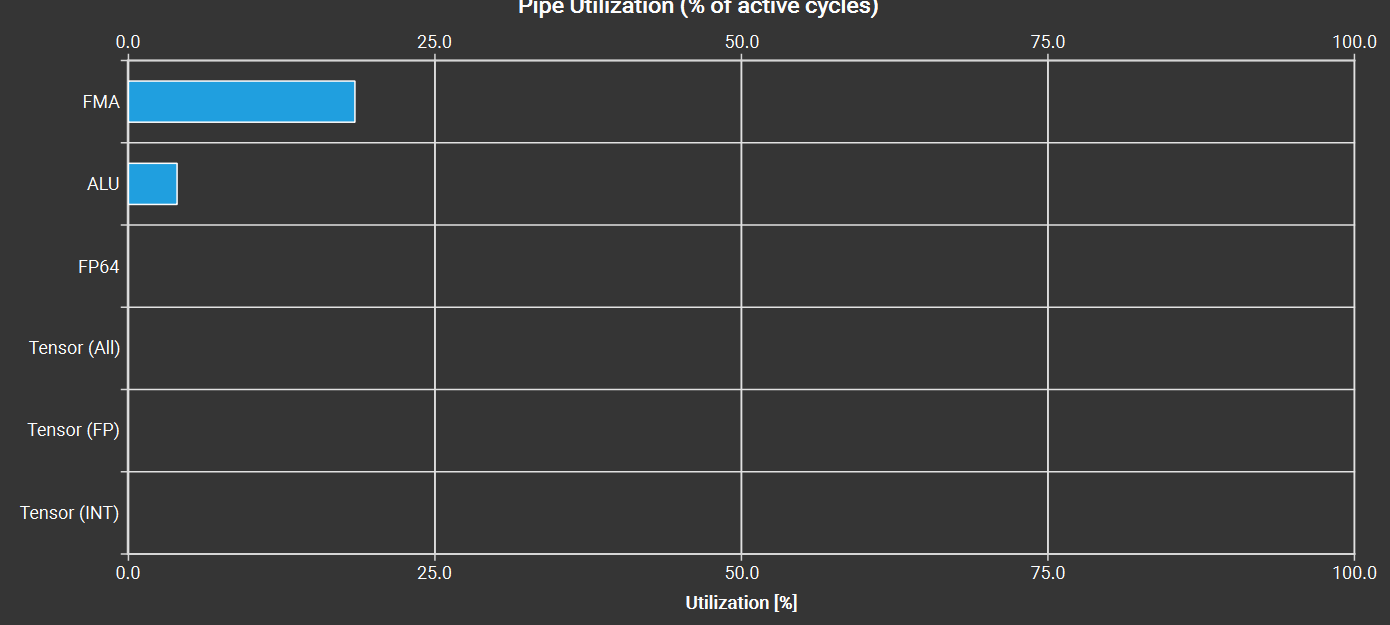
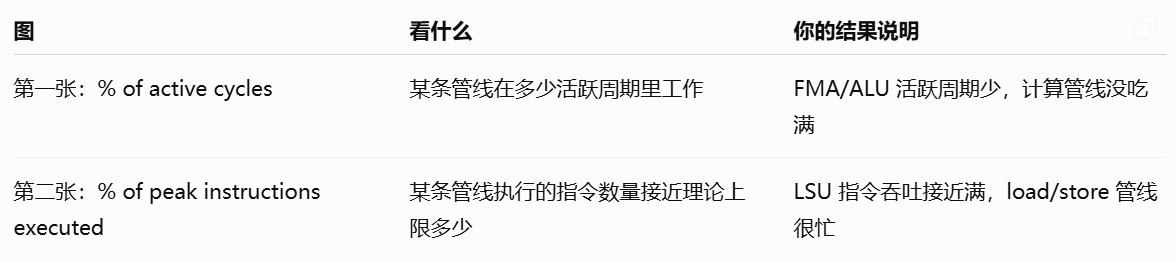
流水线利用率(占 SM 活跃周期百分比)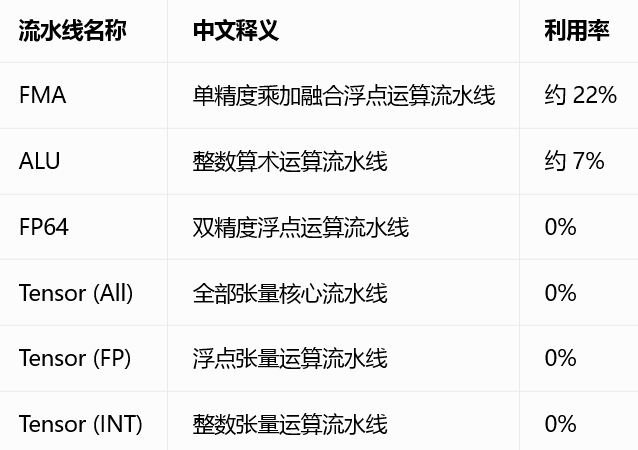
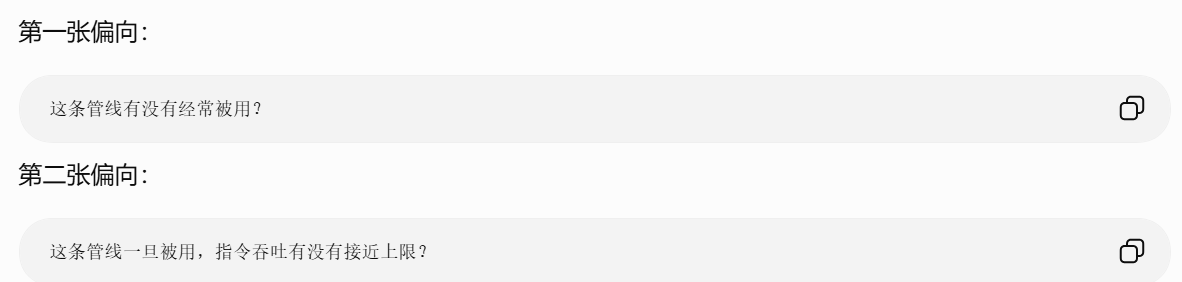
这个是反应的计算指令的类别占比,可以看出我们程序主要是进行什么计算,这里可以看出,主要是FMA计算。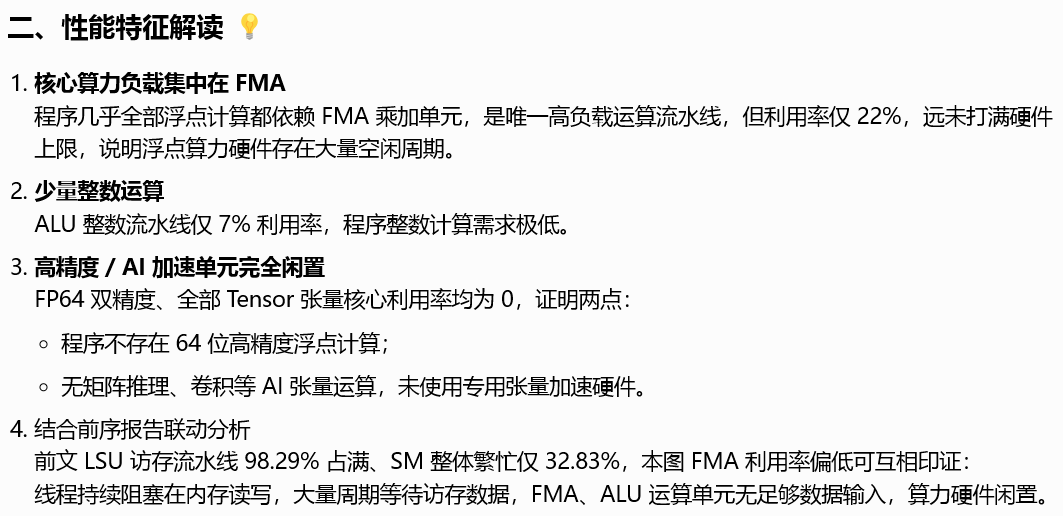
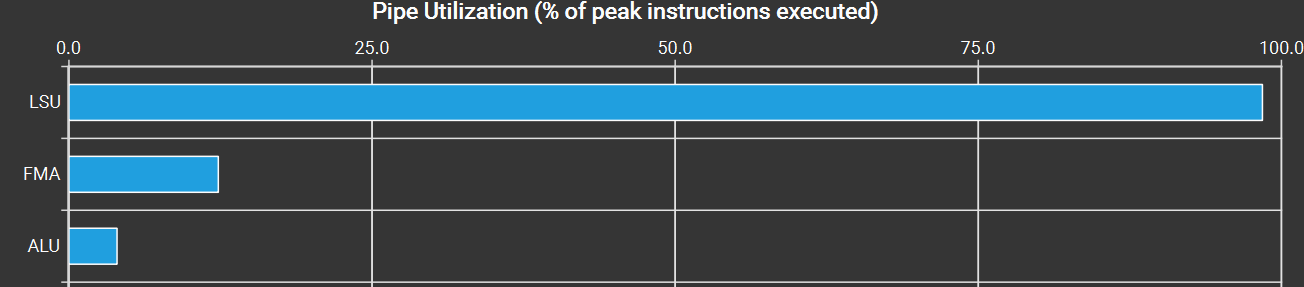
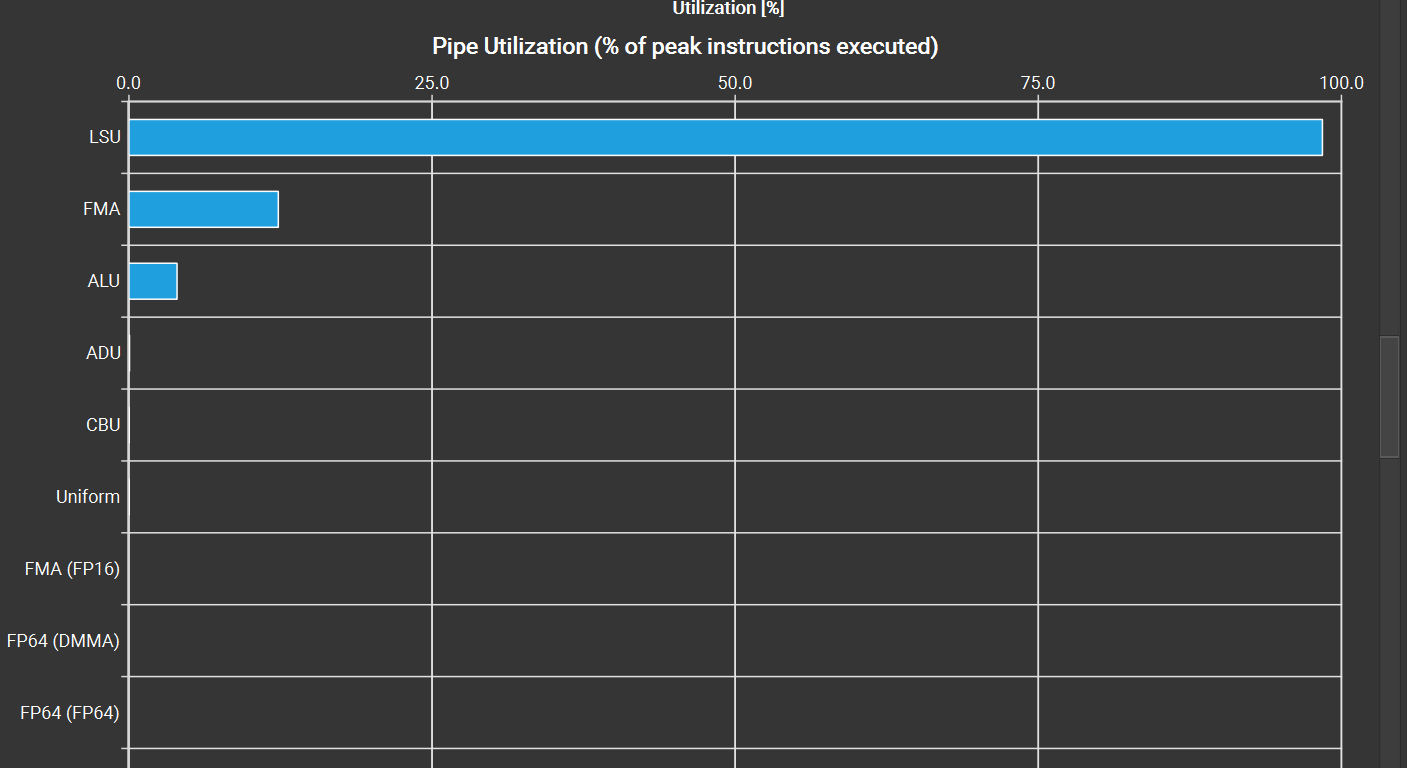 流水线利用率(占硬件峰值可执行指令总量百分比)
这个主要反应的是,一段绝对时间内,SM主要在进行什么指令,这里可以看出,大部分实际都是LSU,也就是访存
所有线程执行流程都被内存读写指令阻塞,硬件绝大多数周期用于加载、存储数据,没有空余周期执行浮点 / 整数计算。
所以,总结下来:V1 的 matmul的朴素实现,是一个
访存密集型:海量全局内存读写操作;
仅基础单精度浮点 + 少量整数运算,无高精度、AI 张量、纹理采样、复杂分支逻辑;
总结
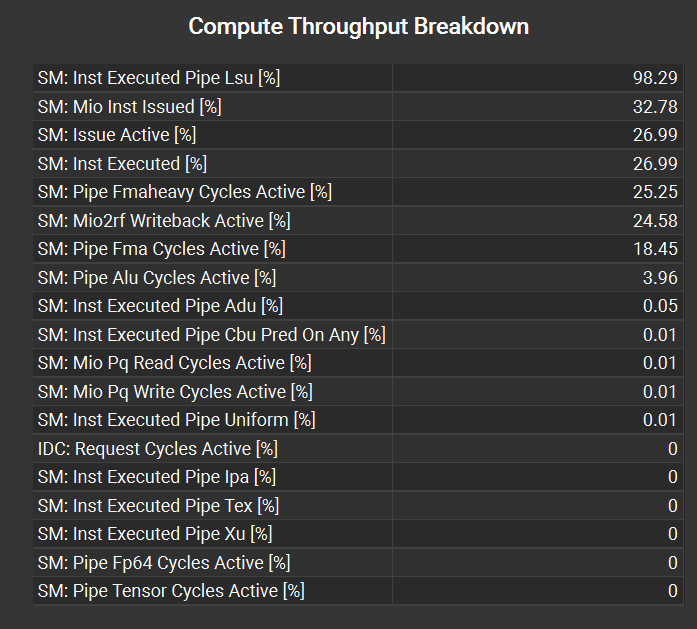
计算吞吐量 是看100个时间点里面,最忙的子管道(指令)工作了多少时间
这里 98.29% 代表:只要 SM 处于活跃、没有阻塞等待的周期里,运算单元几乎跑满了理论算力上限。我们可以查看breakdown细则,发现,最忙的是LSU指令。
结合前面流水线图表:活跃周期内 FMA 流水线占比 22%、ALU 占 7%,在仅有的少量能干活的时间里,算力硬件被充分利用。这里的占比,是指的FMA在他的所有时间内,只工作了22个时间
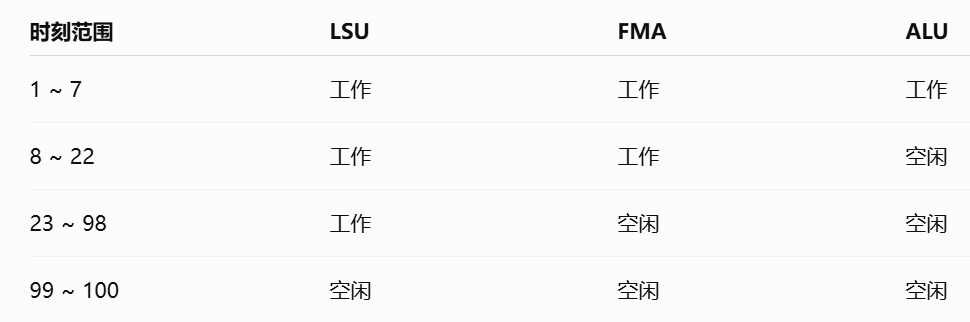
所以现在看这个SM的峰值利用率,可以看到在SM的活跃时期100个时间,LSU一直都在跑,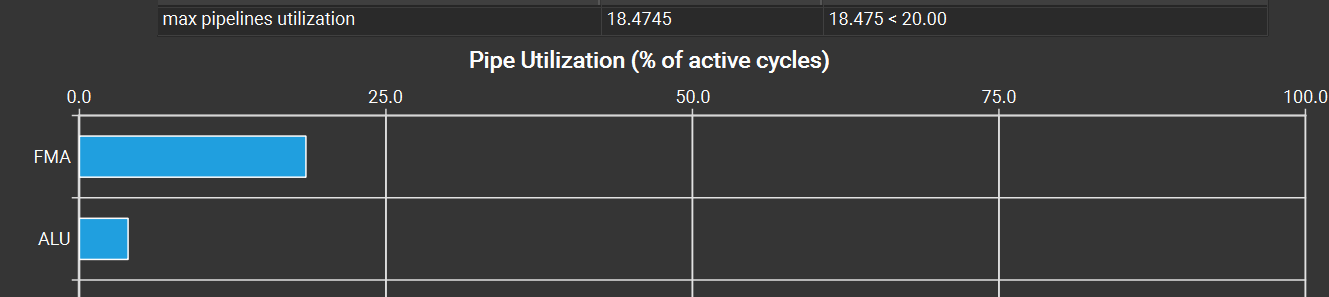
Memory Workload Analysis
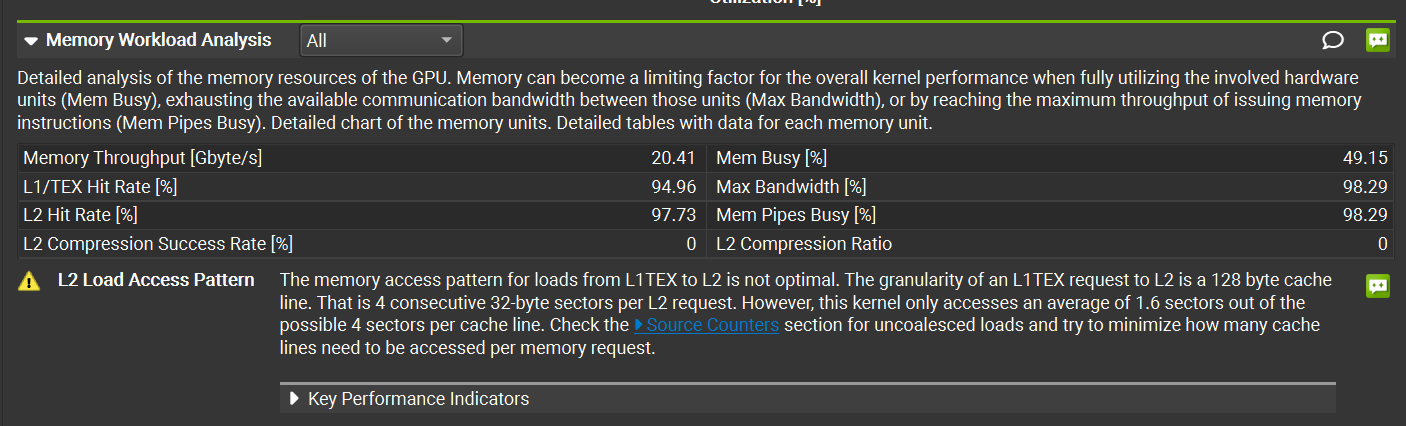
这里就是分析GPU的显存资源,
- 内存吞吐量 20.41 Gb/s 低
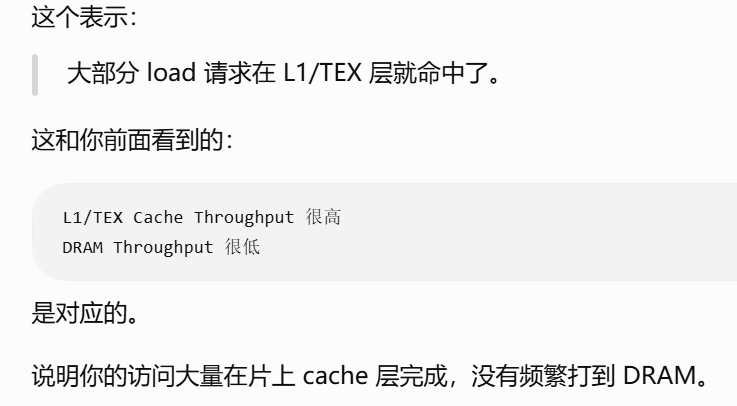
- L1缓存命中率 94.96% 高
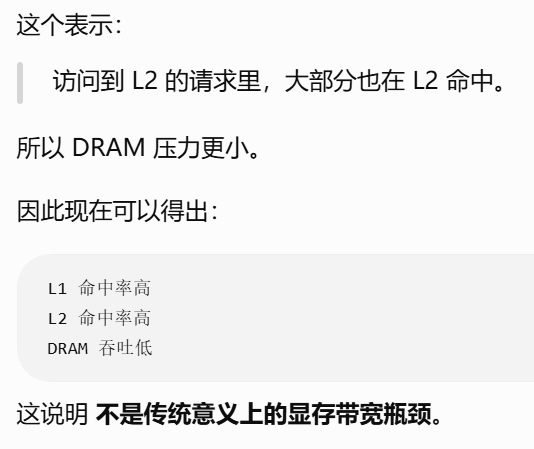
- L2缓存命中率 97.73% 高
- L2压缩成功率 0%
- 内存繁忙率 49% 整体 memory 系统忙碌程度
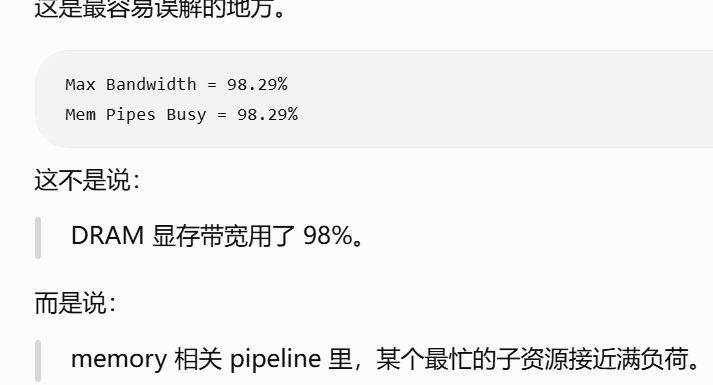
- 最大带宽占满率 98.29% 极个别管线最忙 最忙 memory 子资源的带宽利用程度
- 内存管道繁忙率 98.29% memory 指令管线忙碌程度
L2压缩率 0%
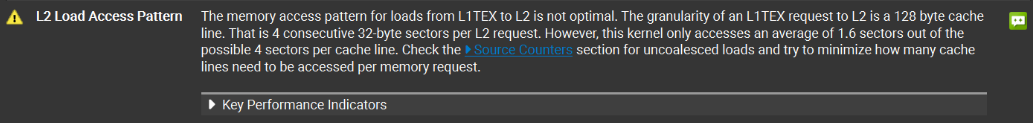
黄色警告提示:L2 Load Access Pattern
从 L1 纹理缓存向 L2 缓存发起的读取访存模式未达到最优。
L1 纹理缓存向 L2 发起一次请求的最小粒度为一条 128 字节缓存行,一条缓存行包含 4 段连续 32 字节扇区。
但当前内核每次读取缓存行时,平均仅访问 4 个扇区中的 1.6 个,存在大量无效缓存行加载开销。
前往「源码计数器」板块查看未合并离散读取相关指标,优化思路:尽可能减少单次内存请求需要加载的缓存行数量。
接下来是分析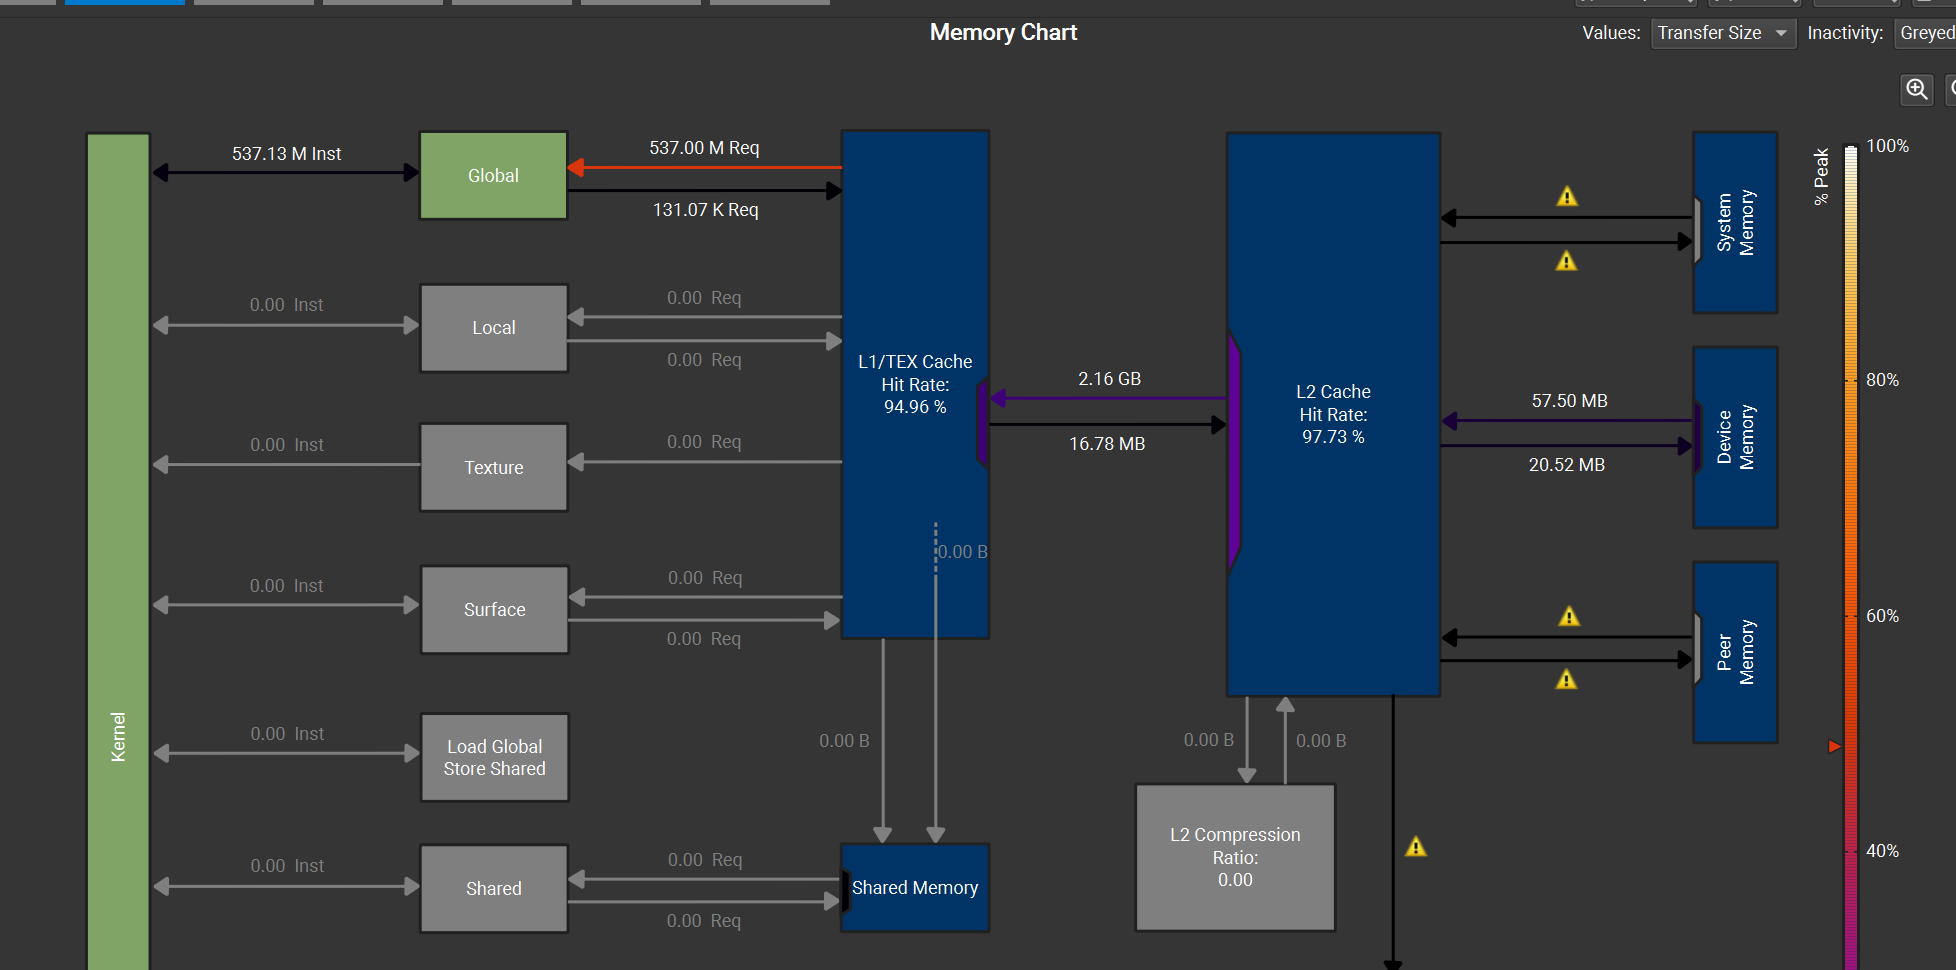
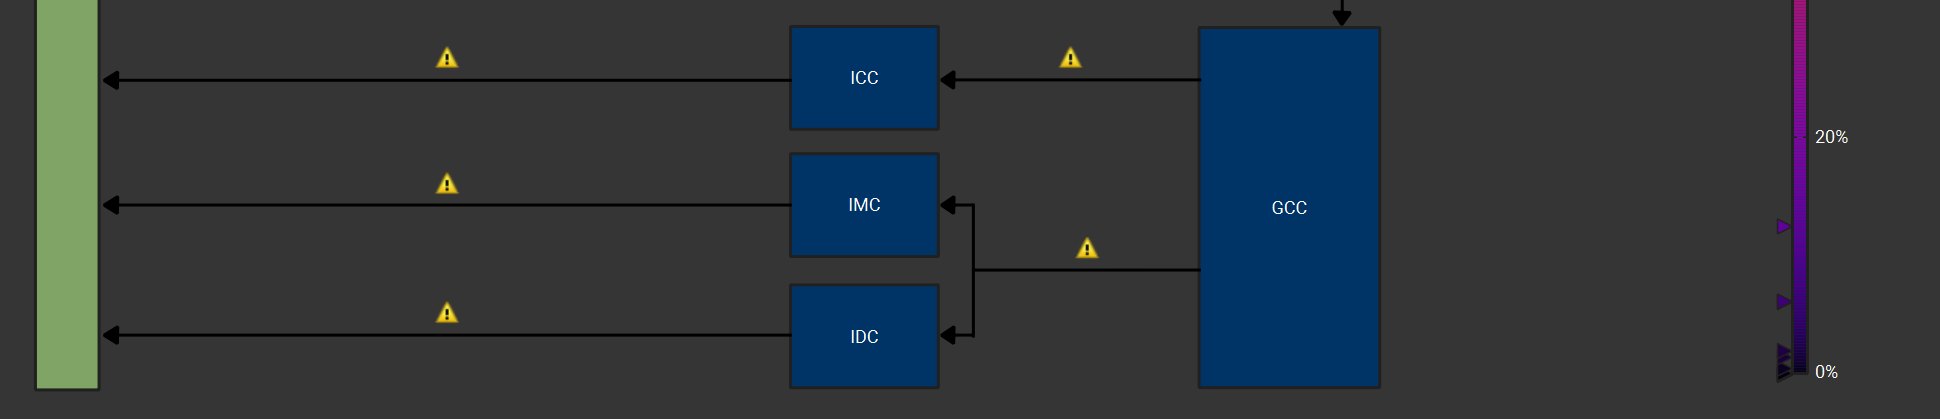
这个 Memory Chart 是把刚才表格里的 memory workload 画成一张“数据流图”
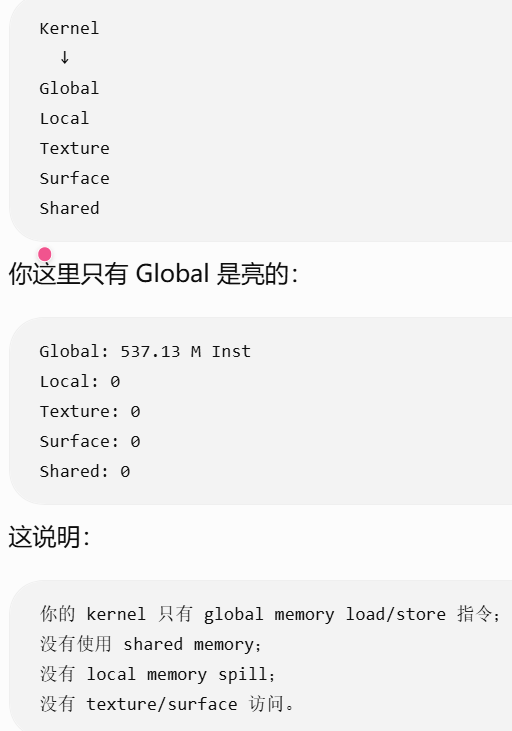
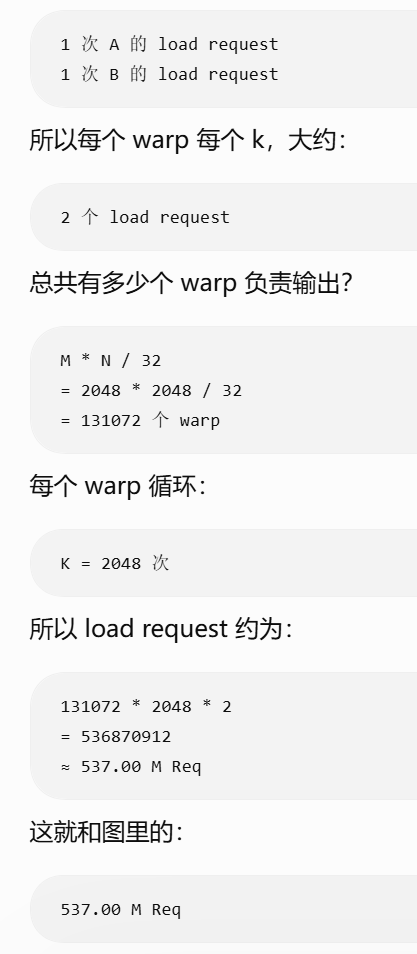
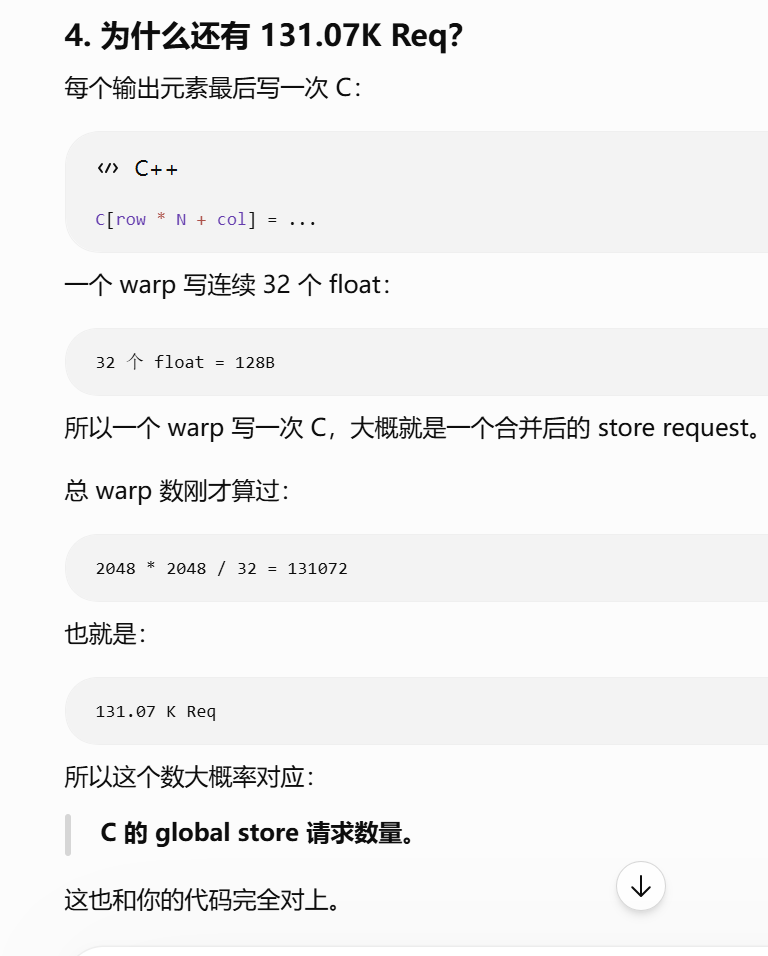
你的 v1 naive SGEMM 几乎只使用 global memory 路径,
没有 shared memory;大量 global load/store 请求进入 L1/TEX,L1/L2 命中率很高,真正到 DRAM 的数据不多,但 global→L1TEX 以及 L1TEX→L2 的请求模式存在 warning。
总结
所以,根据以上分析,可以看出几个问题
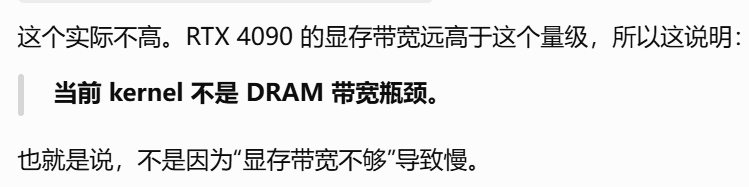
- 显存带宽低,说明显存带宽不是瓶颈
- L2->L1的访存请求粒度利用不充分
- 每次访存请求没有充分利用完整 cache line,访问的L2的cache line的利用率不够。
scheduler statistics
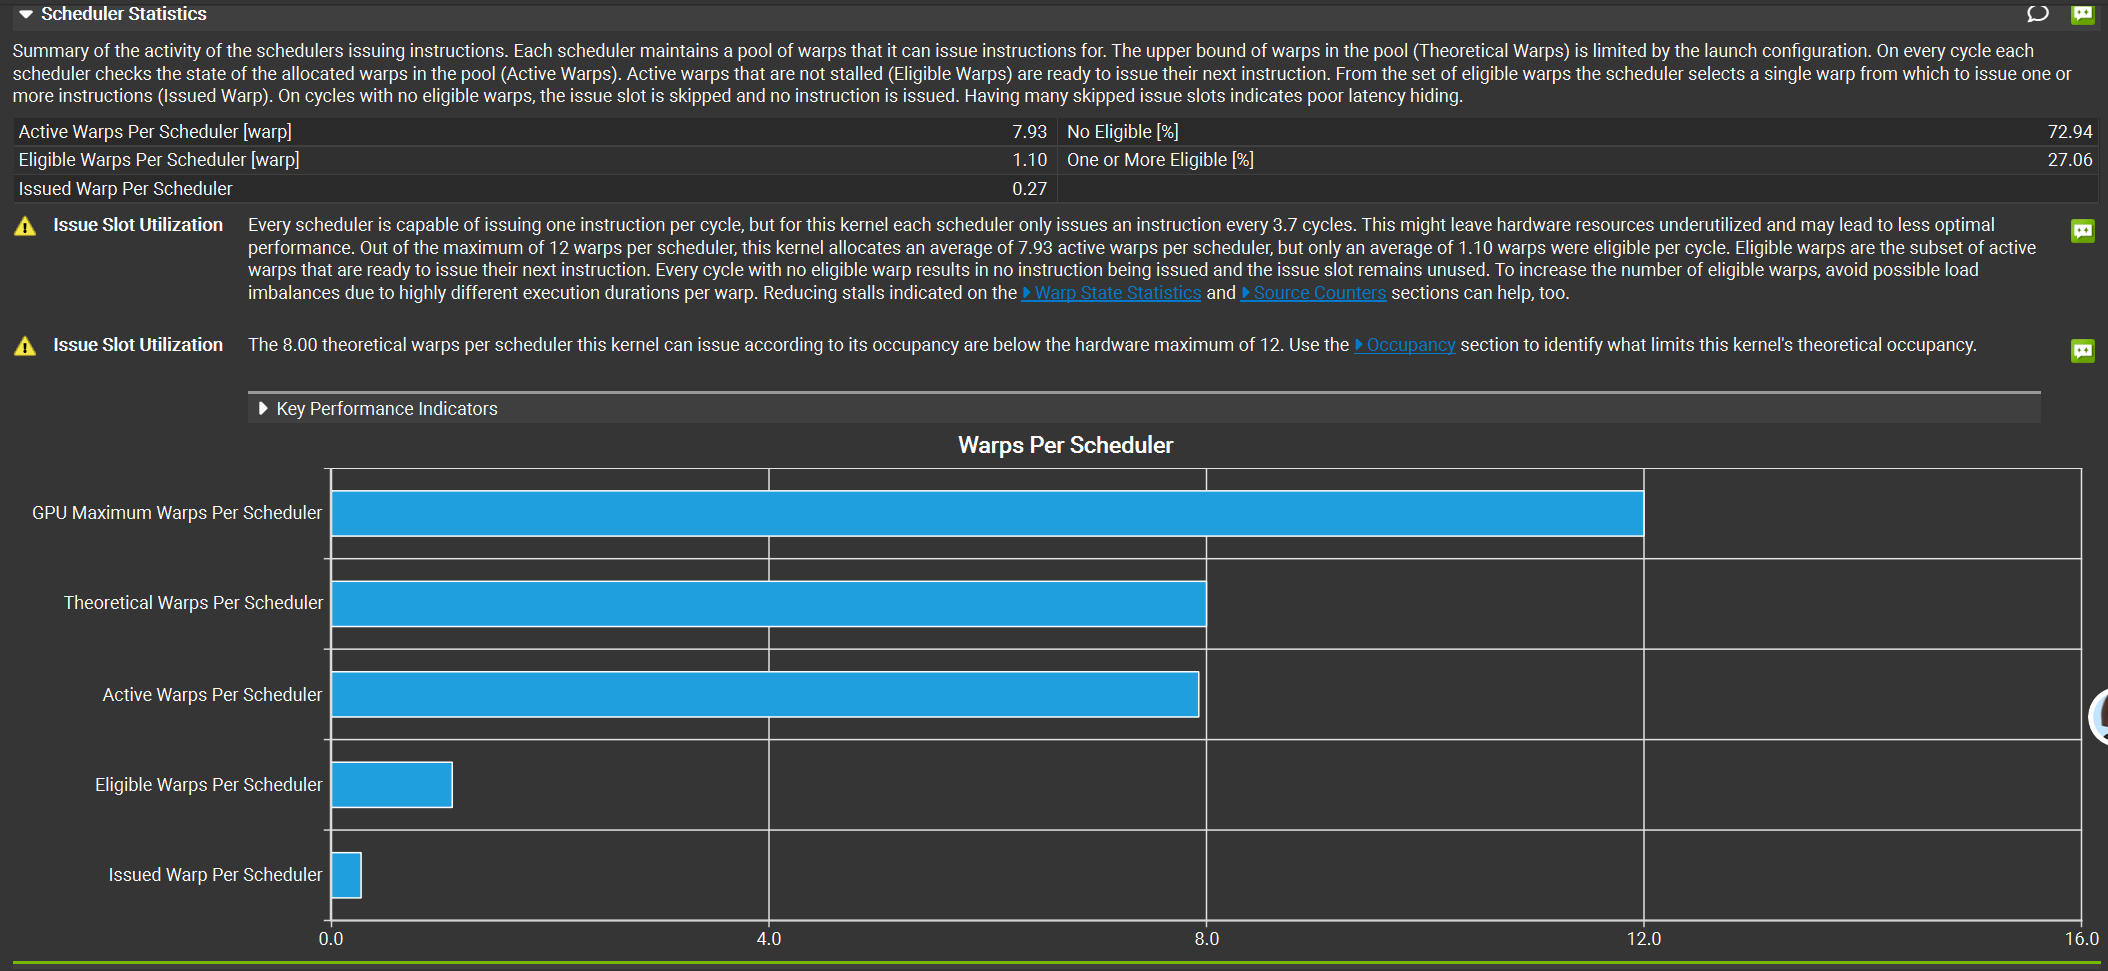
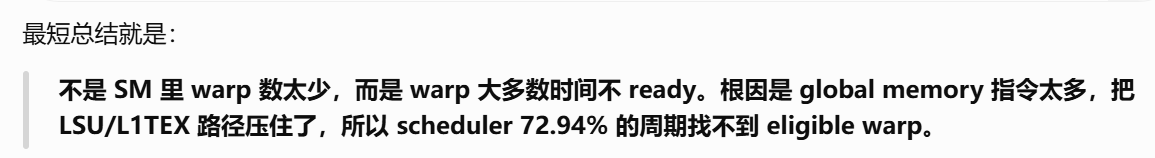
warp 调度器有没有足够多的 warp 可以发射指令。
SM 里的 warp scheduler 每个周期有没有活干?能不能连续发指令?
GPU Maximum Warps Per Scheduler = 12 //硬件上限,每个 warp scheduler 理论最多能管理 12 个 warp。 |
Warp state statistics
warp 在两个连续指令之间,到底把时间花在了哪里
前面的 Scheduler Statistics 告诉你:“调度器经常发不出指令”。
这个 Warp State Statistics 进一步告诉你:“为什么 warp 发不出指令”
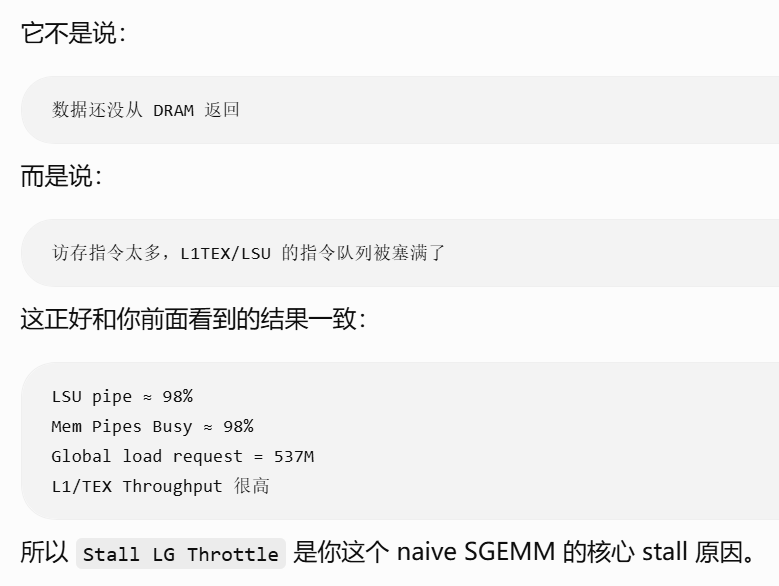
Warp Cycles Per Issued Instruction = 29.31 //平均每个 warp 发出一条指令,要隔大约 29.31 个 cycle。 |

每个 warp 平均有 20 个周期卡住,是因为 local/global memory 指令要进入 L1TEX/LSU 相关队列,但是这个队列满了,新的访存指令发不进去。
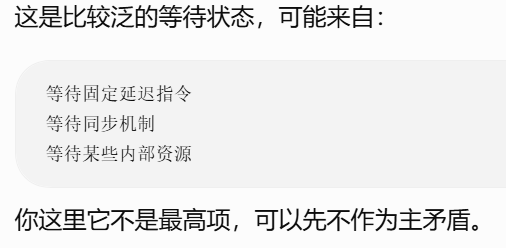
warp的其他几个项:
- Stall Not Selected
- 这个 warp 已经 ready 了,但是调度器这一拍没有选它。
- Stall Wait
- Stall Long Scoreboard
- warp 在等一个较长延迟的数据依赖,常见是 global memory / L2 / DRAM load 的返回。
- Stall Dispatch Stall
- 这个和指令分发/执行资源有关,表示 warp 虽然有指令,但由于 dispatch 相关限制没能顺利发出去
- Selected
- warp 被 scheduler 选中并成功发出指令的周期。
Launch Statistics
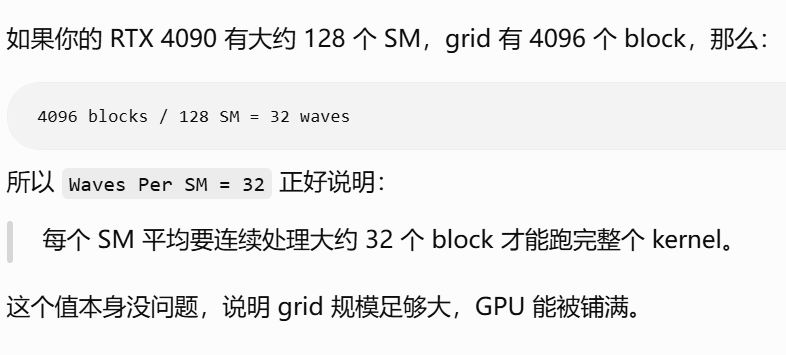
kernel 是怎么启动的,以及这个启动配置会消耗多少 GPU 资源。
Grid Size = 4096 |
如果扑不满会怎么样,我在编写kernel的时候,怎么会知道GPU的SM数量,每个SM的寄存器大小呢?
写 kernel 时怎么知道 SM 数量?
最标准方法是用 CUDA Runtime API 查询。
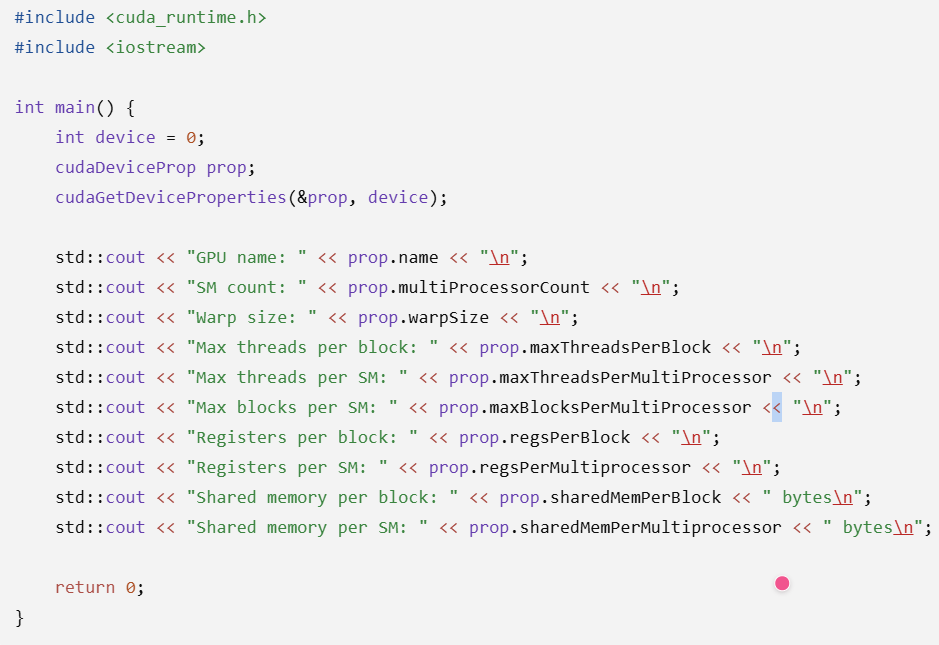
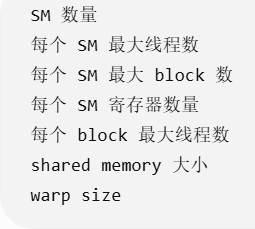
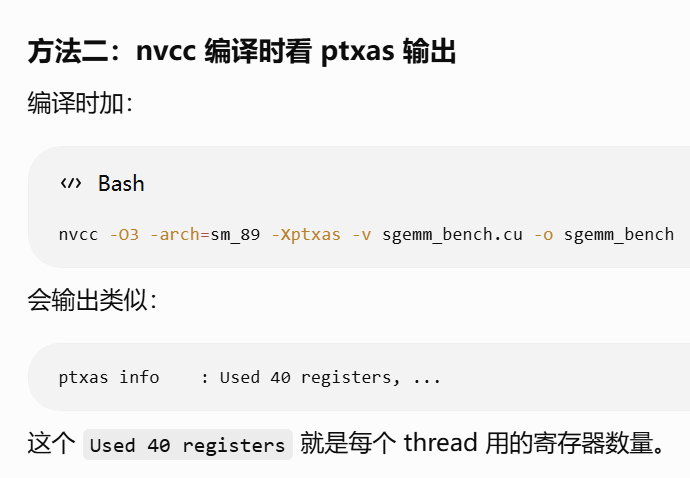
怎么知道自己的 kernel 每个线程用了多少寄存器
- Nsight Compute

怎么知道一个 SM 能同时放几个 block?
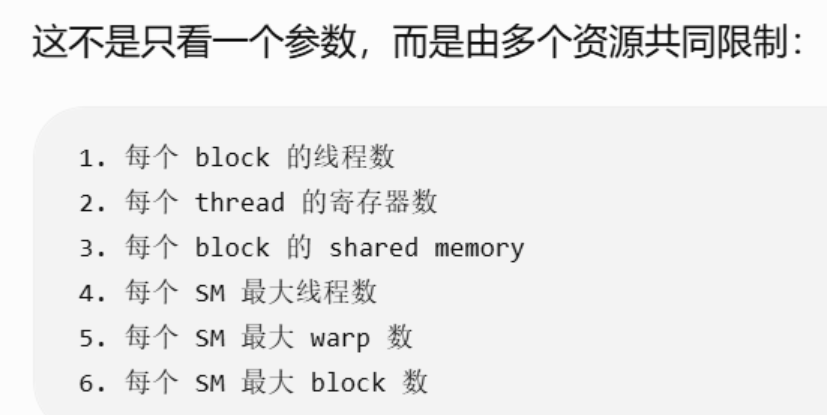
这个函数会帮你根据 kernel 的寄存器、shared memory、block size 自动算出理论 occupancy。
实战中写kernel的流程
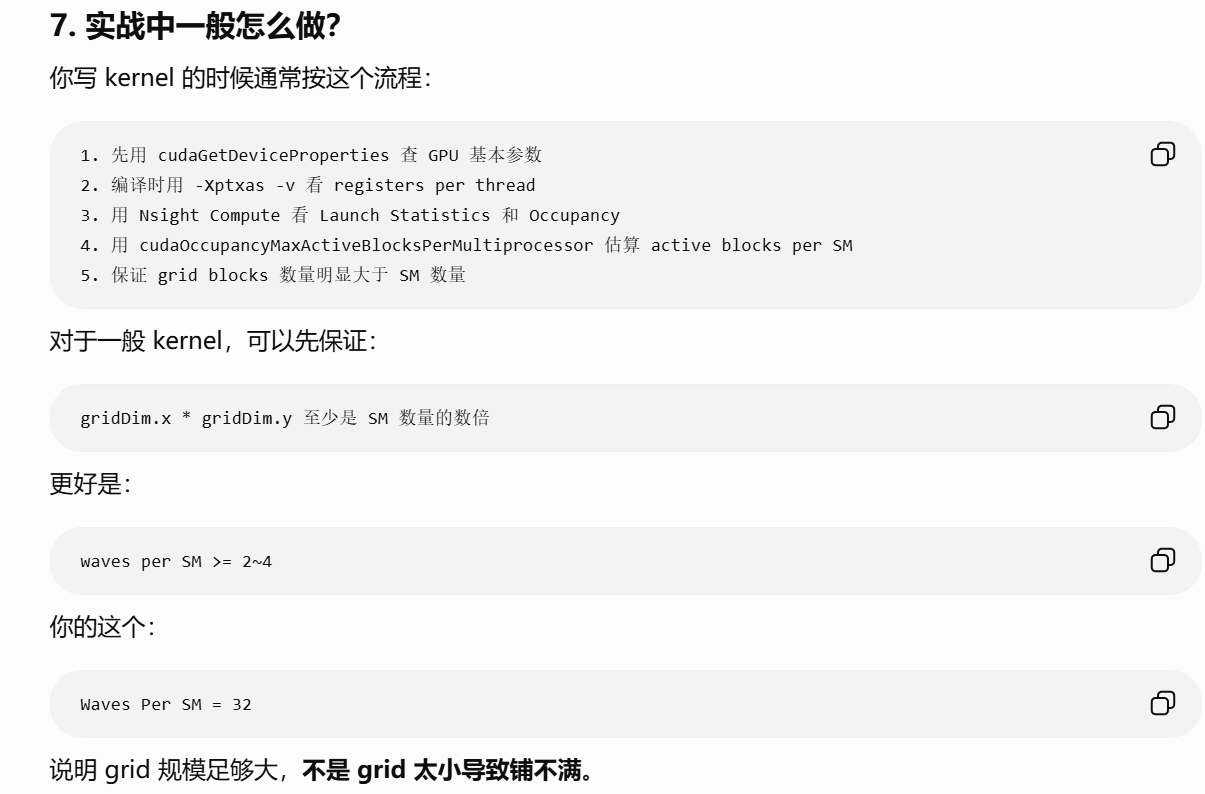
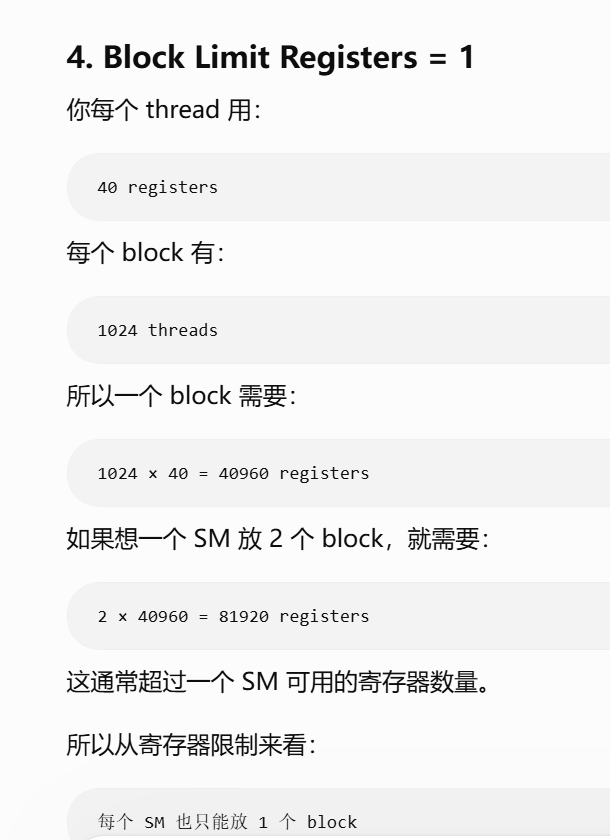
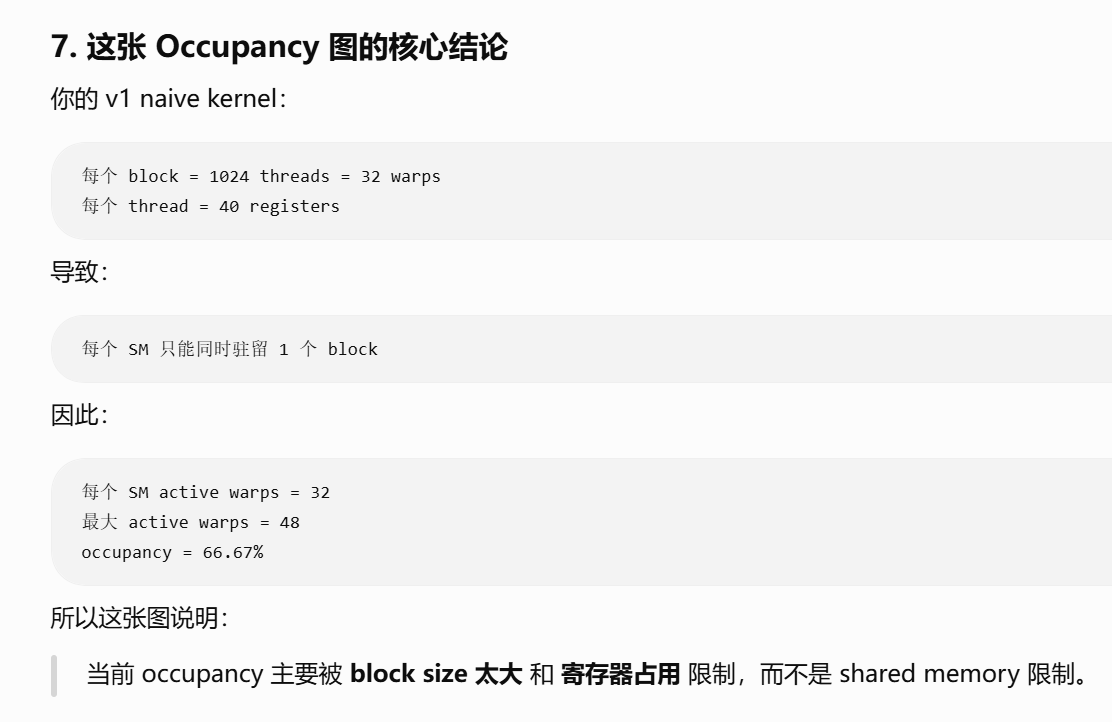
Occupancy
一个 SM 上到底同时驻留了多少 warp,占硬件最大可驻留 warp 数的比例
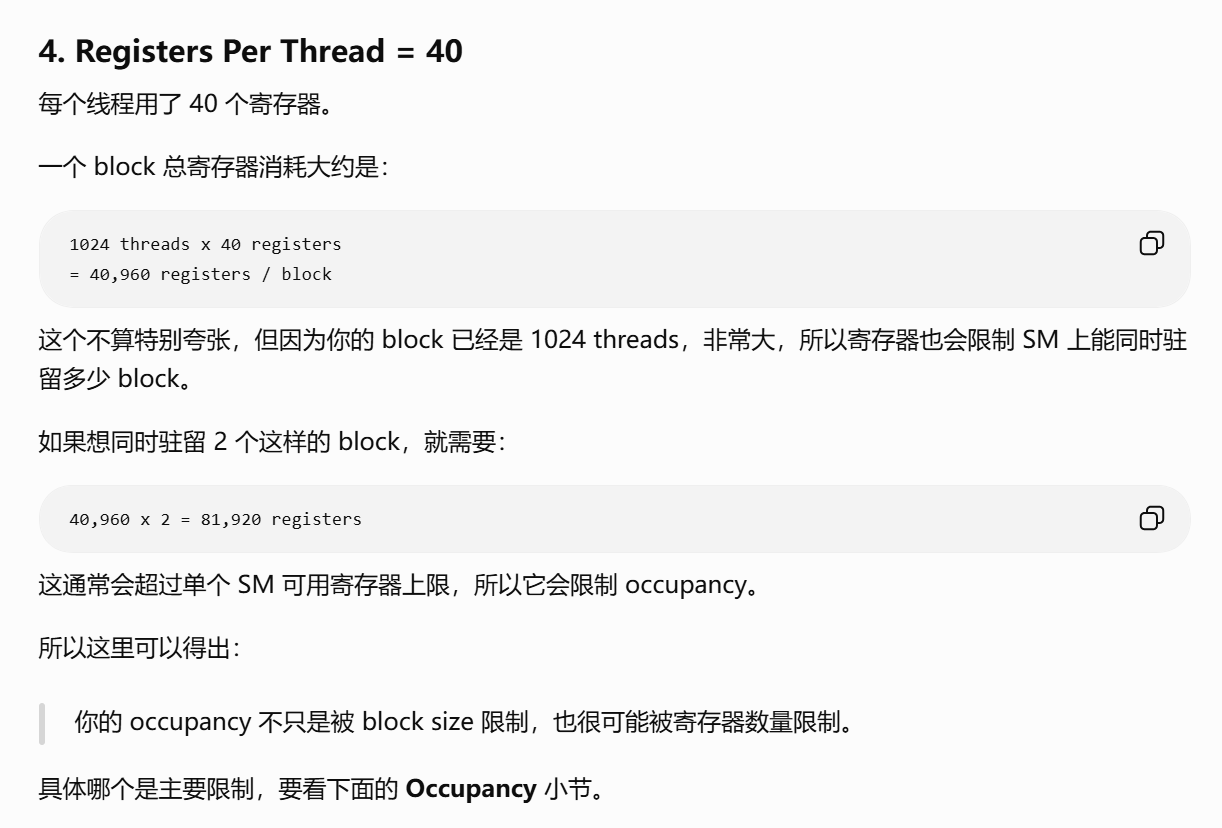
|
总结
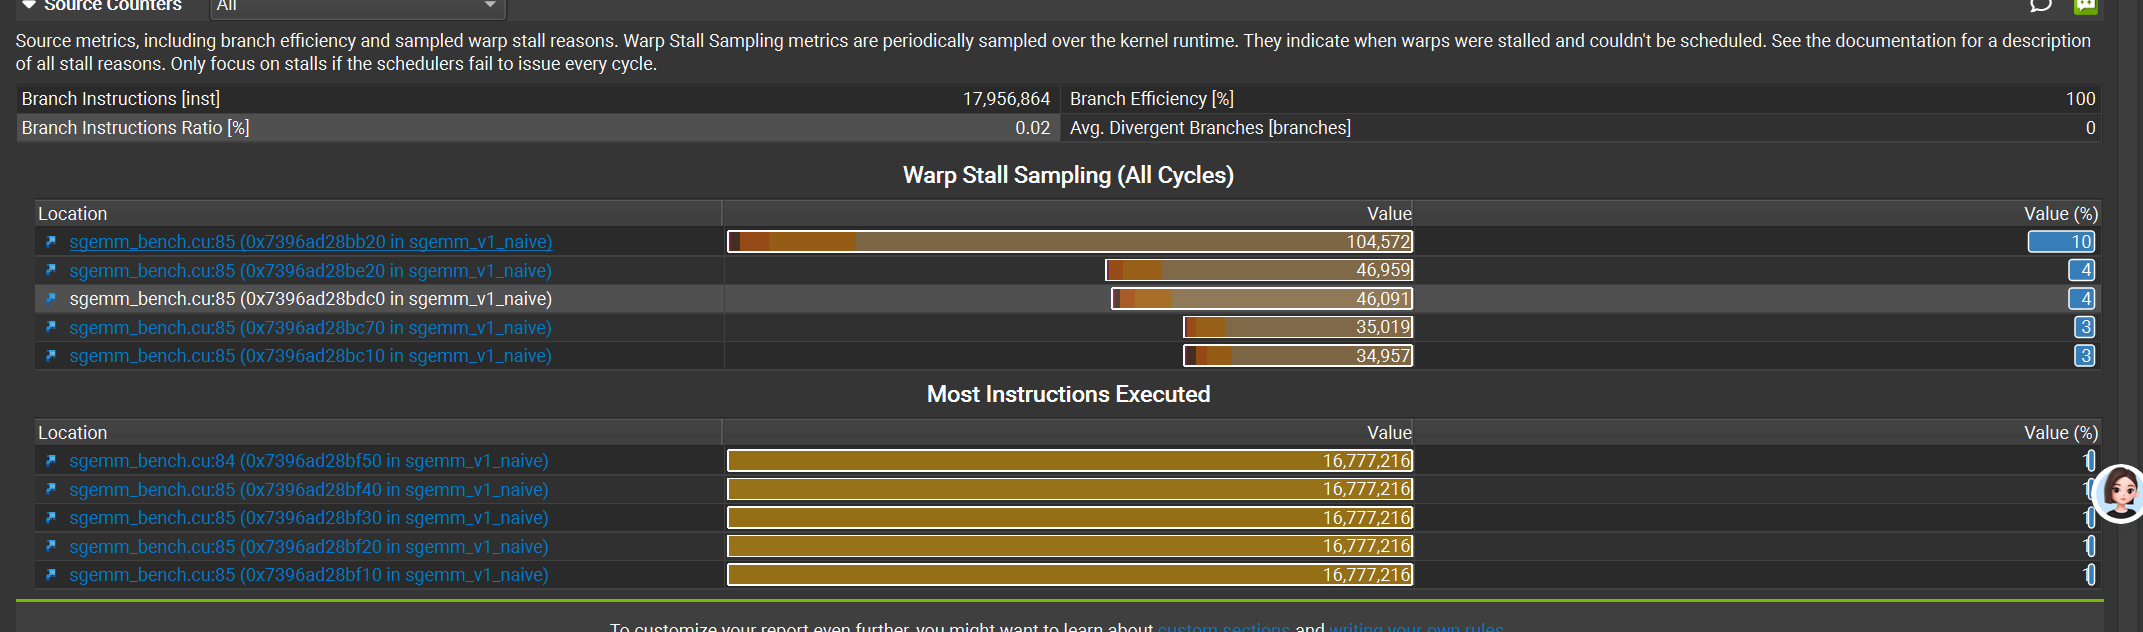
Source Counters
把前面看到的 stall、分支、指令数量 对应回源码行。
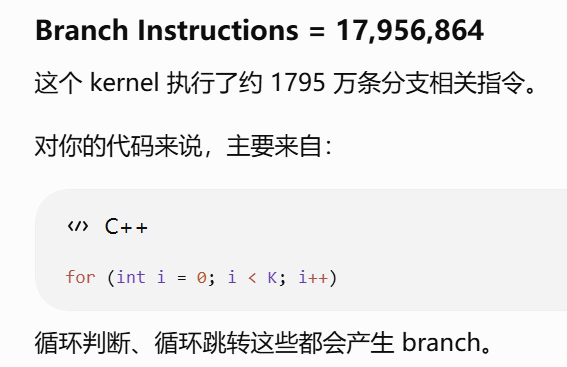
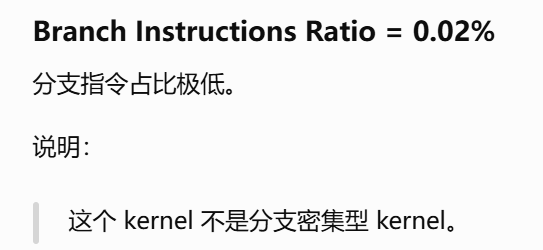
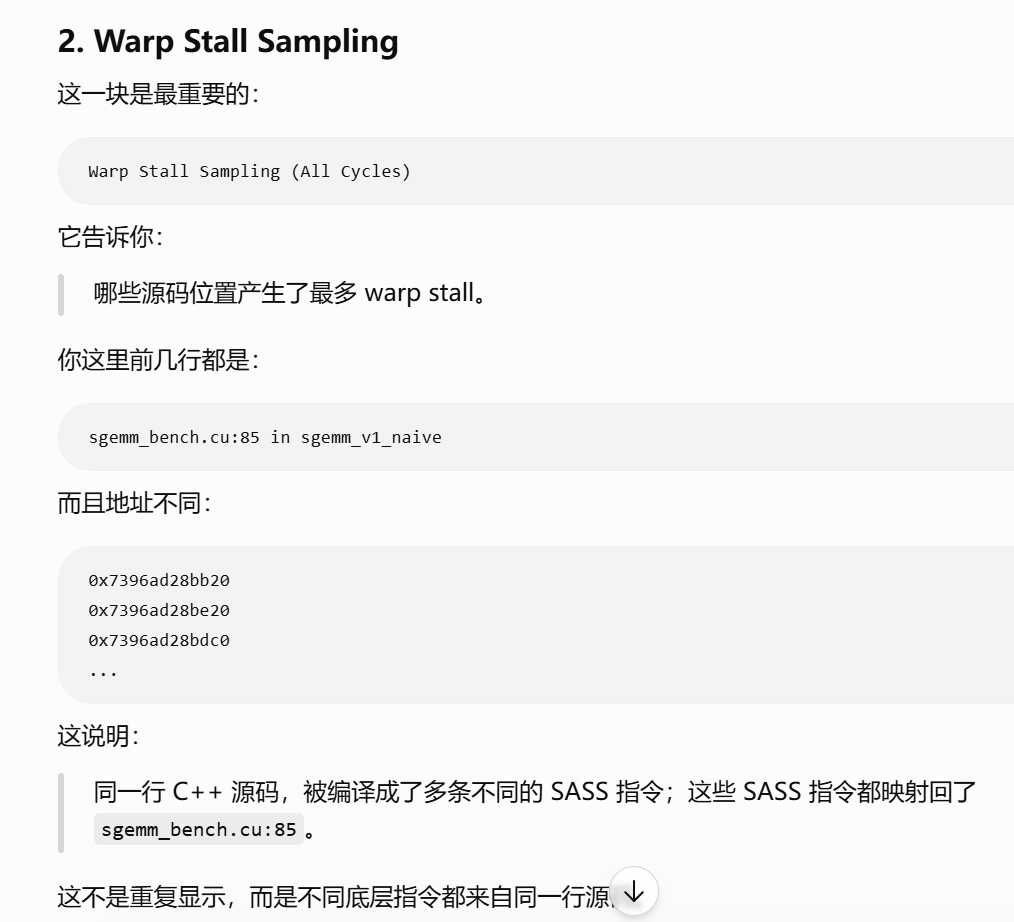
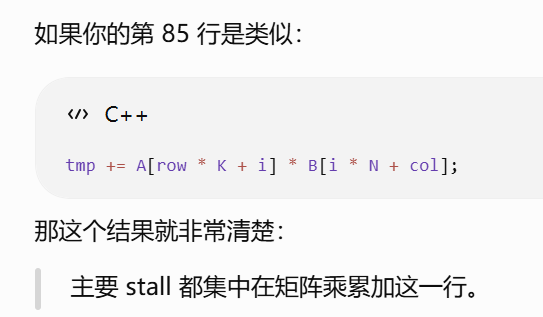
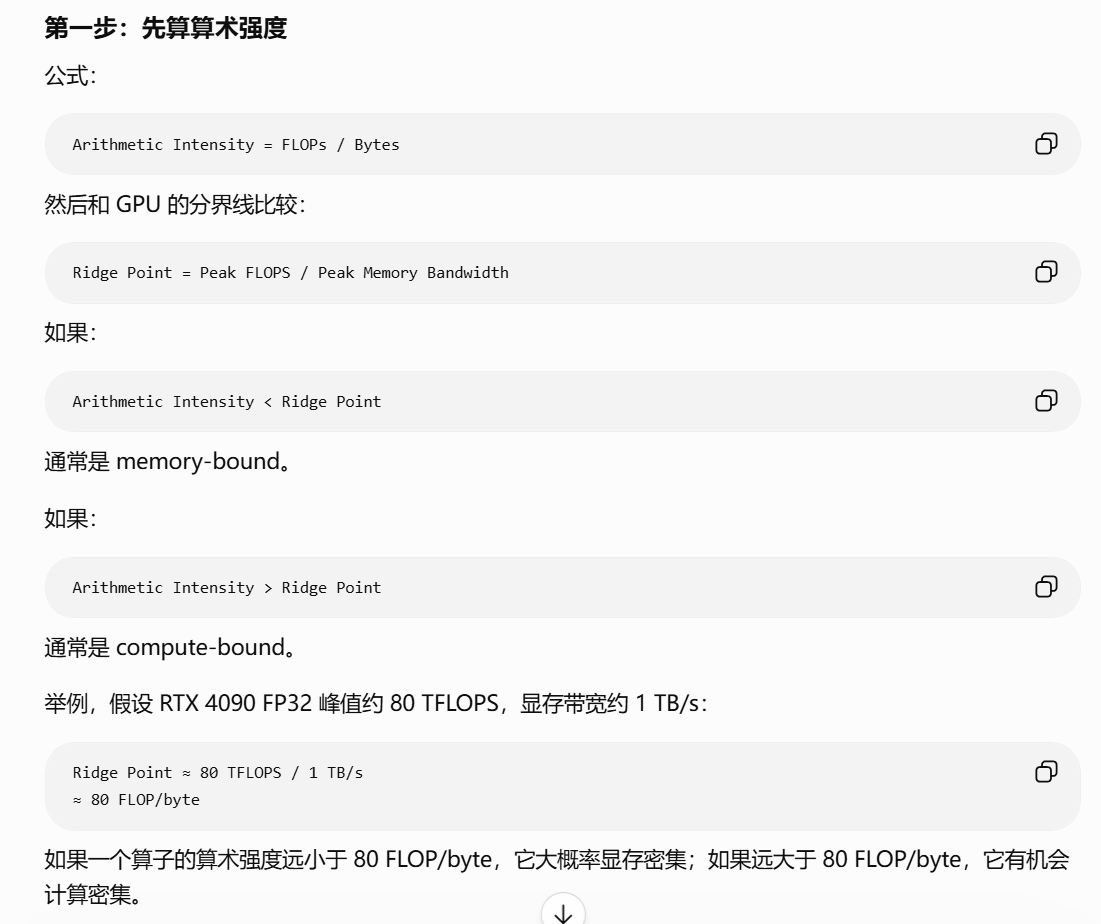
计算密集型 - 显存密集型 / 计算瓶颈 - 显存瓶颈
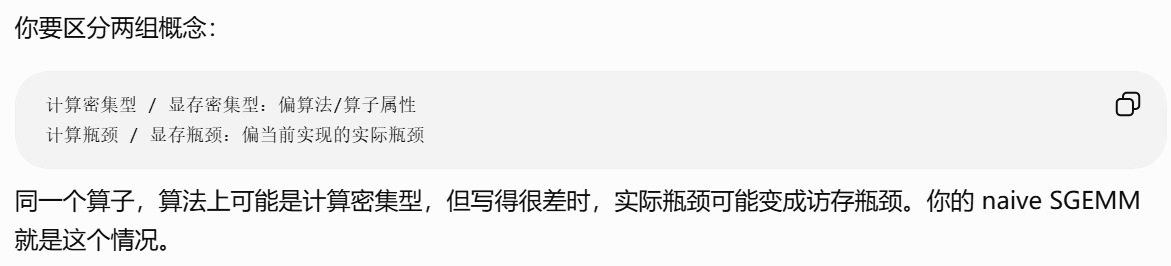
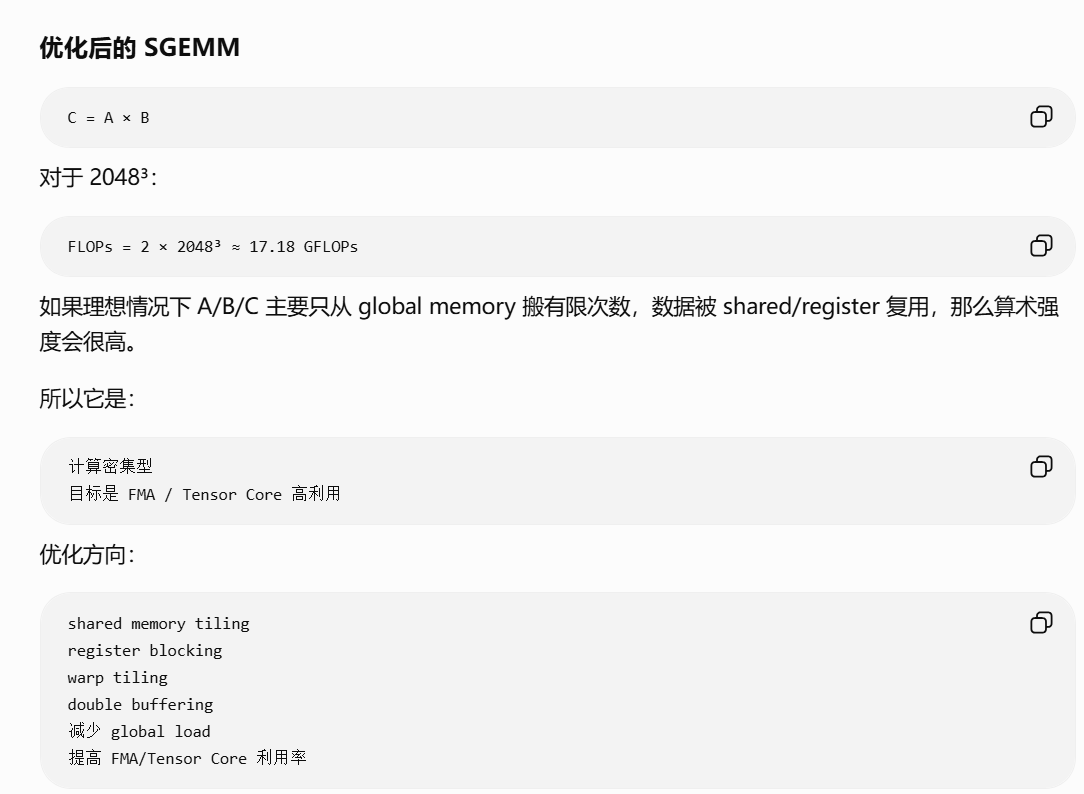
计算密集型
每搬 1 byte 数据,可以做很多次计算。
核心指标:
算术强度 = 浮点运算次数 / 访存字节数
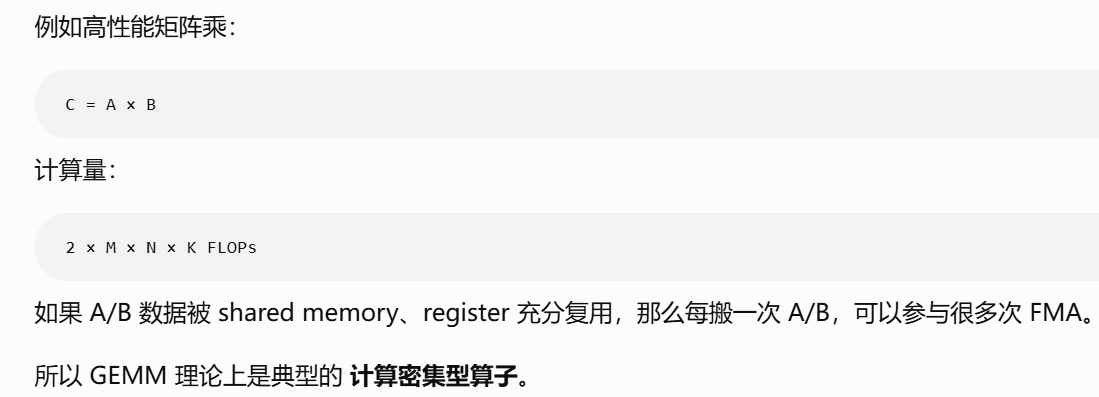
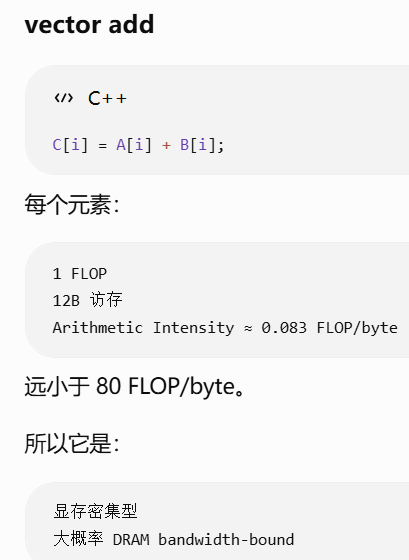
显存密集型:
每搬 1 byte 数据,只做很少计算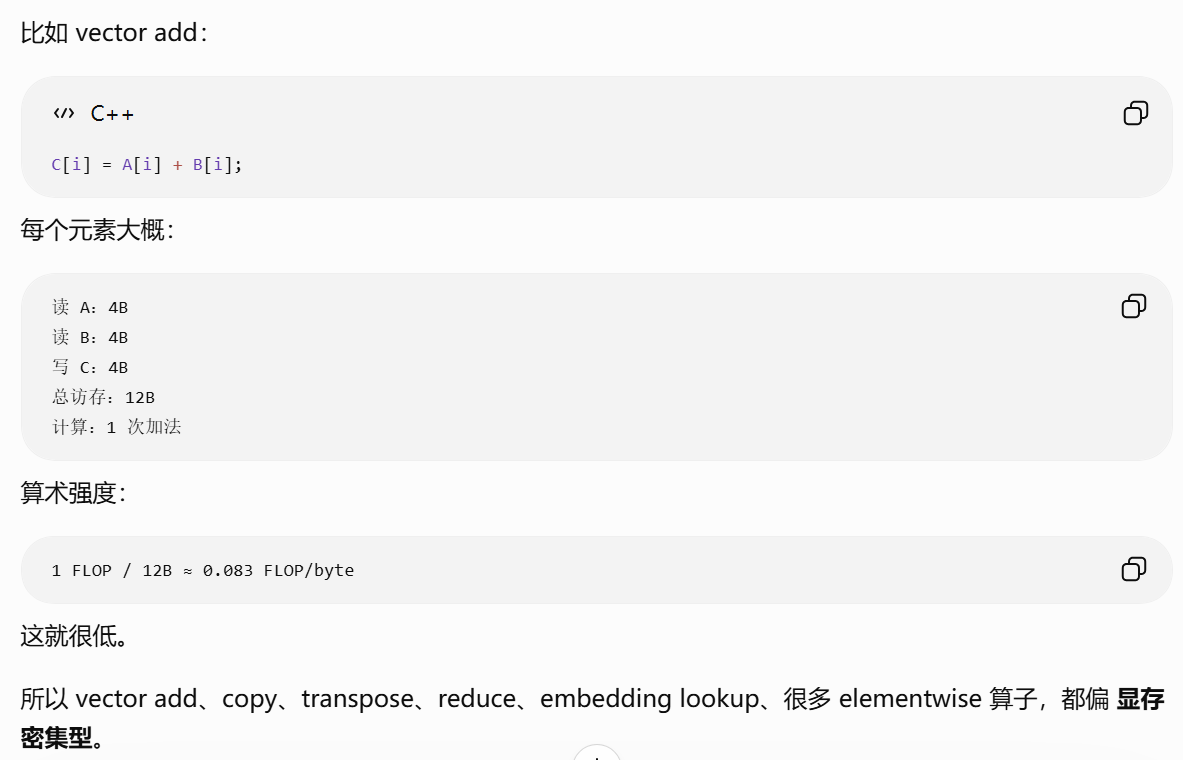
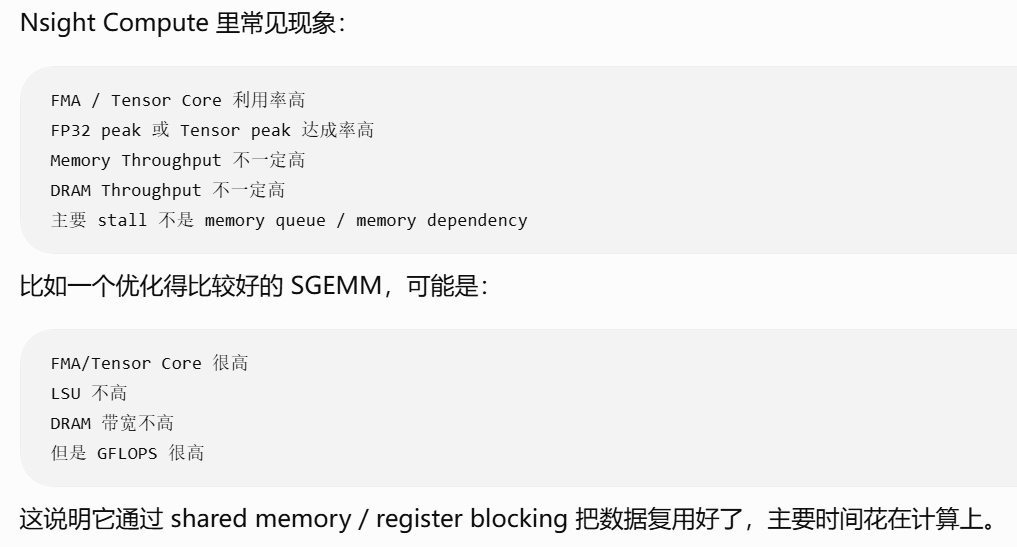
计算瓶颈
kernel 的速度主要受计算单元限制,比如 FMA / Tensor Core / SFU 等计算管线已经很忙,继续优化访存意义不大,应该优化计算组织。
显存瓶颈
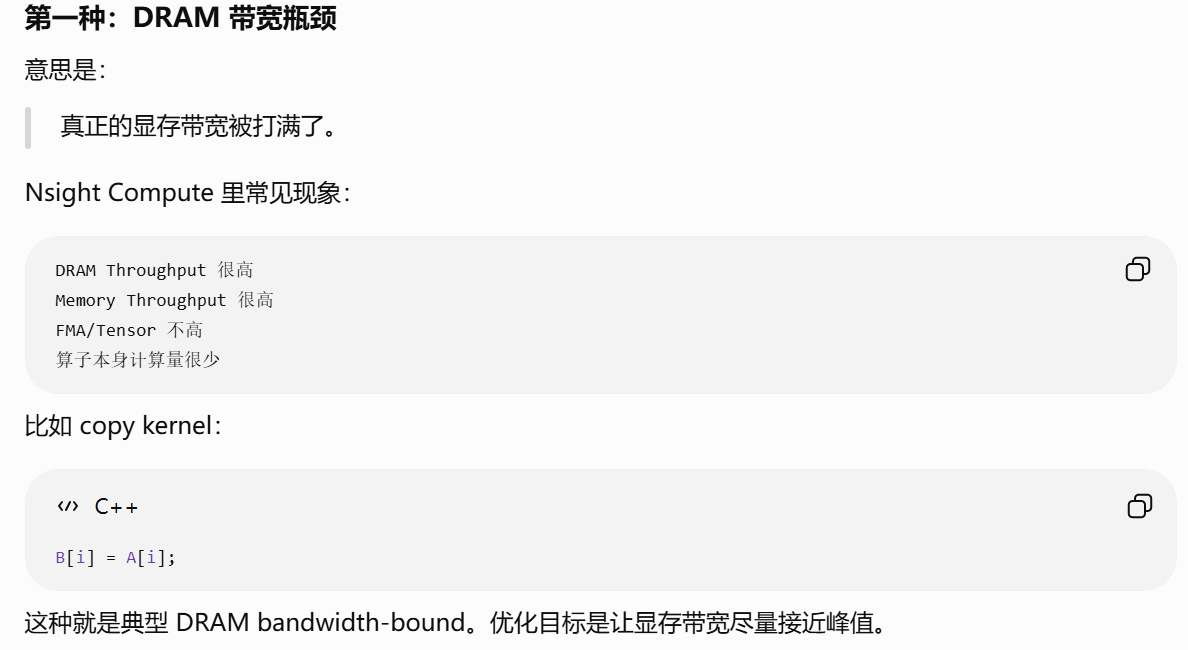
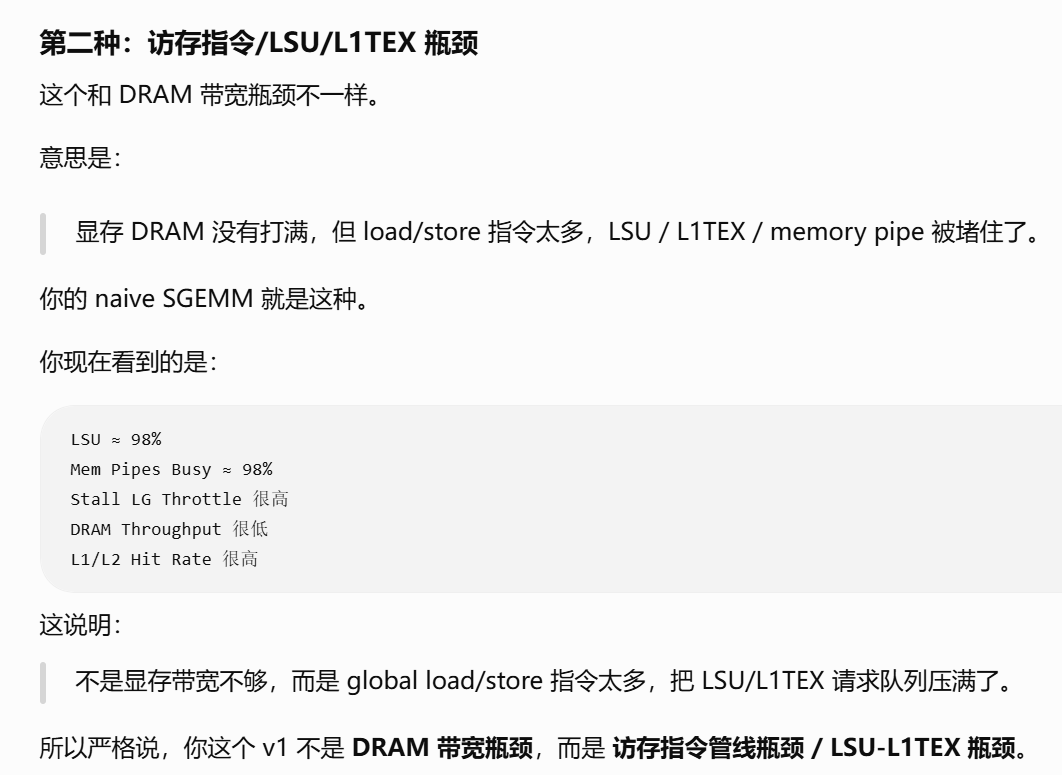
显存瓶颈有两种,要分清
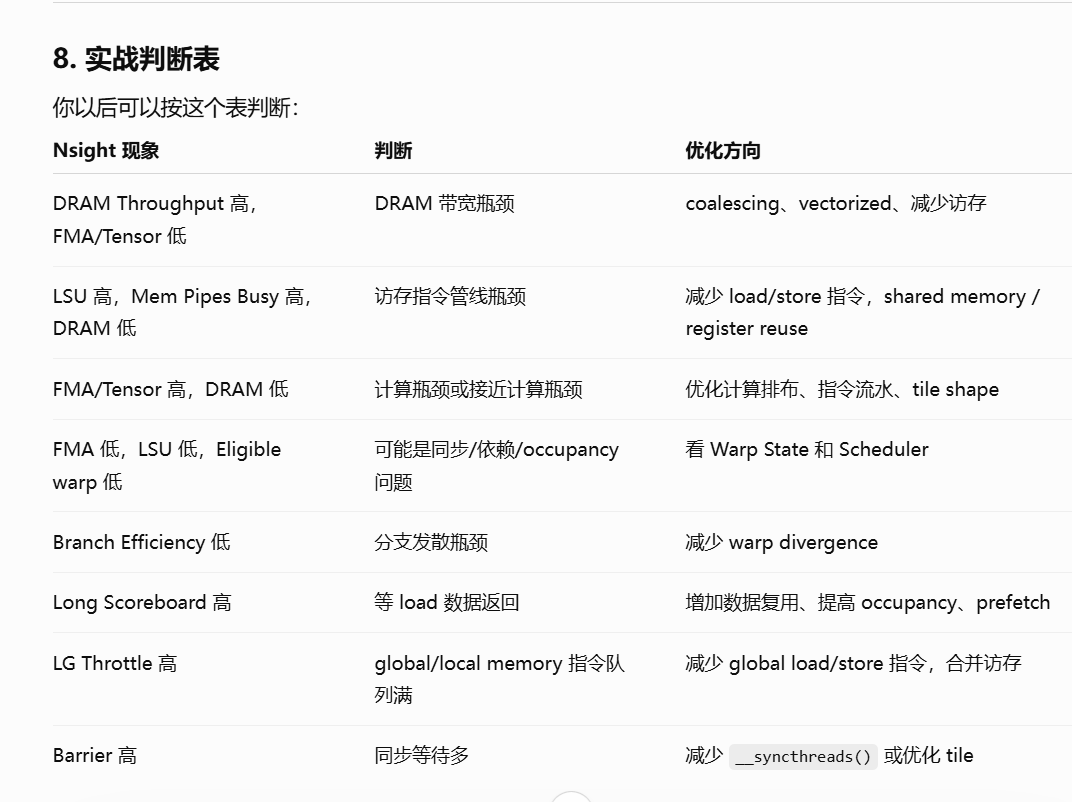
如何准确判断
计算密集型算子: |