infra 基于cuda自制llama大模型推理框架
环境安装
gcc, g++
nvcc编译器
armadillo数学库
cmake
cmake帮你写Makefile, 然后你用make进行编译
CMakeLists.txt |
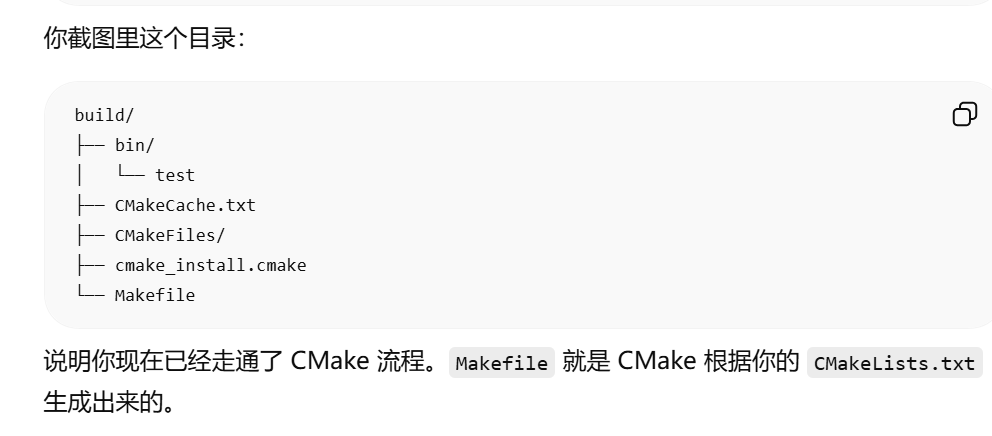
cmake的使用
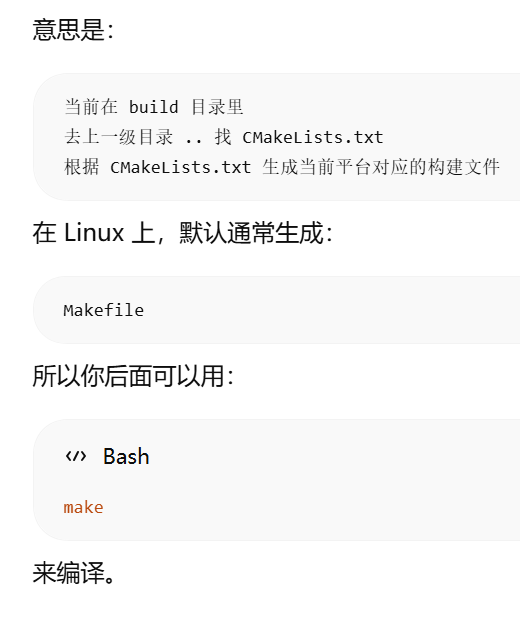
- 第一阶段(构建编译文件)
cmake .. |
- 第二阶段(编译)
CMakeLists.txt
# 表示这个项目最低需要的CMake的版本 |
最后生成的Makefile约等于:/usr/bin/g++ -std=c++17 -o test test.cpp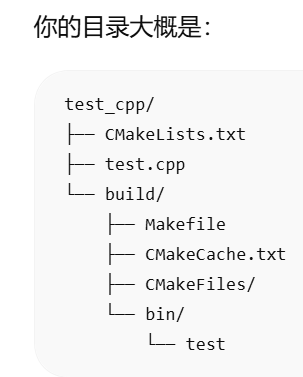
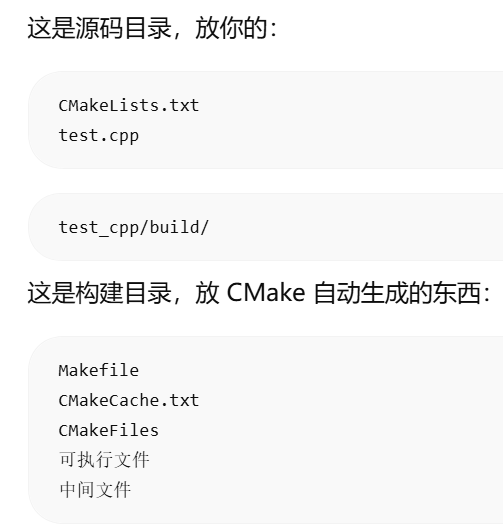
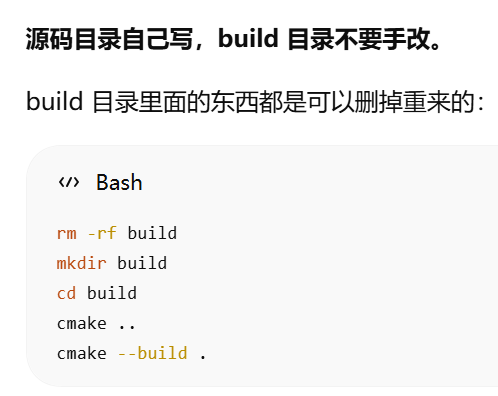
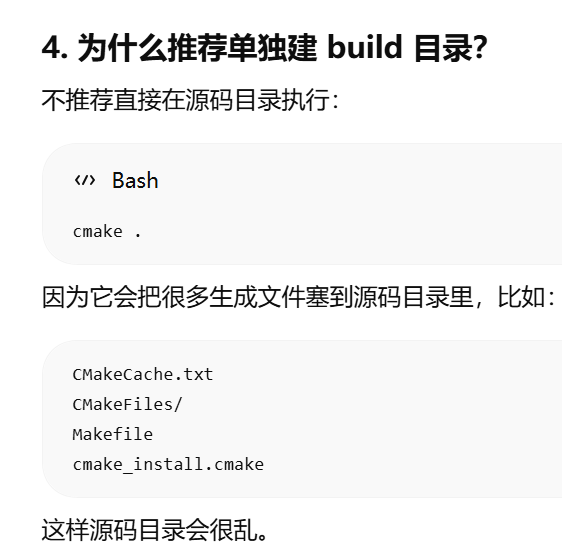
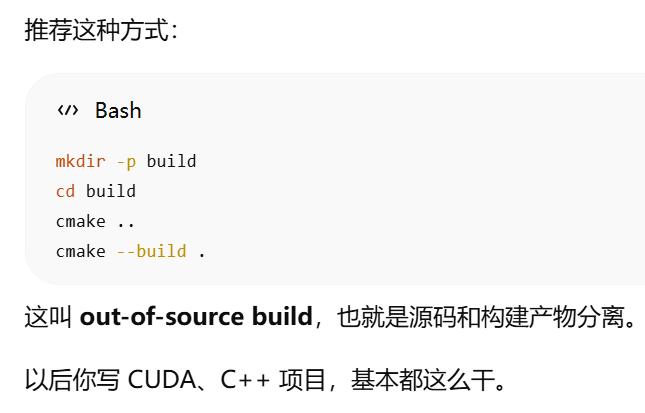
cmake真正的好处
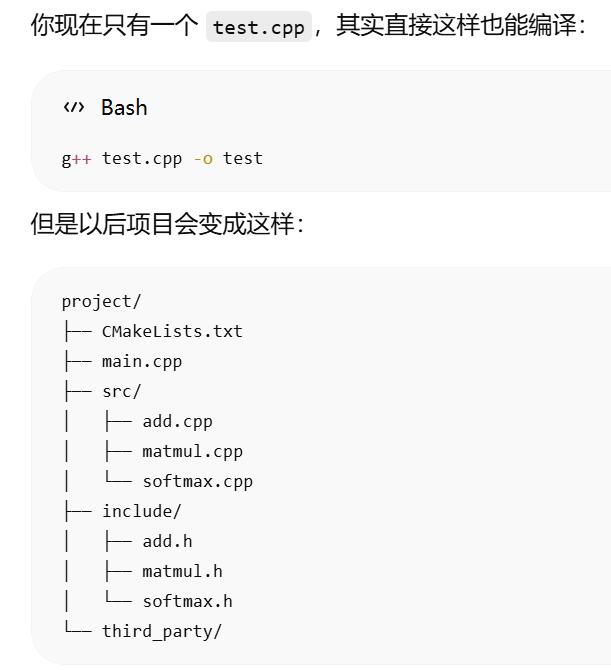
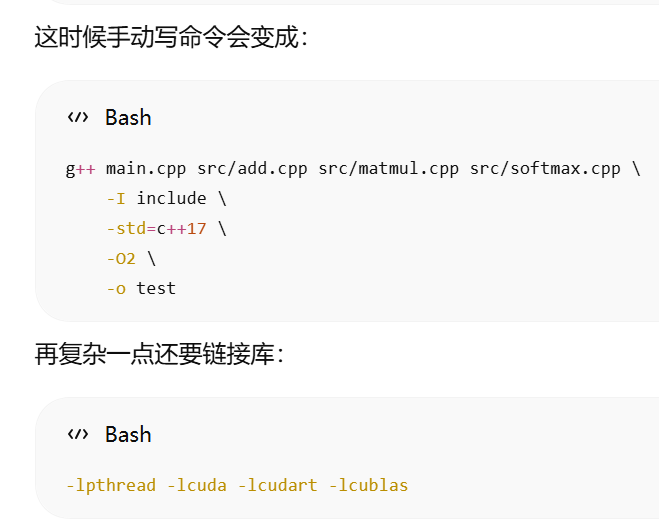
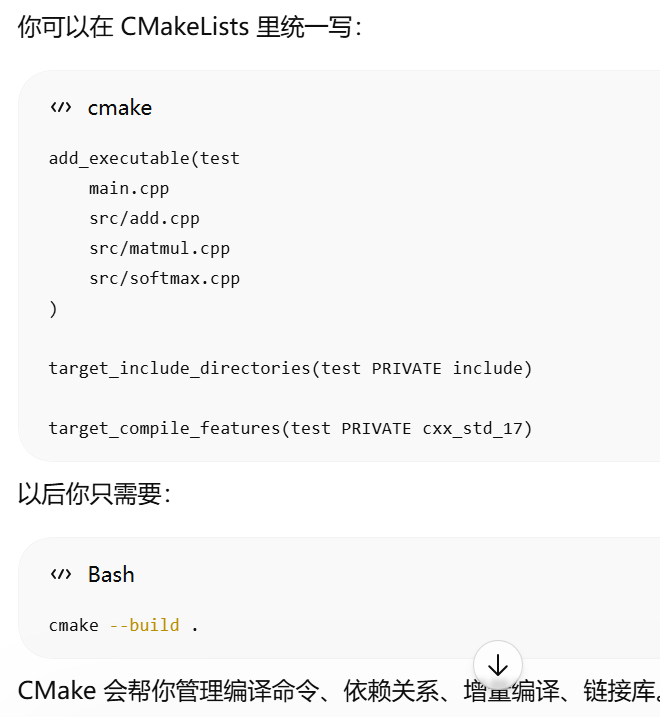
CMakeLists.txt:
cmake_minimum_required(VERSION 3.10) |
这里:
add_executable(test ...) |
创建一个目标,叫 test。
target_include_directories(test PRIVATE ...) |
给 test 这个目标添加头文件搜索路径。
target_compile_features(test PRIVATE cxx_std_17) |
让 test 用 C++17 编译。
这就是现代 CMake 的核心思想:
不要全局乱 set尽量围绕 target 配置 |
也就是围绕:
add_executable() |
这些来写。
cmake的指令参数
cmake -S . -B build -DCMAKE_BUILD_TYPE=Debug |
项目里的CMake构建速查
一个项目从 CMakeLists.txt 到可执行文件,大概是这条线:
include() / find_package() |
根 CMakeLists.txt 通常先做这些事:
cmake_minimum_required(VERSION 3.16) |
重点:
CMAKE_EXPORT_COMPILE_COMMANDS ON:生成compile_commands.json,方便 IDE 跳转和补全。project(llama_infer CXX CUDA):启用 C++ 和 CUDA 两套语言支持。include(cmake/cuda.cmake):执行 CUDA 探测脚本,比如检查 toolkit、GPU 架构。
几个容易混的点:
include(xxx.cmake):执行 CMake 脚本,类似 bash 的source,不是 C++ 的#include。find_package(GTest REQUIRED):找的是库安装时附带的 CMake 描述文件,不是直接找.so/.a。GTest::gtest:CMake target,里面已经打包了头文件路径、库路径和依赖。PROJECT_SOURCE_DIR:顶层CMakeLists.txt所在目录。REQUIRED:找不到就直接报错停止。add_library(llama SHARED ...):llama是 CMake 目标名,不是最终文件名。SHARED表示生成动态库,Linux 下 CMake 会自动加lib前缀和.so后缀,所以产物是libllama.so。
顺序上,target_include_directories / target_link_directories / target_link_libraries 必须写在 add_executable/add_library 之后,因为它们要绑定到已经创建好的 target。
如果有子目录:
add_library(llama SHARED ...) |
test/demo 如果要链接 llama,就应该放在 add_library(llama ...) 之后。
条件编译常用来控制模型支持:
option(QWEN2_SUPPORT OFF) |
命令行开启:
cmake .. -DQWEN2_SUPPORT=ON |
用途:不同模型依赖不同,按需打开,避免强制安装暂时不用的库。
第三方库安装后通常长这样:
/usr/include/gtest/ # 头文件 |
常用命令:
mkdir -p build && cd build |
make test_llm 时,如果 test_llm 写了:
target_link_libraries(test_llm llama) |
CMake 会自动先编 llama,再编 test_llm,不用手动分两步。
常见目标:
| 目标 | 产物 |
|---|---|
llama |
lib/libllama.so |
test_llm |
build/test/test_llm |
llama_infer |
build/demo/llama_infer |
查看有哪些目标:
make help |
库链接怎么判断
核心原则:
只要代码用了某个库的头文件,一般就要把对应库写进
target_link_libraries。
target_link_libraries(llama |
可以粗略分三类:
| 类型 | 例子 | 是否需要手动链接 |
|---|---|---|
| 编译器默认库 | libstdc++、libc、libm、libgcc |
通常不用 |
| 系统库但不默认链接 | pthread、dl、rt |
需要 |
| 第三方库 | glog、gtest、sentencepiece、cudart、armadillo |
需要 |
glog::glog 这种带 :: 的名字,一般是 CMake target,里面已经带了头文件路径、库路径和依赖。
sentencepiece、cudart 这种裸库名,等价于让链接器去找:
libsentencepiece.so / libsentencepiece.a |
一句话记忆:
include 解决“编译时能不能看到声明” |
GTest单元测试速查
基本写法:
TEST(test_buffer, allocate) { |
TEST(suite, name) 会自动生成测试类,并注册到 gtest 的全局用例列表。RUN_ALL_TESTS() 会统一执行这些测试。
suite 通常写模块名,name 写测试场景,比如 test_buffer.allocate。
常用断言:
| 断言 | 含义 |
|---|---|
ASSERT_EQ(a, b) |
a == b |
ASSERT_NE(a, b) |
a != b |
ASSERT_TRUE(cond) |
条件为真 |
ASSERT_FALSE(cond) |
条件为假 |
ASSERT_STREQ(a, b) |
C 字符串相等 |
ASSERT_ 失败后立刻终止当前用例,EXPECT_ 失败后记录错误但继续执行。
运行命令:
make test_llm -j$(nproc) |
输出里重点看:
[ RUN ] test_buffer.allocate |
如果失败,会打印断言所在文件行号、期望值和实际值。
CMake 集成:
find_package(GTest REQUIRED) |
test_llm 本质是一个测试可执行文件,里面链接了 libllama.so、gtest、glog 等依赖。
gdb使用
gdb是调试工具,需要按照调试模式来编译程序
# 构建 |
重点是我们指定按照Debug模式来编译程序
之后我们就可以用gdb来进行调试了
gdb ./build/bin/test |
- 打断点
- main
bread mainb main
- 行号
break test.cpp:6b test.cpp:6
- main
- 开始运行程序
runr
- 执行
- 单步执行(不进入函数内部)
nextn
- 单步执行(进入函数内部)
steps
- 执行到下一个断点
continuec
- 单步执行(不进入函数内部)
- 查看当前停在哪里
where
- 查看函数调用栈
bt= backtrace
- 查看当前源码附近
listl
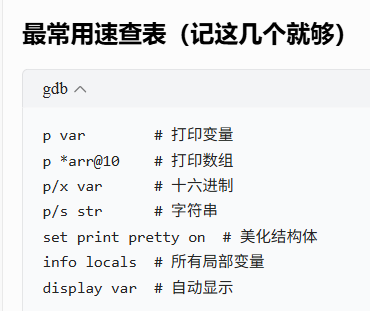
- 打印变量
- 直接打印变量值
p ip namep this->count
- 格式化打印
p/x 变量16进制打印p/d 变量10进制打印- …
- 打印复杂类型
- 数组/连续内存
p *arr@10打印arr数组的前10个元素
- 结构体/类
p 结构体变量
- 漂亮打印(缩进打印结构体)
set print pretty onp user
- 数组/连续内存
- 打印全局变量
p 变量名p ::count避免和局部变量重名
- 打印指针指向内容
p *ptr
- 连续自动打印(每次停下都显示)
display 变量- 取消自动打印
undisplay
- 查看内存
x/格式 地址x/10xw ptr打印10个32位(word),按16进制(x)x/20cb ptr打印20个字节(8位),按照char解析
- 查看所有局部变量
info locals一次性打印当前函数所有变量
- 直接打印变量值
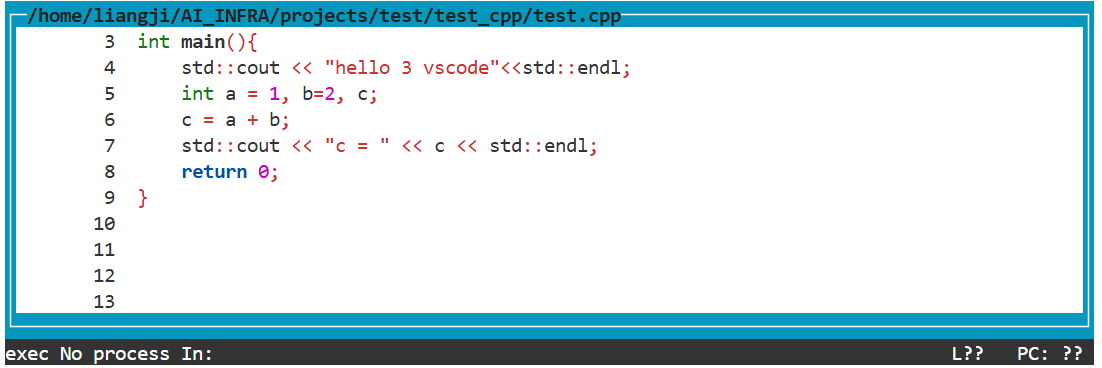
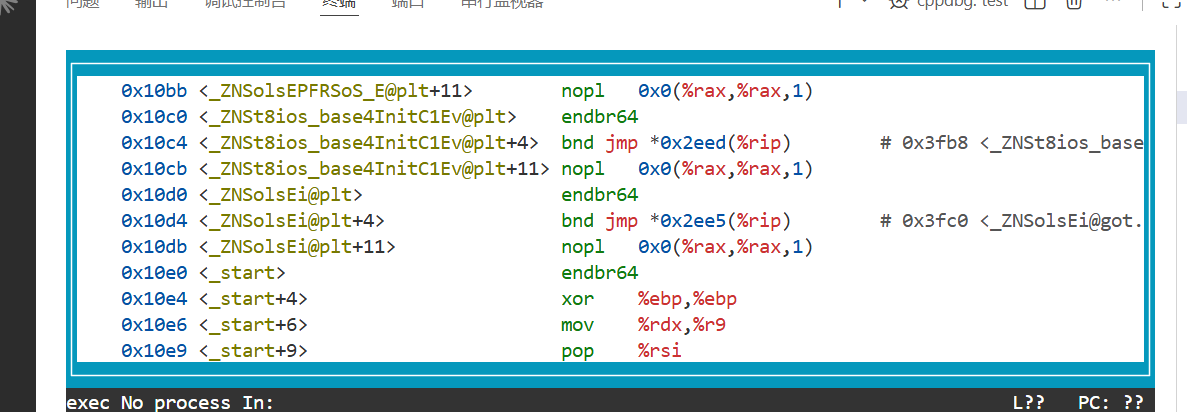
- 查看各种界面
layout src源码界面layout asm汇编界面layout regs寄存器界面
CMake
前面已经知道,cmake是帮助你编写Makefile的,我们可以利用CMake的方法,来自动生成整个项目的Makefile
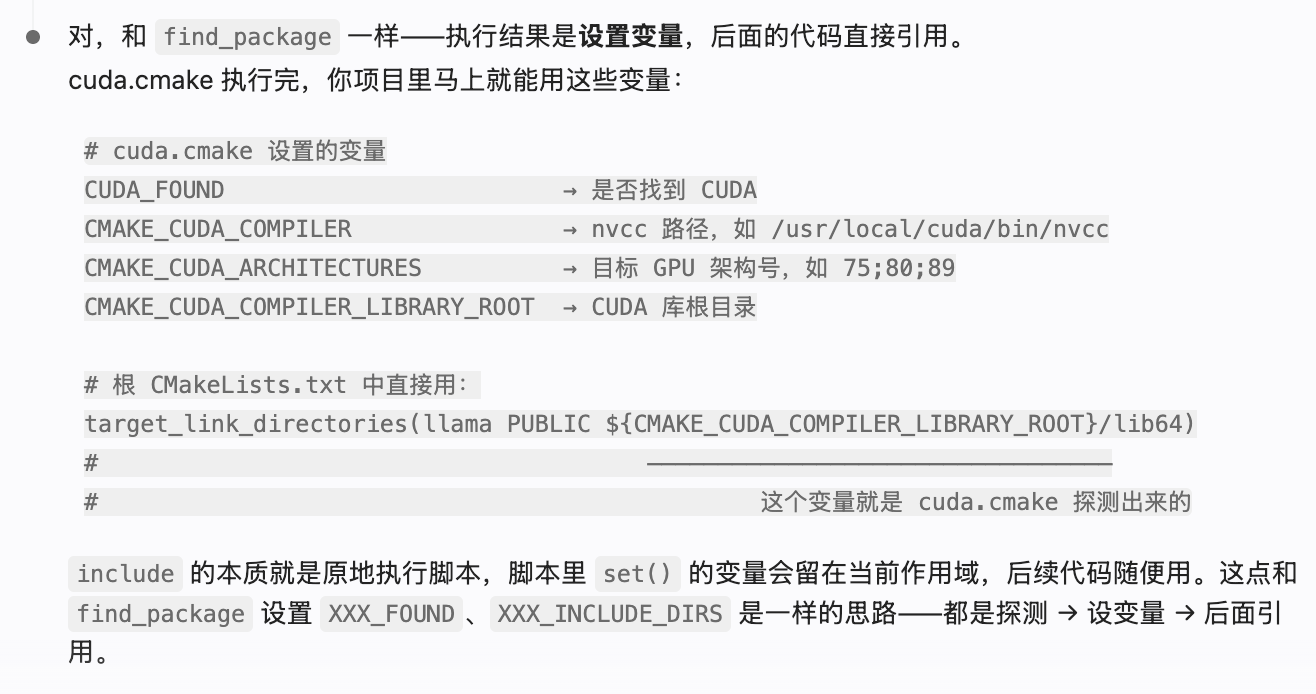
include(../cmake/cuda.cmake)
CMakeLists里面的include,是针对同样的cmake来的,这不是引用库,而是把cuda.cmake里的代码原样贴过来执行
.cmake 后缀只是约定,表明”这是个 CMake 脚本”,不是 .so 或 .a 库文件。
这个.cmake说明书的作用:检查cuda工具链是否存在,探测显卡架构,把执行结果,保存到变量里面,后面的代码直接引用
find_package(GTest REQUIRED)
第三方库编译成.so后,安装到系统中(/usr/lib/archxxx/),
顺带会装上.cmake描述文件(可以理解为说明书 /usr/lib/archxxx/cmake)
find_package靠.cmake找到库的物理位置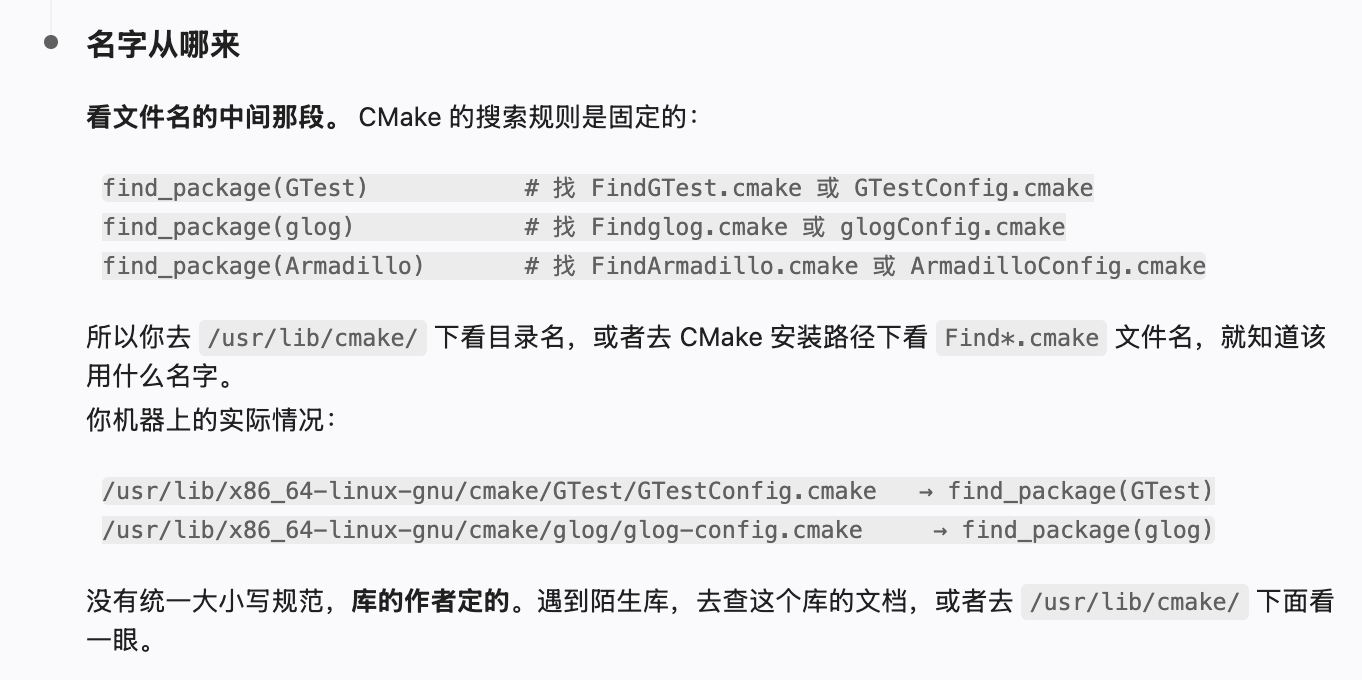
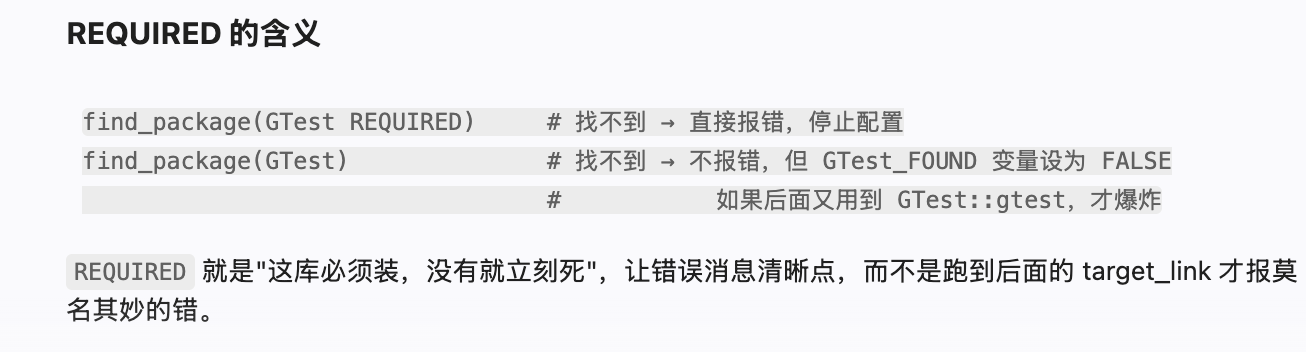
找到库之后,会把检查结果记录到一些变量里面,就是后面的:
- ${glog_INCLUDE_DIR}
- ${GTest_INCLUDE_DIR}
所以流程就是:find_package 探测库的位置 → 设置变量 → target_include_directories 用这些变量告诉编译器。
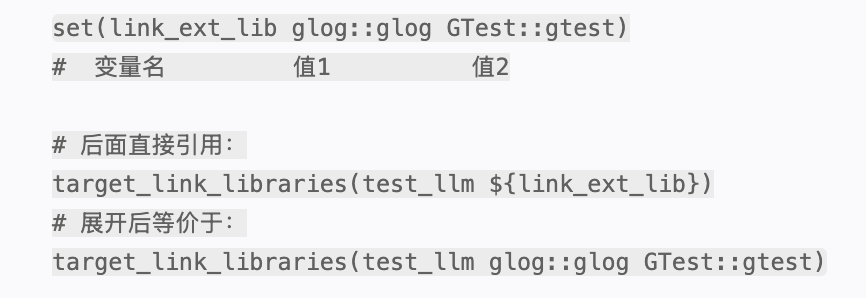
set(link_ext_lib glog::glog GTest::gtest)

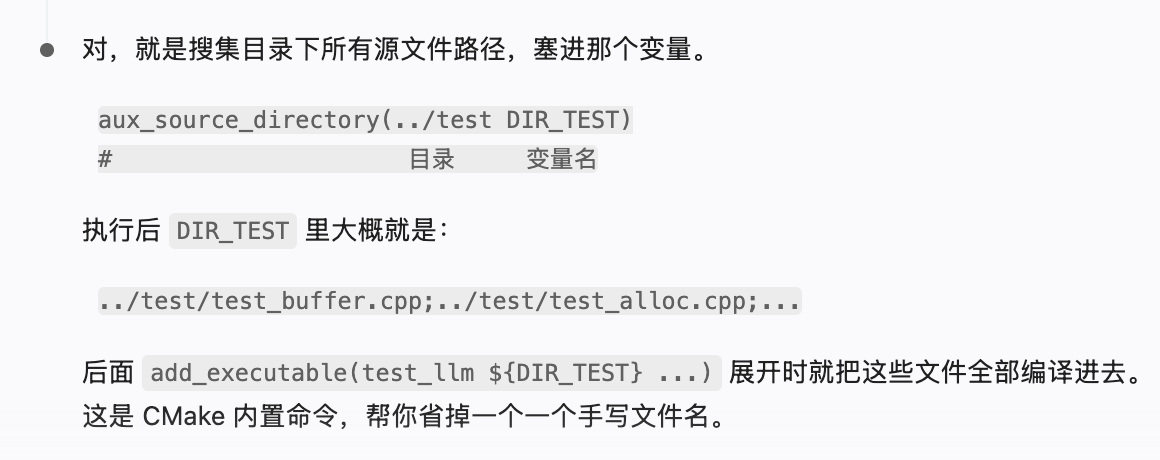
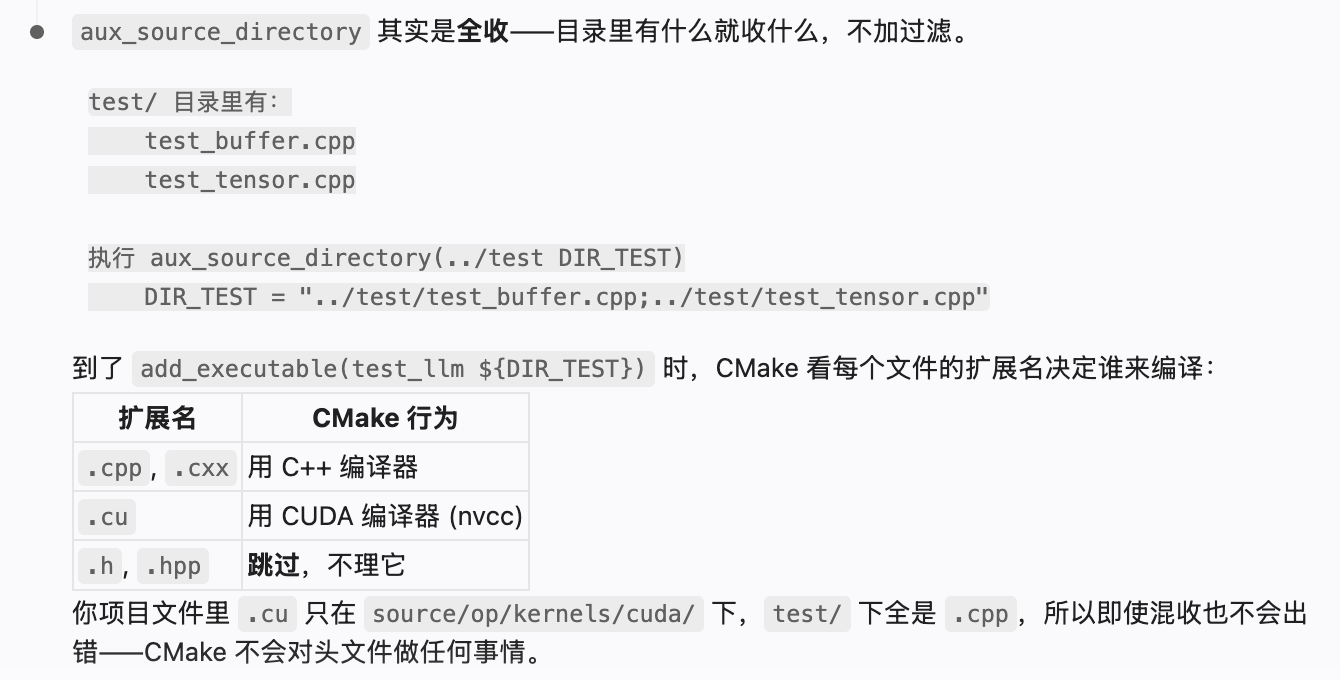
aux_source_directory(目录 变量名)
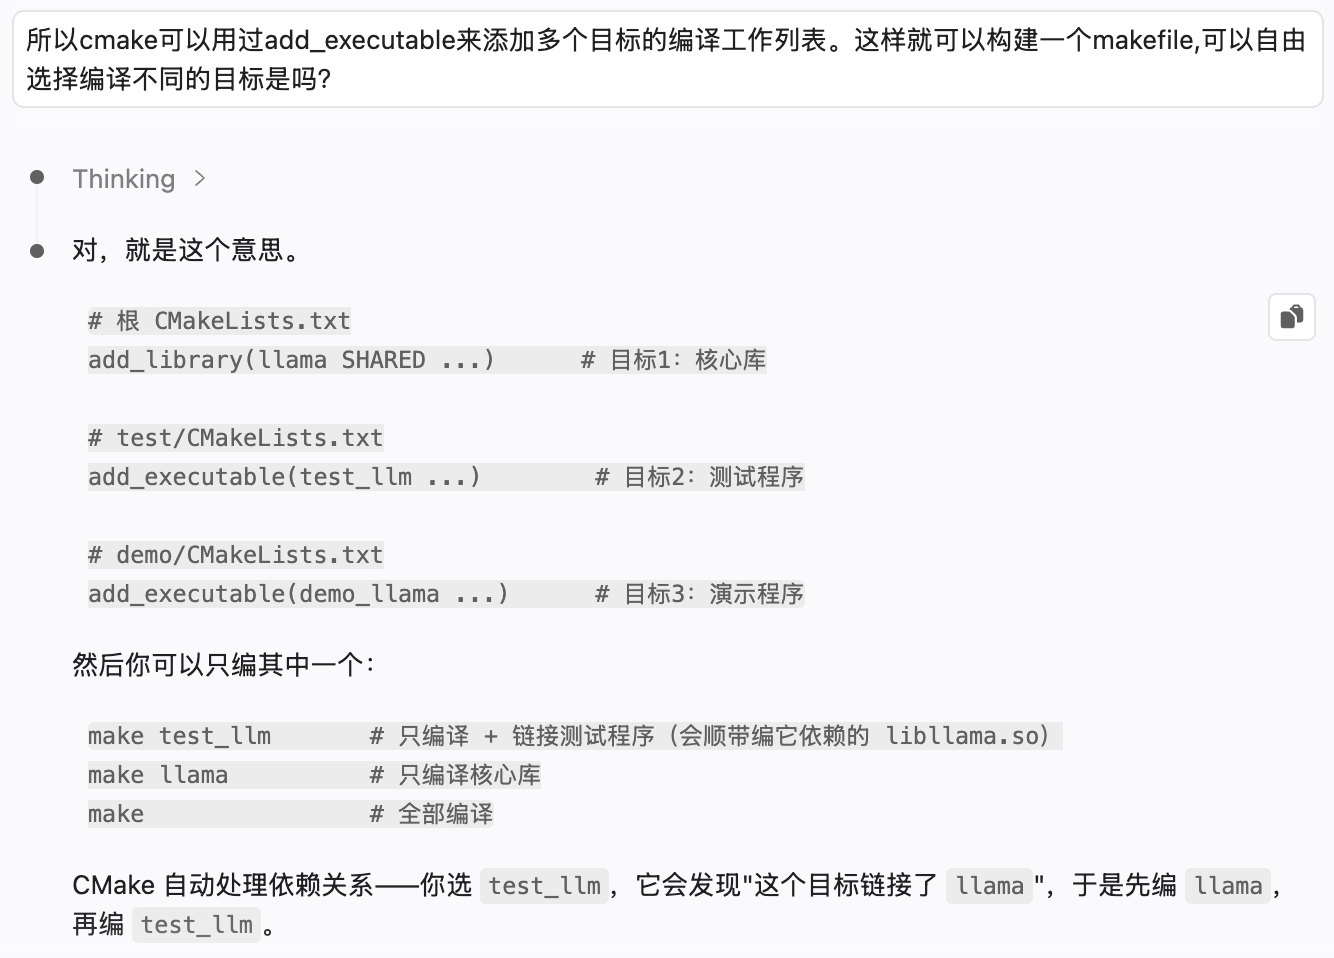
- add_executable(名字 源文件列表)
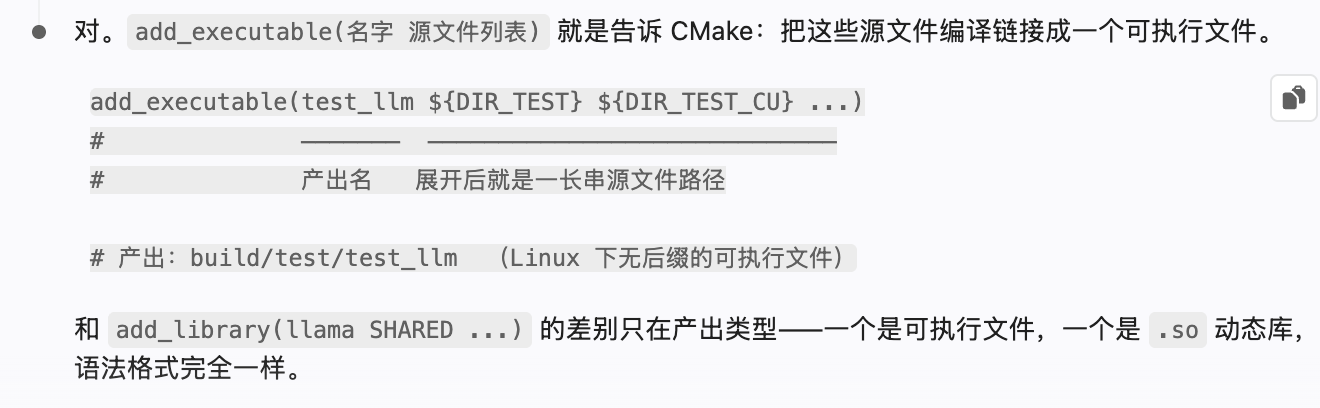
注意,这个add_executable还没有正式开始编译,只是注册目标,告诉CMake,要编译什么。
真正开始构建,是你执行 cmake –build . –target test_llm
或者make test_llm
- target_link_libraries(目标 链接库)
这个的作用,就是g++里面的-l, 可以链接的库有:
- 动态库(.so)(看到.so就只记引用,运行到这一块的时候,才加载)
- 静态库(.a)(链接器看到.a就把代码拷贝到可执行文件中)
这里纠正一个认识:
给你一个库,so/a, 里面肯定是各种方法的实现,但是这个方法叫什么,你肯定在写代码的时候,就需要知道,所以库文件.so/.a, 还需要配合头文件,这样你才知道方法叫什么。
target_include_directories(目标 PUBLIC 目录)
指定头文件的目录target_link_directories(目标 PUBLIC 目录)
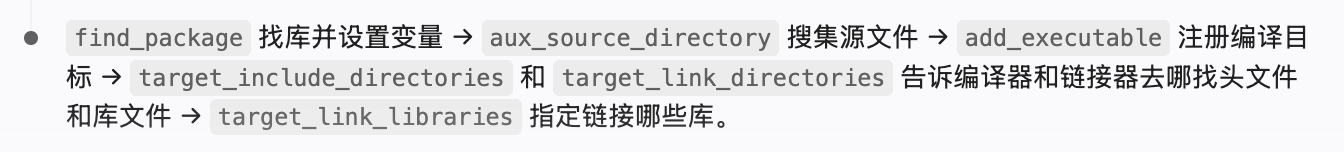
总结
用CMakeLists,来利用cmake构建一个项目的make,流程是: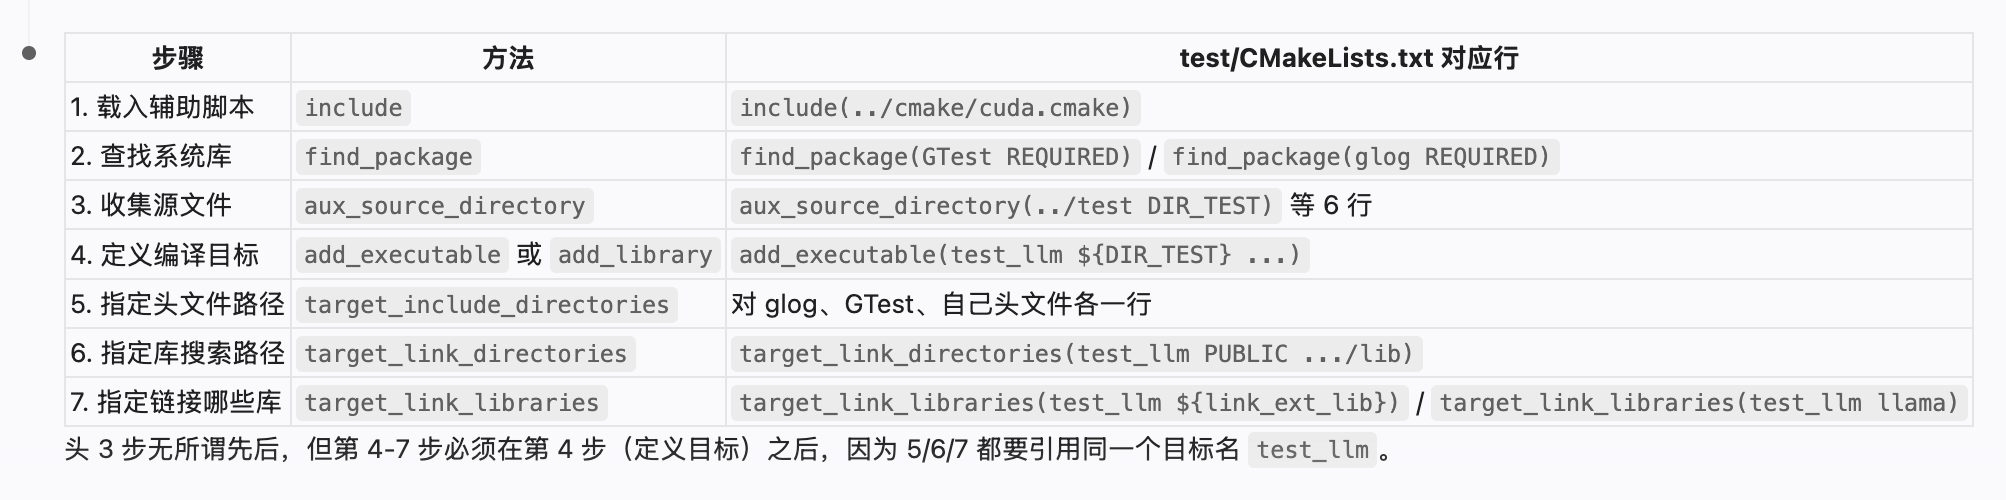
c++20的特性
命名空间
我的理解,就是相当于形象的理解成模块归属的机制就行。
关键字
explicit
静止编译器做隐式类型转换,强迫调用者显式写出构造动作,避免编译器帮你自动做类型转换。override
void* allocate(size_t byte_size) const override;
用来告诉编译器,我在重写基类虚函数,帮我检查,如果这个不是基类的虚函数,就变成新函数。override的作用是把错误提前到编译阶段。
这个里面的const,是表示常函数,这个函数内部,不会修改这个对象内存的任何成员变量。
- mutable
这个是const的后门,如果const修饰了成员函数,那么内部就不能改变变量,但是有一个例外,就是如果这个成员函数被标记了mutable。那么即便在常函数里面也能修改。
容器
- map
STL标准库里面的有序键值对容器,#include<map>
语法
static_cast / reinterpret_cast / const_cast
c++风格的强制类型转换, 比()直接转换更安全。
()转换等于:
static_cast— 相关类型间的转换(只做编译期可检查的转换)reinterpret_cast— 不相关指针类型间的暴力转换const_cast— 悄悄去掉 const
= delete 禁止拷贝
显式删除某个函数,让编译器禁止调用它。常用于禁止拷贝:
class NoCopyable { |
子类继承 NoCopyable 后,普通构造不会受影响:
Buffer buf(128, alloc); // 正常构造 |
但拷贝构造和拷贝赋值会被编译器拒绝:
Buffer buf2(buf); // 触发拷贝构造,编译报错 |
= delete 是编译期拦截,不是运行时报错。
在 Buffer 这种管理大块内存的类里,禁止拷贝可以避免两个对象指向同一块 ptr_,析构时发生 double free。
enum 和 enum class
普通 enum:
enum StatusCode : uint8_t { |
枚举值可以直接使用,也容易隐式转成 int:
int code = kSuccess; |
enum class:
enum class DeviceType : uint8_t { |
使用时必须带作用域:
DeviceType type = DeviceType::kDeviceCUDA; |
enum class 更类型安全:不会隐式转成 int,不同枚举类型之间也不能随便比较。
: uint8_t 表示指定底层存储类型,能减少内存占用。默认优先用 enum class,只有需要和 int 高频交互时再考虑普通 enum。
virtual xxx = 0 纯虚函数
= 0 表示纯虚函数:基类只声明接口、不提供实现,子类必须重写;含纯虚函数的类不能直接实例化。
virtual base::Status forward() = 0; |
右值引用和 std::move
左值引用 T&,就是引用一个正常变量,有名字,能取地址。
右值引用 T&&,可以理解成引用一个临时对象,或者一个后面基本不用的对象。
右值引用的核心作用:告诉编译器,这个对象里面的资源可以被转移走。
std::move 这个名字有点迷惑,它本身不搬数据,也不申请内存,只是做了一次类型转换:
std::move(x) = static_cast<T&&>(x) |
std::move 的本质:把一个左值,强行标记成“可以被移动的右值”。
比如 Tensor 构造函数里面:
Tensor::Tensor(base::DataType data_type, std::vector<int32_t> dims, ...) |
这里的 dims 是形参,本身是一个局部变量,所以它其实是左值。
但是构造函数结束之后,dims 就没用了,所以这里用 std::move(dims),让成员变量 dims_ 直接接管它内部的堆内存。
拷贝 vector:重新申请内存,然后一个一个复制元素,O(n) |
所以这个写法:
Tensor(..., std::vector<int32_t> dims) |
可以理解成:
调用者传左值:先拷贝到形参 dims,再移动到成员变量 dims_ |
注意:被 std::move 之后的对象还能析构,但是不要再依赖它原来的内容。
几个容易混的点:
dims_(std::move(dims)):这是移动构造,在初始化列表里完成。dims_ = std::move(dims):这是移动赋值,成员变量已经存在了。return t;返回局部对象时,一般不用写std::move(t),编译器会做返回值优化或者自动移动。
vector 常用方法
std::vector 是动态数组,常用增删改查:
| 操作 | 写法 | 说明 |
|---|---|---|
| 增 | v.push_back(x) |
尾部追加 |
| 增 | v.emplace_back(args...) |
尾部原地构造对象 |
| 增 | v.insert(v.begin() + i, x) |
指定位置插入 |
| 删 | v.pop_back() |
删除最后一个元素 |
| 删 | v.erase(v.begin() + i) |
删除指定位置 |
| 删 | v.clear() |
清空元素 |
| 改 | v[i] = x |
修改指定位置 |
| 查 | v[i] |
直接访问,不做越界检查 |
| 查 | v.at(i) |
带越界检查 |
| 查 | v.front() / v.back() |
第一个 / 最后一个元素 |
| 查 | v.size() / v.empty() |
元素个数 / 是否为空 |
v[i] 越界是未定义行为;v.at(i) 越界会抛异常,更适合防御性代码。
项目里如果前面已经手动检查过范围,比如 CHECK_LT(idx, weights_.size()),后面再用 weights_.at(idx) 是双保险。
智能指针
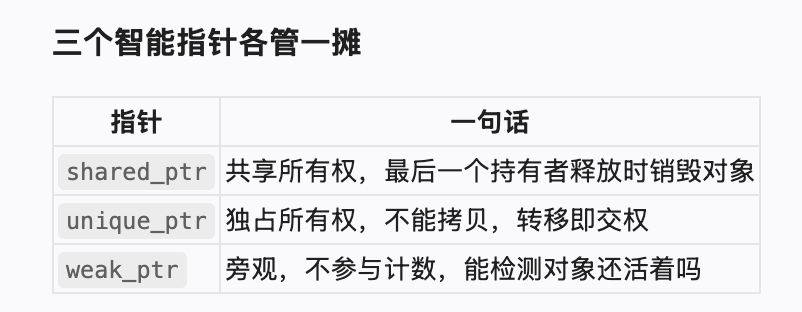
- shared_ptr, c11引入的智能指针之一,功能:引用计数自动管理内存,没人用了就自动delete。
创建方法:
auto p1 = std::make_shared<Buffer>(128, allocator); |
cuda相关
- 异步拷贝,流
cudaMemcpyAsync的”异步”是指:函数调用本身立即返回给 CPU,不等待拷贝实际完成。对比cudaMemcpy(同步),CPU 会卡在那行直到拷贝结束。
至于流内的顺序:同一个流上,任务依然按挂上去的顺序执行,后面的任务仍要等前面的异步拷贝完成。异步只是说 CPU 调用那一刻不等。
所以你这个文件里用 cudaMemcpyAsync 的好处是,CPU 可以快速跑完这段 memcpy 函数,去干别的事(比如准备下一层的输入)。
cudaDeviceSynchronize, 是cpu阻塞等待GPU所有流的任务完成。只要GPU还在干活,就不返回。
- 异步 = CPU 不等 GPU 任务完成就继续往下执行。
cudaDeviceSynchronize= CPU 死等 GPU 上全部任务干完。
项目一:cuda自制大模型推理框架
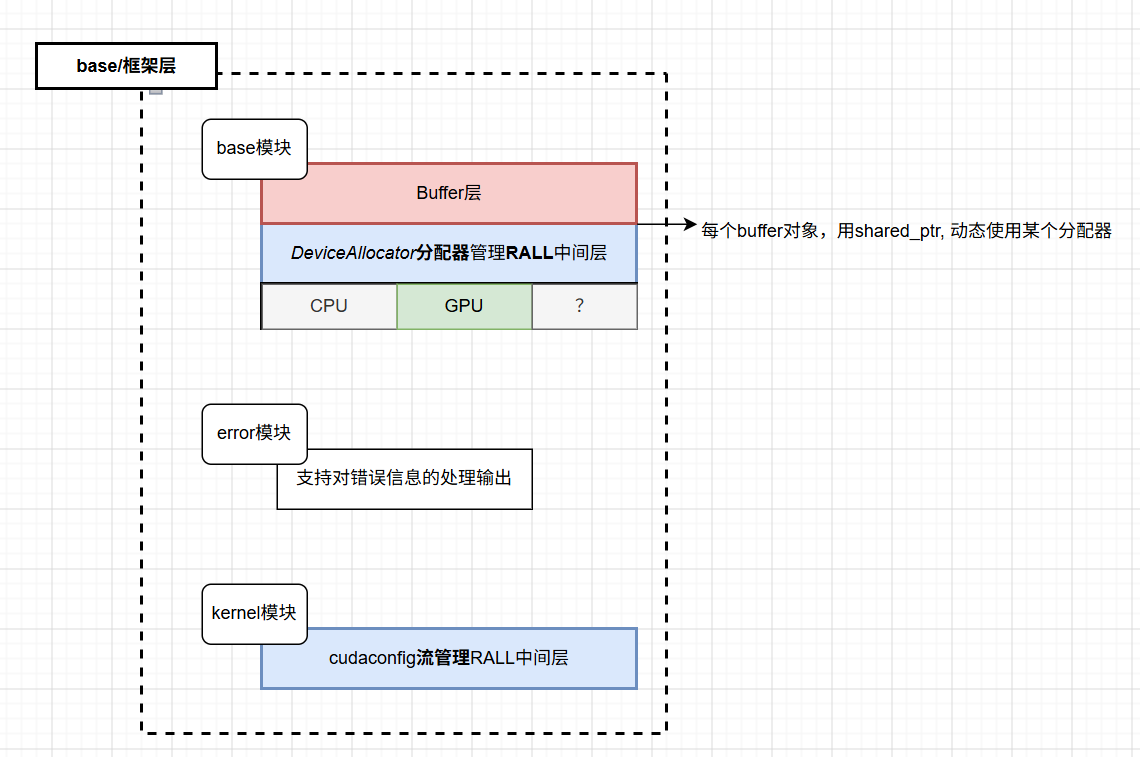
1. base/基础组件层
这边主要三个部分:
- base
- 这个模块主要定义整个推理框架的一些基本类
- 设备类型(枚举)
- 数据类型(枚举)
- 模型类型(枚举)
- 属性类
- 状态类
- 这个模块主要定义整个推理框架的一些基本类
- buffer
- 这个模块对不同设备的内存空间做了一层抽象封装
- 抽象存储空间
- alloc
- 这个模块是对内存分配管理器的封装
Buffer层,DeviceAlloctor层,RALL动态管理设计
我的原话问题:
对了,我记得老师说,buffer类这里面有用智能指针+RALL,智能指针我看就一个shared_ptr, 用来对内存进行引用计数,自动进行释放回收。是吗?
那RALL呢?
shared_ptr 本身就是 RAII 的经典实现,这算什么?共享指针本质上就是一个带一个引用计数机制的特殊指针,我看buffer里面,主要就是用来指定DeviceAllocator类型的指针,是用来表示设备操作类对象的指针的。
buffer类里面,包含的是一块内存的抽象信息(内存大小,内存指针,内存设备,是否是buffer类管理的内存,管理这块内存的DeviceAllocator类对象。)
而一个指向的具体的设备操作类对象,allocator_,(处理的设备类型,就这一个成员属性)
所以我们的用共享指针shared_ptr所实现的RALL思想,是什么意思?是指的buffer类包含的对DeviceAllocator类的动态包括关系吗?
所以buffer类对象,只是内存块的抽象表示层,中间还有一层DeviceAllocator类的分配层,是吗?
这里可以理解成三层:
Buffer # 内存块抽象:大小、指针、设备类型、是否外部内存 |
Buffer 不直接关心底层是 CPU 还是 GPU,它只保存内存块信息,并把申请/释放委托给 allocator_。
Buffer类 里的核心成员大概是:
size_t byte_size_; |
byte_size_ + ptr_:表示这块内存本身。device_type_:标记内存在 CPU 还是 GPU。use_external_:如果是外部传进来的指针,Buffer 不负责释放。allocator_:指向具体分配器对象,负责实际的allocate/release/memcpy。
RALL编程思想 =
Resource Acquisition Is Initialization。
核心思想就一条:把资源的生命周期绑到对象的生命周期上——对象构造时获取资源,对象析构时释放资源。编译器保证析构一定会跑,所以资源永远不会忘了释放。
RAII 的核心:资源在构造时获取,在析构时释放。
在这里有两层 RAII:
Buffer自己管理ptr_指向的内存块:构造时申请,析构时释放。- buffer层,每个buffer类对象,管理ptr_,是通过构造函数,析构函数,来实现RALL的
shared_ptr<DeviceAllocator>管理分配器对象:多个 Buffer 共享同一个 allocator,最后一个引用消失时自动销毁。- DeviceAllocator层,是通过共享指针来动态管理分配器对象,实现RALL的
auto alloc = CPUDeviceAllocatorFactory::get_instance(); |
这里 buf1、buf2 都保存了一份 shared_ptr,共同指向同一个 DeviceAllocator。引用计数归零时,分配器对象才会自动释放。
注意:shared_ptr 管的是 allocator 对象的生命周期;Buffer 析构释放的是 ptr_ 指向的那块数据内存。这两个资源不要混在一起。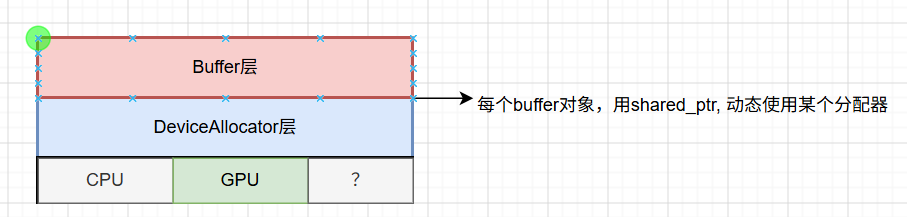
Cuda流层,kernel模块的RAII封装
base 层里还有一个 kernel 模块,对 CUDA stream 做了一层轻量封装:
namespace kernel { |
这里的 CudaConfig 本质上是 CUDA 流的 RAII 包装器。
stream保存一条 CUDA 流。- kernel 函数通过
config->stream拿到指定流,在这条流上启动 GPU 算子。 CudaConfig析构时自动调用cudaStreamDestroy(stream),不用外部手动销毁。
RAII 思想:谁持有资源,谁在析构时负责释放。
和 Buffer 类似:
Buffer 管 ptr_ 指向的内存块 |
区别只是资源类型不同,一个是内存,一个是 CUDA 执行流。
2. tensor/张量层
这一层就是在buffer层的基础上,定义tensor层,上下层之间也是共享指针来动态绑定来实现RALL
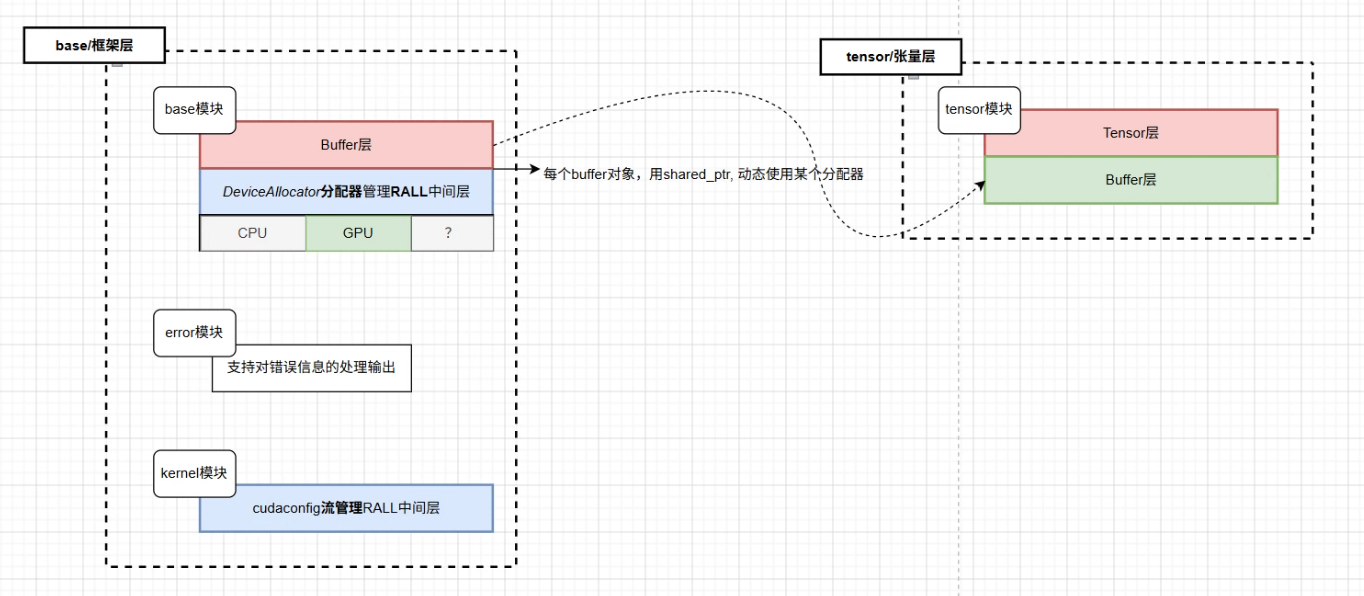
这边主要仔细看了一下构造函数,张量转移函数。
构造函数
张量转移函数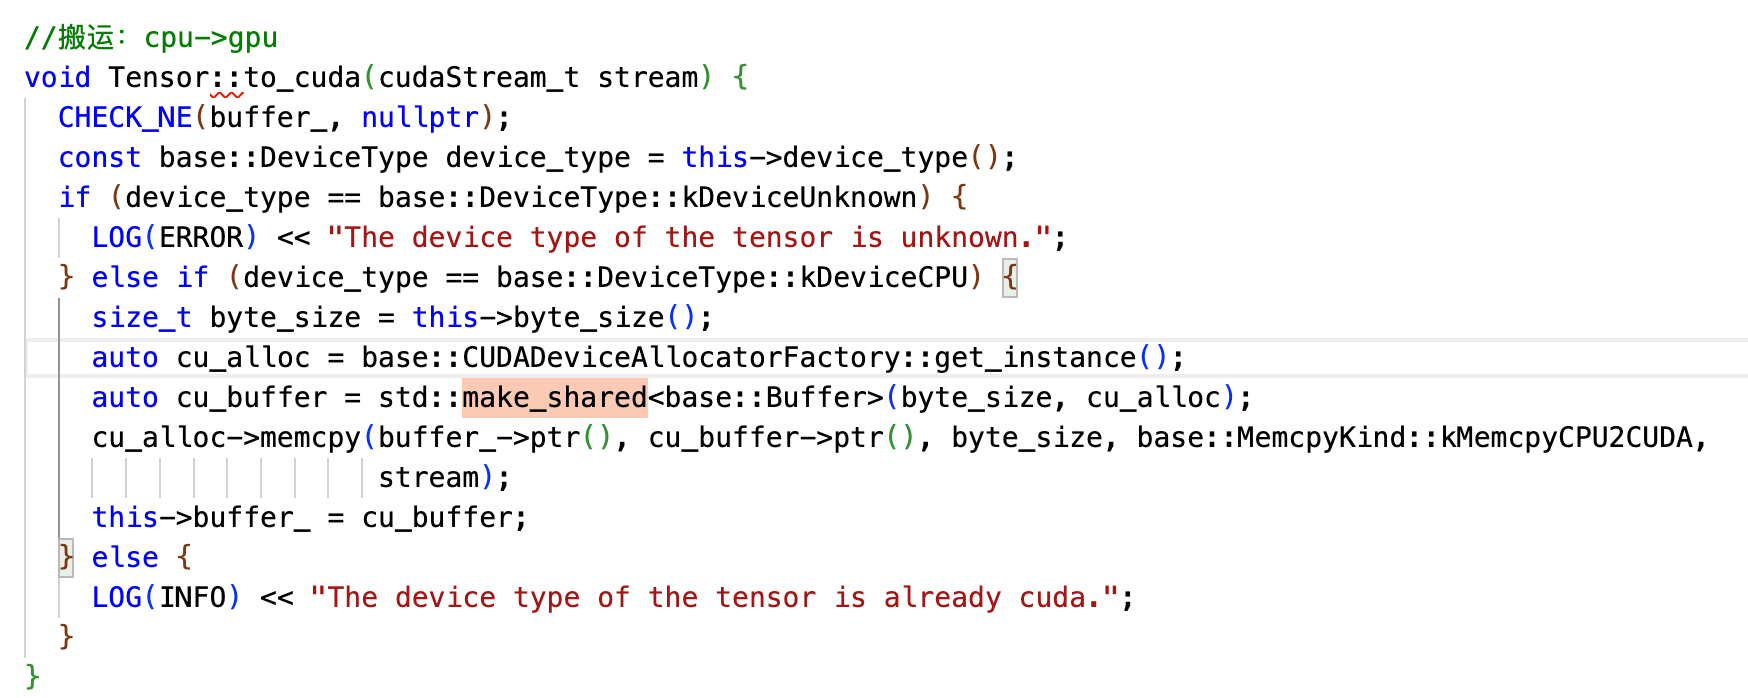
这里来解释一下,
- 先判断当前tensor的设备类型,必须是cpu内存
- 之后
- 获取内存大小
- 工厂函数获取GPU的内存分配器(实际干活的人)
- 工厂函数获取gpu内存分配器
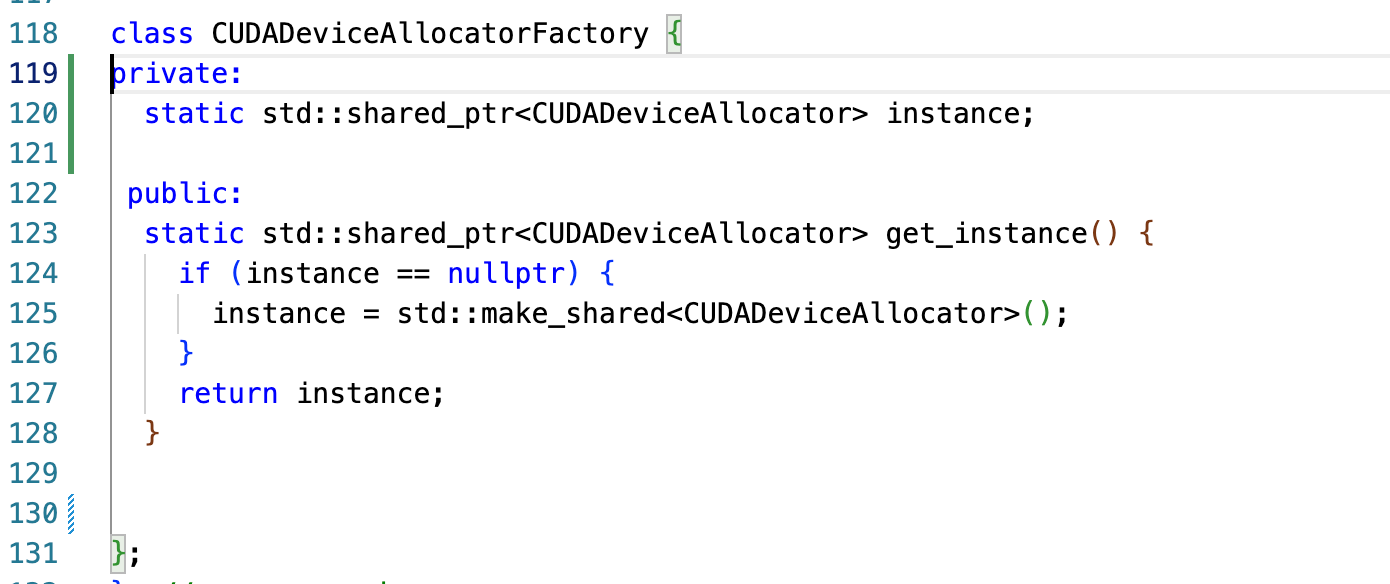
- 可以看到,工厂函数类对象,维护者一个静态的真实的gpu内存分配器指针,instance这个共享内存指针,永远指向一个gpu内存分配器。
- 之后所有申请gpu内存分配器,就是用auto cu_alloc来指向这个gpu内存分配器的对象,增加了引用计数。这也是RALL的思想。
- 分配器开辟gpu内存
- 分配器拷贝内存
- 绑定该内存
3. op/算子层
层的概念复习
前面我们已经构造好了整个框架层base/, 里面实现了:
- 内存的分配,内存的抽象
之后,我们又在tensor张量层,来基于buffer层,实现了张量。
现在我们要开始实现深度学习里面最经常用到的组件:层,他表示一种运算,输入张量,得到另一个张量。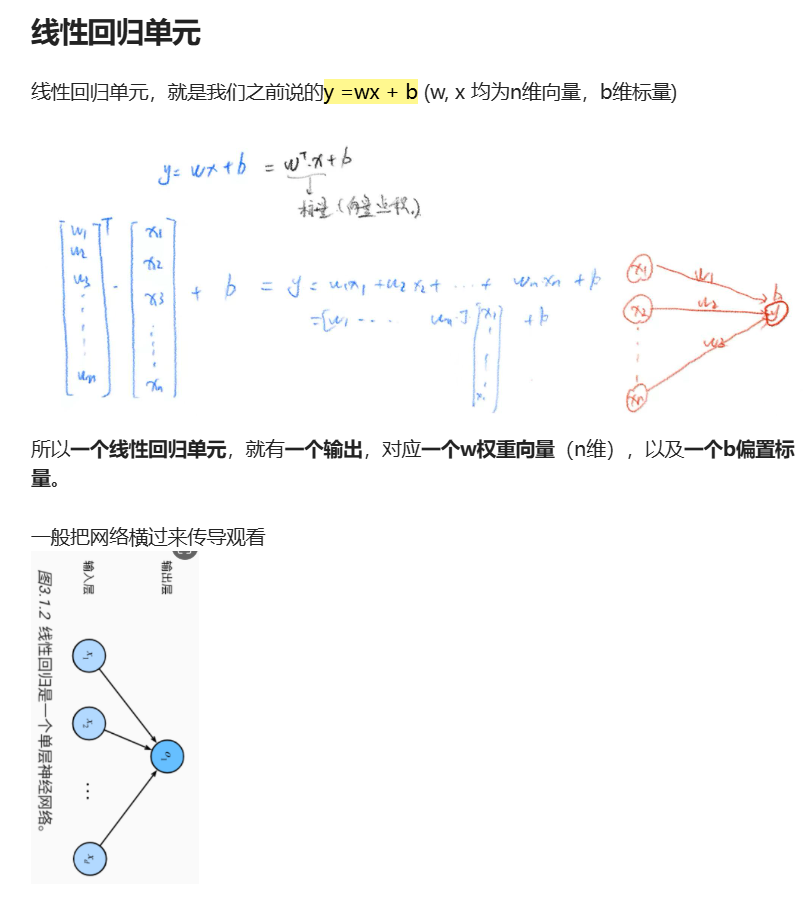
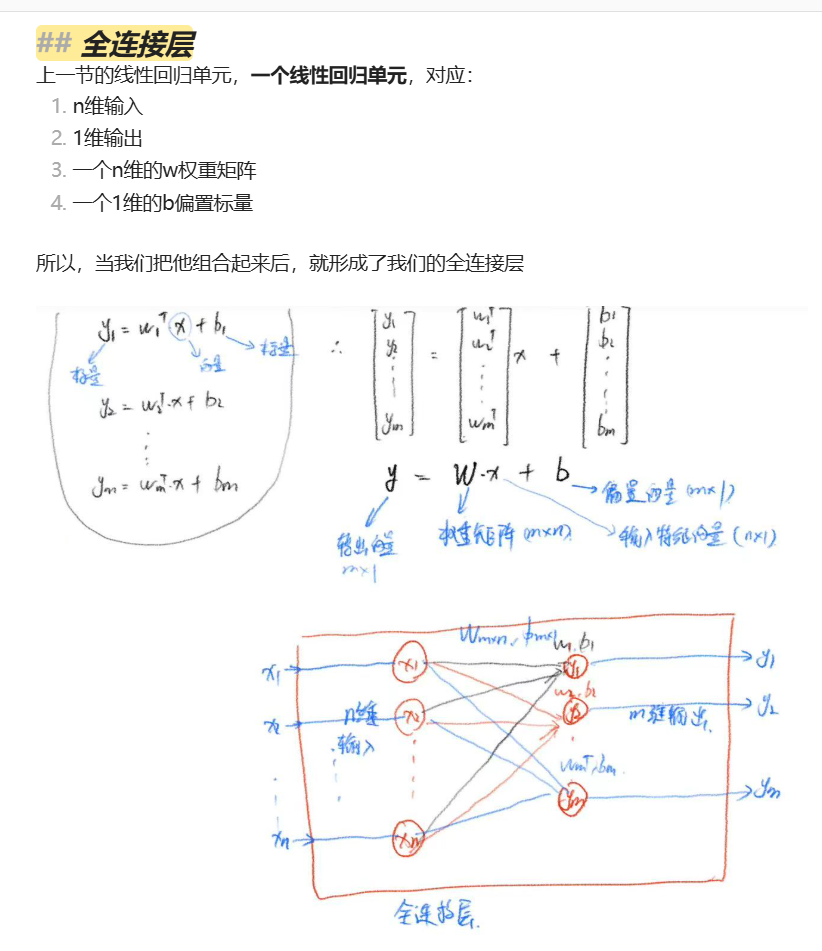
所以我们就要实现一个层 类,来抽象这个针对张量的运算过程的概念。
算子层op/的总体架构
所以op/算子层,这里主要有这几个部分:
- layer,层接口层
- 主要作为前端实现,确定好:
- 输入张量组
- 输出张量组
- 权重张量组
- 主要作为前端实现,确定好:
- 后端接口层:kernel_interface
- 利用函数指针,重定向具体的后端实现
- op, 后端实现forward(), 拿数据进行具体的计算
op/add.h .cppop/linear.h .cppop/matmul.h .cpp- 各种具体的层的运算实现
所以,至此,我们的大模型推理框架的整个结构是: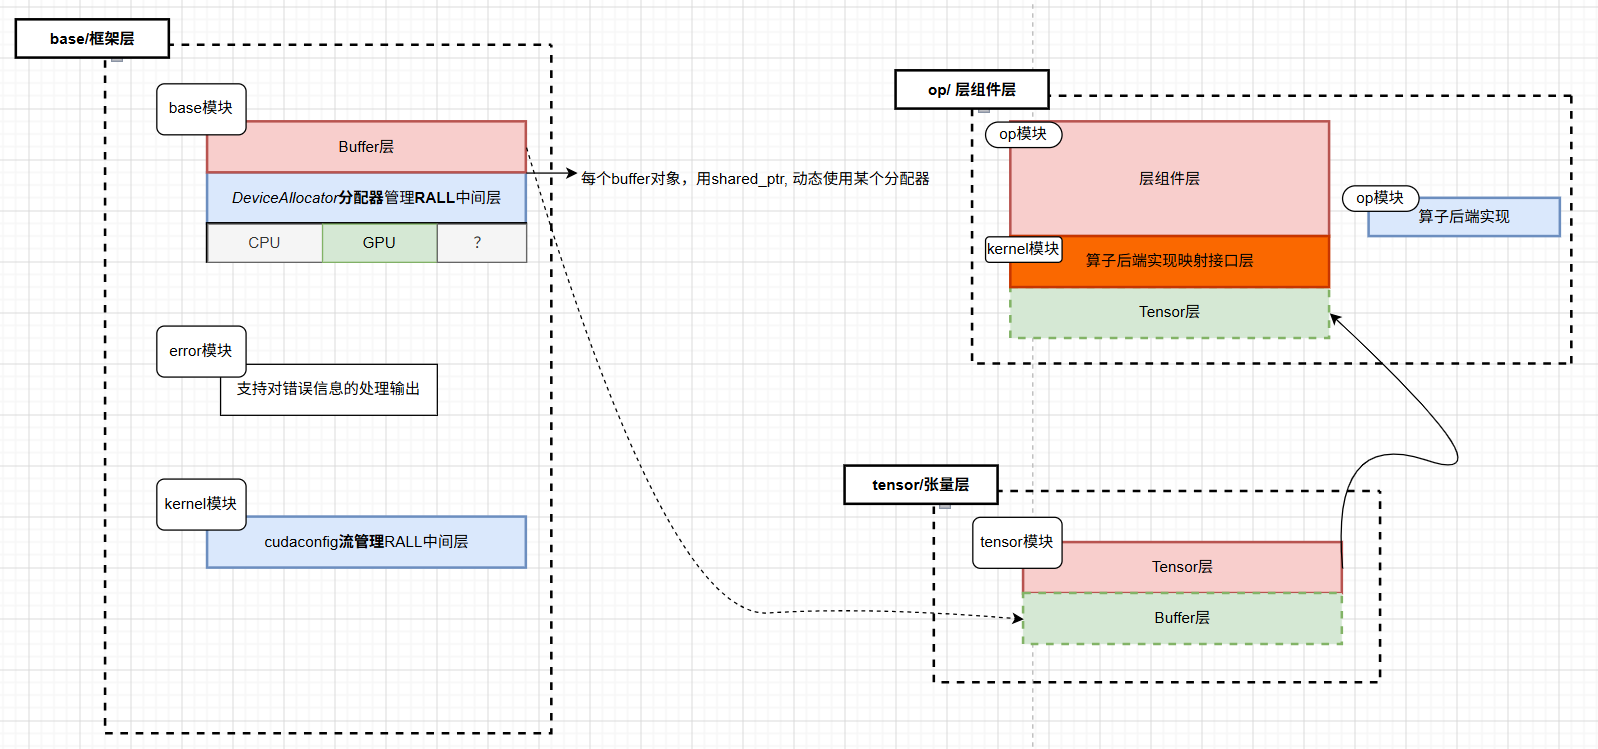
根据前面,我们得知了
层组件层 (y = f(x) 的前端结构)
首先是层组件层:
- BaseLayer类(层的固有属性)
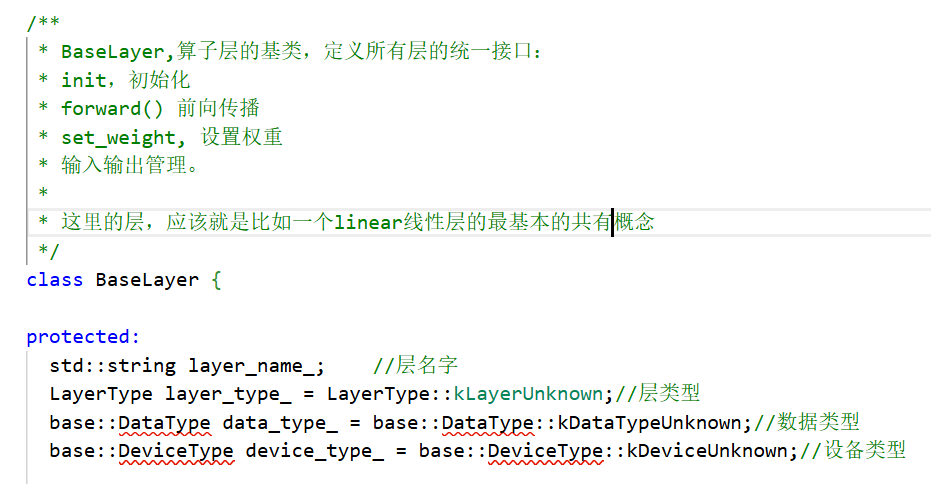
Layer类,(层的固有属性+输入输出张量)
LayerParam类(层的固有属性+输入输出张量+权重张量)
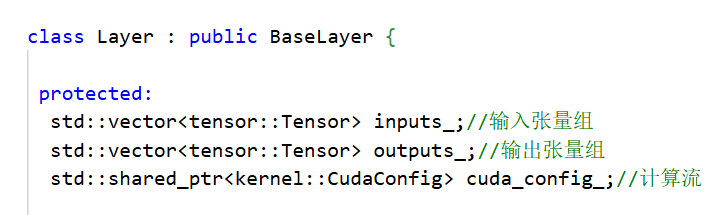
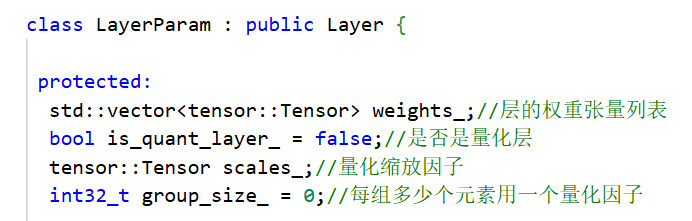
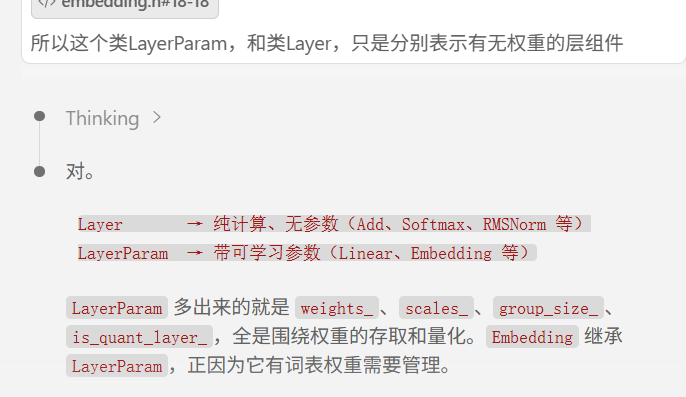
上面这个是第一部分,主要定义了一个层组件层,这样一个中间层,实现了张量-张量的层运算的抽象过程。
内部的具体逻辑没有,只有形式, 就相当于实现了y = f(x) ,这样一个前端框架,但是f(x)的具体后端实现并没有定义,只是通过forward()这个基类的虚函数,在**子类(算子)中实现。
在这个中间层的基础上,我们:
- 在上方构建算子层(实现各个算子)
- 各个算子的后端实现,forward(),依赖后端算子内核接口层返回具体的内核方法
- cpu后端内核实现
- cuda后端内核实现
- 各个算子的后端实现,forward(),依赖后端算子内核接口层返回具体的内核方法
- 在下方依赖于Tensor层
后端内核接口层(kernel_interface)
这里就是前端连接后端的接口层。通过这一层的方法,自动判断使用哪个后端内核。
定义各种算子的后端内核方法的函数指针接口
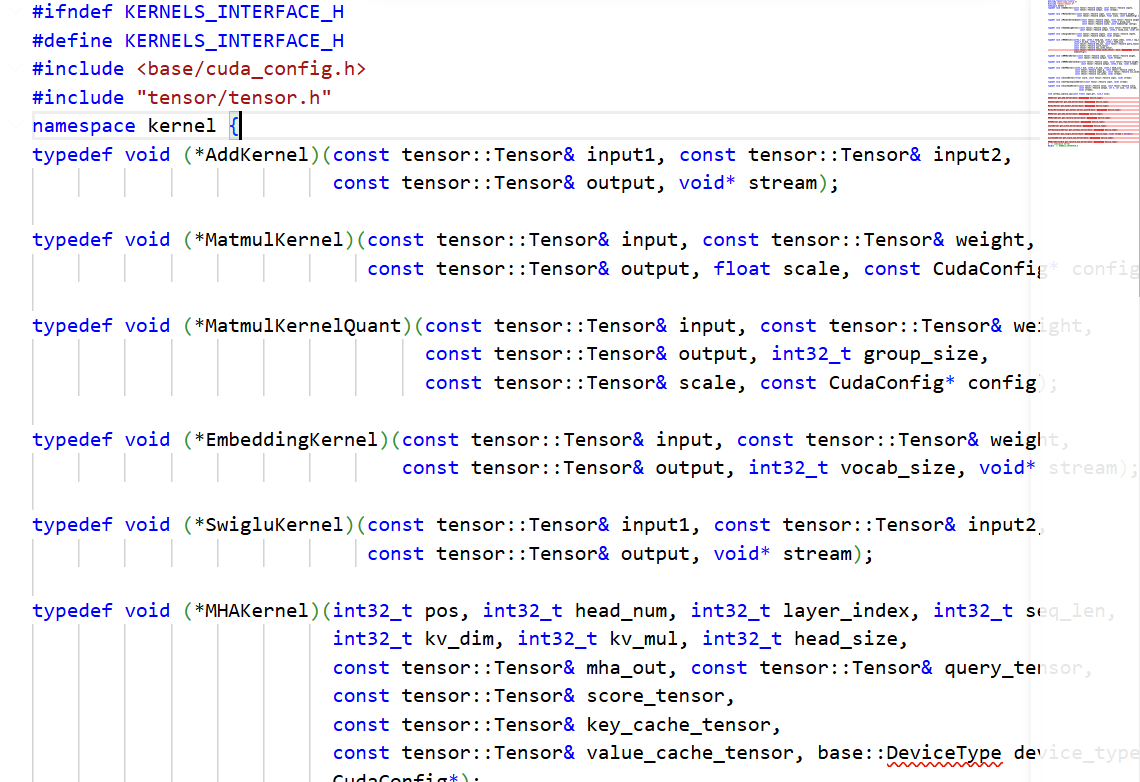
提供返回函数指针的方法, 提供自动索引后端内核
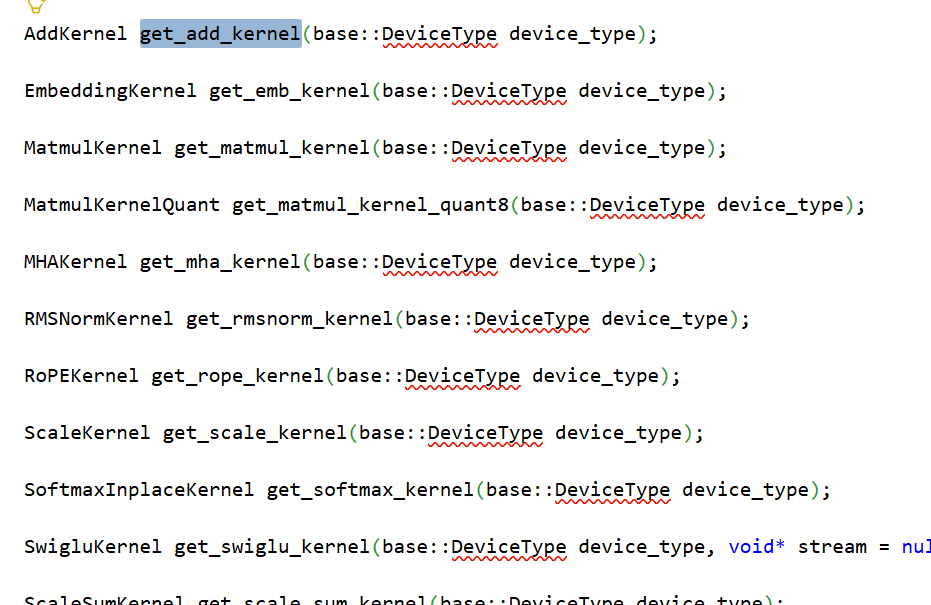
具体返回的后端内核,涉及了
cpu/add_kernel.h和cuda/add_kernel.cuh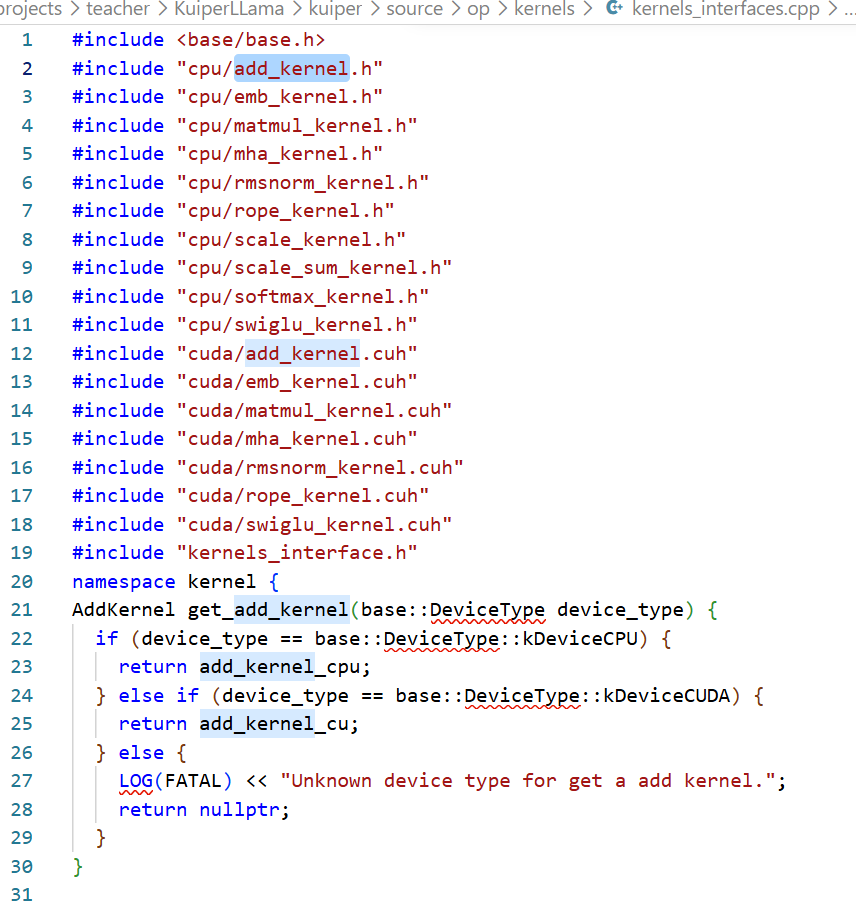
具体算子层( f()的真正实现 )
这一层,就是基于前面两个层,创建各个算子的抽象类,继承Layer层,让不同算子类都是继承的层的概念。并重写各自的forward()
因此,通过调用每个算子类对象的forward(),即可调用真正的后端算子内核实现。
下面以add_kernel为例:
- 定义加法算子:
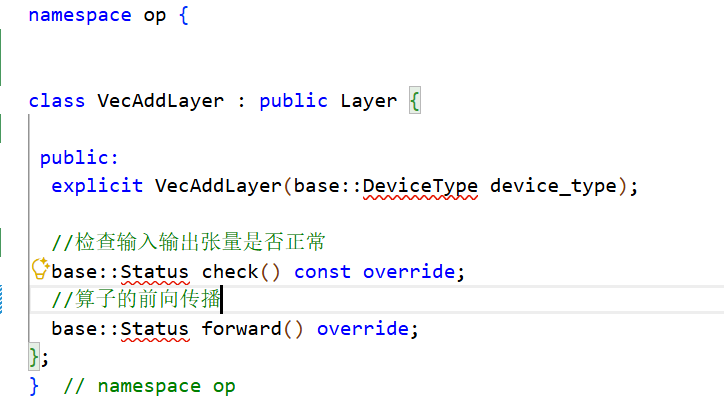
- 算子方法实现:
- 设定算子的输入输出
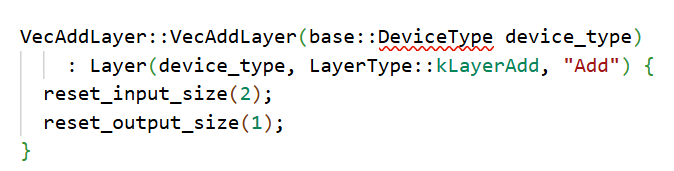
- 实现前向传播forward
- 设定算子的输入输出
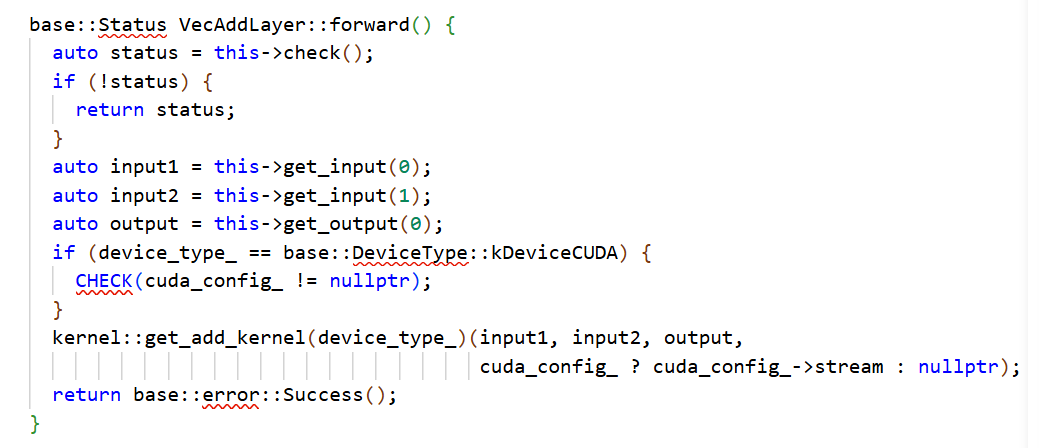
可以看到,f()的实现里面,调用了后端内核接口层的get_add_kernel方法,来返回一个根据设备类型而选择的后端内核
kernel::get_add_kernel(device_type_) = AddKernel
kernel::get_add_kernel(device_type_)(input1, input2, output, cuda_config_ ? cuda_config_->stream : nullptr);
= Addkernel(......)
从而在forward()里面实现调用对应的内核接口
cpu端内核
- 首先进行一系列对输入输出的检查
- 计算得出结果(利用armadillo库,这个是c++的线性代数库)
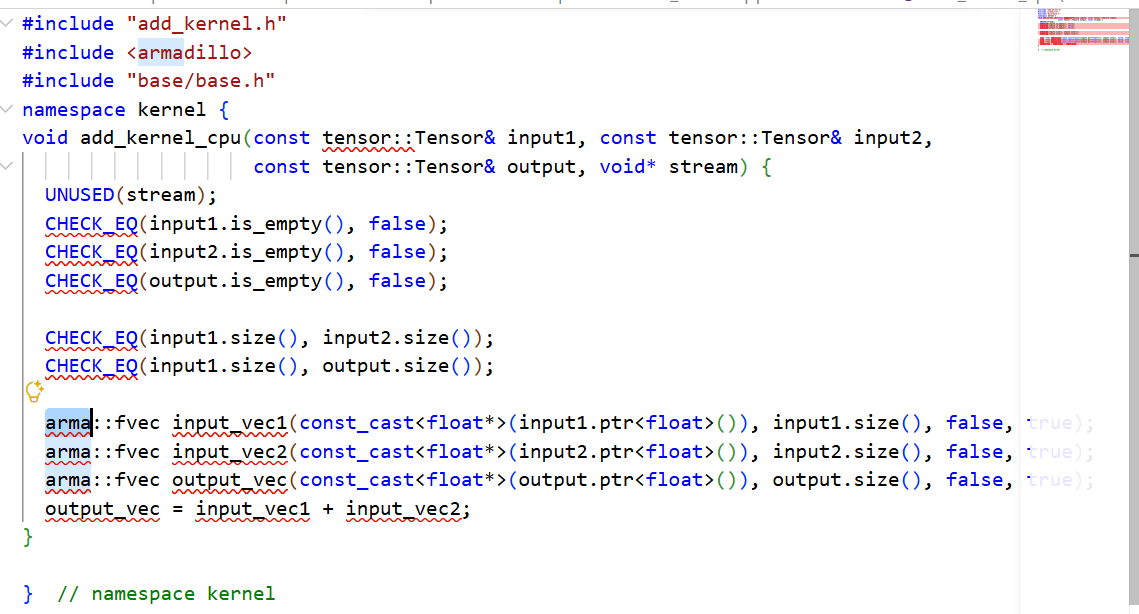
cuda端内核
- 对输入输出进行检查
- 实现后端主函数,调用核函数
- 实现后端核函数
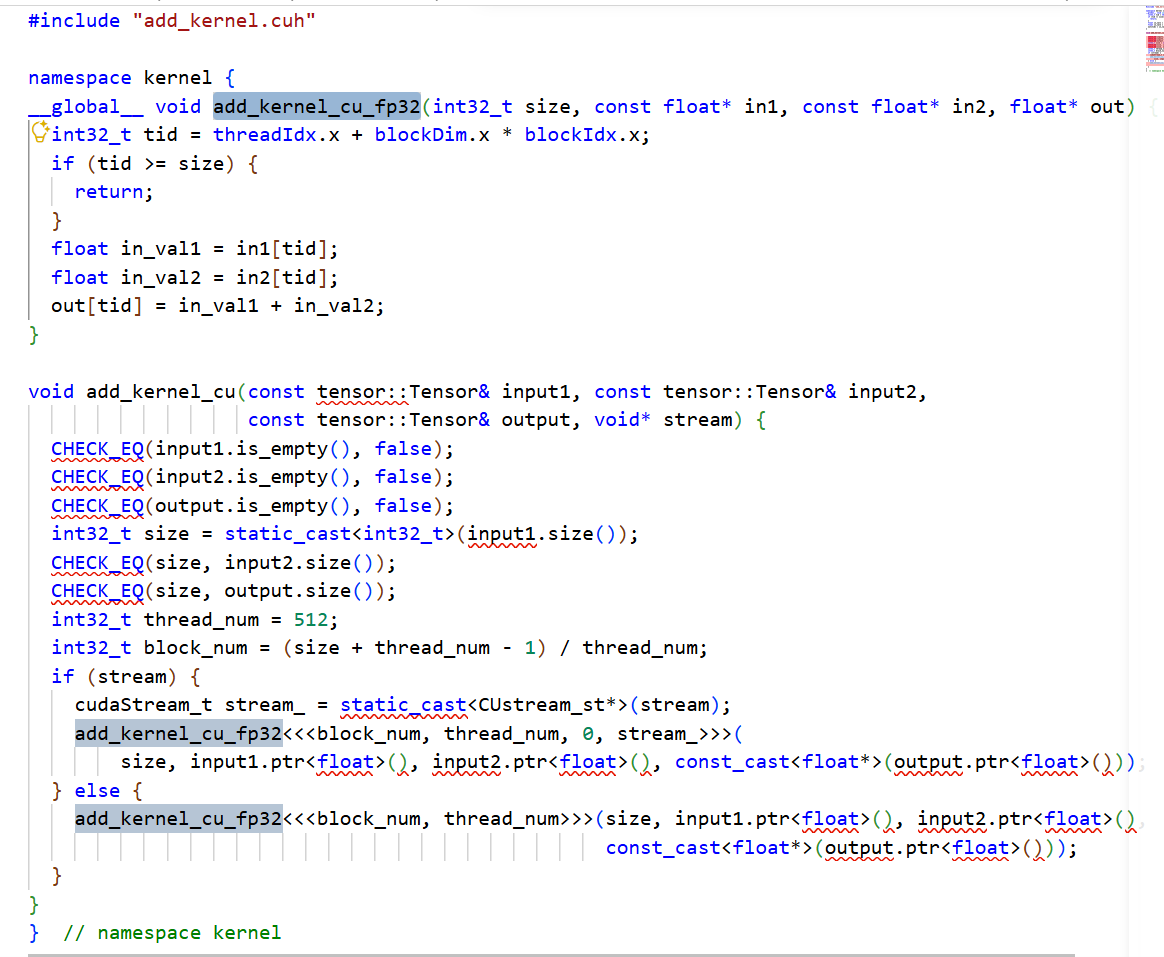
算子输入规划策略
我想知道,我们的这个cuda算子,我们的算子cu实现是肯定不知道,处理的输入数据是多大的,
我看我目前的add算子,是固定设置好了block_size的大小,然后grid_size根据实际输入的数据大小来定的,但是我目前的add算子是朴素实现,一个thread处理一个元素输出。
但是如果后续优化的话,比如SGEMM,可能就会有thread_tile, warp_tile等优化策略,这就导致,我们一个thread处理多个元素。 那么这样的话,如果我写这样的优化算子的话,那么还是一样的吗?
比如,我默认想好使用这种优化手段,所以一个thread对应x个元素,所以设置一个block_size = 256这样,然后我再根据输入的大小来动态计算grid_size吗?
对,核心逻辑完全一样,只是 grid_size 的计算公式里要多除一个系数。
朴素实现(你现在的 add):1 thread = 1 element
grid_size = ceil(size / block_size); |
线程平铺优化(比如 thread_tile = 4):1 thread = 4 elements
size_t block_size = 256; // 还是固定 |
SGEMM 那种更复杂的(有 warp_tile),也是同样模式,只是分得更细:
total_tiles = (M * N) / (thread_tile * warp_tile) |
本质上就是:
block_size 永远是固定的(硬件友好常量),grid_size 永远是根据数据量动态算出来的,只是”一个 thread block 能做多少工作”的计算公式变了。
你用固定 block_size + 动态 grid_size 这个模式是对的,不管怎么优化都适用。
那block_size,要怎么确定呢?是根据SM上的寄存器数量以及共享内存的大小,考虑到一个thread负责多少个数据,来推导出来的?一般是多少?
对,block_size 的确定就是这几个因素互相制约:
核心公式(任何一个 SM 上):
MaxWarps × WarpSize = min( |
具体推演,拿常见的架构举例:
一个寄存器,4 字节。GPU 寄存器是 32 位的,正好装一个
float或int32_t
| 架构 | SM 寄存器数 | 最大线程/block | 共享内存/SM |
|---|---|---|---|
| V100 (SM70) | 65536 | 1024 | 96KB |
| A100 (SM80) | 65536 | 1024 | 164KB |
假设你的 kernel 每个线程用 32 个寄存器:
RegistersPerBlock = max(65536 / 32, 1024) = 1024 threads // 寄存器够用,卡在硬件上限 |
假设用了 48KB 共享内存/block:
SharedMemPerBlock = max(164KB / 48KB, ...) = 3 blocks/SM // 共享内存卡住并行 |
实际情况中最常见的 block_size:
| block_size | 原因 |
|---|---|
| 256 | 最常用,8 个 warp,寄存器/共享内存均衡,适用大多数 kernel |
| 128 | 寄存器用量高的时候(每个 thread 算得多),让更多 block 并行 |
| 512 | 轻量 kernel(寄存器少,共享内存少),最大化 occupancy |
| 1024 | 几乎没寄存器压力的极轻 kernel,跑满硬件限制 |
你的情况: 你用的是 512,对朴素 add 完全合适——一个 thread 只做一次 load + add + store,寄存器压力极小,共享内存也没有,往大了设没问题。
建议: 一般 128 或 256 作为默认值就够,具体调哪个可以在 kernel 测试的时候调一下看看哪个快,这东西理论推导只能给出范围,最终还是跑 profile 说话。
3.2 大模型算子内容介绍
先复习一下我们的decoder-only的transoformer的整个架构
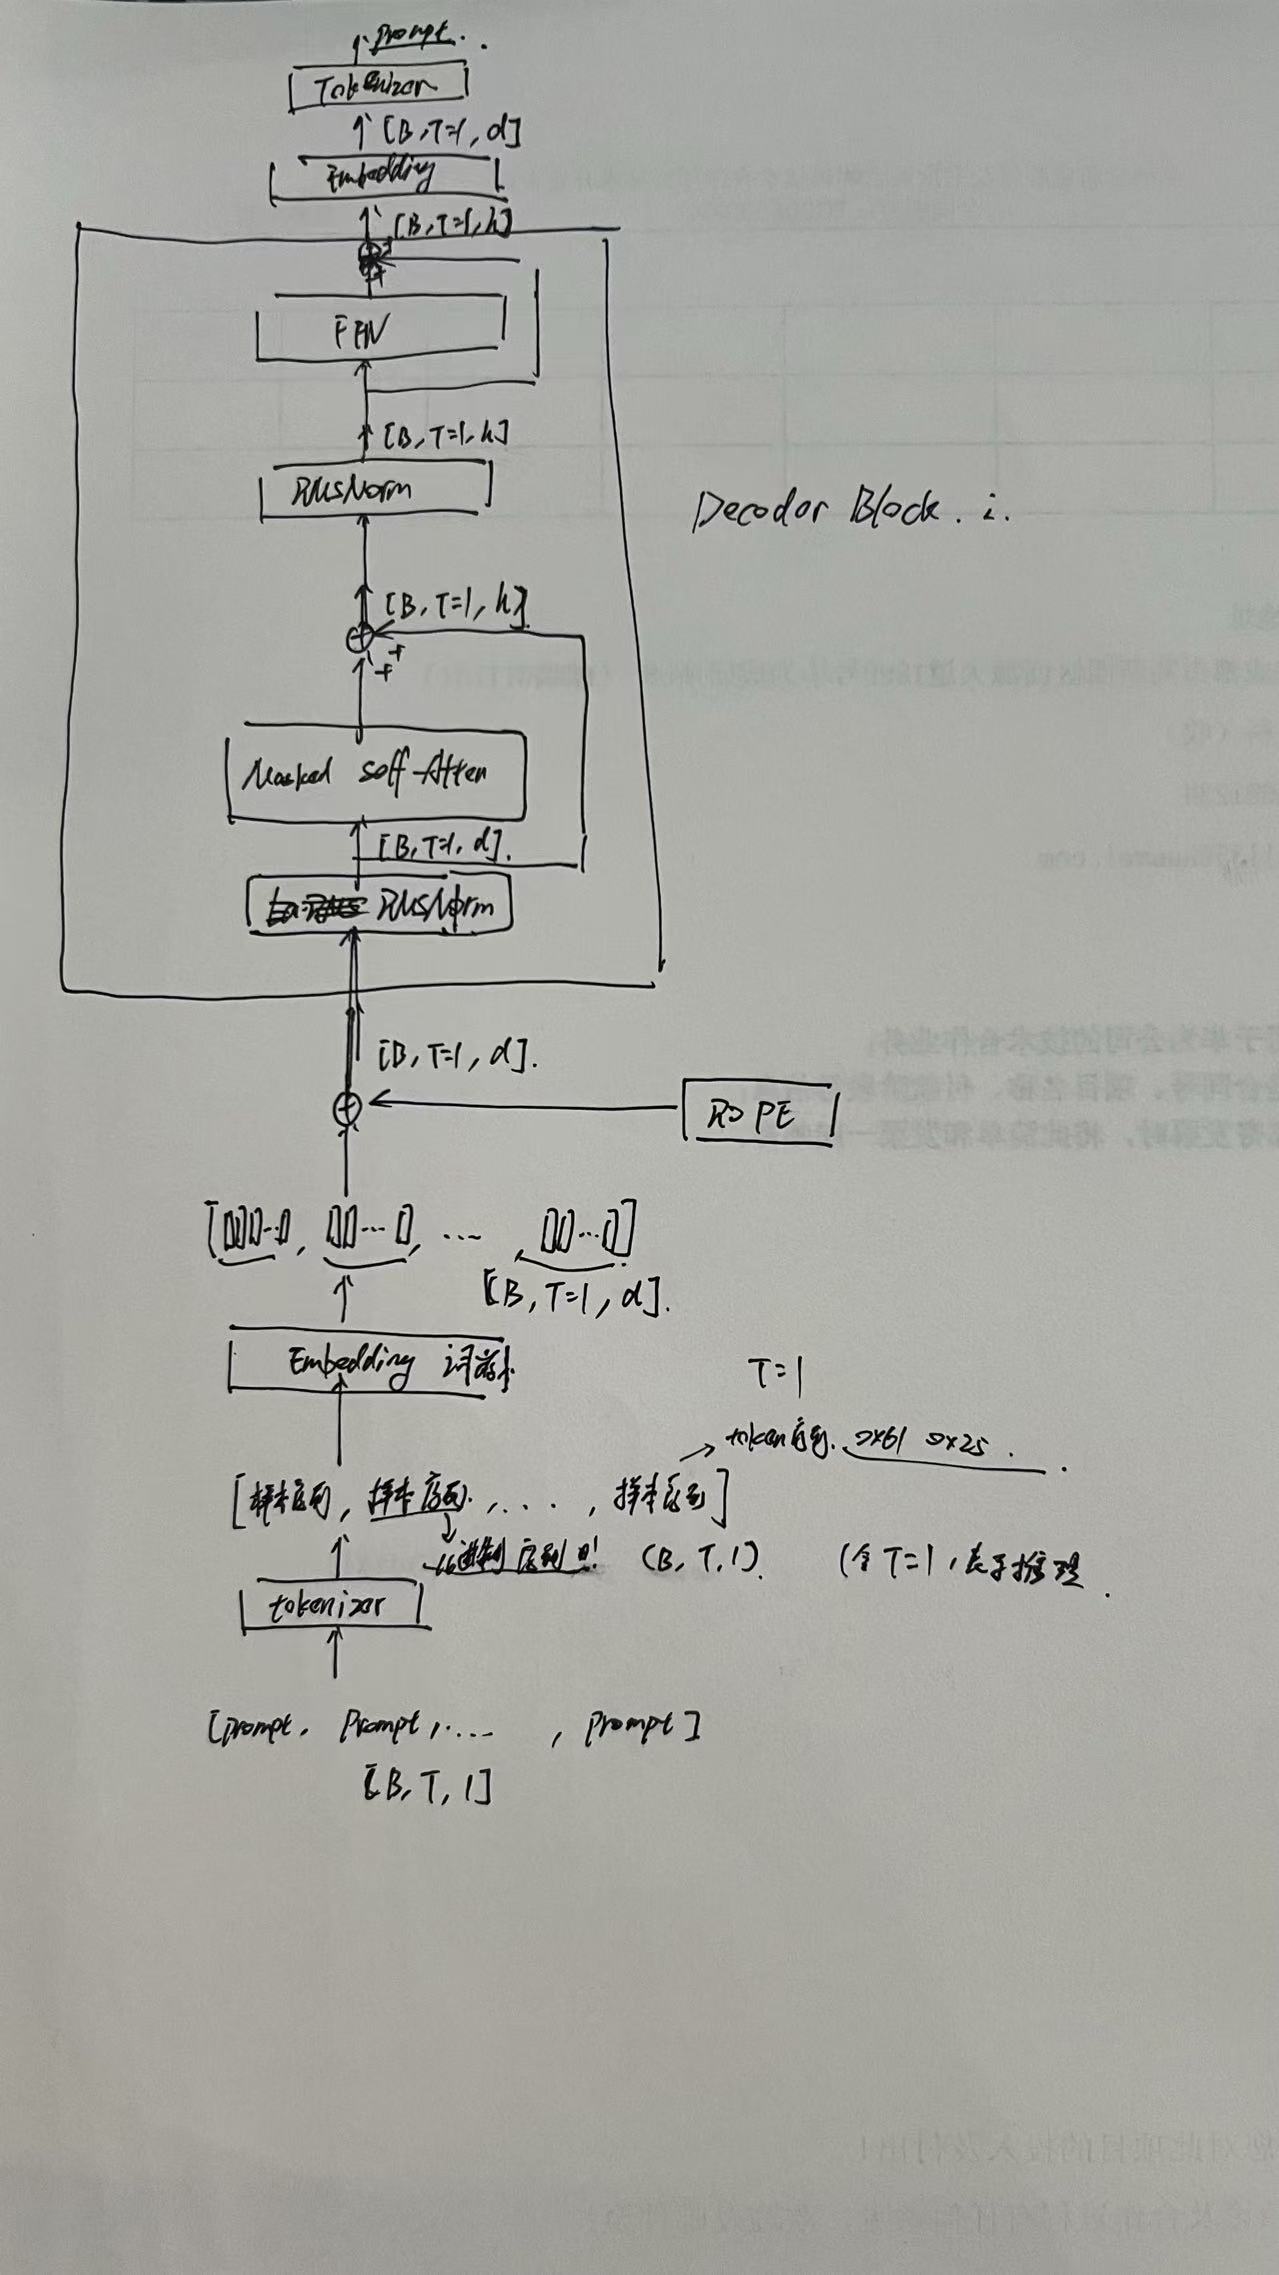
下面逐个看一下各个算子的实现,看看各个算子实际的输入输出是什么
encode 分词编码器层
这个就是一个单纯的无参翻译层算子,
- 给一个词串,他就翻译成一个token id的数组
- 给一个词,就翻译成单个token
所以 encode("hello world") 的过程是:
"hello world" |
embedding 词嵌入层 (有参)
我们一个token,经过encode层之后,获得的是这个token在vocab词袋中的索引id, 这样我们其实可以得到的是最原始的一个编码:one-hot编码
比如token id = 2, 用one-hot编码表示就是
[0,0,1,0,0,……………………………………………………………………………..,0]
但是用这样一个vocab_size( = 36000)的维度的编码太长了,没必要,所以就需要embedding层,来把他映射压缩到一个较低维度的编码比如4096,这就是词嵌入
由于one-hot编码的特性,本质上就变成了,对embedding层的权重矩阵的查表。
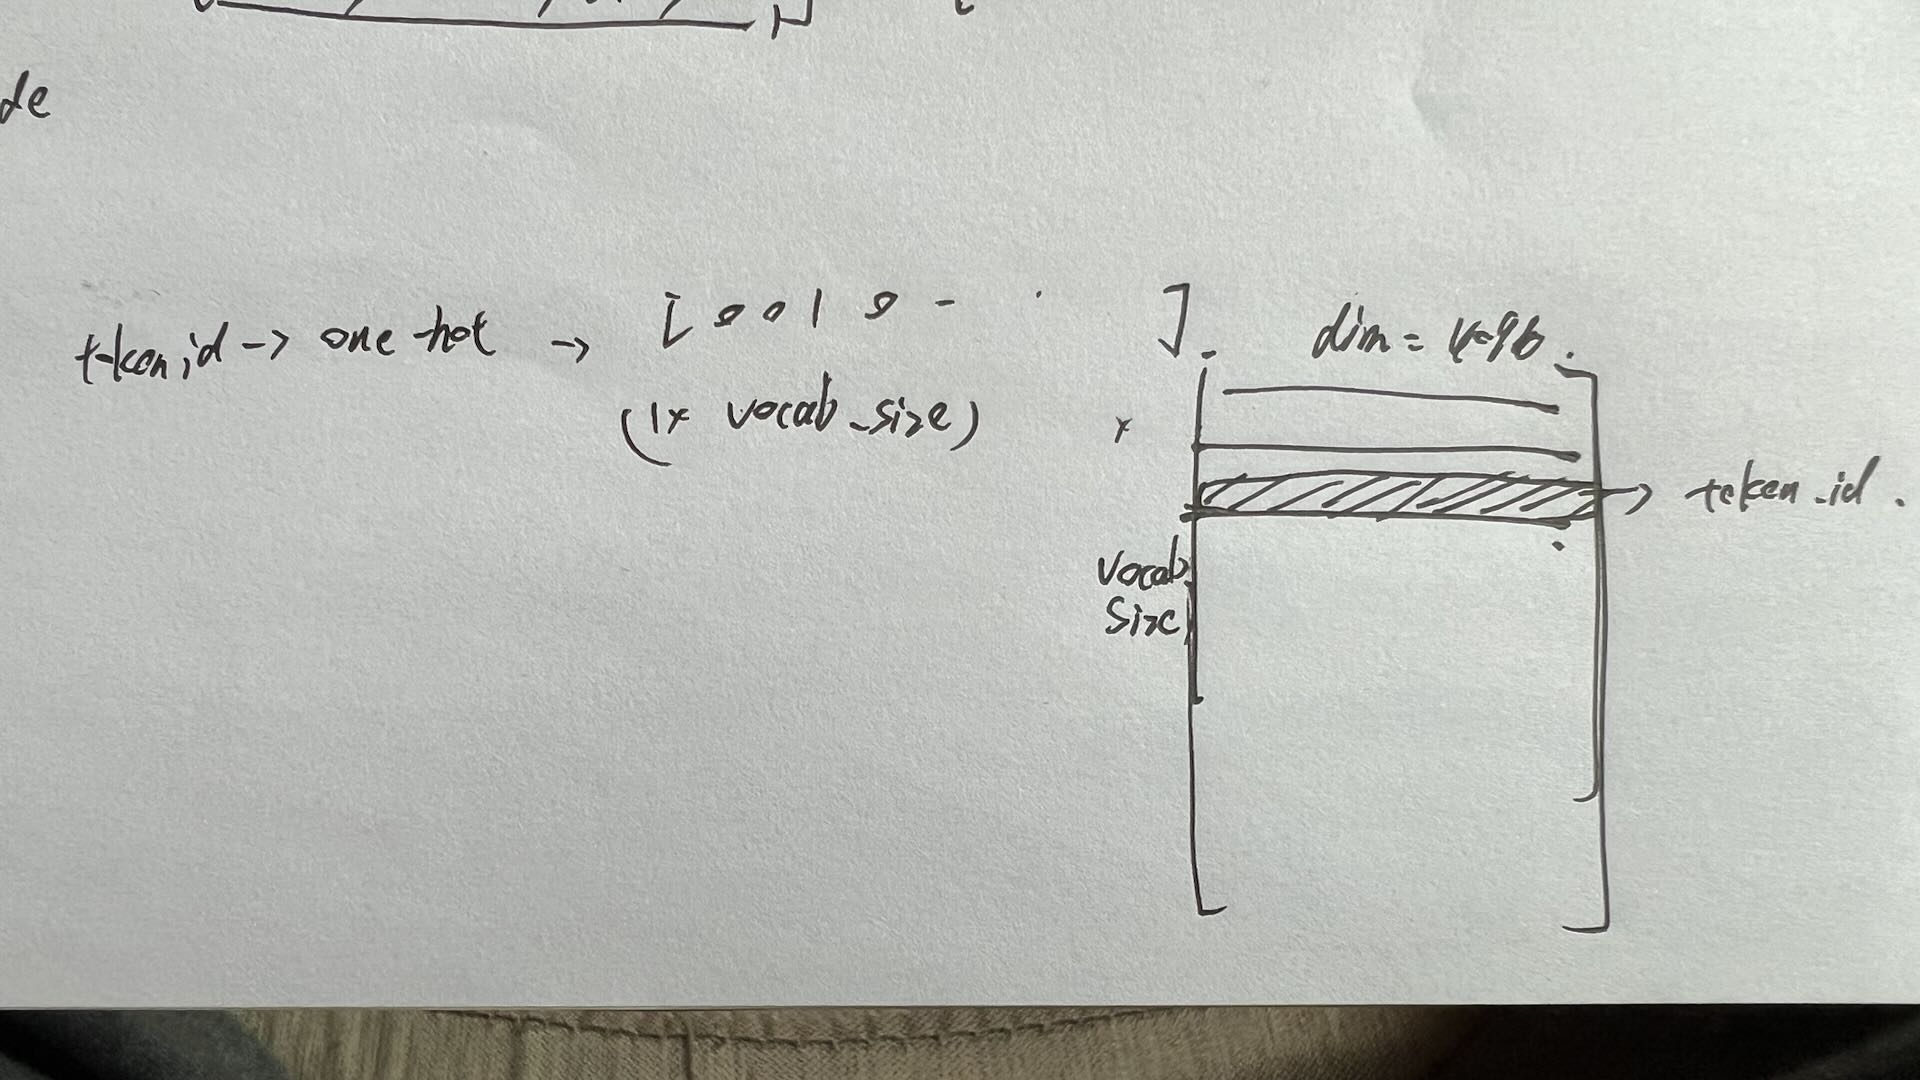
这个权重矩阵,也就是embedding层的参数,是训练出来的,模型在训练过程中,自己学会压缩token向量的维度
one-hot: token "Ġhello" → [0,0,1,0,0,...,0] 32000 维稀疏向量(只有一个 1) |
本质就是降维 + 语义化:
- one-hot 只是编号,
id=2和id=3在向量空间里等距,没有意义 - embedding 让”语义相近的词在向量空间里也近” — “hello” 和 “hi” 的 embedding 向量很接近,这是训练过程中自己学出来的
所以 embedding 层 = 一个 vocab_size × dim 的大矩阵,训练帮每个 token 学到了一个”好的”低维表示。
所以embedding层输出的一个token向量,是一个dim维度的向量,这个dim维度的向量空间V,就是一个语义空间。
我们这就实现了从一个token词,到语义空间的投射。
rmsnorm 归一化层(有参)
这里先捋一下这部分的实际大模型用的一个顺序
embedding 输出 (1×4096) |
所以,decode阶段,当来了一个新的token 从embedding层出来,是一个新的token 向量,
然后进入decoder block的第一个算子层是RMSNorm层,他是一个有参层
这个RMSNorm层,属于层归一化LayerNorm的优化版本
原来LayerNorm,对每个token向量的处理: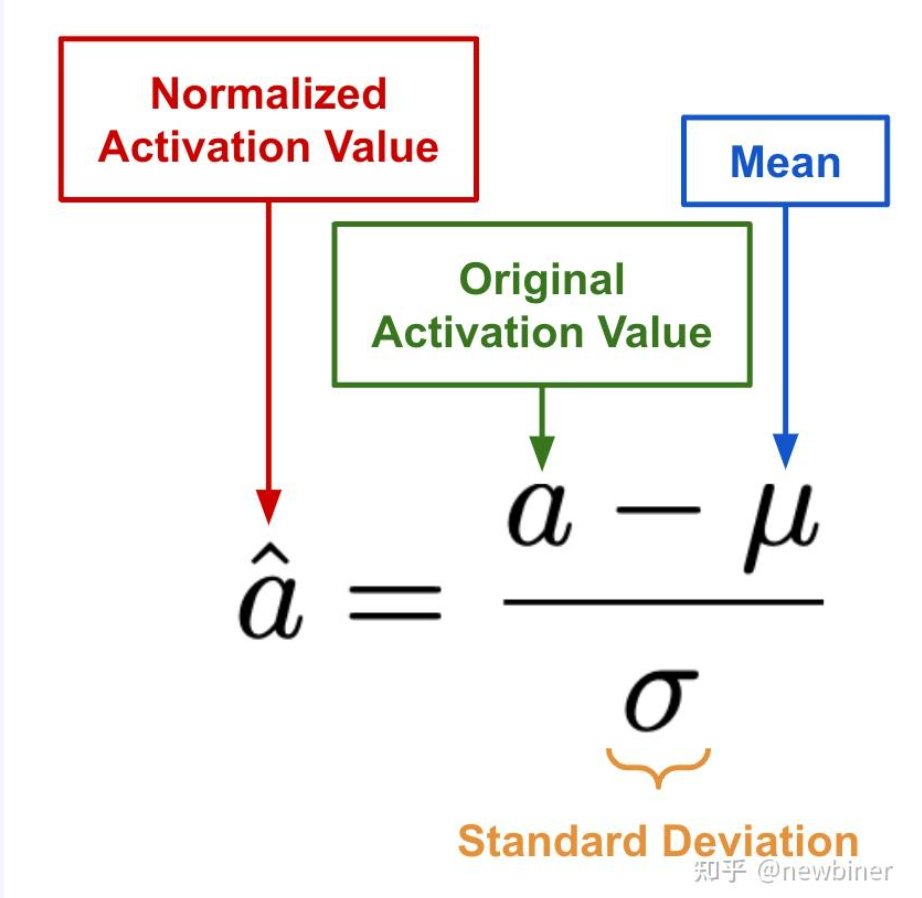
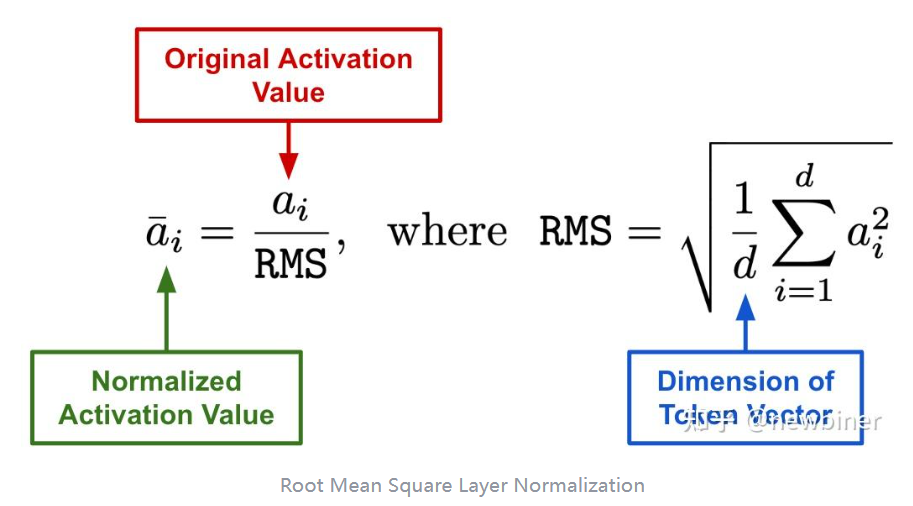
所以RMSNorm对一个向量的公式是:
RMSNorm(x_i) = (x_i / RMS(x)) × γ_i |
γ 做的事就是”这个维度重要就放大,不重要就缩小”
归一化后: [0.01, -0.5, 0.3, ..., -0.02] 每个值都在 [-1,1] 附近 |
让模型自己学会”哪些维度该放大、哪些该缩小”。
归一化把所有维度压到同一个量级,这很粗暴 — 有些语义特征可能需要更大的变化幅度。γ 就是给模型留下自由度:
假设 dim 3 编码"名词/动词"信息 → 训练后 γ₃ = 1.5(放大,让这个特征更突出) |
如果只有归一化没有 γ,相当于强制 γ = [1, 1, 1, …, 1],模型就失去了调节每个维度表达力的能力,这也是为什么纯归一化(无参)之后表现会显著下降。
简单说:归一化负责稳定数值(别让梯度炸了),γ 负责保留表达能力(别把有用信息也压没了)
但是,这里的RMSNorm,虽然也有微调每个token的维度的能力,但是本质上是为了稳定,而真正的表达,是依赖后续的matmul算子的权重张量来负责的。
RMSNorm × γ (dim 个参数) → 纯缩放,调节数值范围 |
γ 就是个”量级微调”,给归一化留一点点灵活性。真正把向量从”被归一化压平的”变成”包含丰富语义的”,靠的是后面 dim × dim 的权重矩阵。
换个角度看:RMSNorm 在每个 block 里出现两次,后面永远紧跟着至少一个 dim × dim 的矩阵乘法。如果你觉得某个维度被归一化后变弱了,那后面那个矩阵完全可以学出对应的补偿 —— 但 γ 可以让这个补偿更直接、训练更稳定。
实际上有研究试过把 γ 固定为全 1(DynamicsNorm),性能差不太多。所以你说得对,它的调节能力确实有限,但这正是它的设计意图 — 别抢权重矩阵的活
Matmul 矩阵乘算子层(有参)
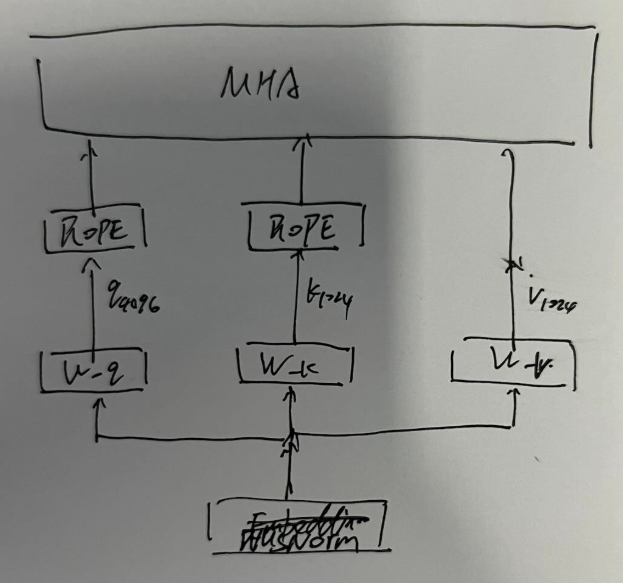
经过embedding后得到的是token向量[4096], 之后会复制3份,分别经过,Wq,Wk,Wv 矩阵乘的算子层,来计算得到我们的Q向量[4096],K向量[1024],V向量[1024]。
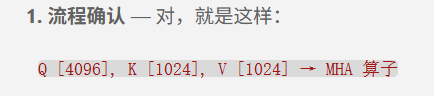
那么既然embedding已经把token投影到语义空间了,qkv的投影矩阵的投影,又是什么意义呢?
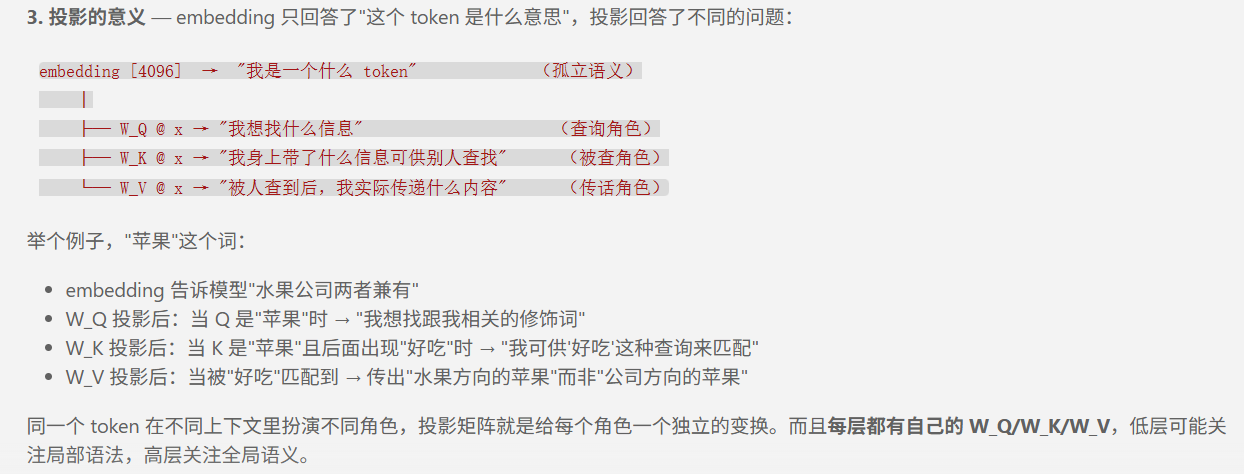
以上解释了,我们矩阵乘Wq,Wk,Wv三个算子层的作用,下面来解释为什么
- q是4096
- k是1024
- v是1024
我的问题现在集中在,为什么token向量是4096,q仍然是4096,而kv则是1024,就是单纯的为了省kvcache吗?kv压缩了维度,不会对模型理解语义效果有什么影响吗
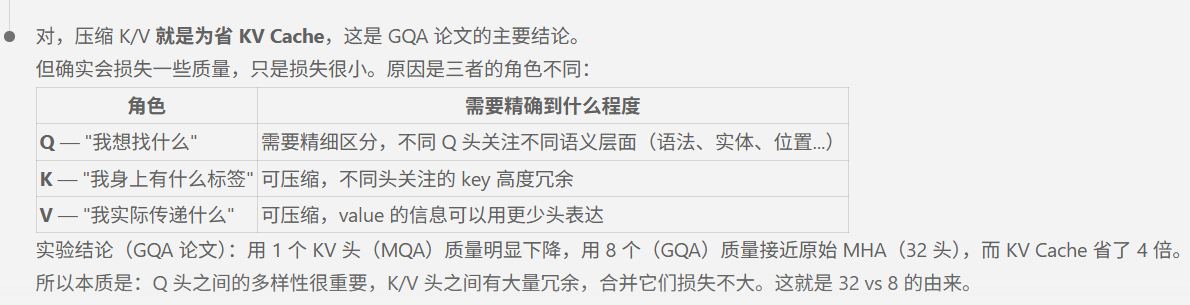
所以原因就是k,v的各个头之间是冗余的,所以可以压缩,就投影到1024,而不是4096.
下面来解释多头的概念。
所谓多头,其实就是去切分q,k,v的这么长的向量,不同分块sub就是一个头。
以llama3为例,
- k,v 1024维度,切分8个头,每个头128维
- q,4096维度,切分32个头,每个头128维
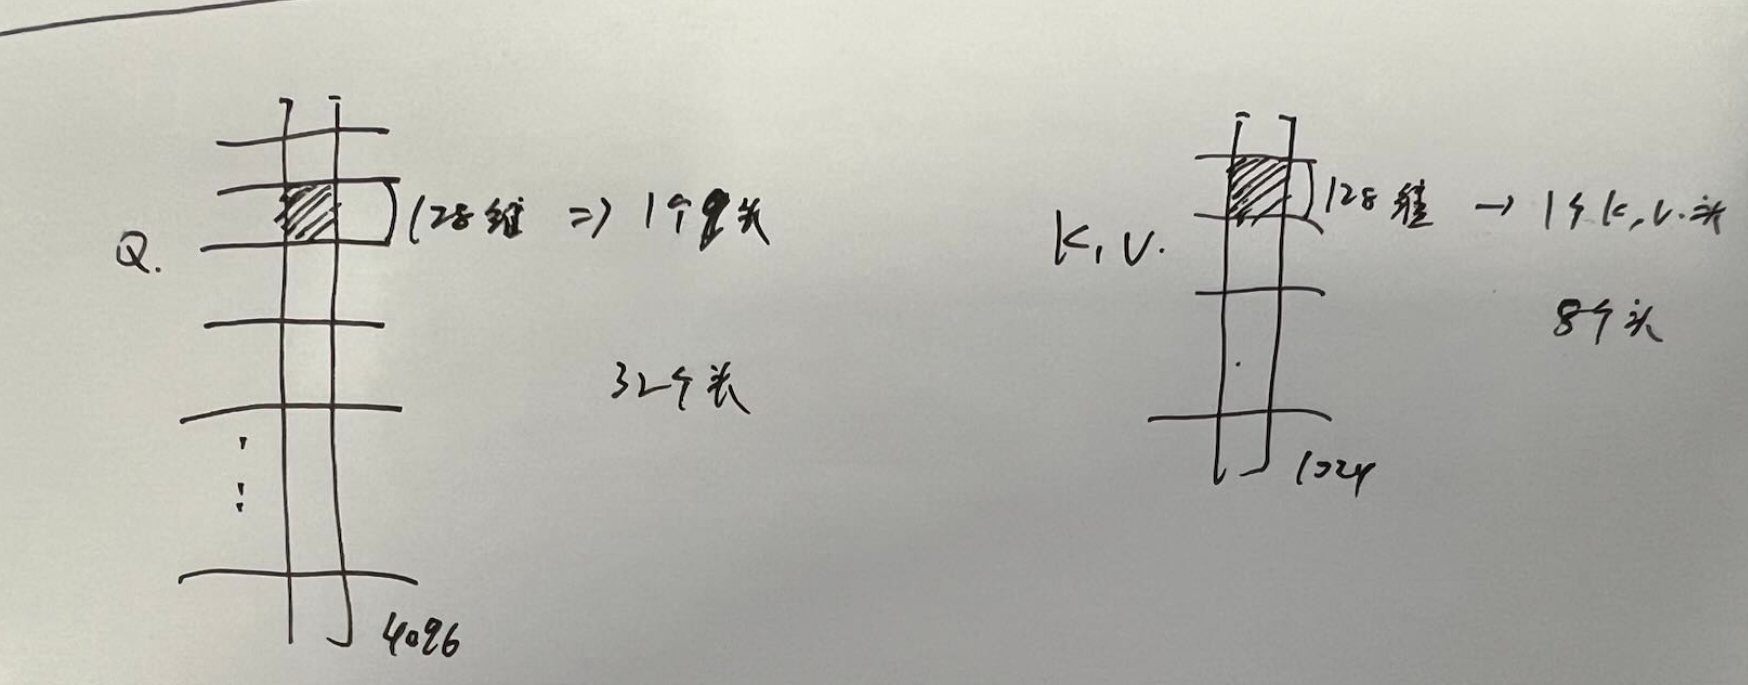
在标准的transformer论文里面,W_Q/W_K/W_V 确实属于 Attention 的一部分。但在这个项目里被拆开了。
多头方案
在接着往下之前,先分析几个多头方案
本质上解决的就是两个头数不同的向量怎么做点积:
MHA
q,k,v都是一个维度,4096维度,切分32个头,每个头一一对应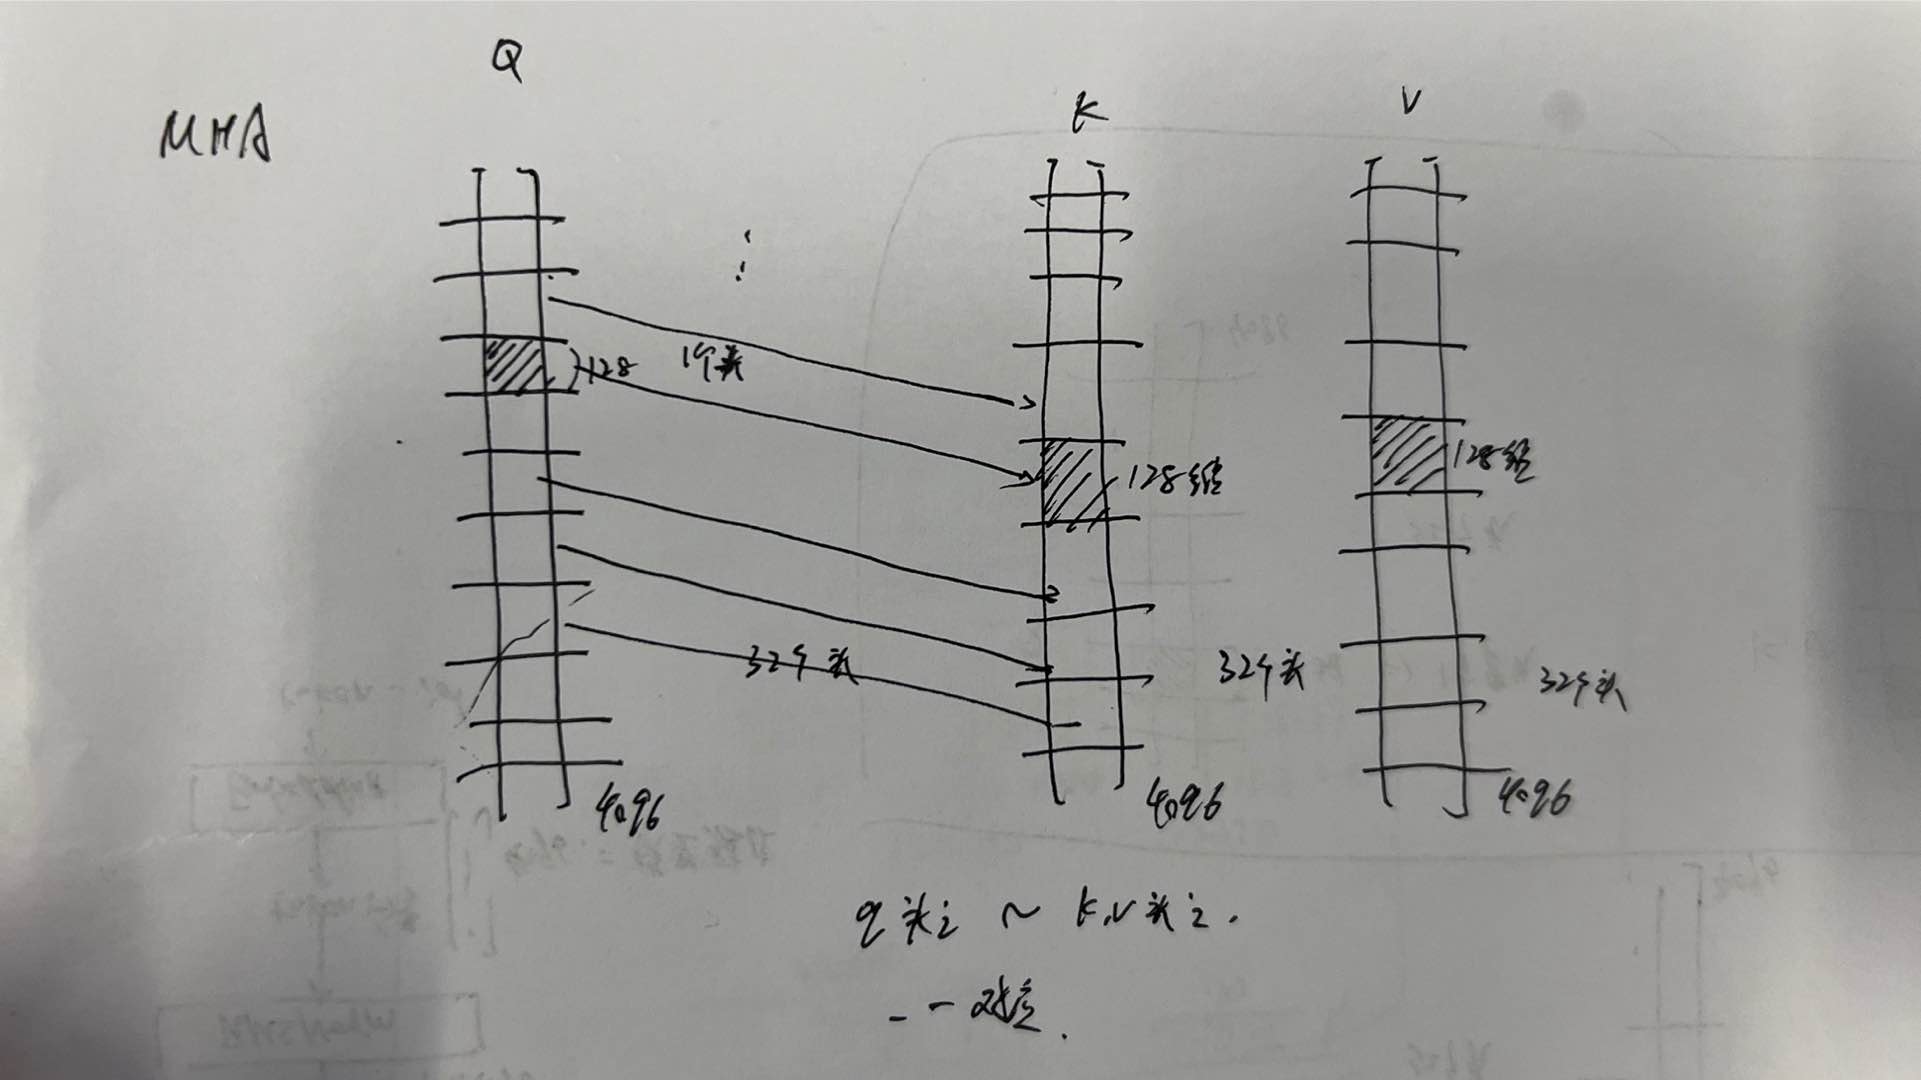
MQA
特点是,k,v向量,被极端压缩,就压成一个头的大小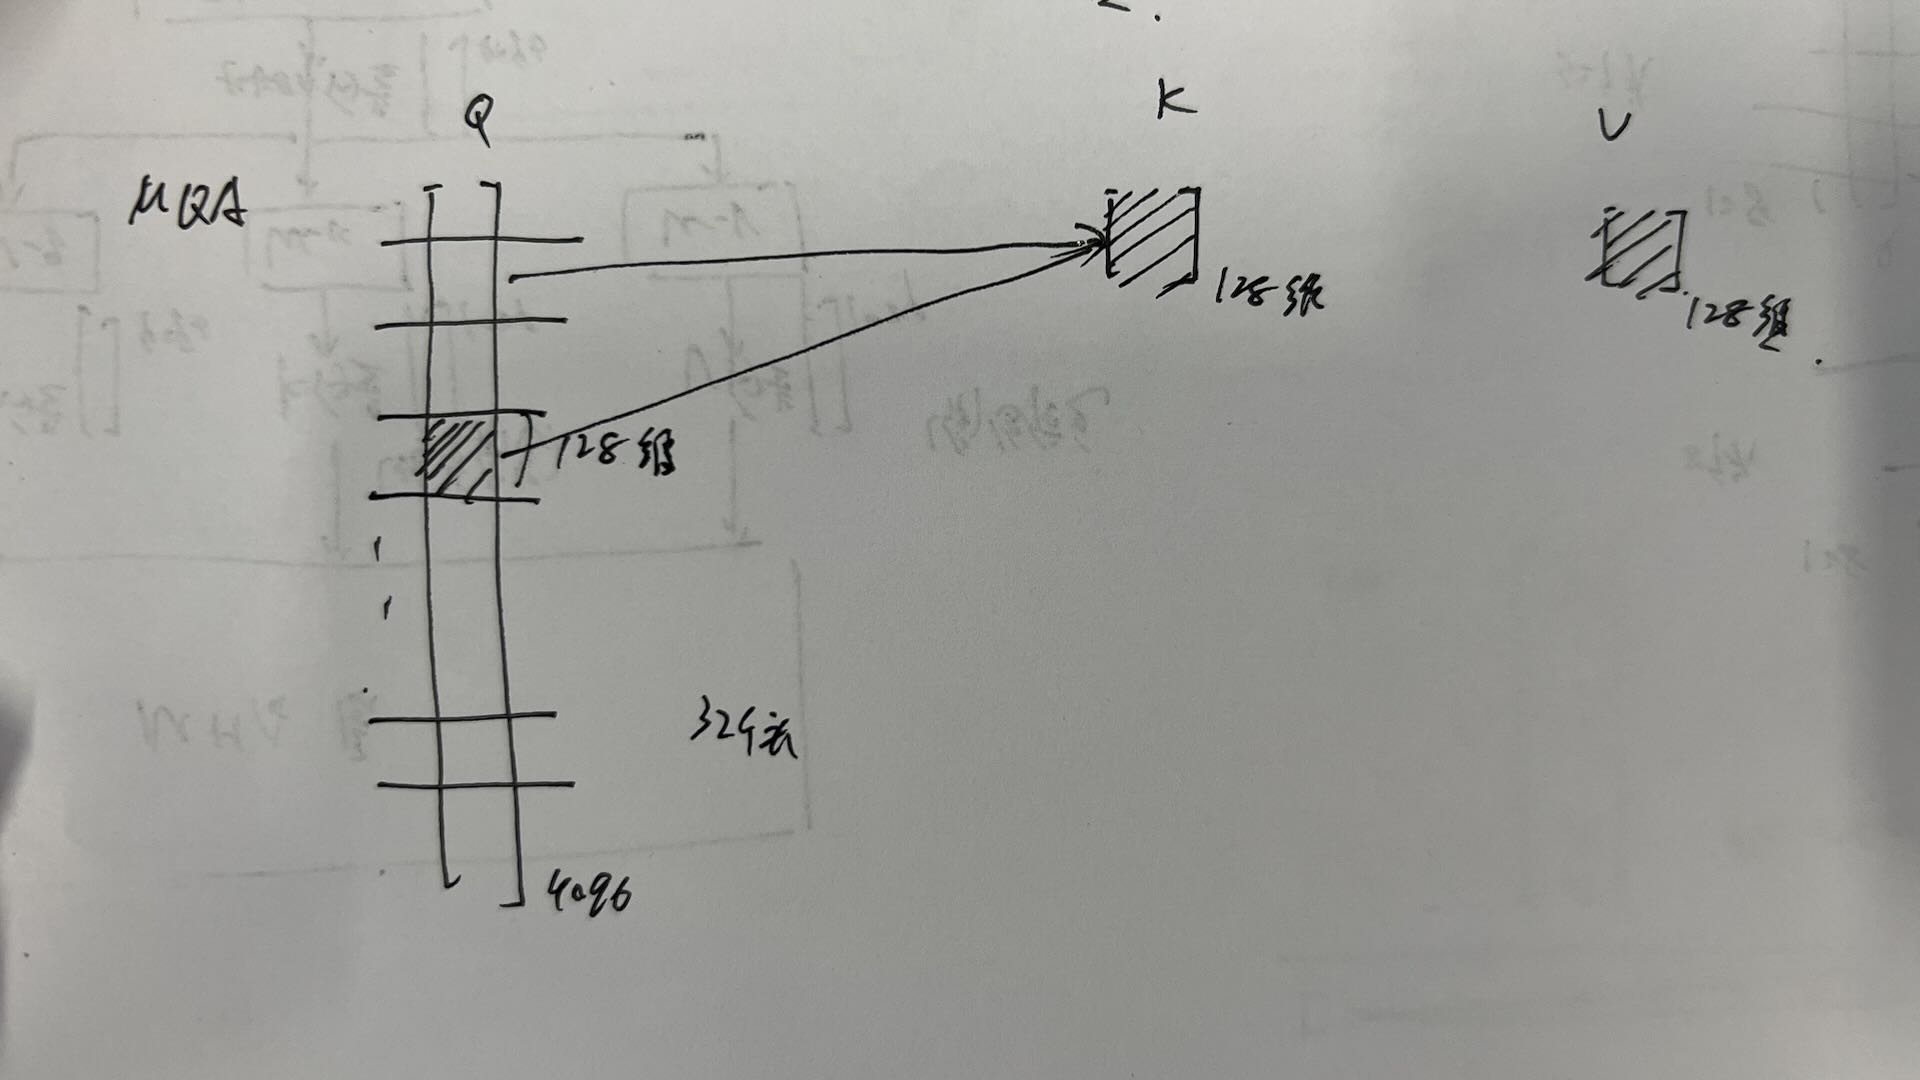
GQA
Q的几个头一组,共享KV的一个头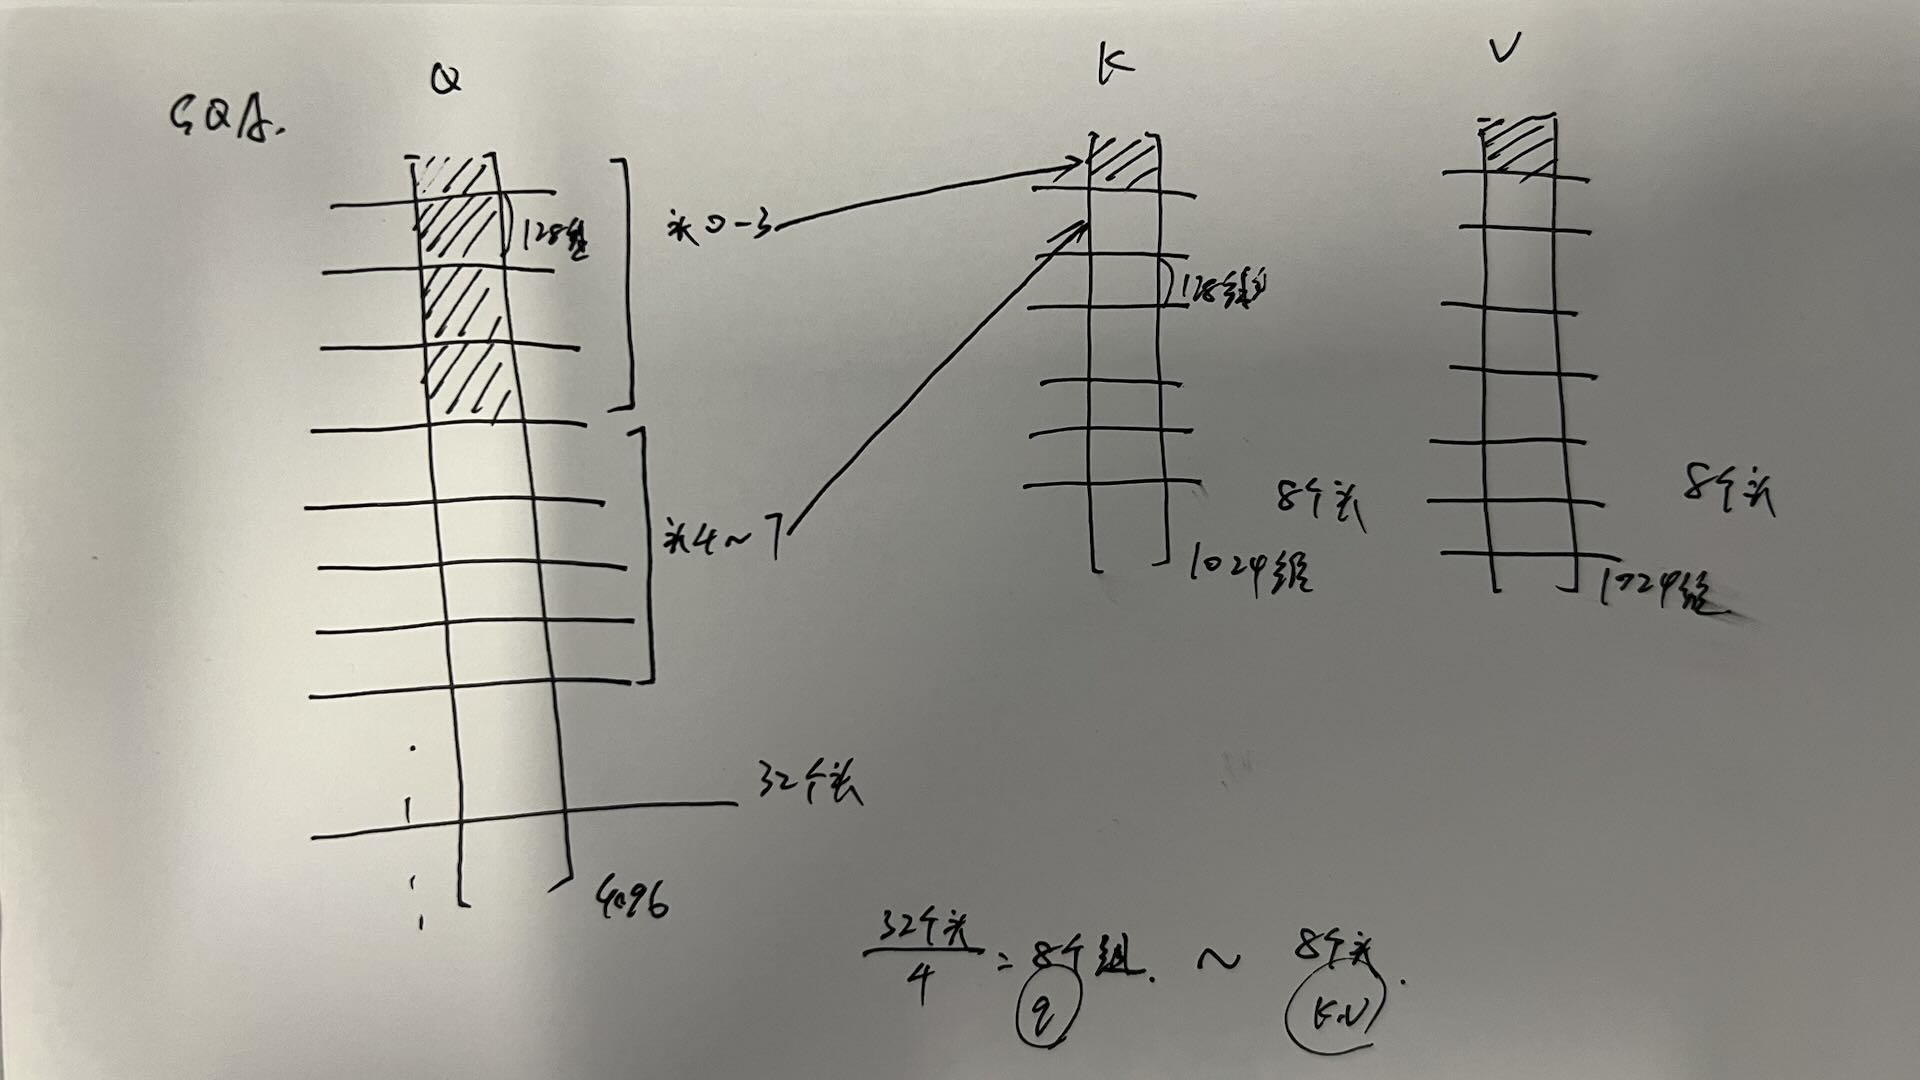
以上仅是分组的策略,本质上都是如何并行计算两个向量之间的相关程度。
效果对比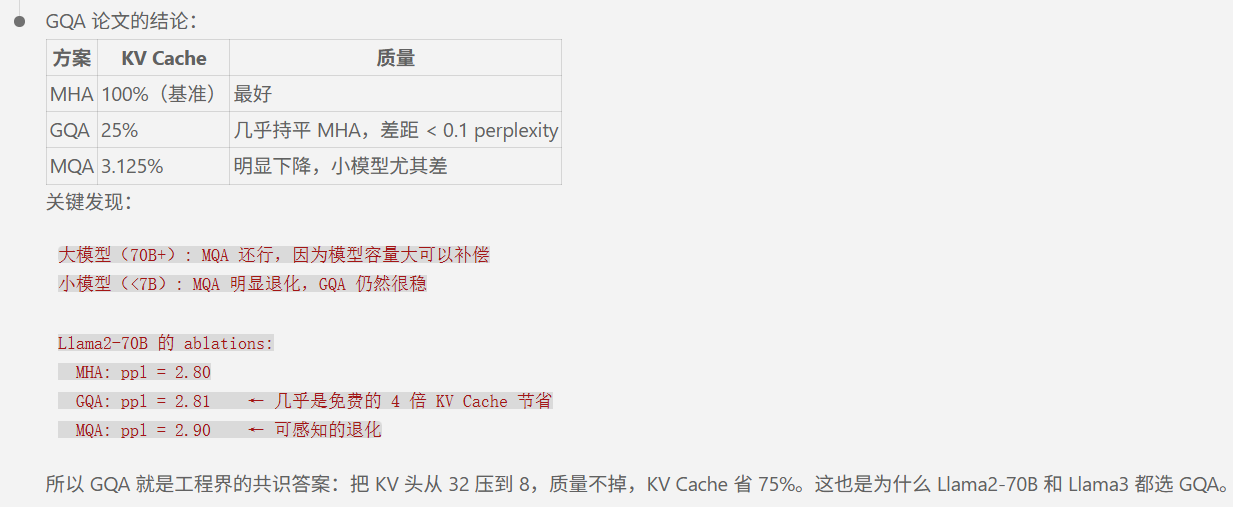
RoPE 旋转位置编码层
在进入mha层之前,会对,q,k两个向量进行位置编码,
这里位置编码的处理,不是整个向量处理,而是一次针对一个头128维来处理的。
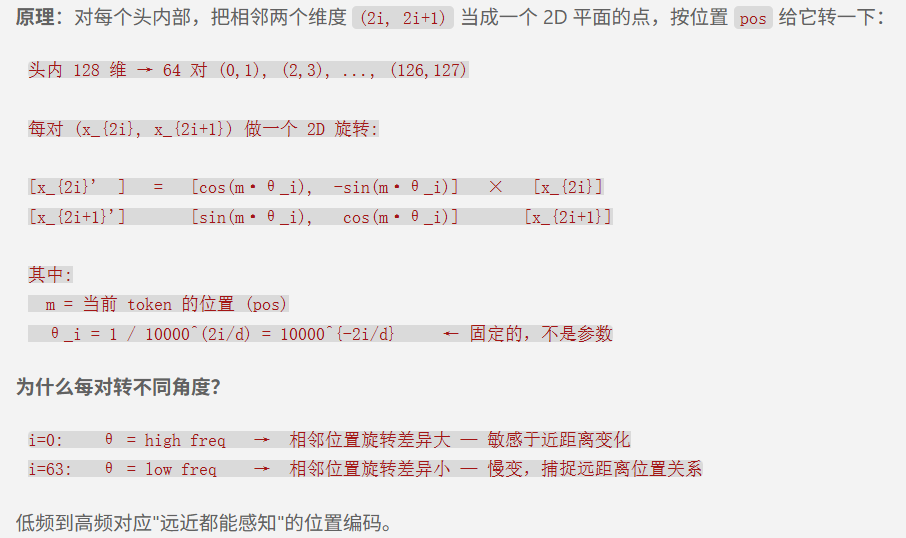
总结
所以,一个token向量,投影成QKV向量后,
- kv向量加入kvcache,作为这个token的键值缓存,用来被其他token向量计算相关性。
- Q向量则用来和历史token的KV向量计算相关性。
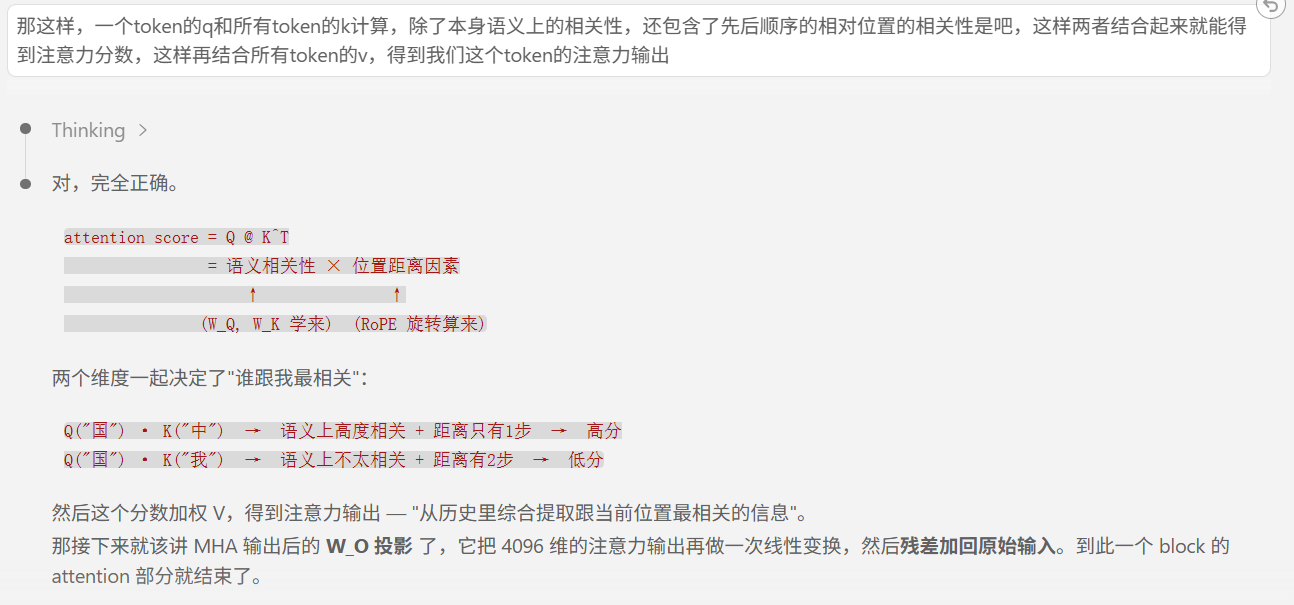
所以,因为每个向量的Q,K经过RoPE,这样,这个token和另一个token的QK进行计算相关性的时候,就带入了相对位置关系,是吧
这里的位置关系,需要说明一下,
我们对一个token向量的Q,K向量做位置编码,本质上是给这些向量一个数学上的绝对位置坐标
这样,该token的q和其他token的k计算的时候,得到的相对位置关系,其实就是先后顺序关系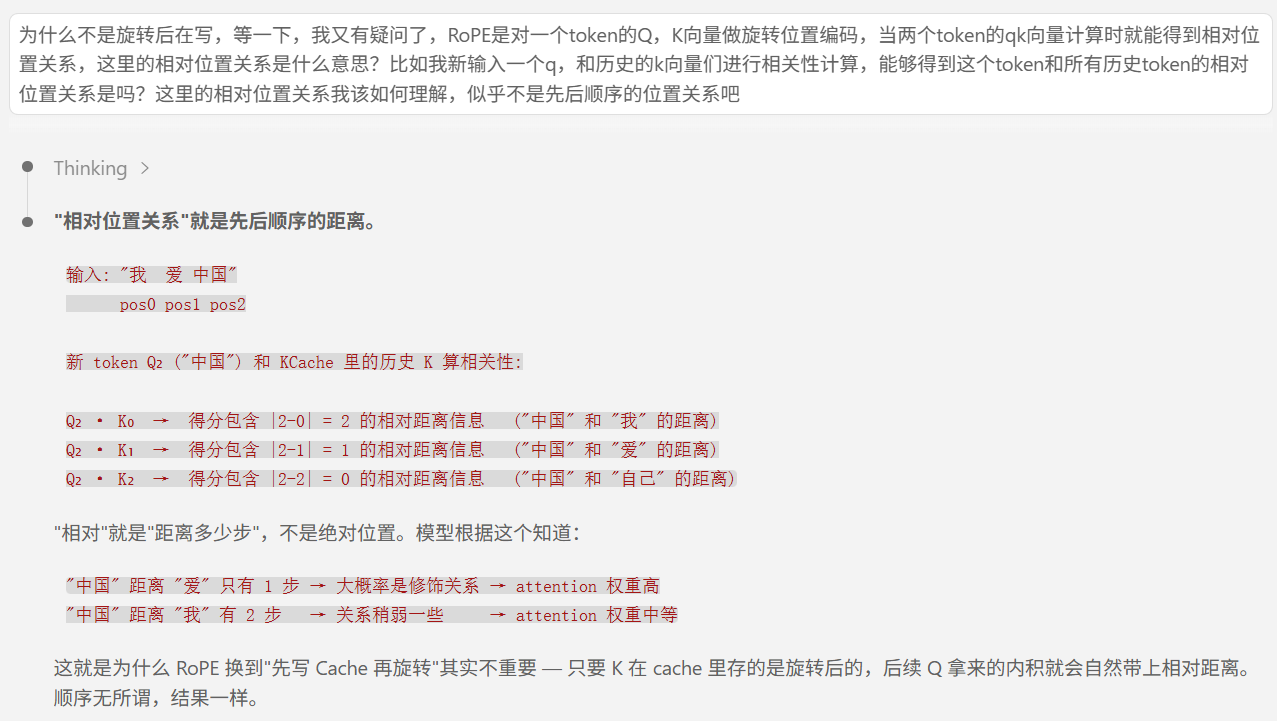
所以,加入RoPE,是为注意力分数的相关性里面,增加了一层位置信息,这样注意力分数的相关性包含:
- 位置先后顺序
- 语义相关性
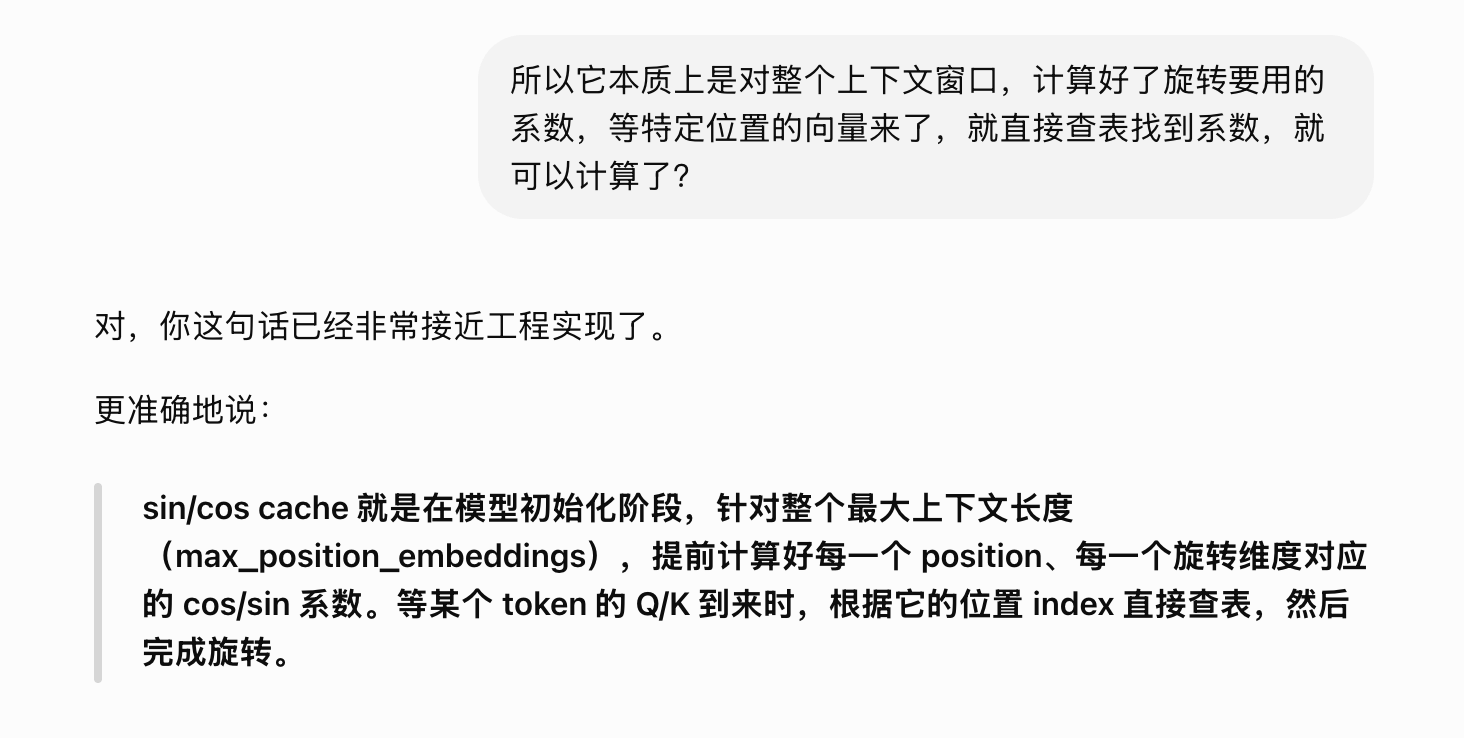
注意,在具体实现中,会提前将旋转运算用到的系数,计算好存在 sin cos cache里面,相当于提前计算好了整个上下文窗口的位置编码的旋转系数。
mha多头注意力算子层
mha这个算子层的实现,他就是,当前token的kv向量直接加入kvcache, q向量和历史token的k向量做相关性计算
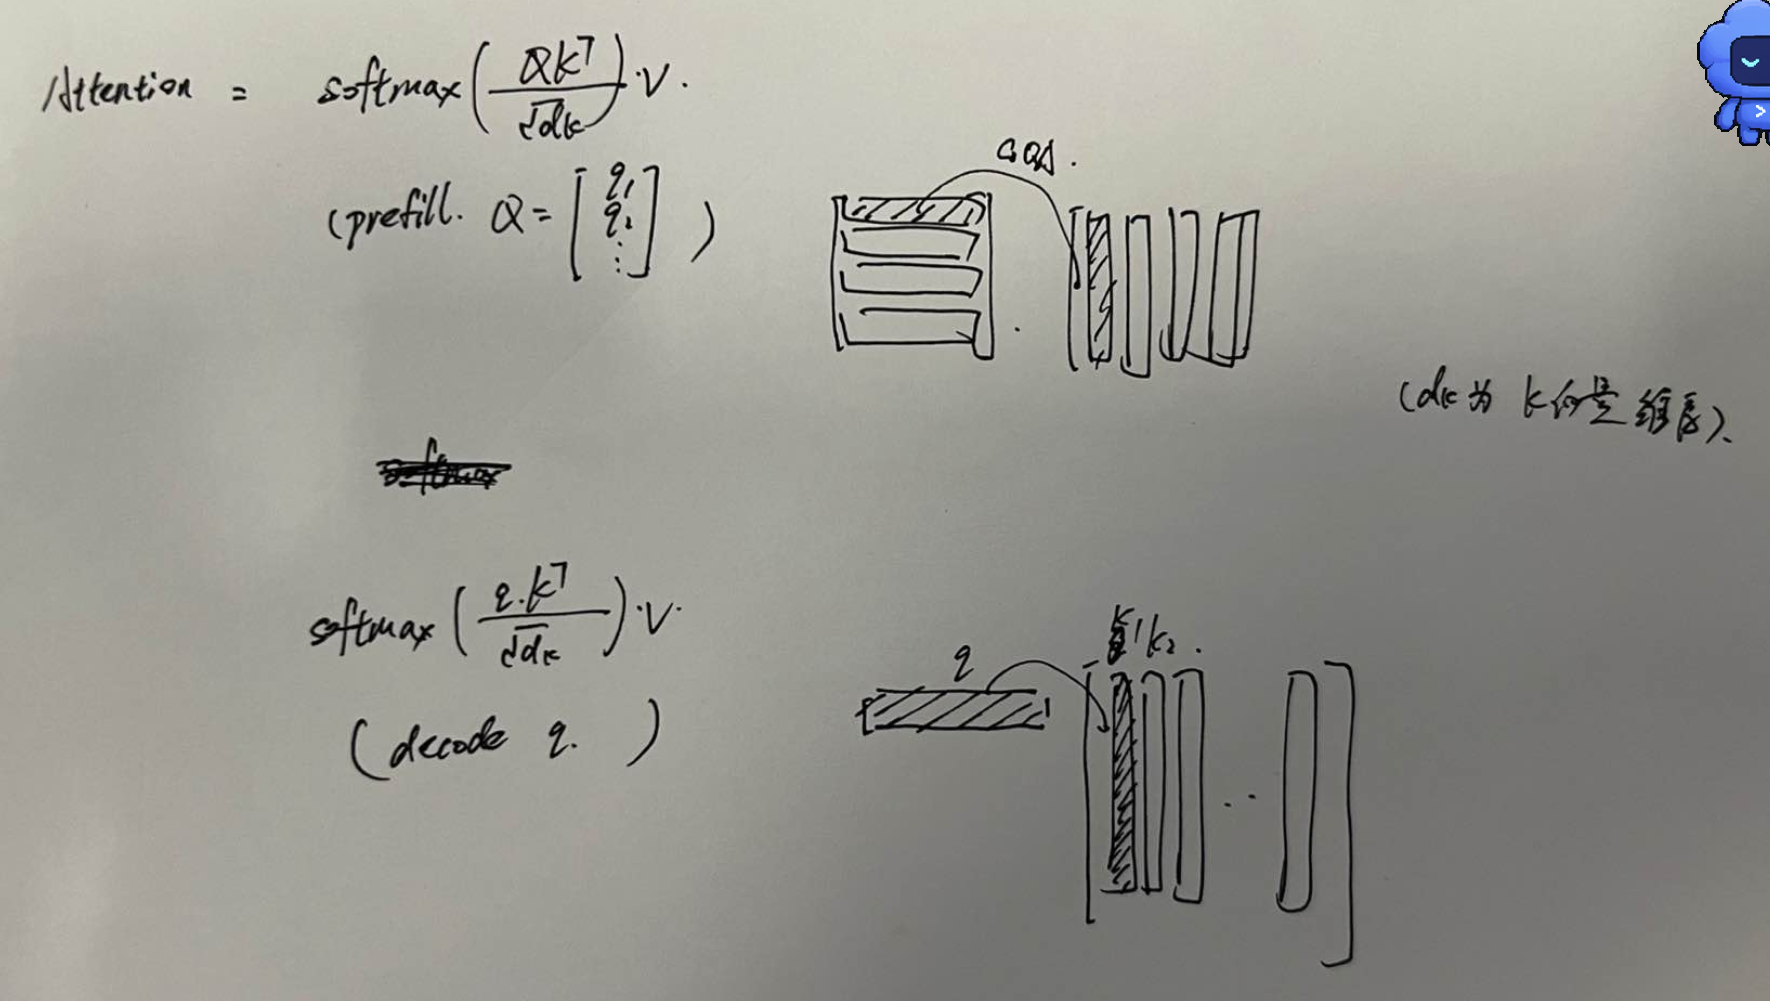
可以看到,我们前面的多头策略,本质上就是定义两个不同维度的向量的点积运算。
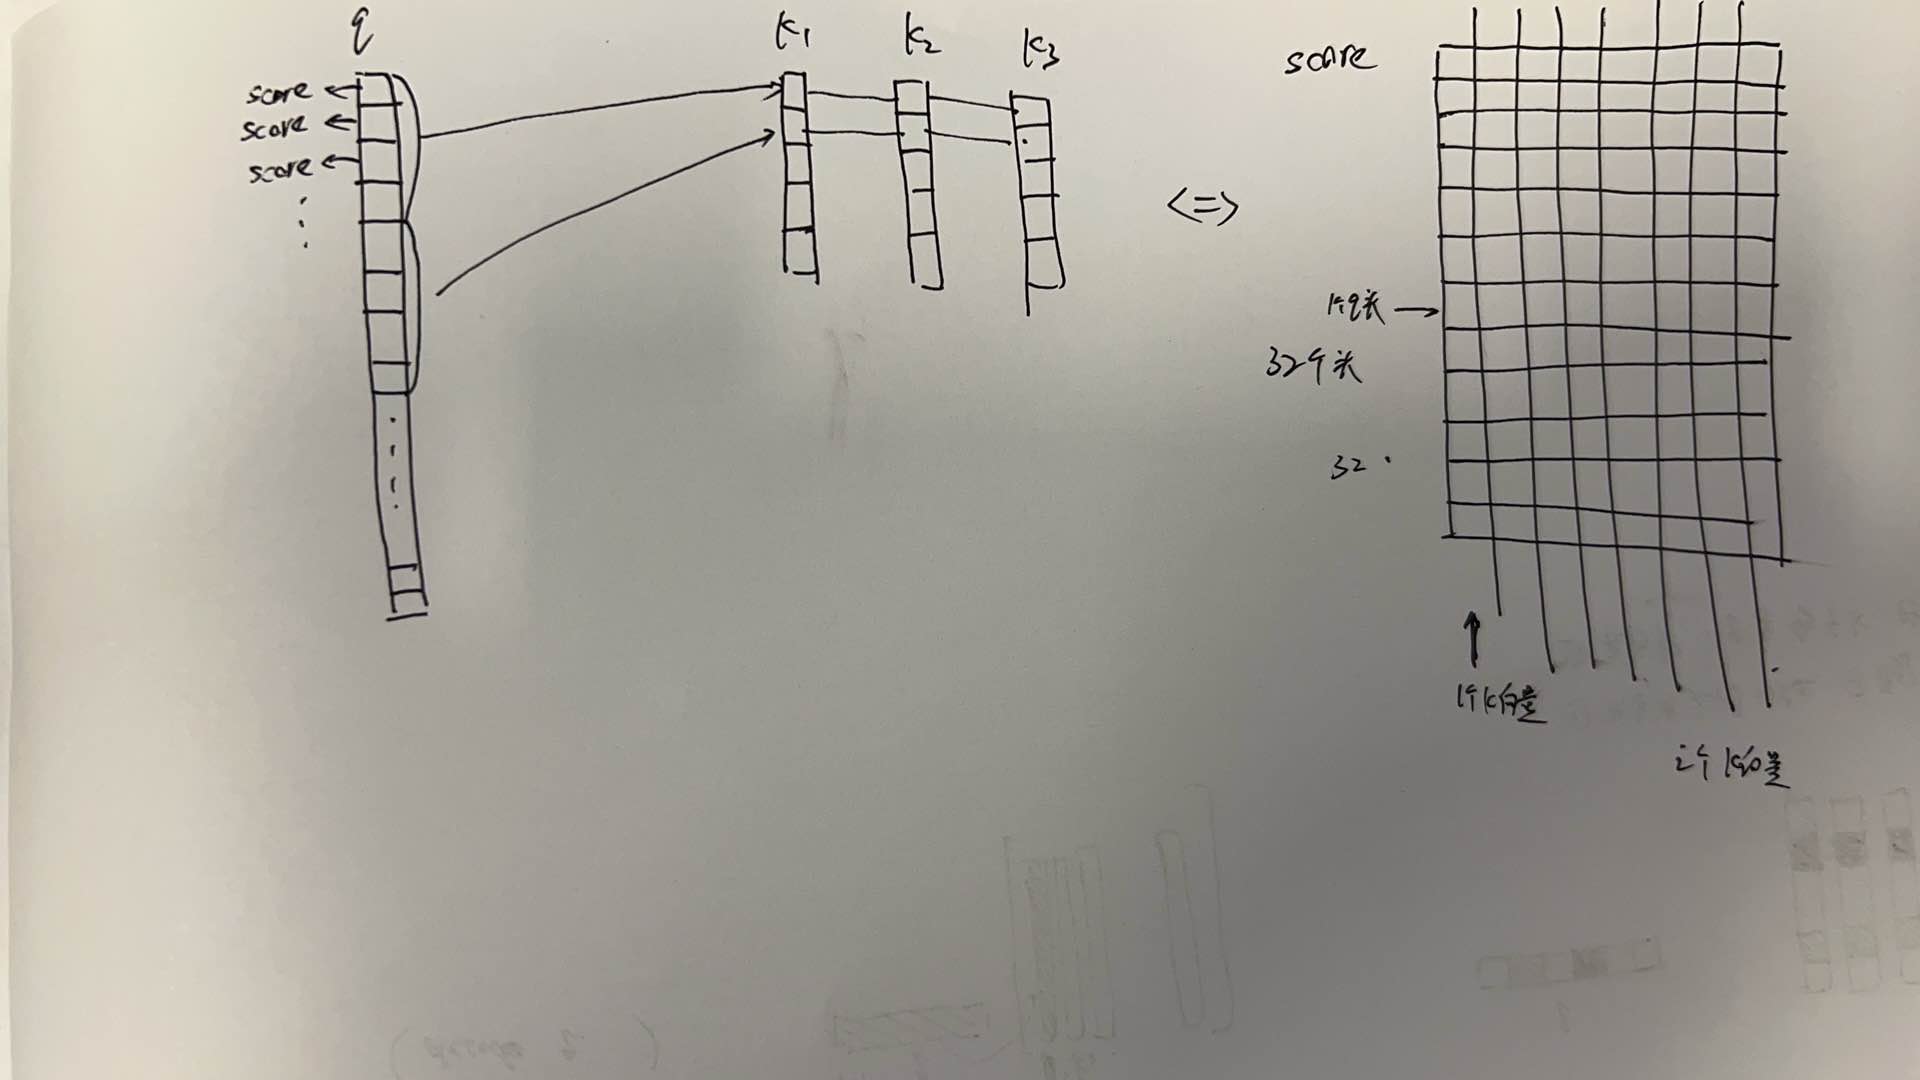
所以实际进行相关分数计算的时候,是发生在里面的头和头之间的
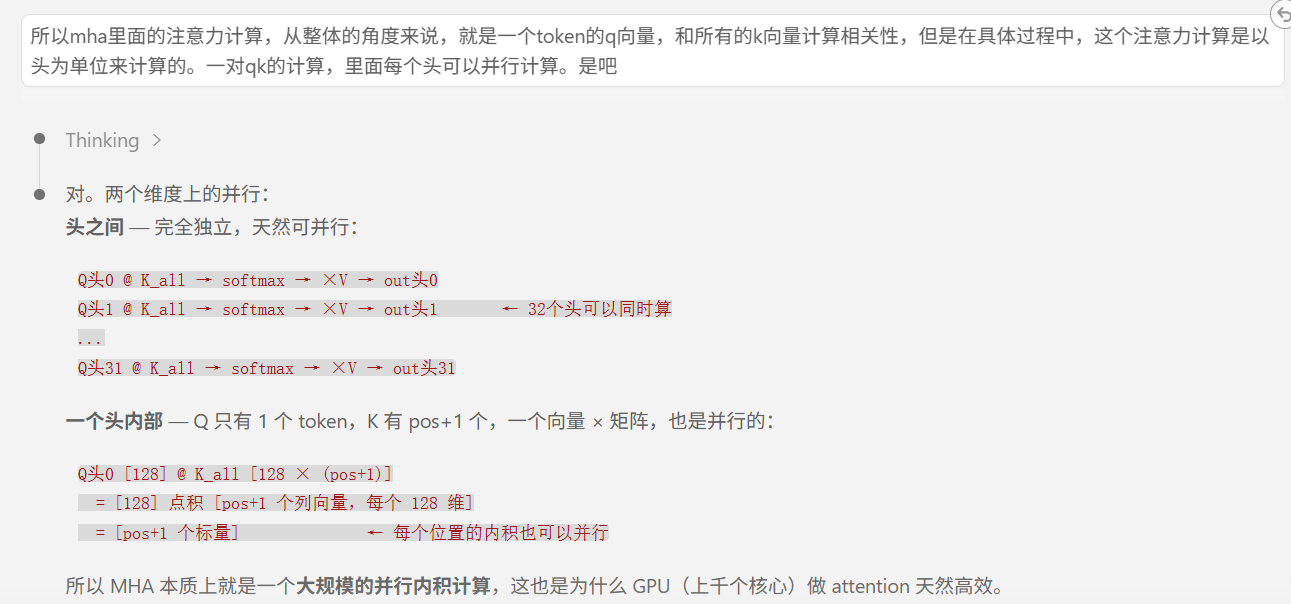
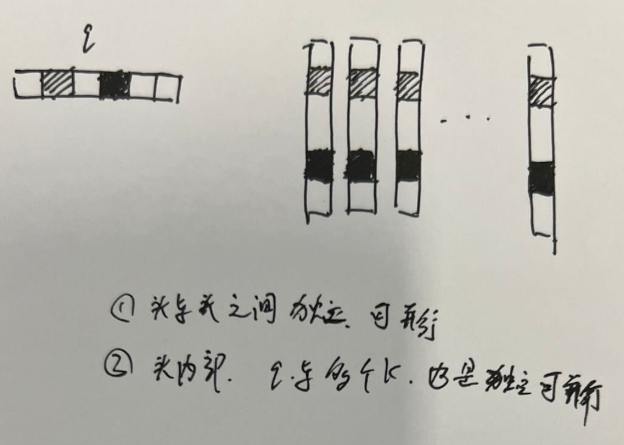
一个q和所有的kcache进行注意力分数计算
在输出注意力输出的时候,因为v是1024维度,只有8个头,所以,和k一样,GQA共享,也就是说,每组的q
所以,i个kcache, i个vcache, 一个q 4096, 32个头,
最终产生的v_q, 就是4096维度的(32个头都有分数,分组加权vcache)
总结
最终还有一个W_O的矩阵乘算子层,把多头信息投影到语义空间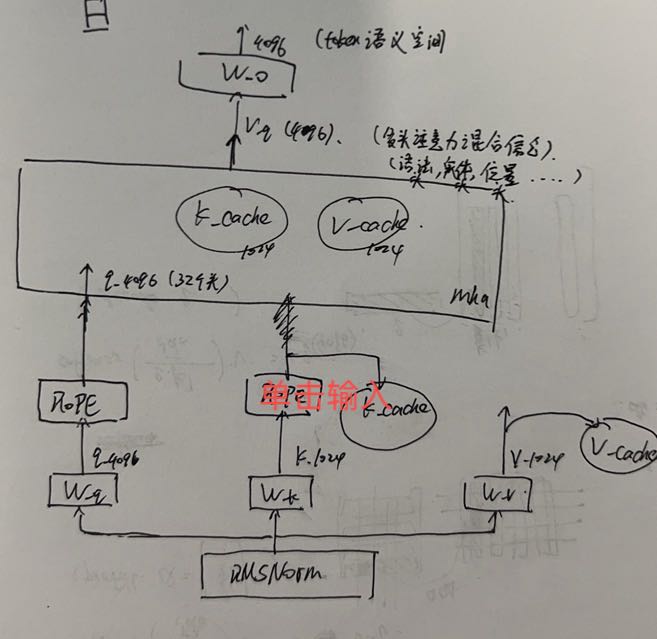
残差连接层 add
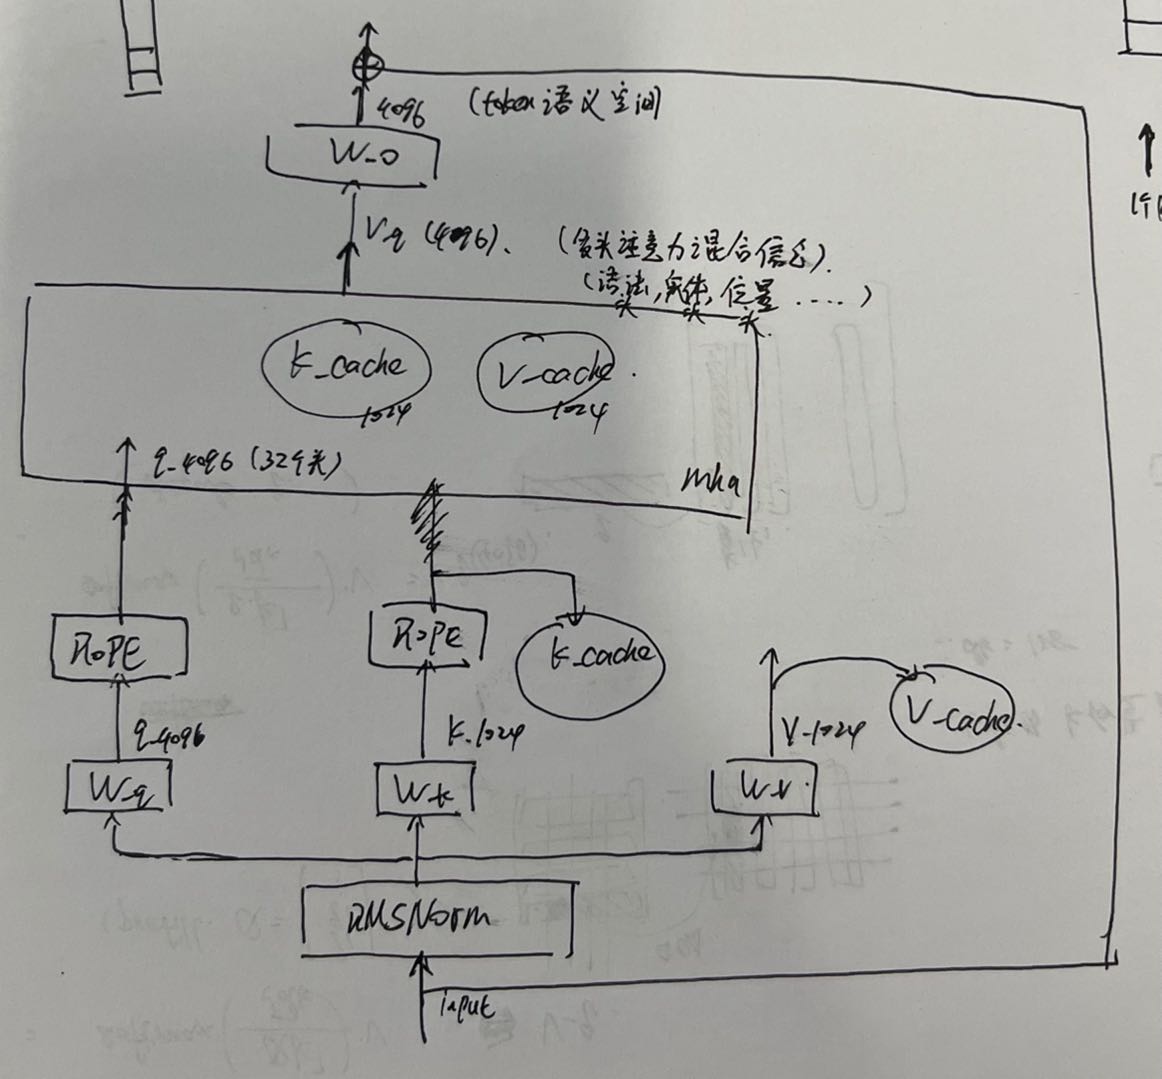
至此,就是decoder block的前半段。
(补充)门控GLU
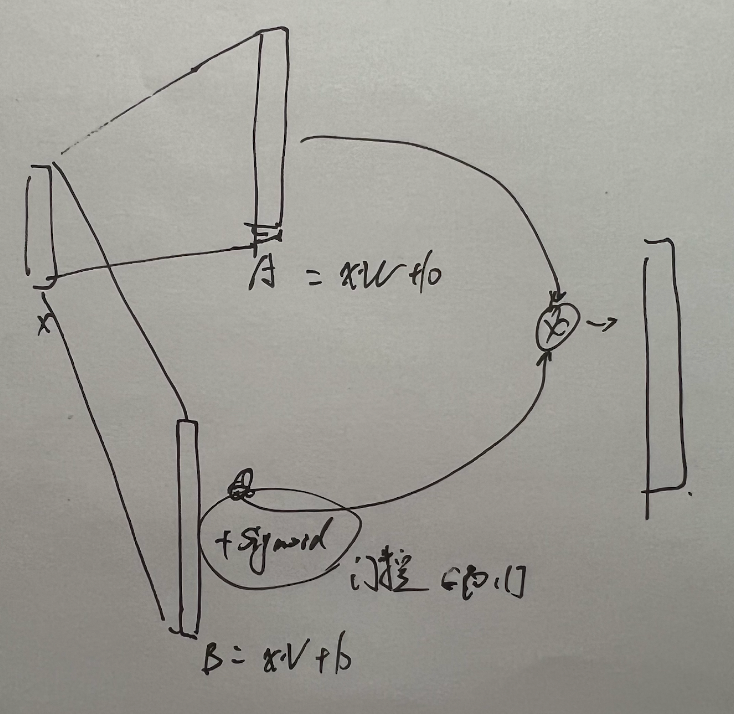
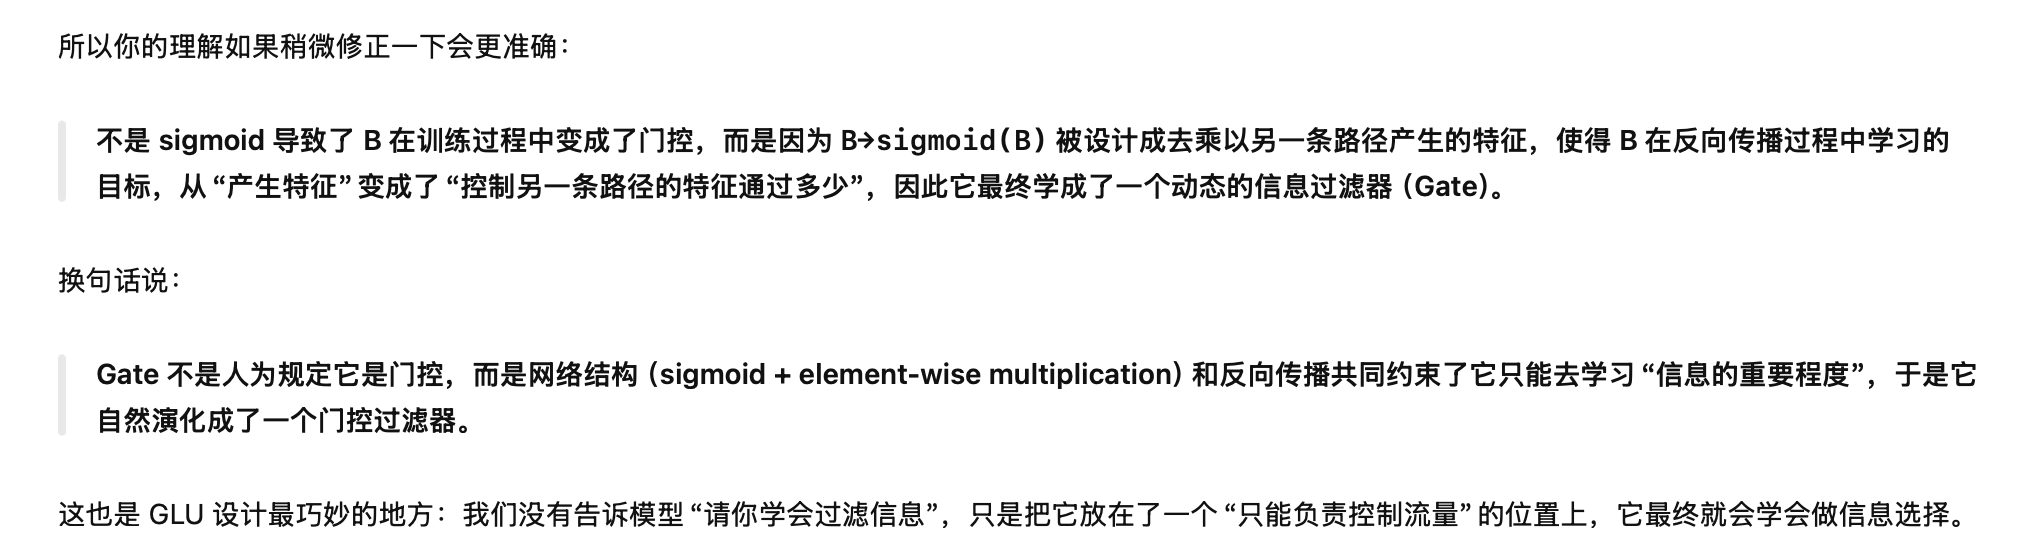
假设现在有一个输入x, 经过两个线性层linear算子,但是其中一个算子后面增加了sigmoid,
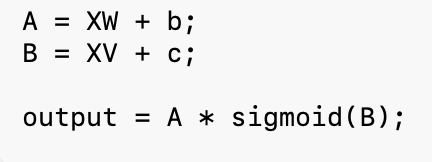
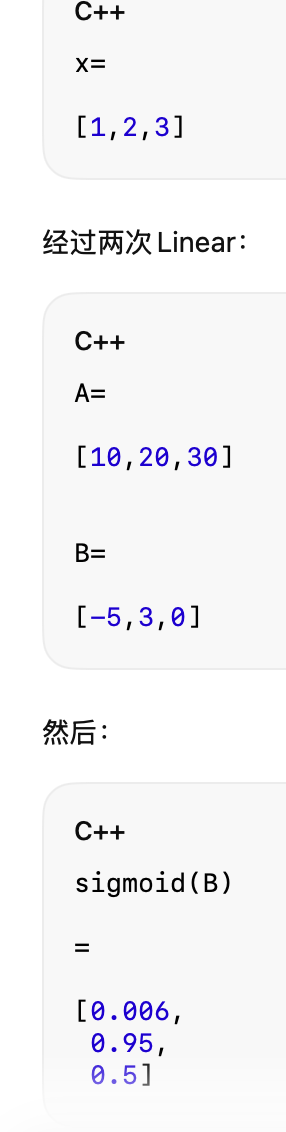
因此B这条linear层算子,因为加上了sigmoid,就会变成一个门控单元,之后和A的linear层进行逐元素相乘即可
这就是我们最原始的GLU的思想
SwiGLU
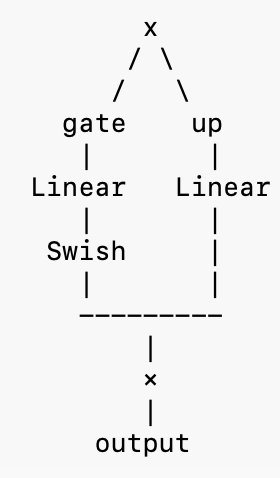
而我们的decoder-block的后半段,是FFN部分,这里不是单纯的两个linear层,
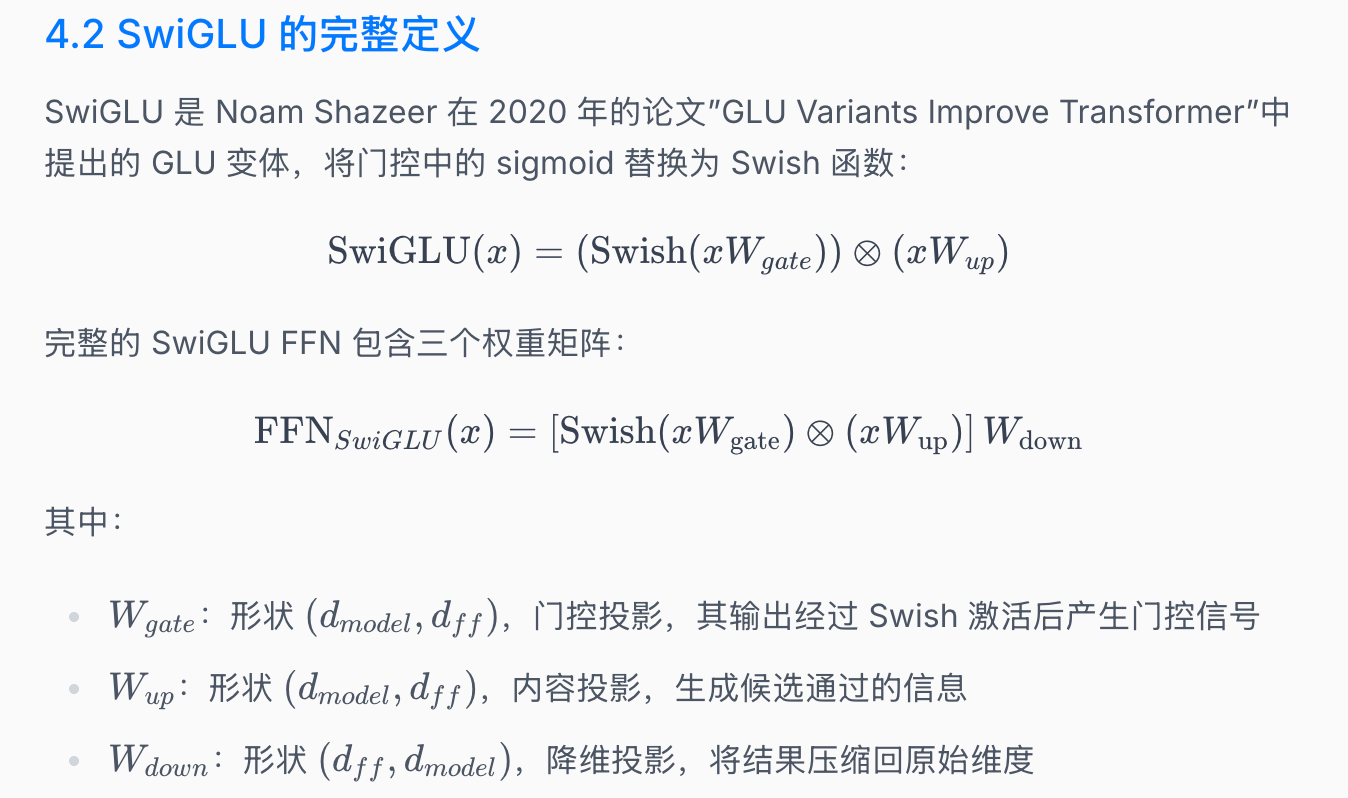
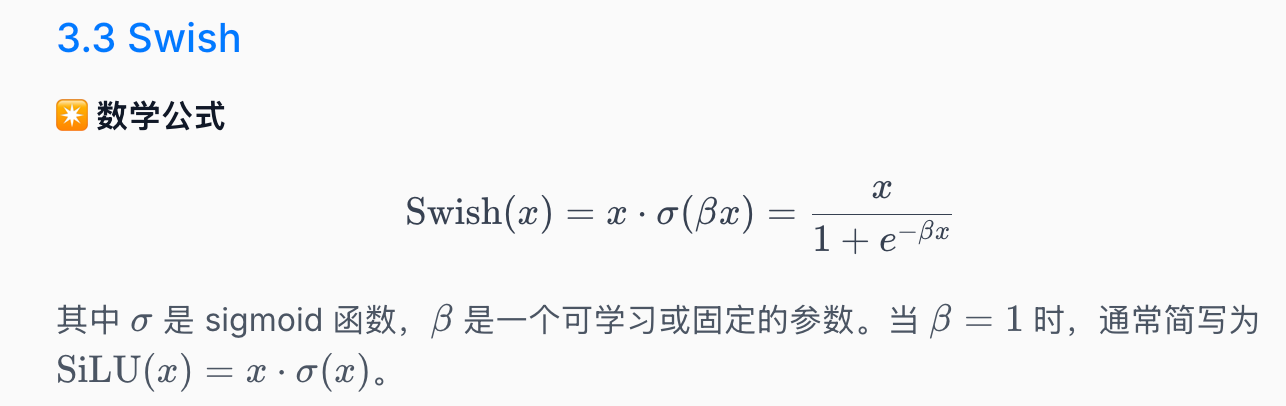
所以,可以看到,他这里把sigmoid函数换成了 x*sigmoid(x), 这样的好处是:
- 原来激活函数用sigmoid,只能通过、抑制,不能放大信息
- swish函数:-0.3——-+∞, 可以实现关闭,衰减,保留,放大,改变符号。
所以,kuipa里面的SwiGLU算子层,就是把升维的向量,和门控的向量,做一个运算的无参层。
真正的升维的都是矩阵乘matmul算子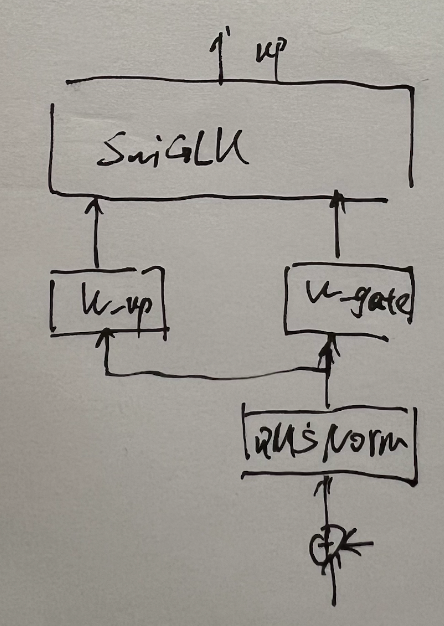
经过SwiGLU之后,得到升维的token向量。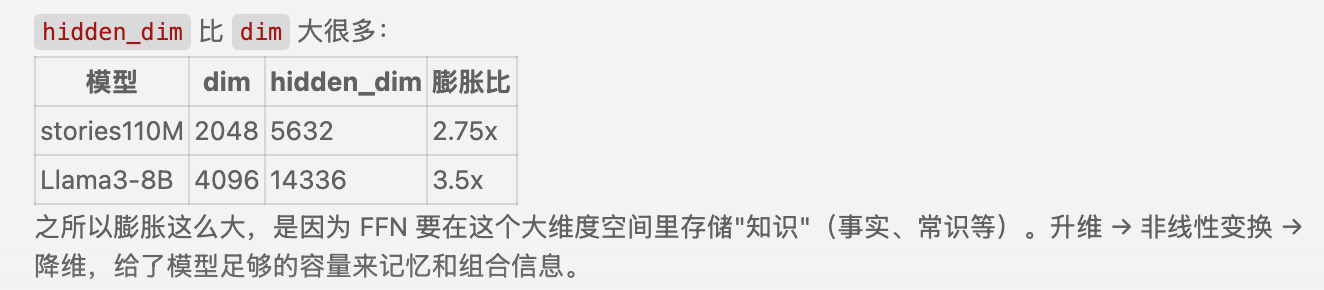
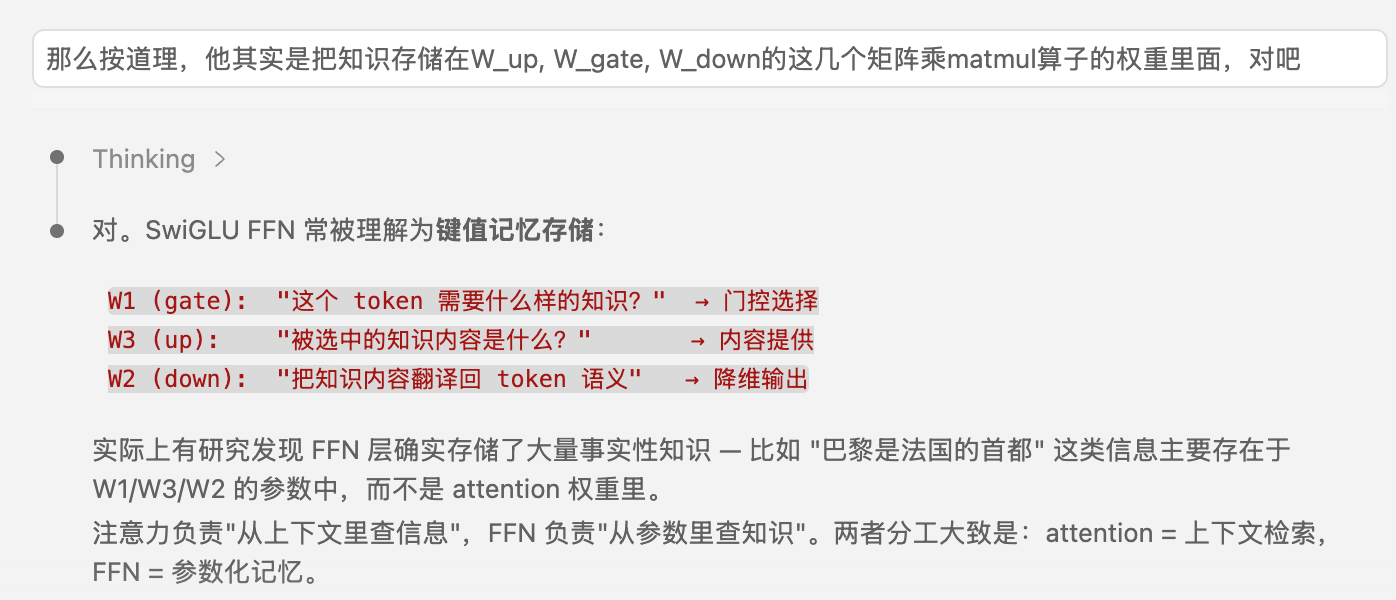
总结
之后这一块也有残差连接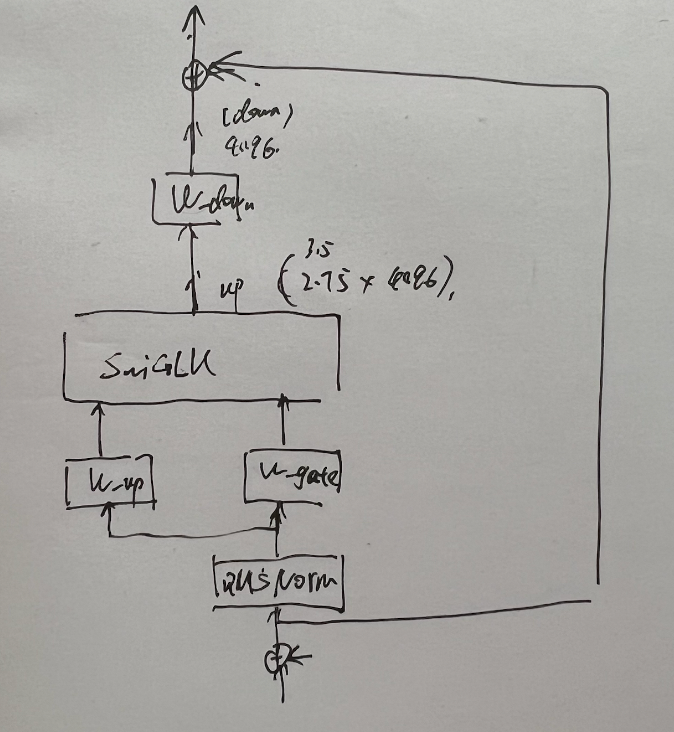
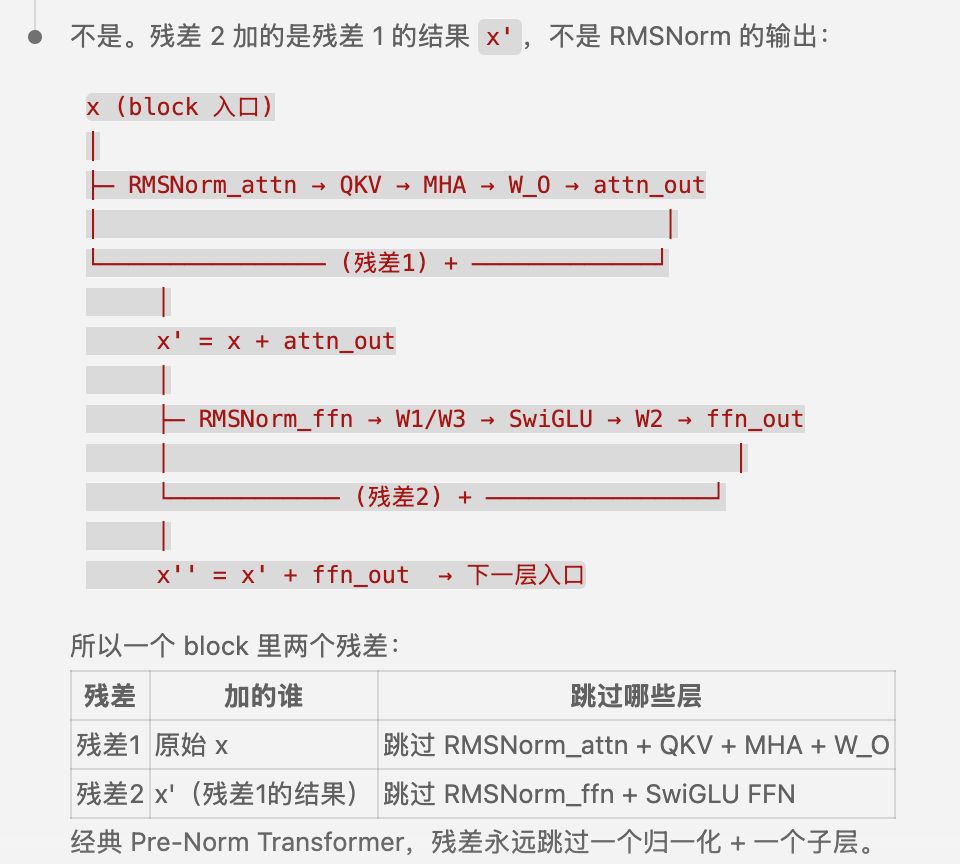
分层算子 cls_layer(本质上matmul算子) (有参)
至此,当我们经过了多个decoder block, 得到最后的一个输出token向量 4096,经过最后一个RMSNorm,归一化到0-1之间,之后,就可以开始解码了。我们解码,用的就是embedding的逆用。
这里就需要再次深入的认识embedding这个算子层了。
在一开始,embedding算子层的作用是把token_id -> token向量,本质上就是token id的one hot编码对embedding的巨大的权重矩阵(vocab_size x dim)的查表。
在最后,我们用输出向量4096,也反向去embedding的权重矩阵里面去查表,得到最后的token id. 这就是我们的输出token的id。
所以,embedding的权重矩阵,不是无意义的编码,而是每个token的语义坐标
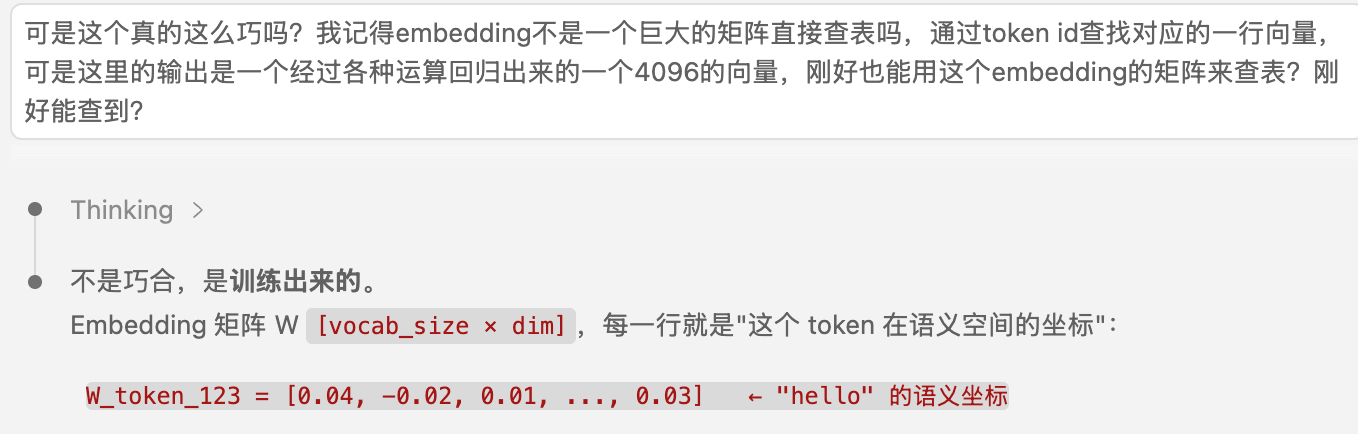
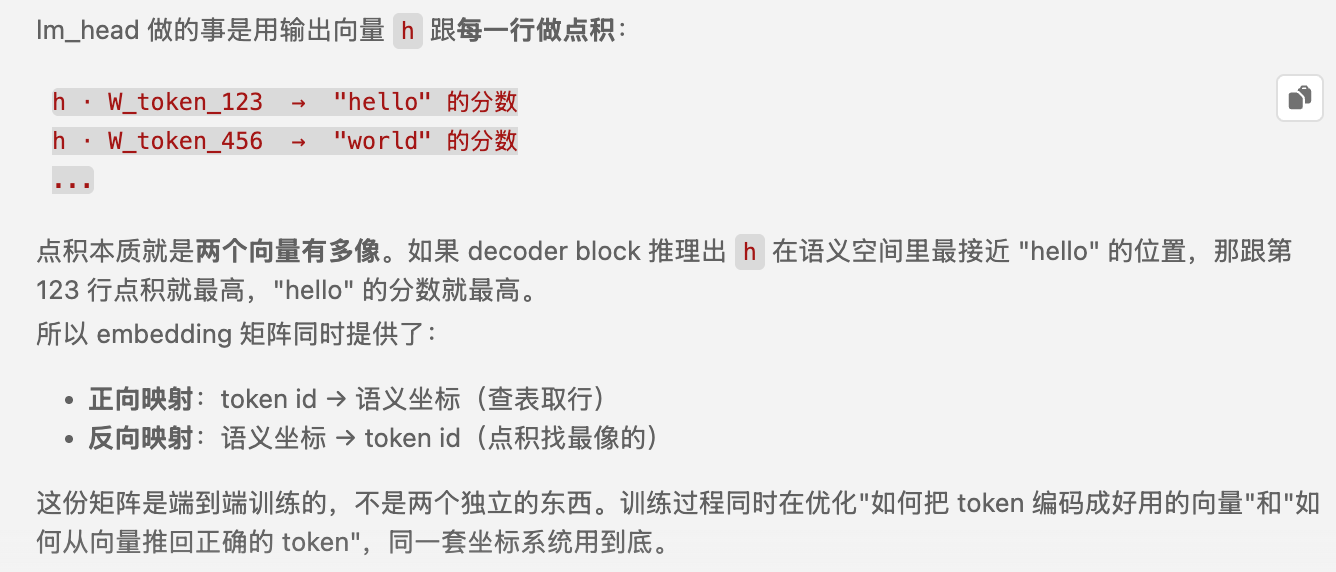
所以末端的cls_layer层,通过语义坐标来查找匹配对应的tokenid, 并不是完全一致。而是匹配看看那个向量最接近。
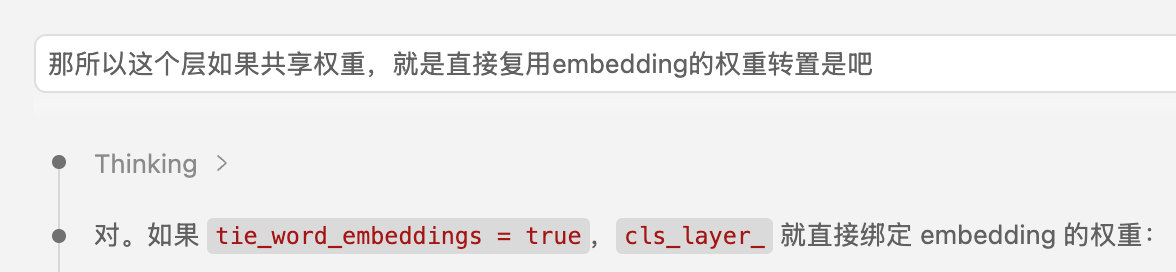
所以,cls_layer层算子,本质上就是一个matmul算子,因为里面指定了特定的权重矩阵,所以,才单独封装一下。
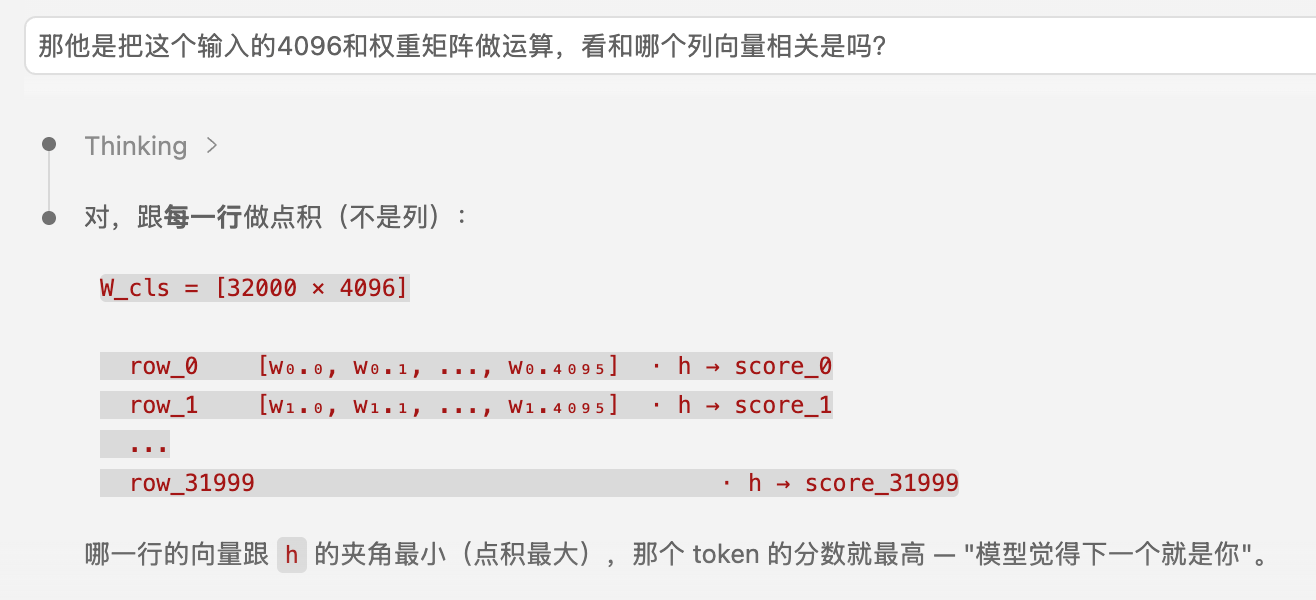
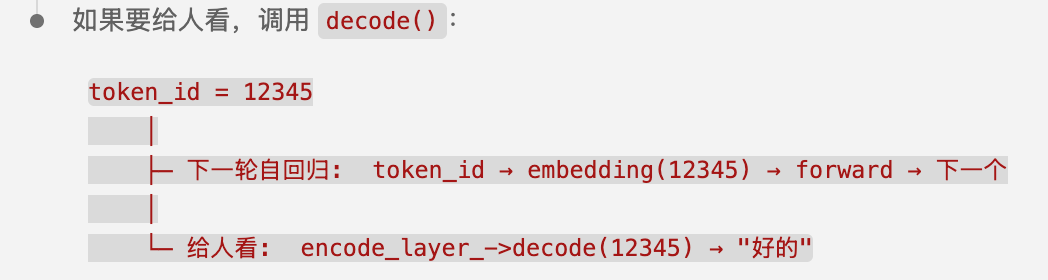
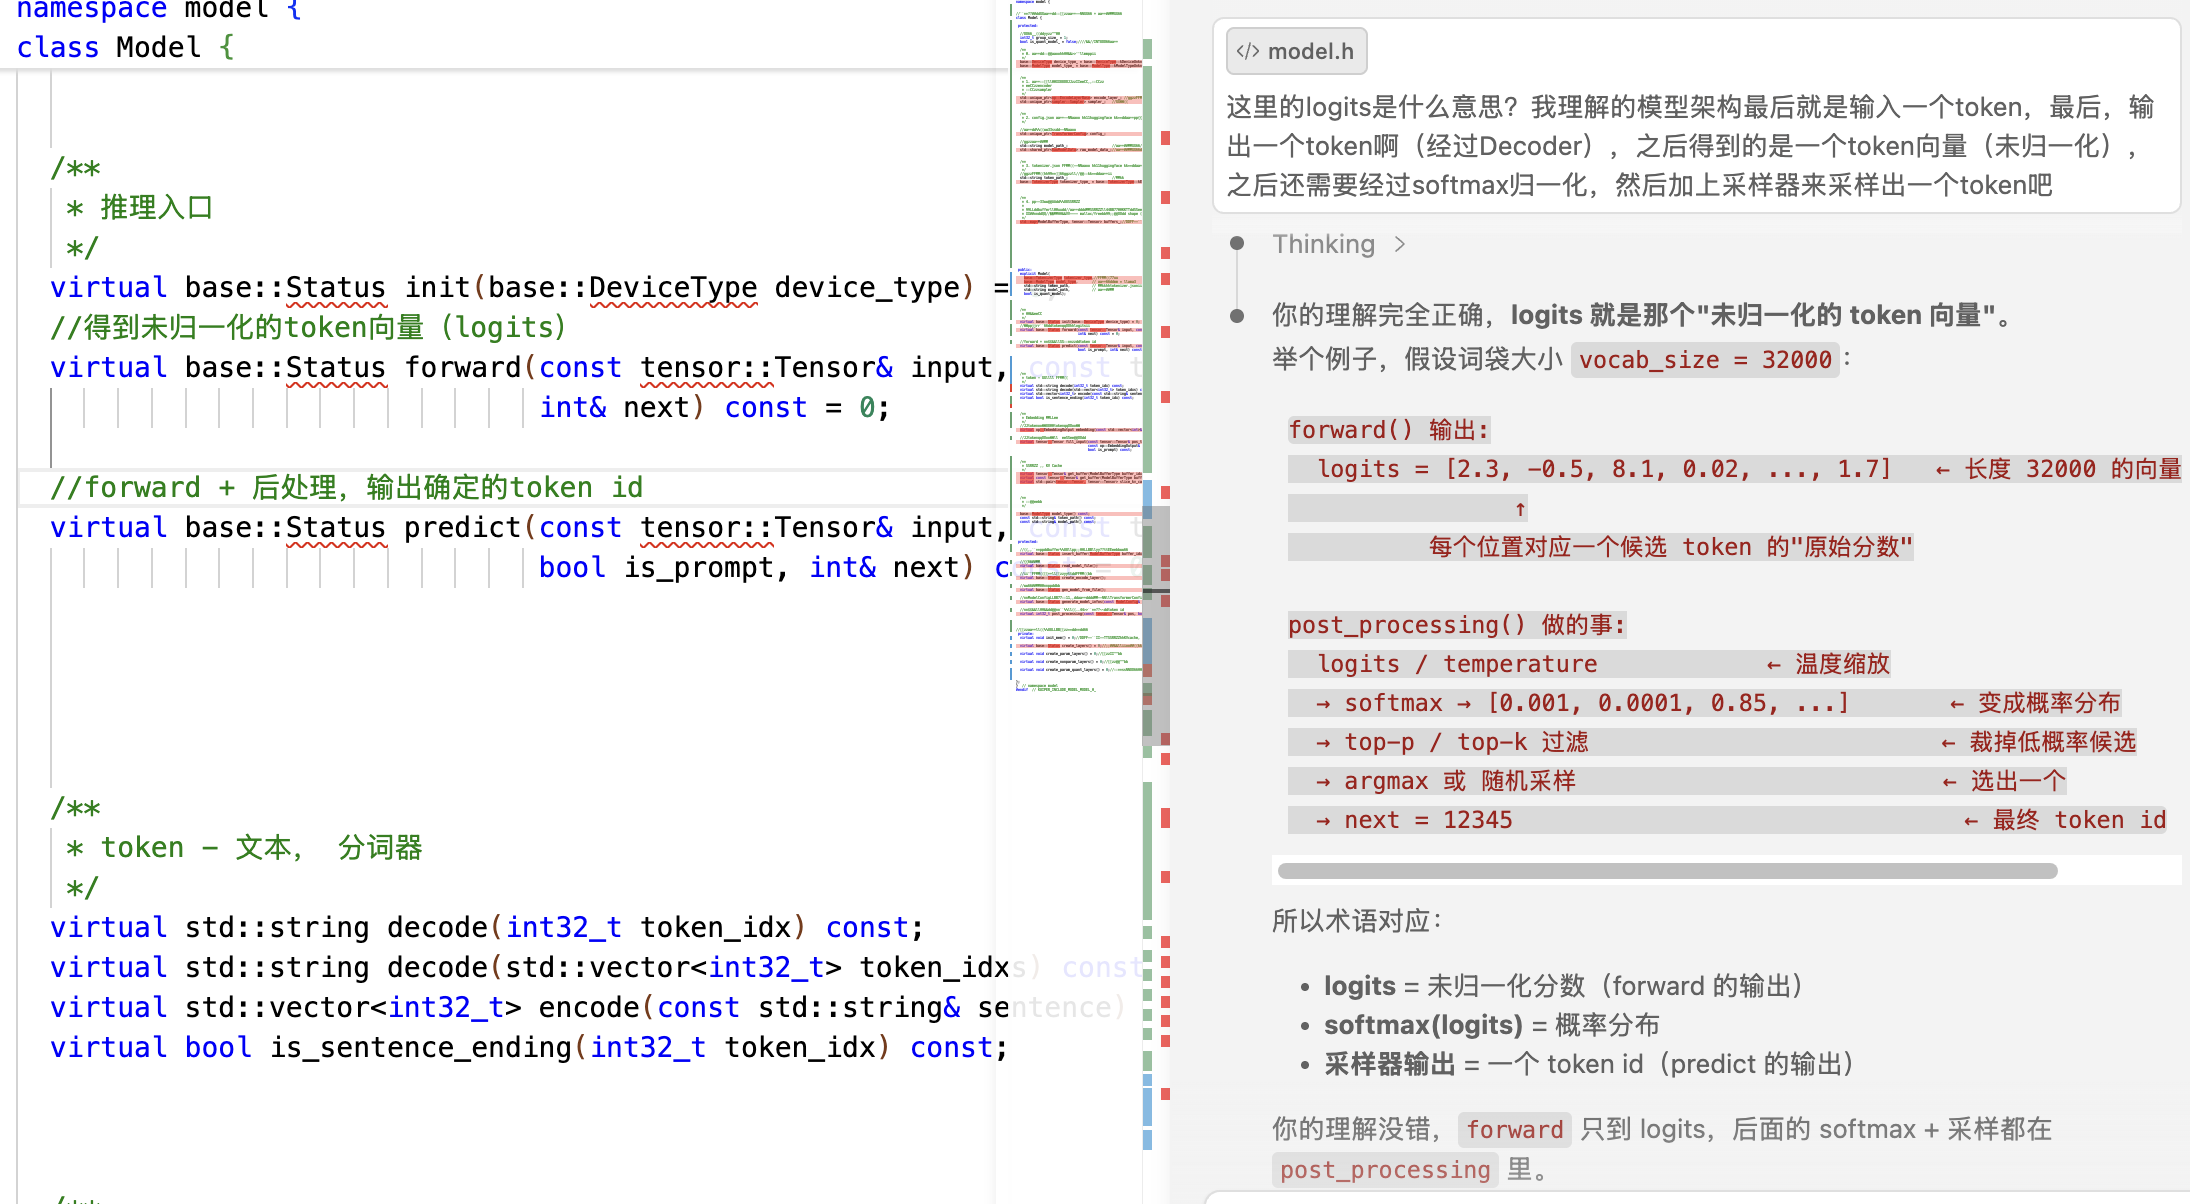
cls_layer计算得到可能输出tokenid的整个分数表,下面就是解码策略了, 到底如何选择一个实际的token? 也就是sampler,采样器。
argmax — 直接选分数最大的那个 token
- 没做 temperature、top-k、top-p,就是贪心选
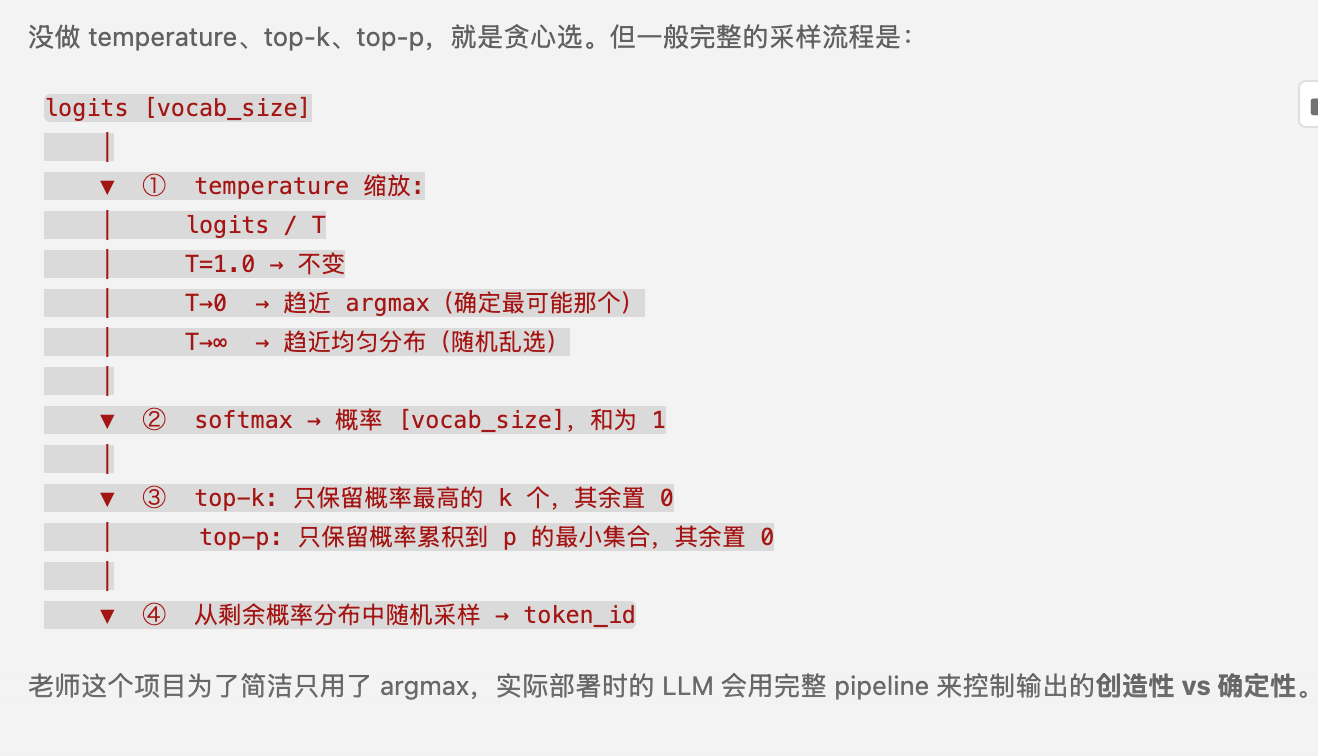
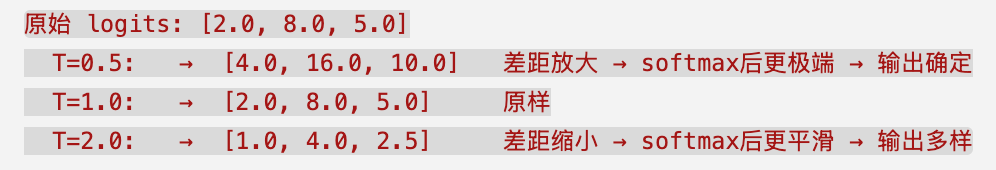
Temperature — 控制”创造力”(放大距离值)
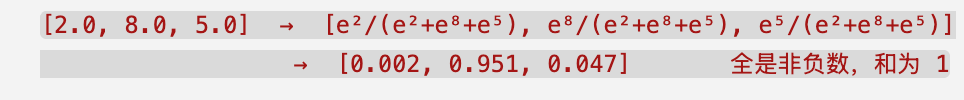
Softmax — 转成概率(距离转成概率)
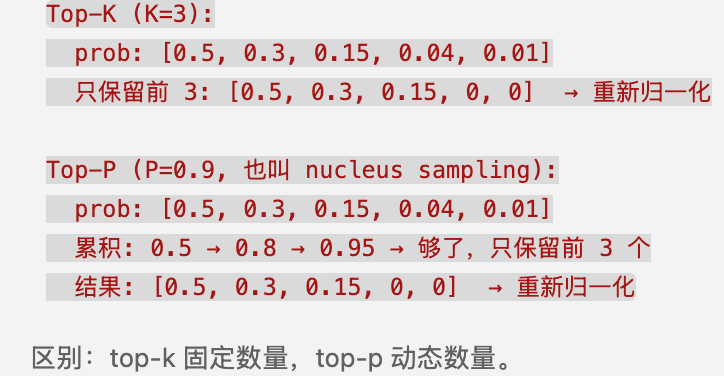
Top-K / Top-P — 砍掉烂选择
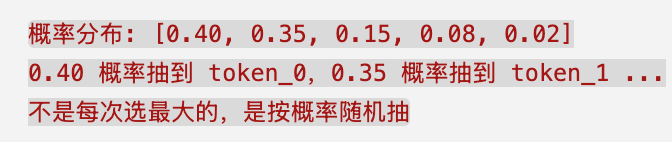
随机采样
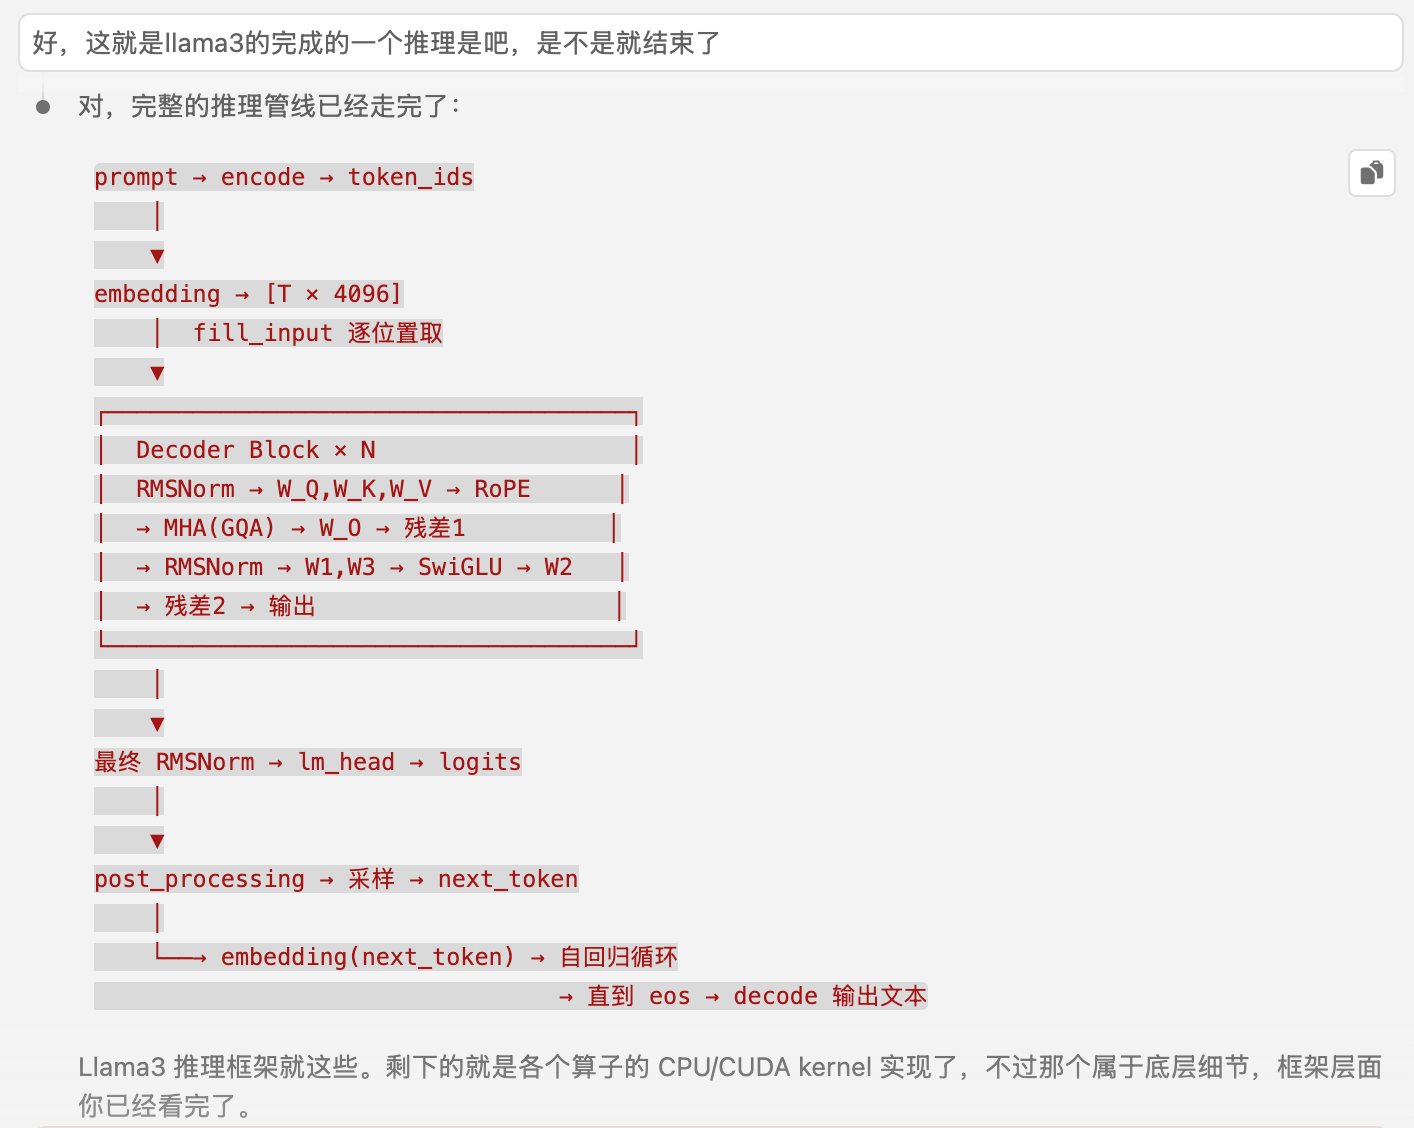
推理框架部分结束
(旧)matmul算子(有权重层)
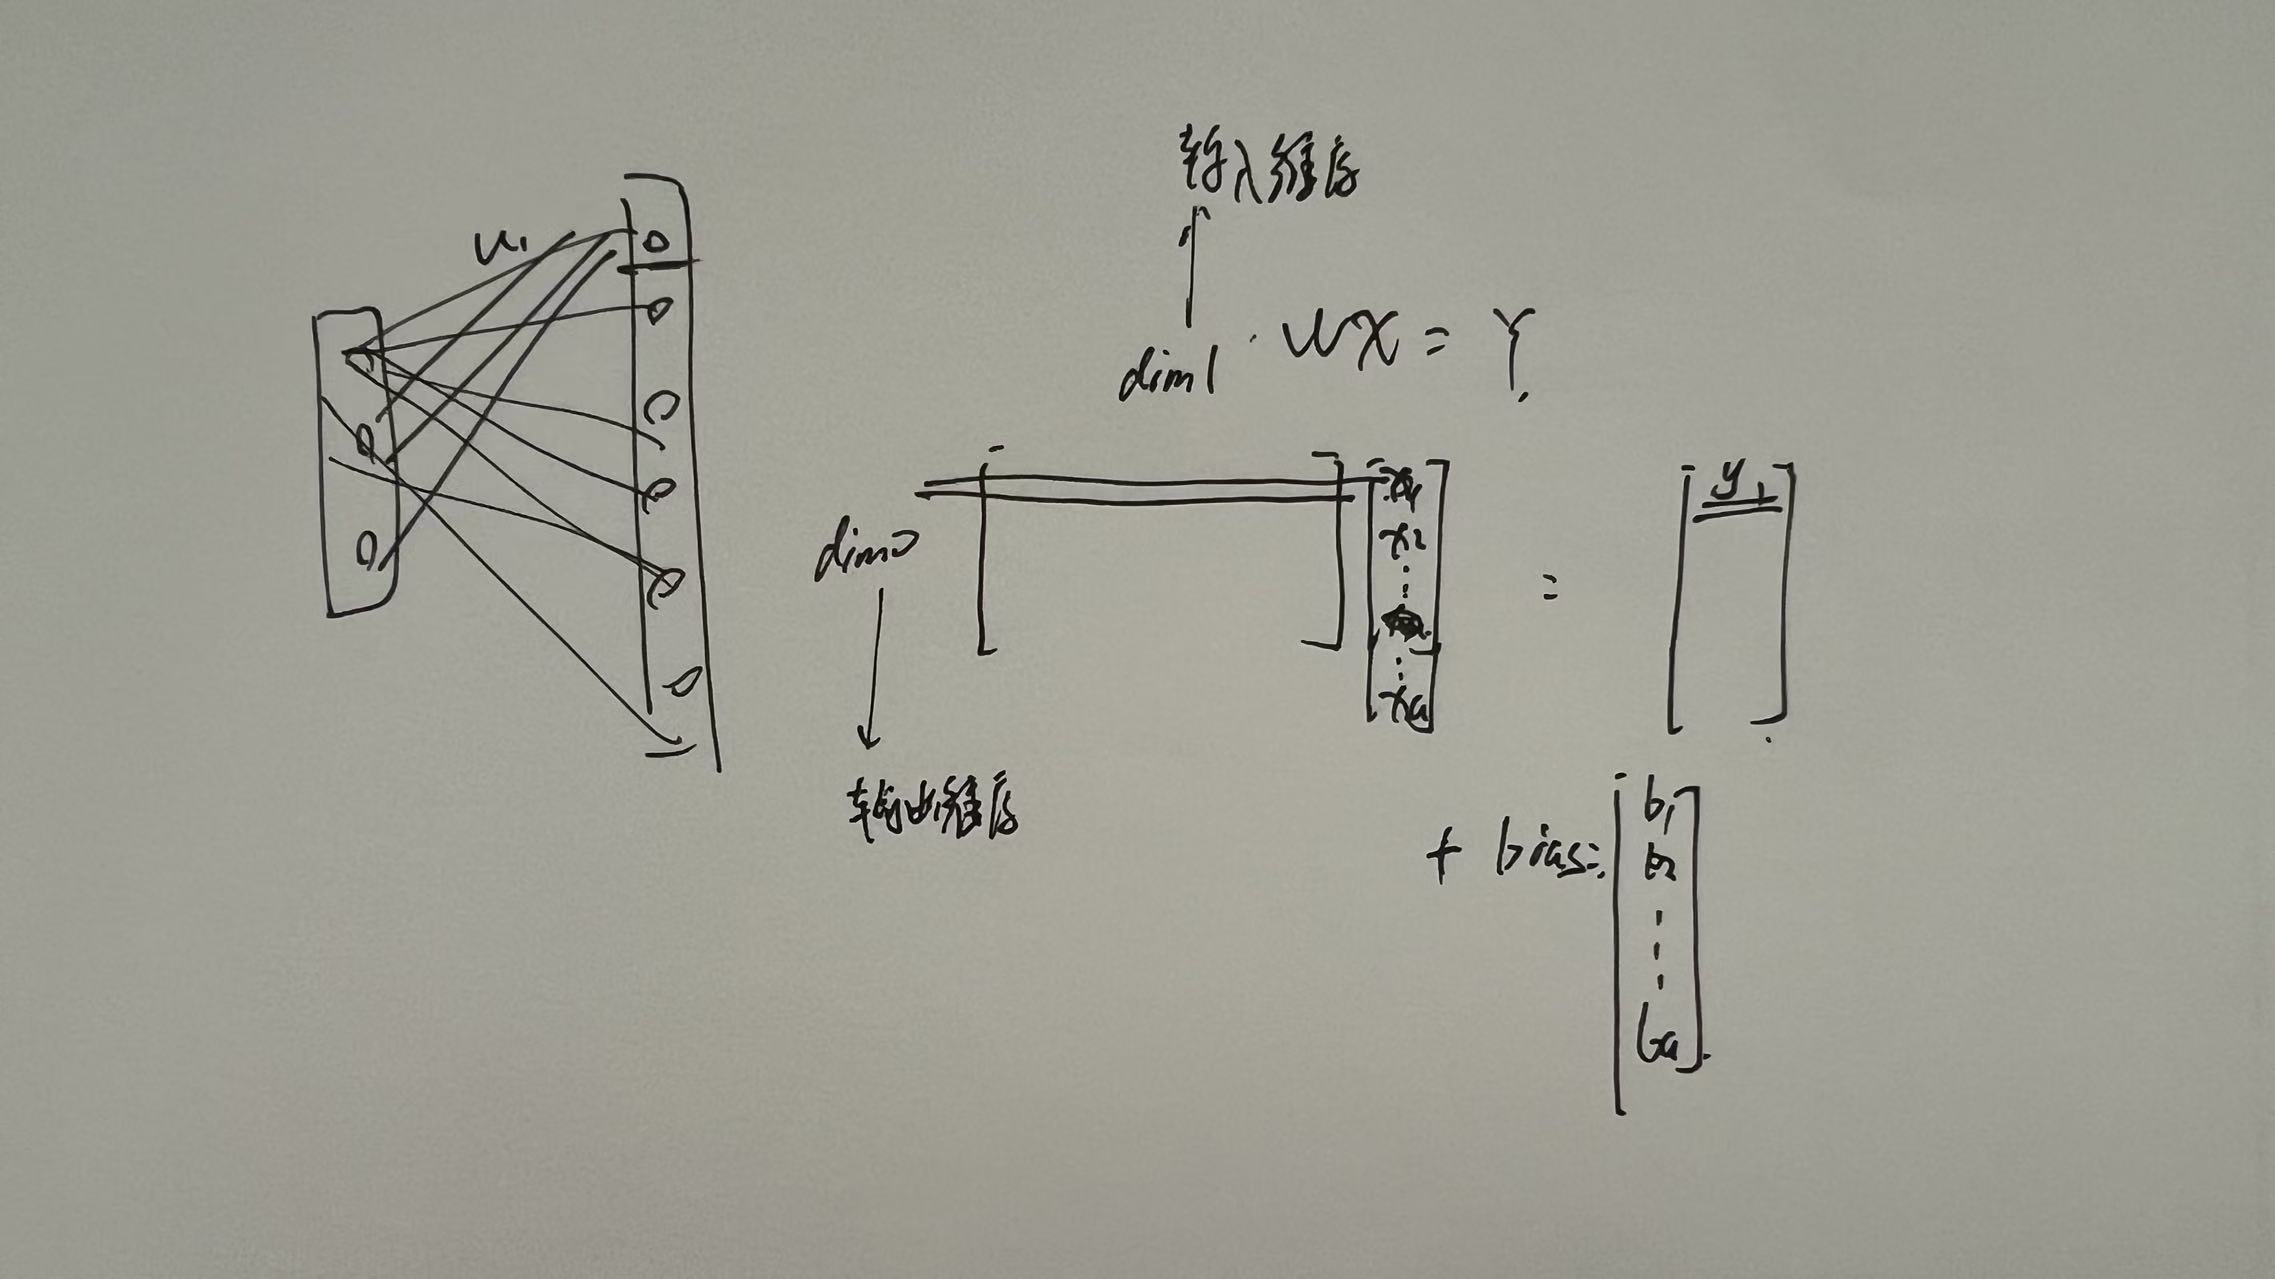
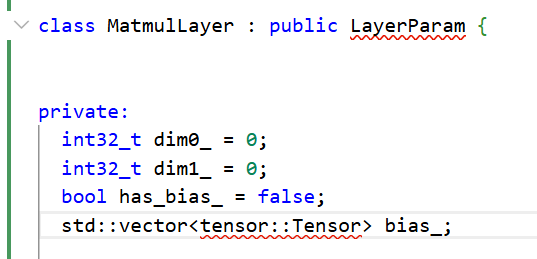
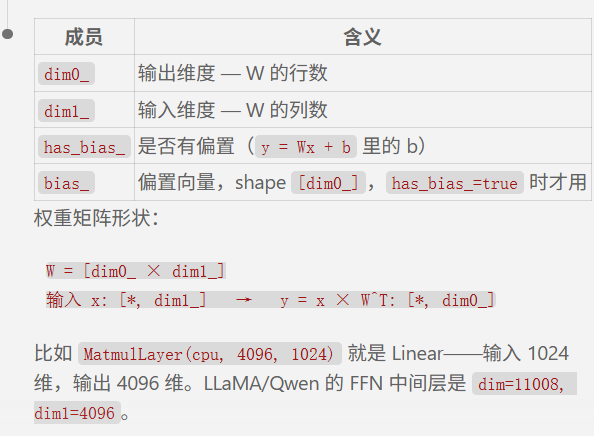
可以看到,这个矩阵乘的算子层,也是有权重参数的。设置权重张量,是直接用父类的方法,设置偏执张量,就要由子类提供。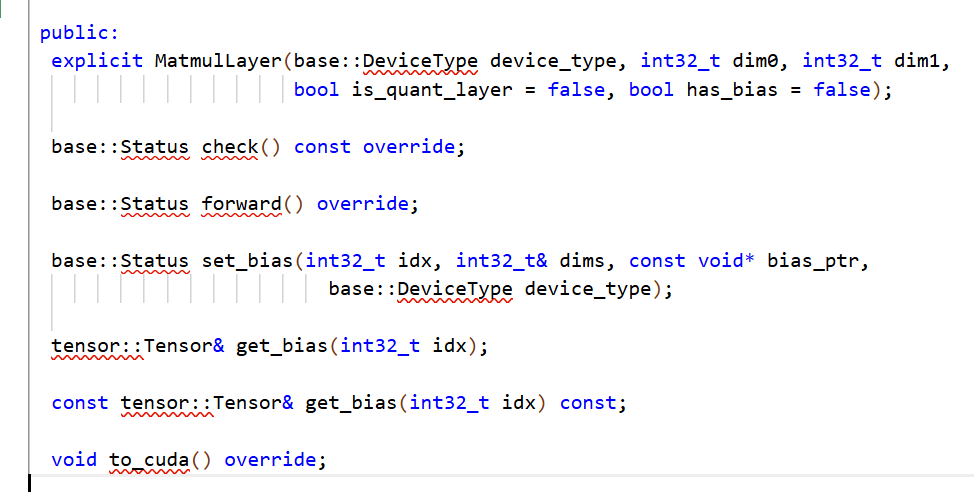
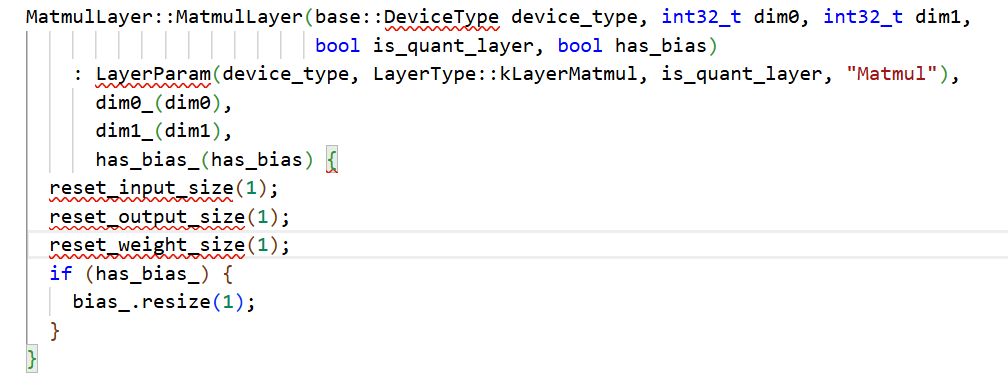
这里可以看到,矩阵乘算子层的输入张量1个,输出张量1个,权重张量1个。
后端实现,指向两个内核,一个是量化的内核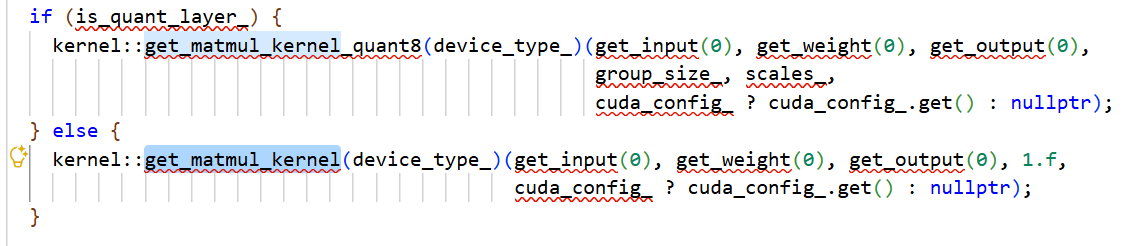
(旧)MHA多头注意力算子层(无权重)
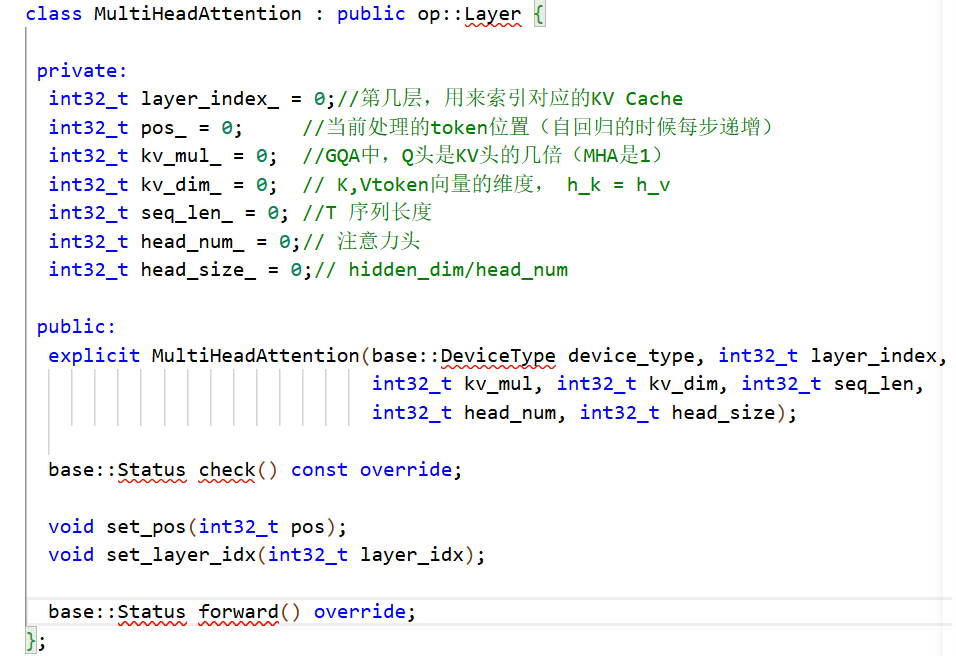
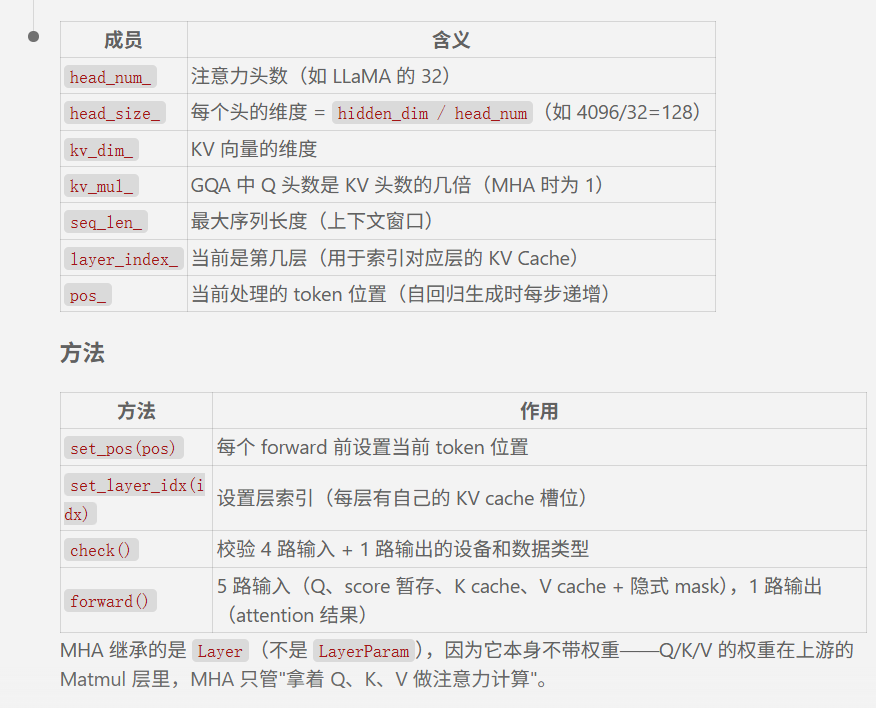
可以看到,多头注意力层,它本质上,是一个无权重的层算子。
下面看一下他的输入输出张量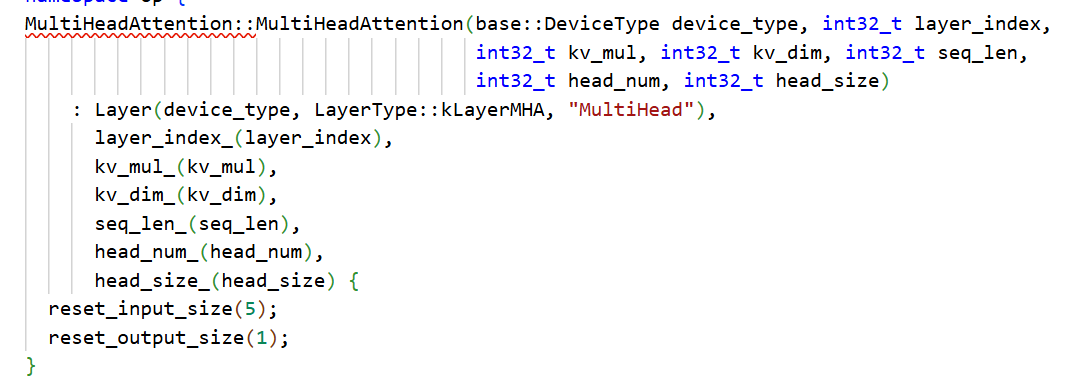
可以看到这个层算子,他的输入设置了5个张量,输出一个张量。
但是很奇怪的是,在推理过程中,我们就是一个张量进([B,T=1,d]),一个张量出[B,T=1,d]
但是这里,针对一个q, 我要计算得到一个注意力输出v_q,需要:
- q查询输入张量
- K cache (所有历史的k键张量)
- V cache (所有历史的v值张量)
- q 与 所有K cache的注意力分数张量
- 这个注意力分数score,理论上是属于临时变量,用来计算注意力输出的。但是每次都需要重新分配显存,通讯延时太慢,所以,选择和kv cache的内存空间一样,预先分配,用空间换时间
- 还有一个未用到
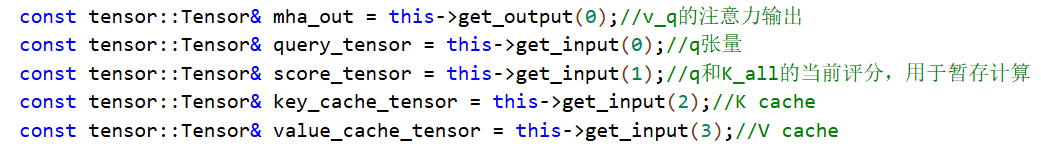
下面看一下这个多头注意力层的算子的前向传播
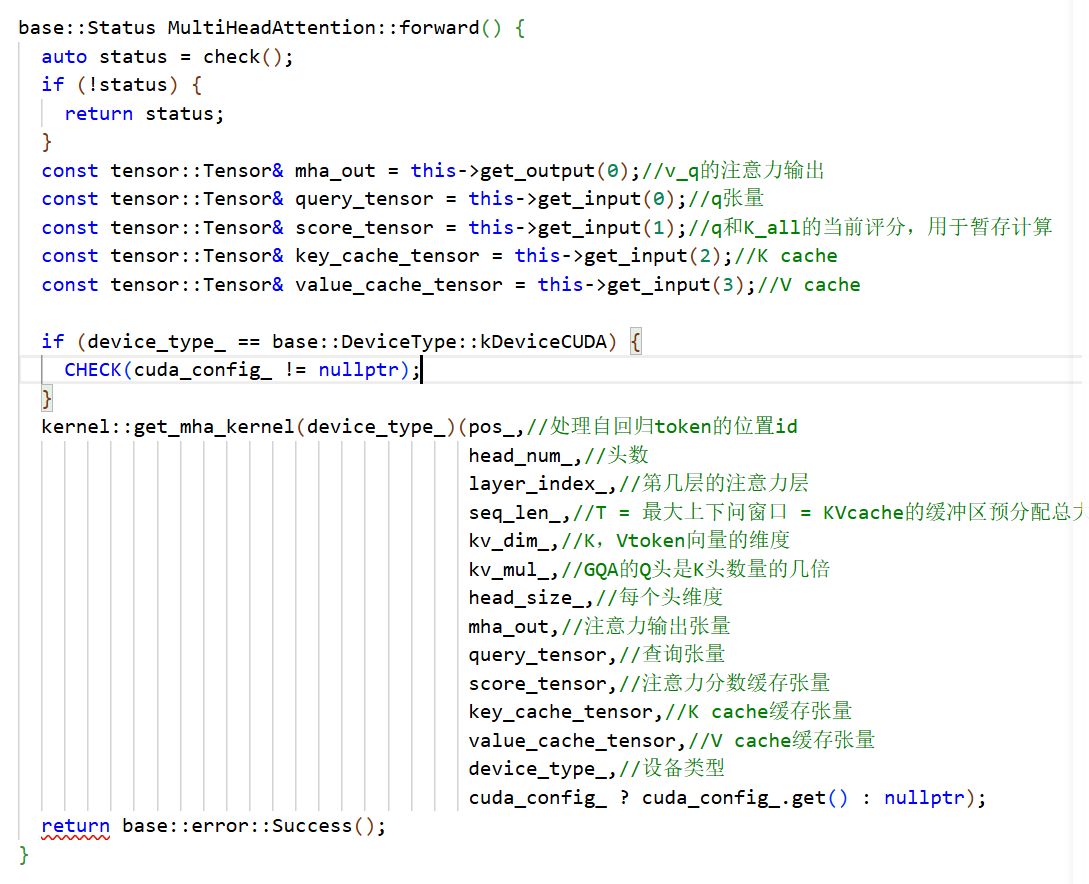
所以,当我们设计架构的时候,我们可以通过张量,把并行的需求,封装透传给底层的并行核心单元。中间的框架层,不需要处理这些并行的需求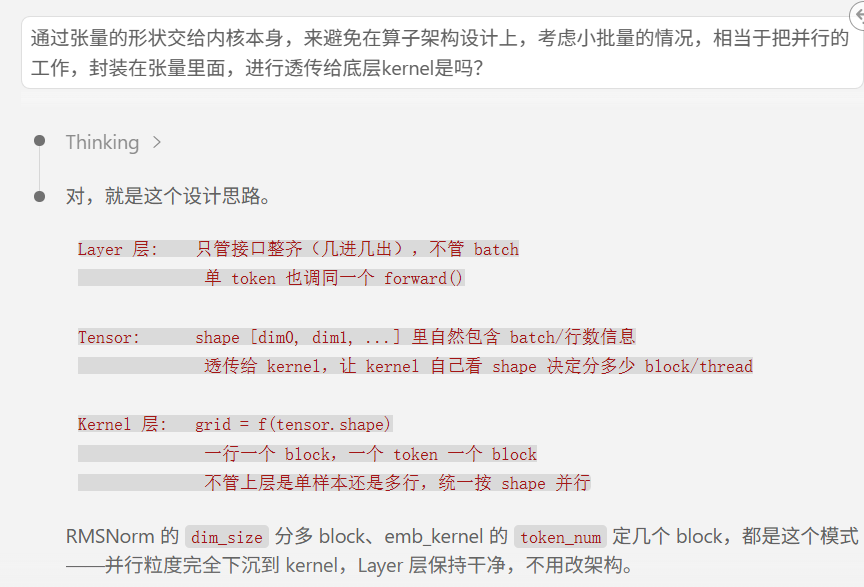
4. model/模型组装层
这一层,就是用上面的各个算子层,来具体组合出一个大模型的类。
我们先来介绍一下,我们下载下来的模型文件有哪些内容:
huggingface下载的模型文件
包含:
-rw-rw-r-- 1 liangji liangji 726 May 17 19:23 config.json |
config.json
- 模型的架构参数(层数,模型维数,头数,词表大小)
generation_config.json
- 采样器的超参数
model.safetensors
- 模型权重,有他的特定格式。
tokenizer.json
- 词袋
- 传给第三方的分词器类就行, 主要用这个

tokenizer_config.json
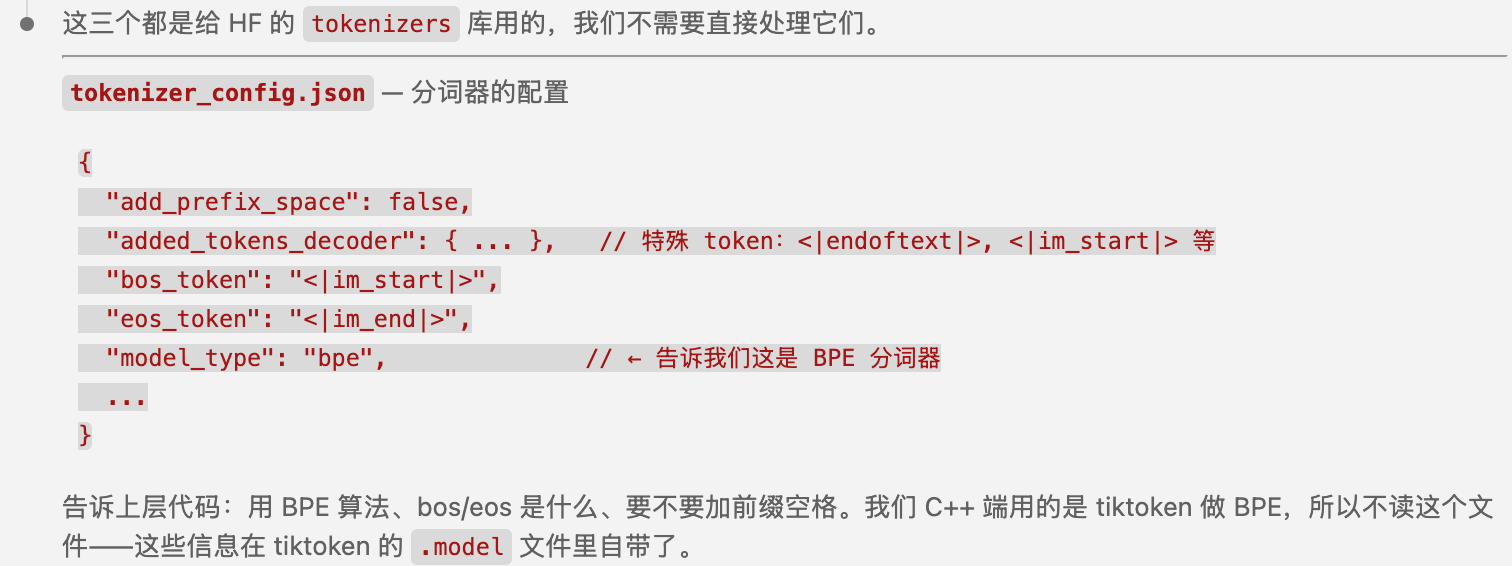
- 存特殊 token 配置
- 分词器元信息(bos, eos token = ?)
- 这个里面的tokenizer_class = Qwen2Tokenizer, 暗示BPE类分词器
- 用来选择
vocab.json
- 词表映射文件
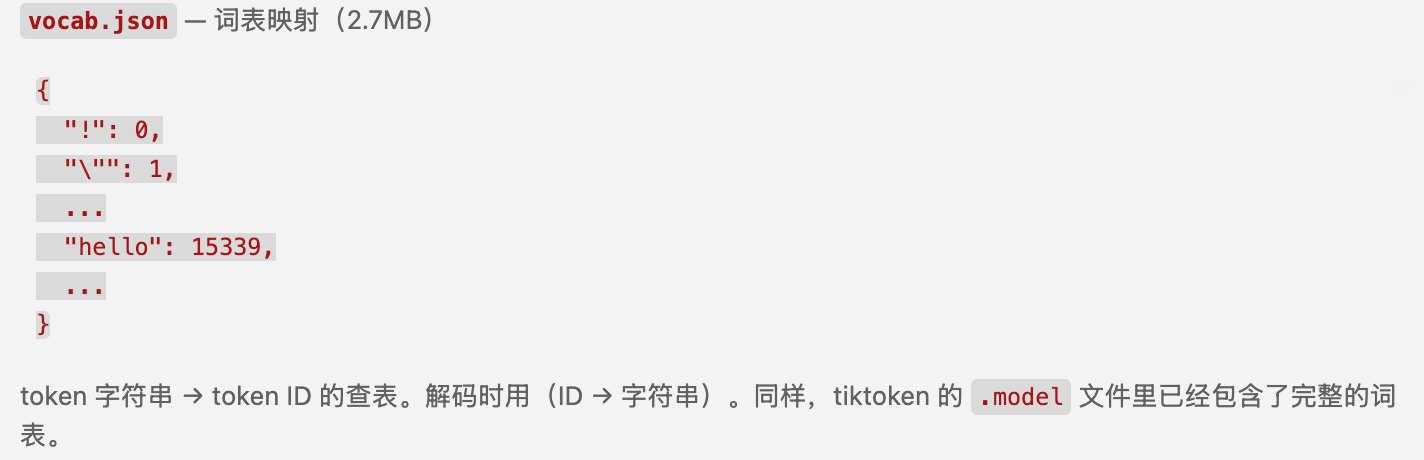
算法类型(BPE/SentencePiece)是”约定俗成”的 — Llama2 用 SentencePiece,Llama3/Qwen 用 BPE,你下载前就知道。
模型文件的格式处理
- 架构文件,config.json
- 这个没多少,主要定义层数,模型维度这些,看一下,读取直接用就行
- 权重文件,model.safetensors
- 这个很多,而且是safetensors的特定格式,我们自己的推理框架cpp无法直接使用,需要格式转换
转换方法就是,
- 先用torch库,自己写一个model.py,里面实现我们的整个模型的类。
- export.py中,先读取config.json,import model, 实例化我们的模型类
- 在这一步里面,我们把官方的权重变量名,和我们自己的权重变量名对应上
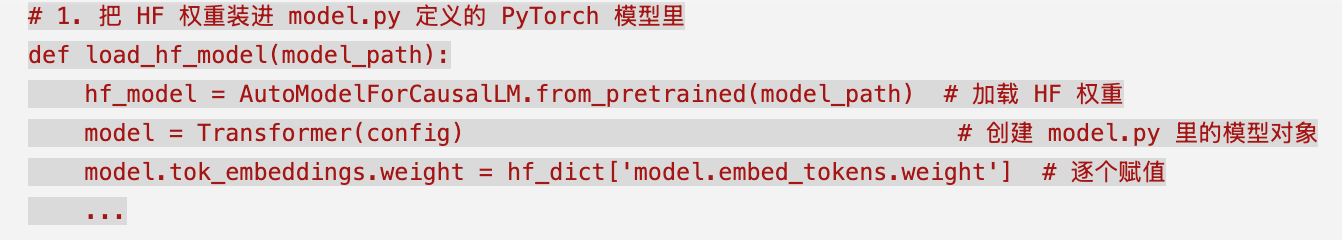
- 按照我们想要的存储结构,导出模型的各个权重张量。
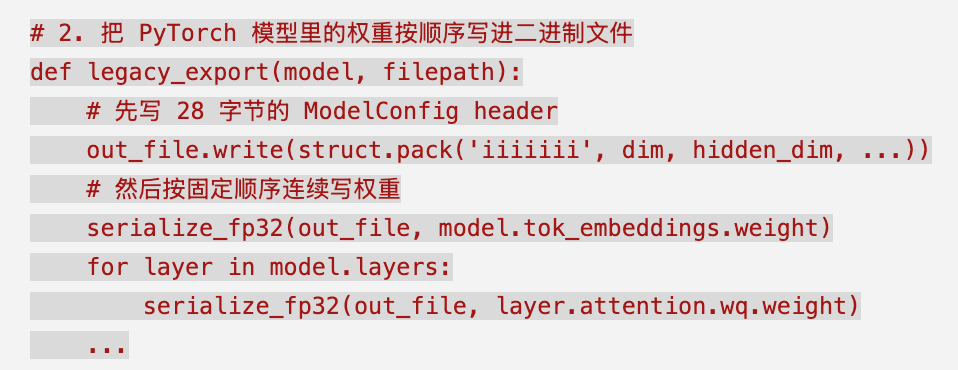
最终,会产生一个新的model.bin, 里面包含
- 模型的架构配置
- 模型的权重
之后,我们在自己的cpp的推理框架中,就可以直接用mmap+地址偏移,来直接读取
┌────────────────────────────────┐ offset 0 |
model的基类
- model (基类)
- 模型的基础信息
- 推理设备
- 模型名称
- 模型的入口,出口
- 入口:分词器层算子
- 出口:采样层算子
- 模型的配置信息(config.json)
- 模型的配置架构:config.json
- 权重文件
- 分词器
- 词袋(tokenizer.json)
- 分词算法
- 提前申请的缓冲区
- 各层的输入输出张量缓冲区
- kvcache
- 量化标志
- 模型的基础信息
5. demo构建
6. profile性能分析
性能指标
首先,先给出我们分析一个推理框架系统的性能指标:
- 端到端性能指标(测结果,快不快)
- TTFT
- TPOT
- 端到端延时
- 吞吐量
- 显存占用
- 阶段性指标(找原因,为什么不快)
- prefill
- 各层的耗时
- decode
- 各层的耗时- Nsight System
- 各个kernel的耗时,找出瓶颈kernel
- Nsight Compute
- 单独分析kernel性能
- Nsight System
指标术语
- benchmark = 基准测试
- 在固定条件下,正式测性能,统计端到端指标
- Benchmark 用来得到一个可重复、可对比的性能结果。
- Benchmark 告诉你“快不快”
- profile = 性能剖析
- 时间到底花在哪里,为什么慢。
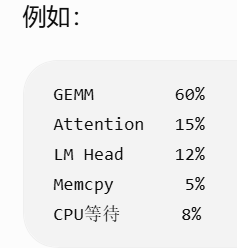
- profile又分成两类:
- Nsight Systems:看整个 CPU、GPU、kernel、内存传输的时间线
- Nsight Compute:深入分析某个 kernel 的访存、计算、occupancy、stall
所以,
Benchmark:测结果
Profile:找原因
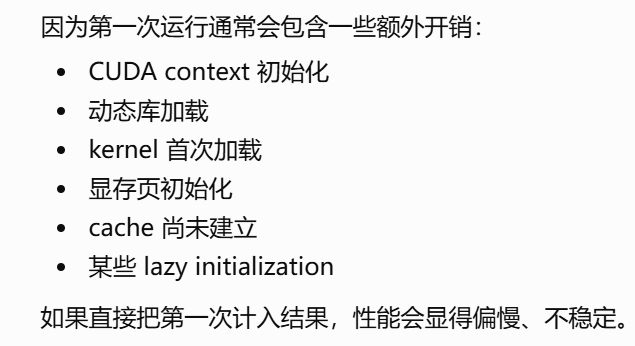
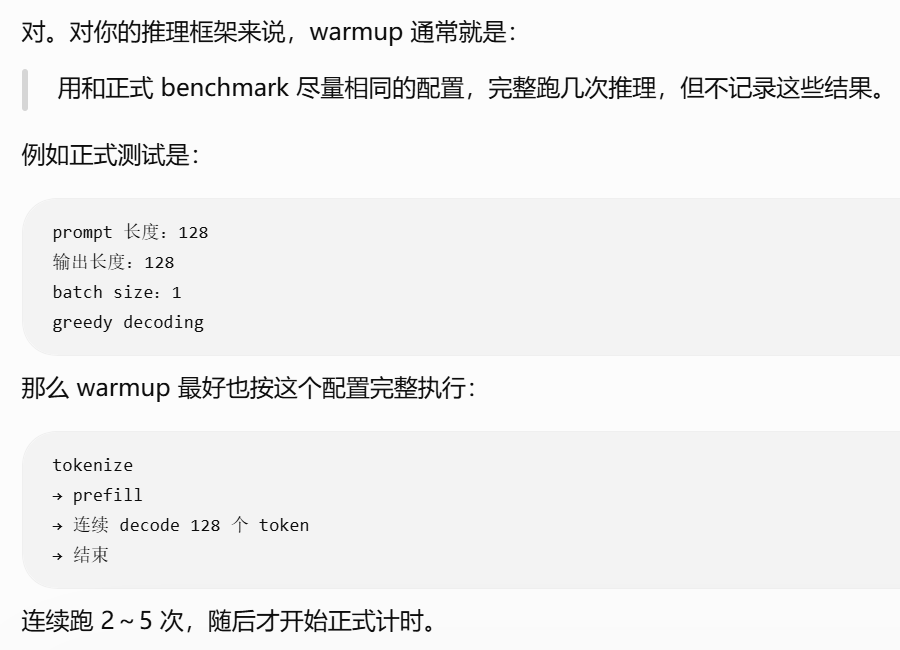
warmup = 预热运行
- 正式计时前,先运行几次,但不记录结果
NVTX = 给 Nsight 时间线添加标签的工具
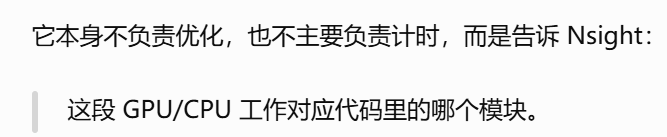
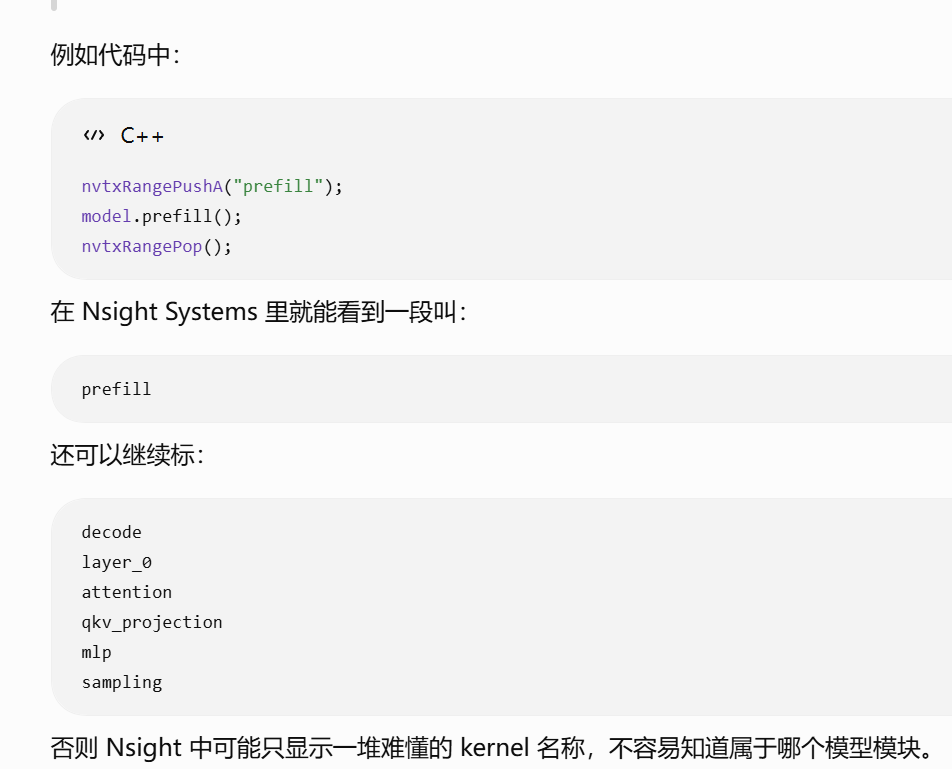
Warmup |
ITL:每个 token 之间的间隔统计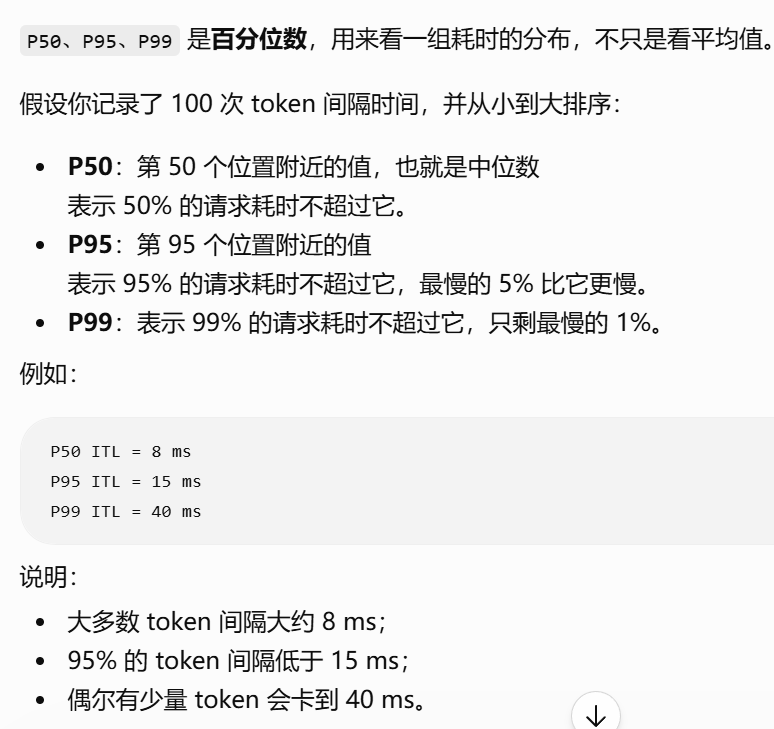
实现
1. nsight system的打标基础工具,nvtx3
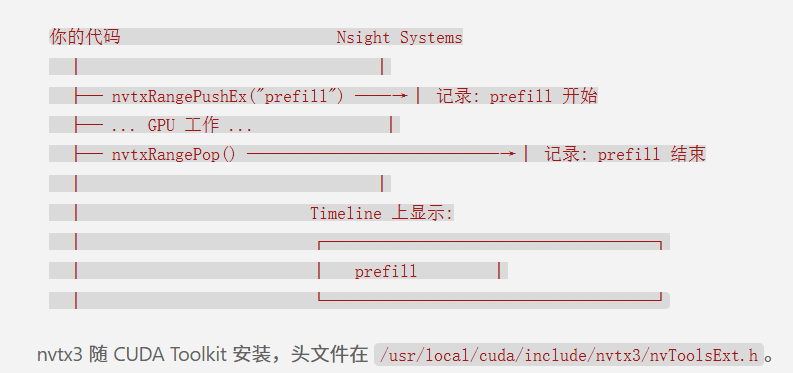
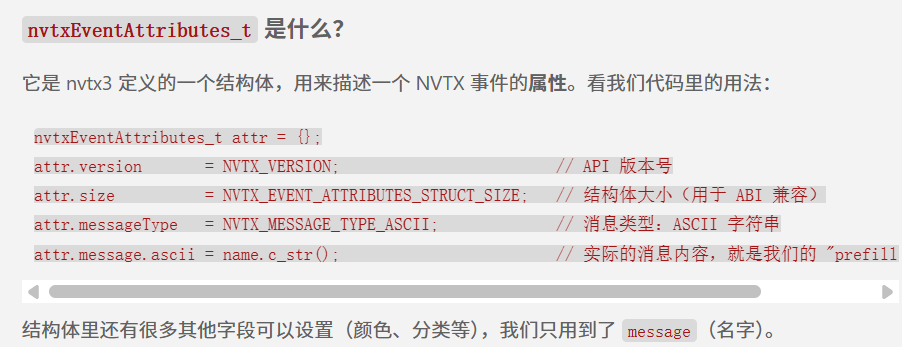
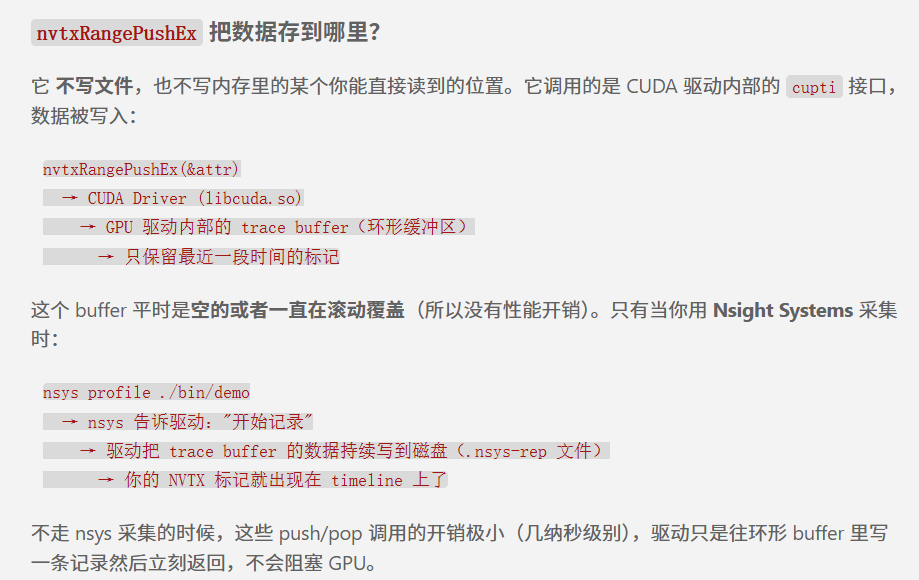
他先搓了一点基础工具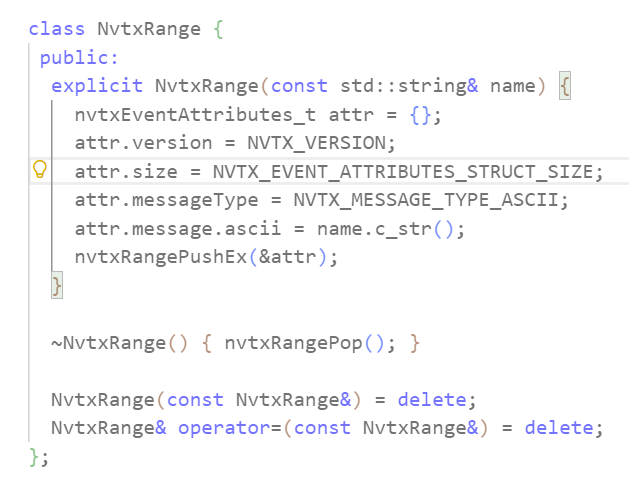
他自己写了一个打标的类,构造一个对象,然后把自己注册到nvtxRangePushEx里面来打标
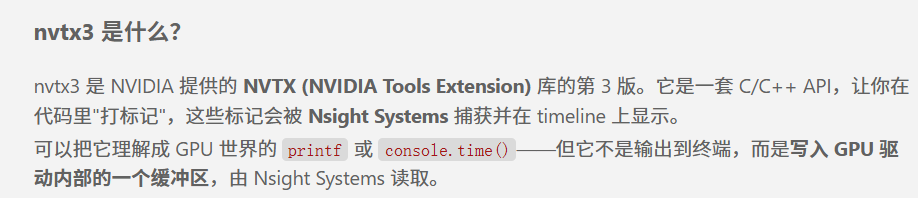
回到我们的代码
// 开启 ENABLE_NVTX 时: |
所以整体的数据流是:
NVTX_RANGE("prefill") // 你的代码 |
下面介绍他是如何具体实现nvtx打标,然后在nsight system上看到打标的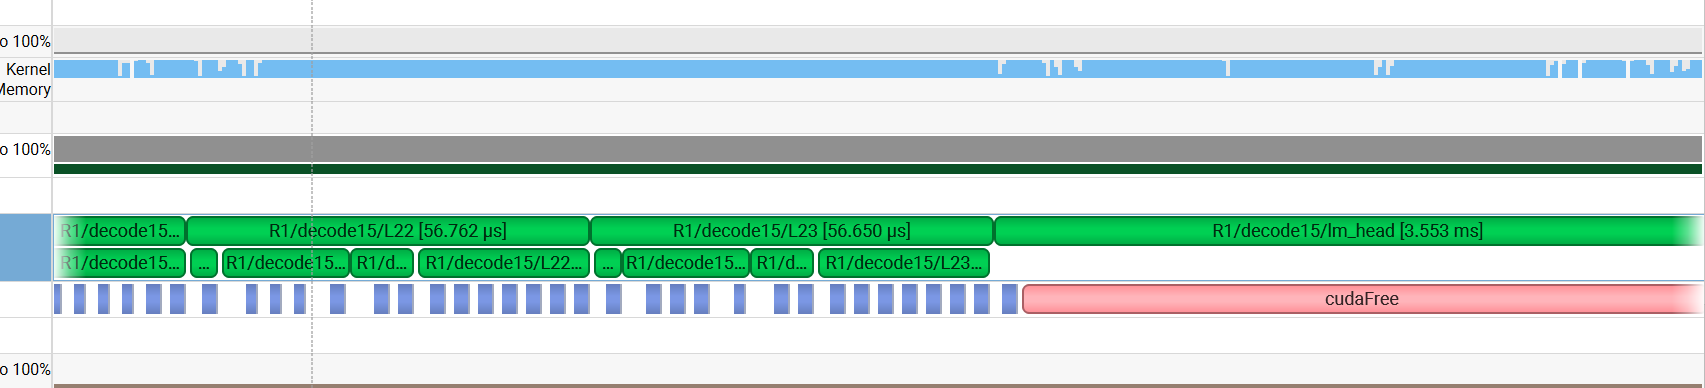
这边定义了两个宏,用来构造创建nvtx标签的实例。
后面在构造函数中,往cuda驱动的缓冲区打标签,析构函数中弹出标签。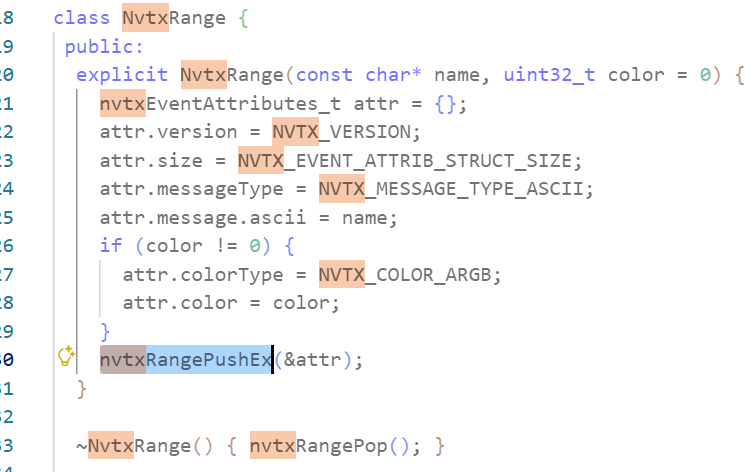
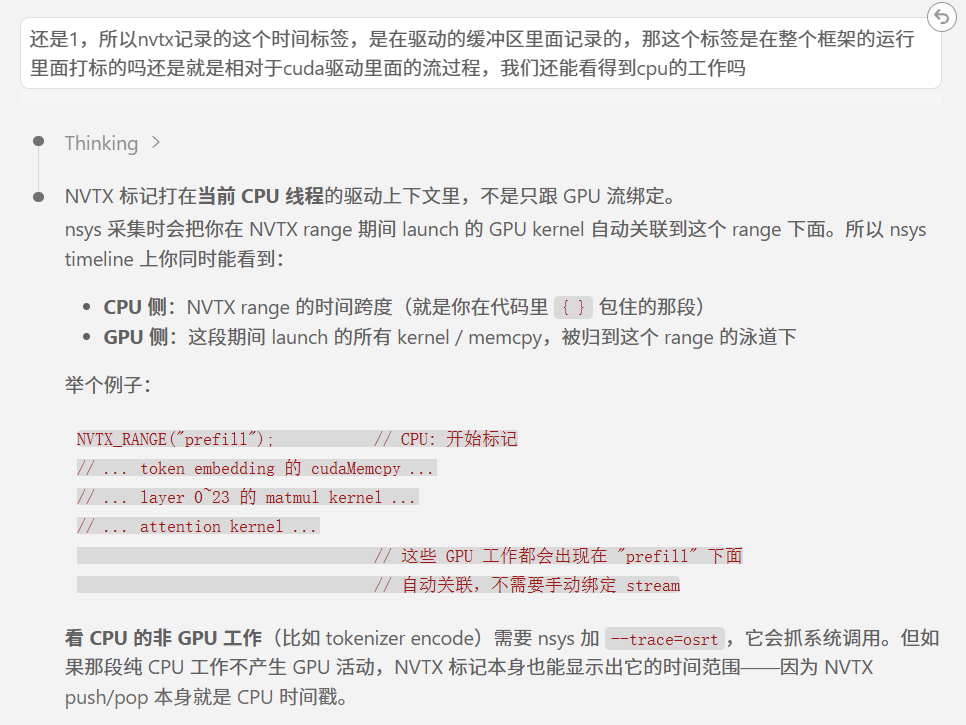
所以,计时开始就是push的cpu时间,弹出时间就是计时结束。
以rmsnorm为例
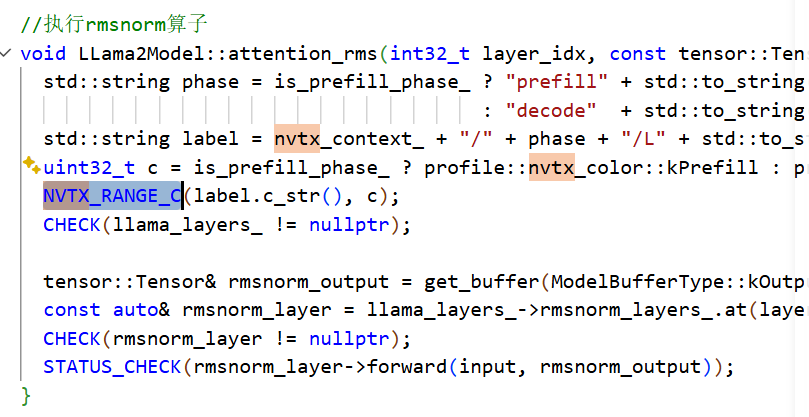
在llama3.cpp中,attention_rms这个调用算子的过程,NVTX_RANGE_C开始打标。这个实例对象的生命周期,和最近的{}绑定,结束后pop析构,计时结束。因此就可以实现对一个生命周期的追踪。
我们实际上要统计的,就是从NVTX_RANGE_C开始,到rmsnorm_layer->forward结束。
但是这个forward一直追踪到调用核函数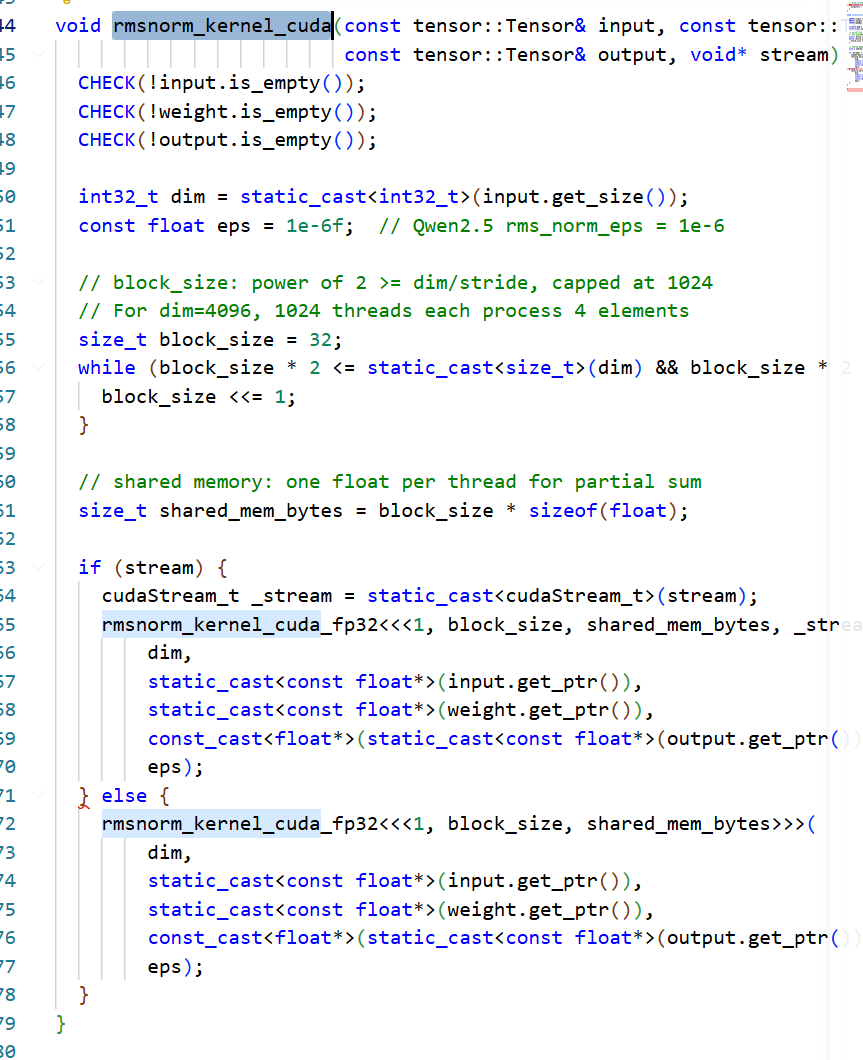
cpu调用核函数之后,没有阻塞等待直接返回。所以我们的nvtx打的标签记录的时间,本质上是cpu时间,因此,我们的kernel的实际运行时间,是会有可能右端超出标签弹出时间的。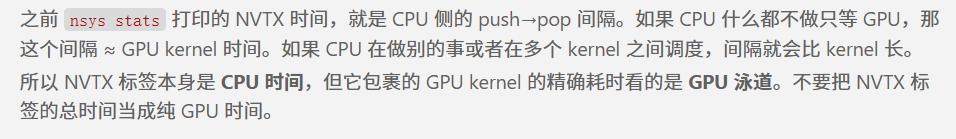
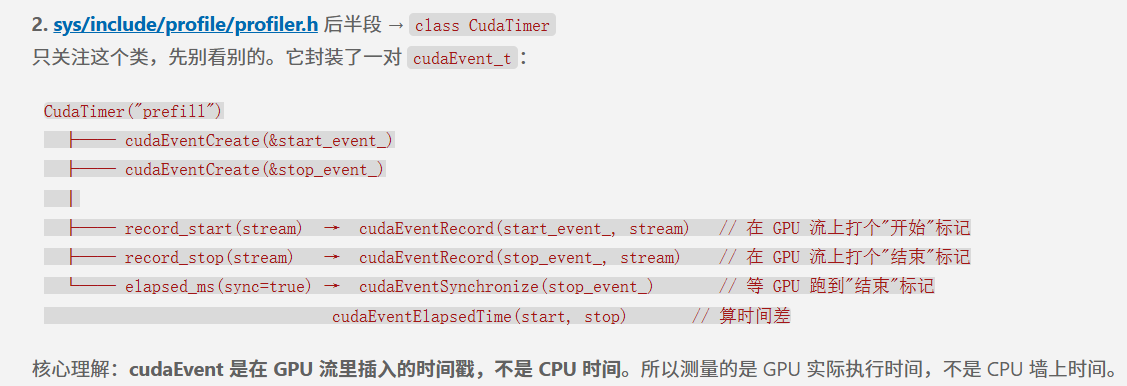
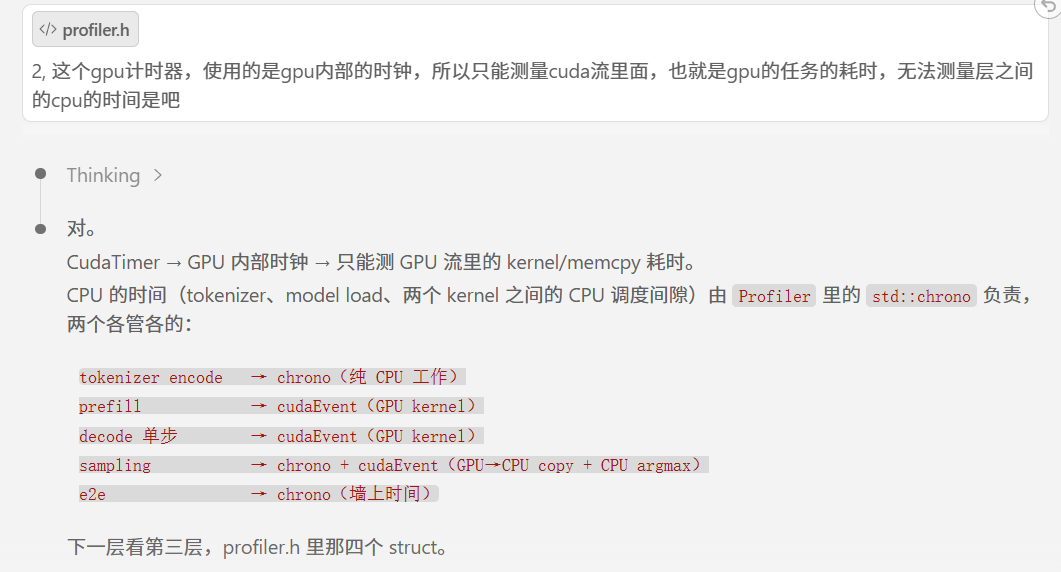
2. gpu计时器(cudaEvent)
定义了cudaTimer的类
// ============================================================ |
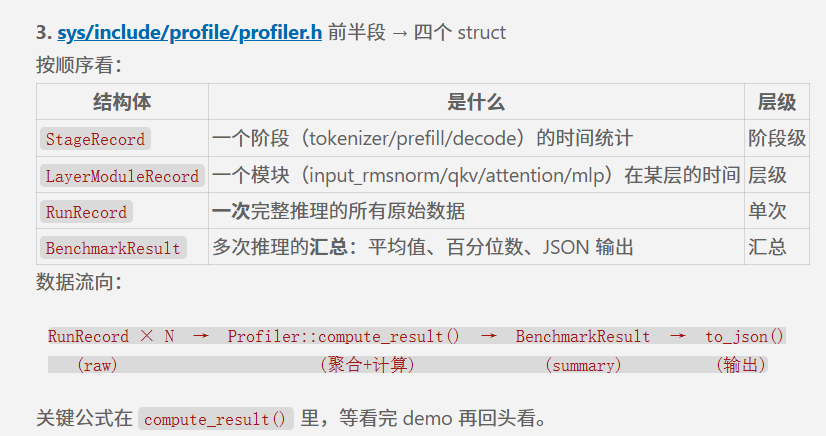
3. 定义汇总结果 结构体
4. Profiler 类(统计总管)
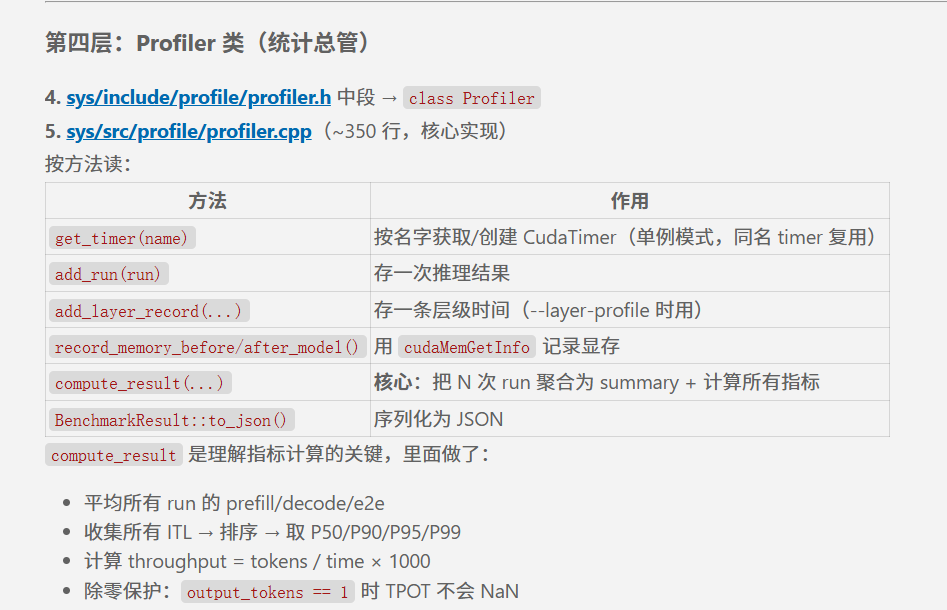
profiler相当于MemoryAllocator,用来创建/读取我们的timer类对象
class Profiler { |
5. 模型集成
在class model类里面新增了一个成员属性: profile::Profiler* profiler_ = nullptr;
在调用cuda算子层之前,前后加入两个event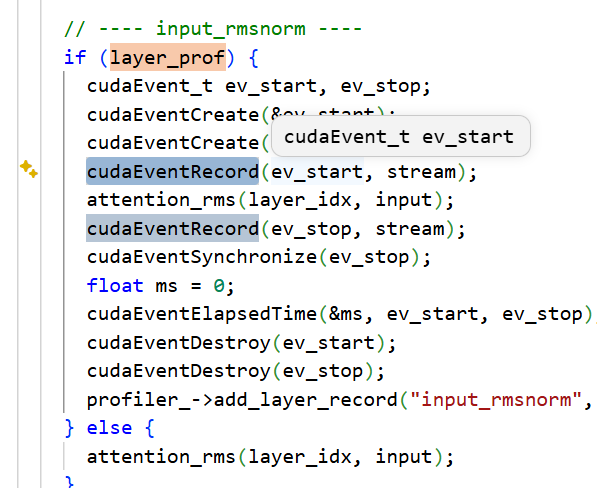
6. 开始测量
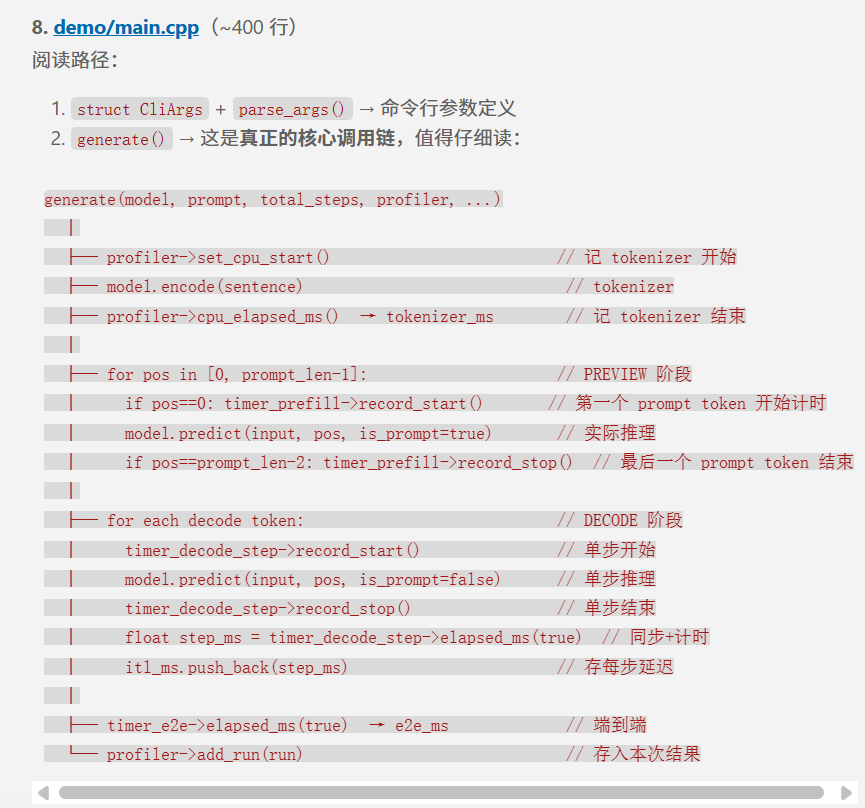
总结
benchmark
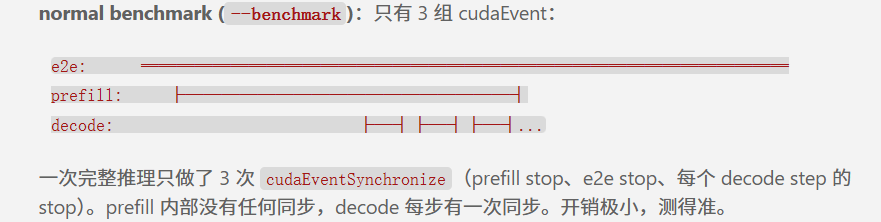
- 可得:
- TTFT, prefill throughput
- itl(每token耗时), TPOT, p50, p95
- e2e 端到端延迟
- 这一步仅在prefill, decode之后,加入sync, 数量不多,因此对性能影响不大
layer profiler
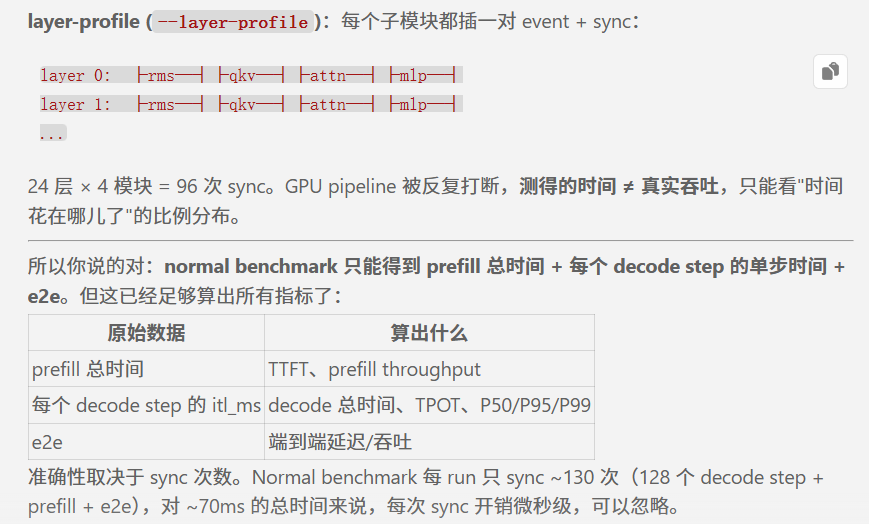
- 这一步,需要你自己针对每个layer,让cpu来sync等待gpu的算子结束运算,来粗略的统计每个layer的运行时间。但是注意,由于sync次数很多,所以对整体性能影响大,只能用来统计每个layer的占比
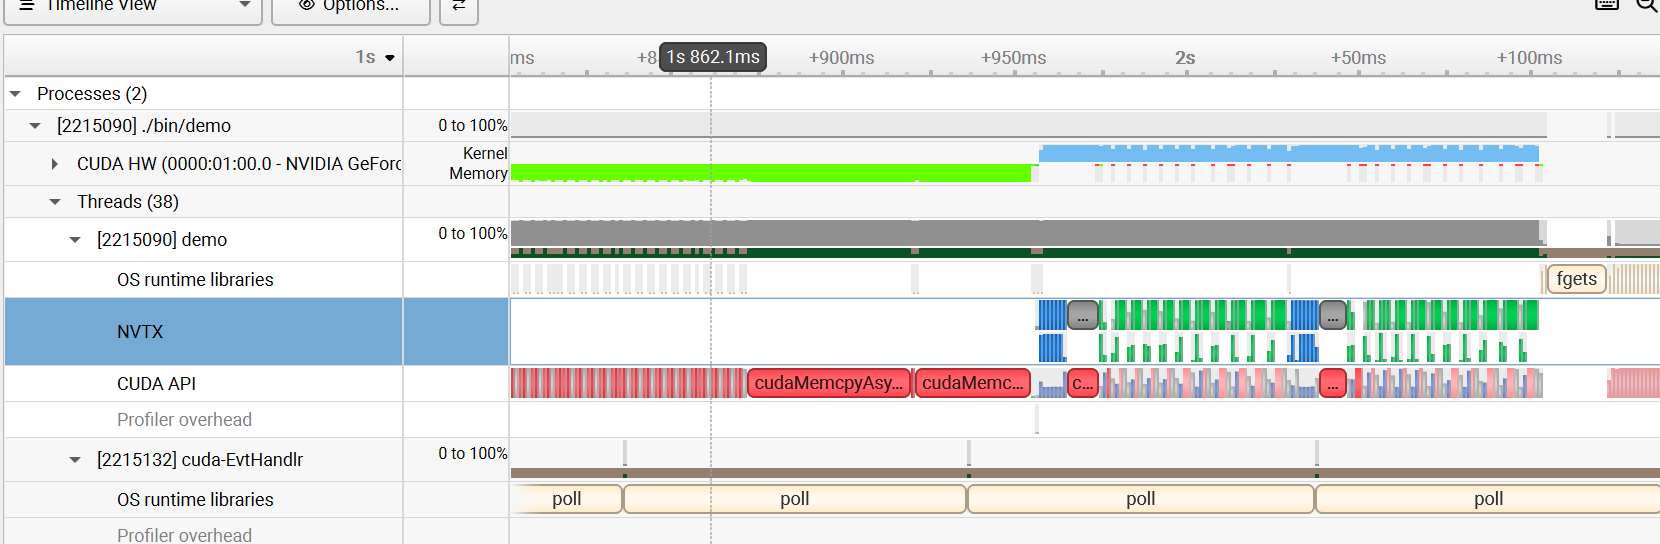
Nsight system
- 这一步就是查看时间具体花在哪一个kernel上。
Nsight compute
- 具体分析kernel的设计
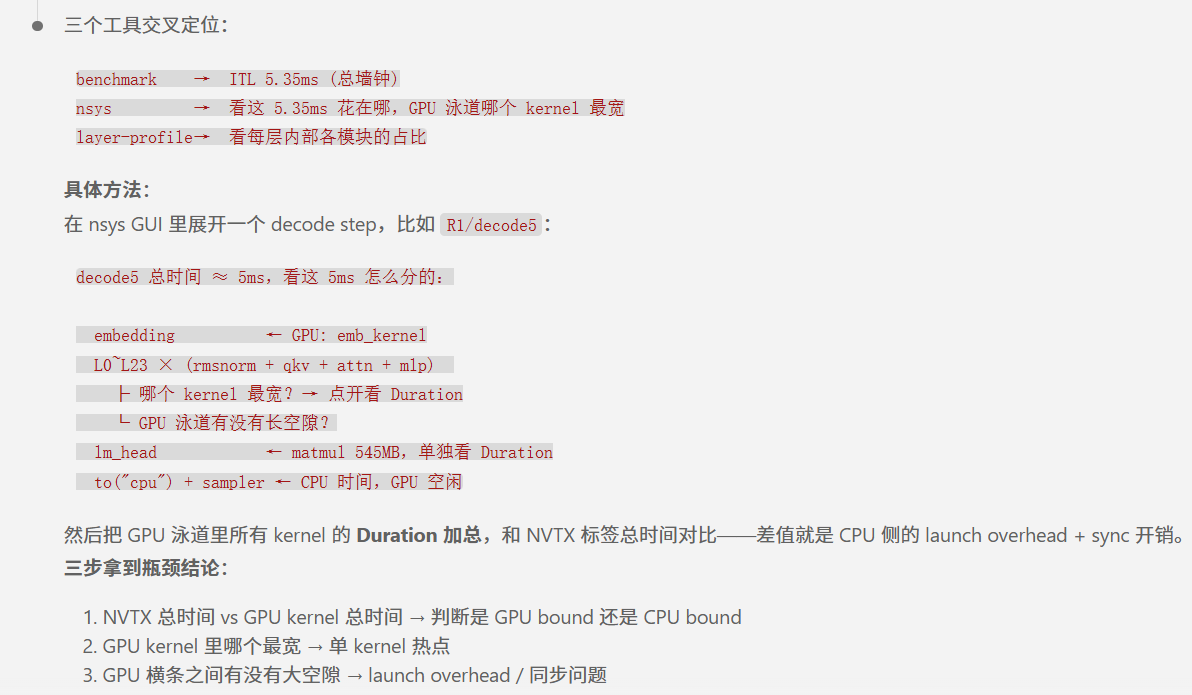
所以整个profile的性能分析流程应该是
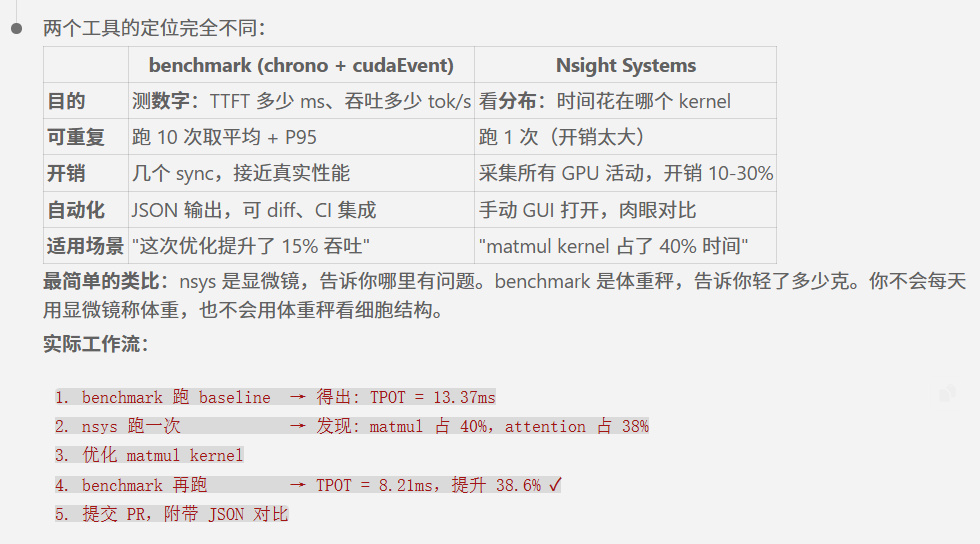
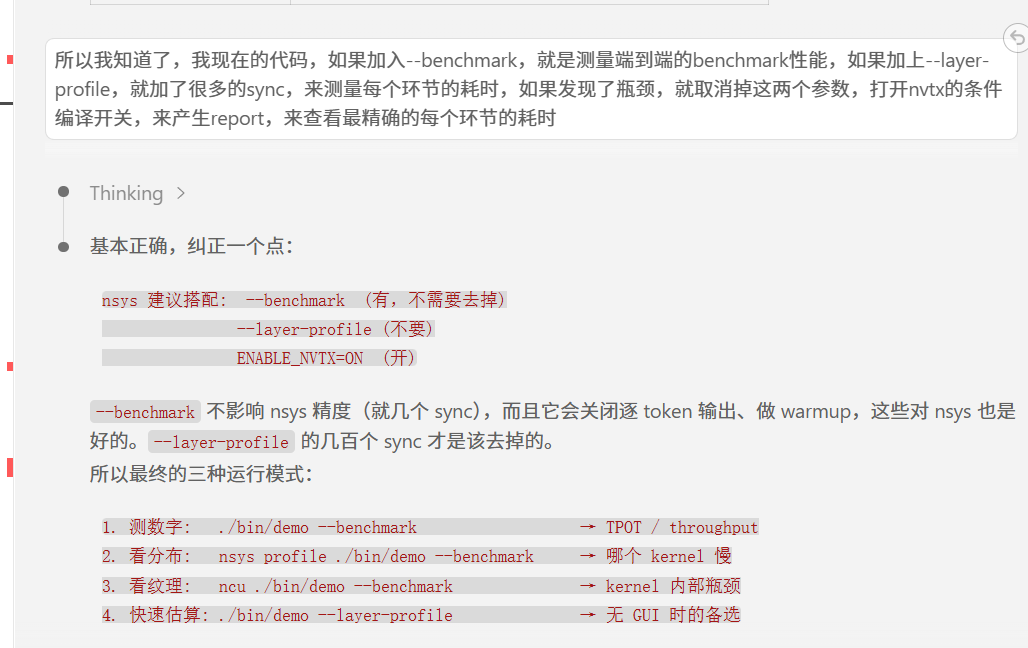
整个demo流程分析
我们目前在demo的单prompt推理中,规定:
- prompt: 6个token
- prefill输入是5个(无需采样)
- 第六个token开始属于decode阶段
- 最大产生长度16个token
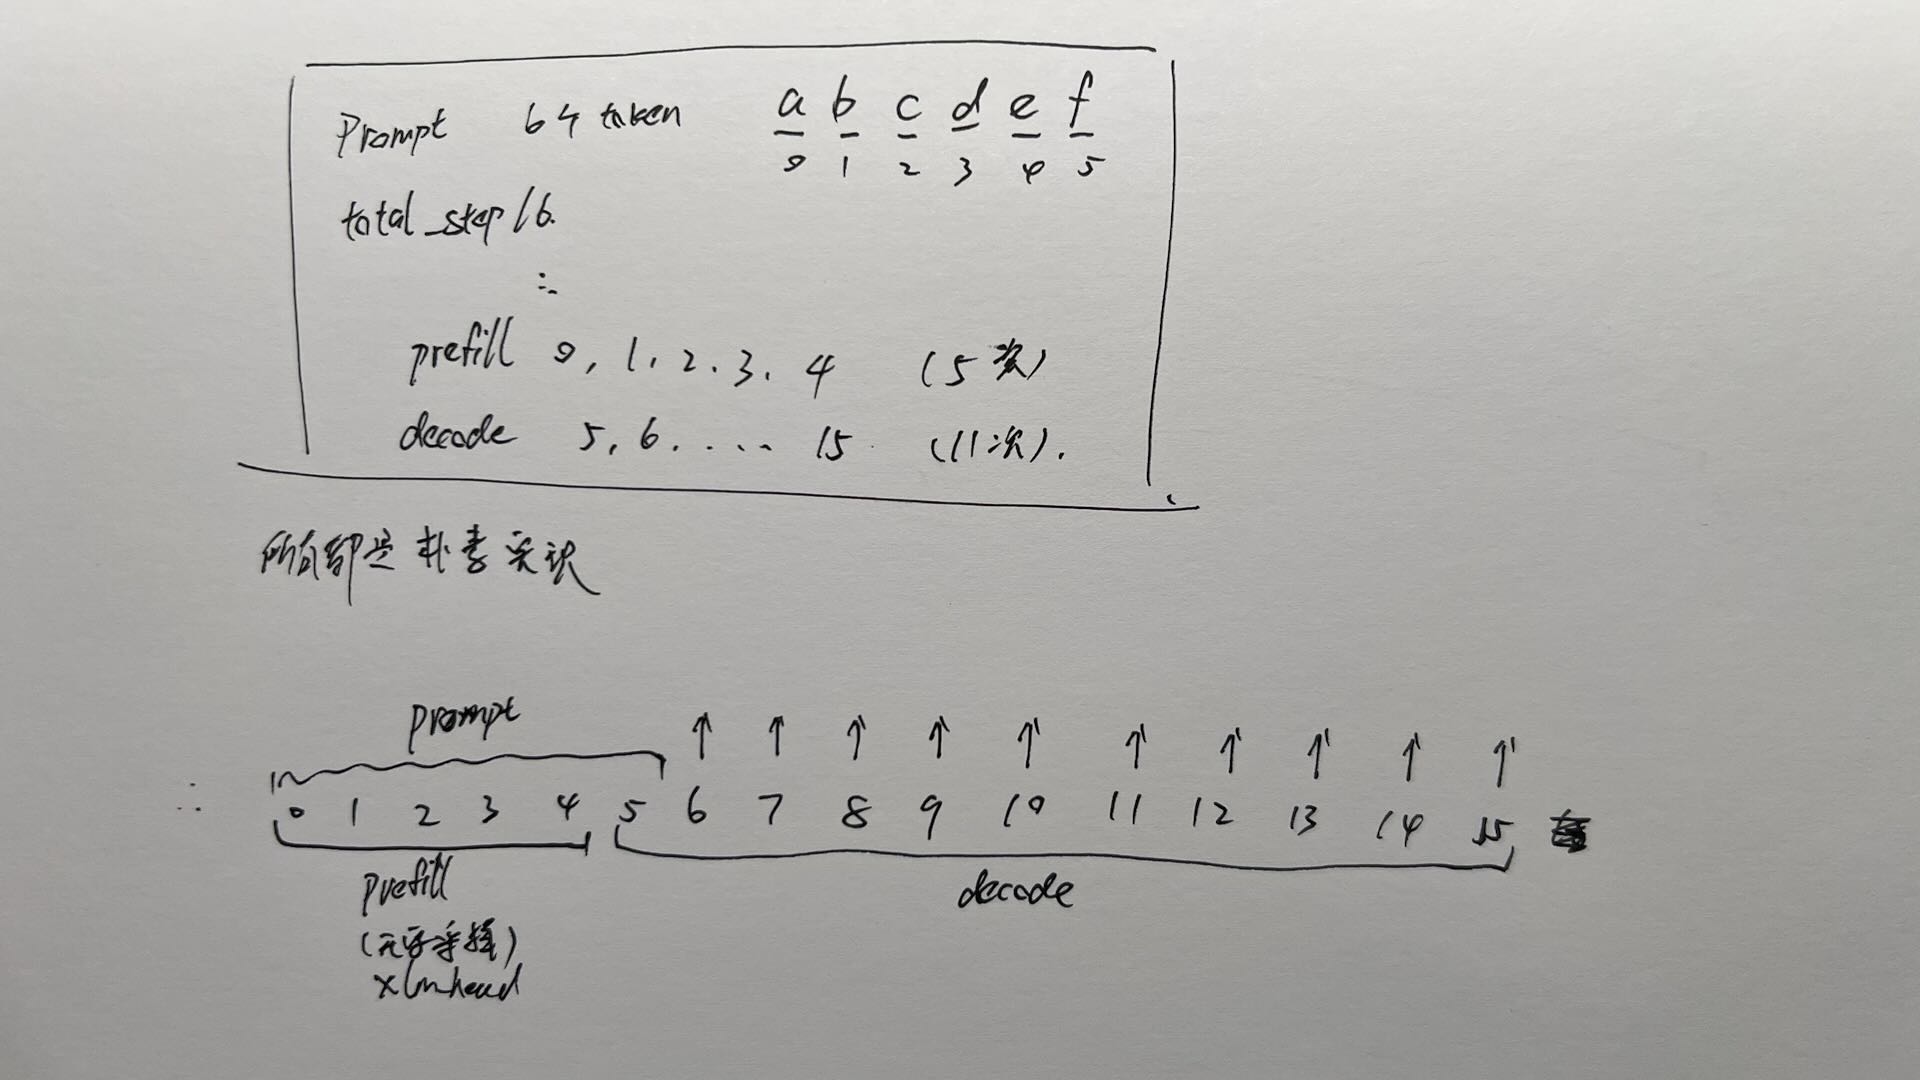
完成一次推理的过程如下:
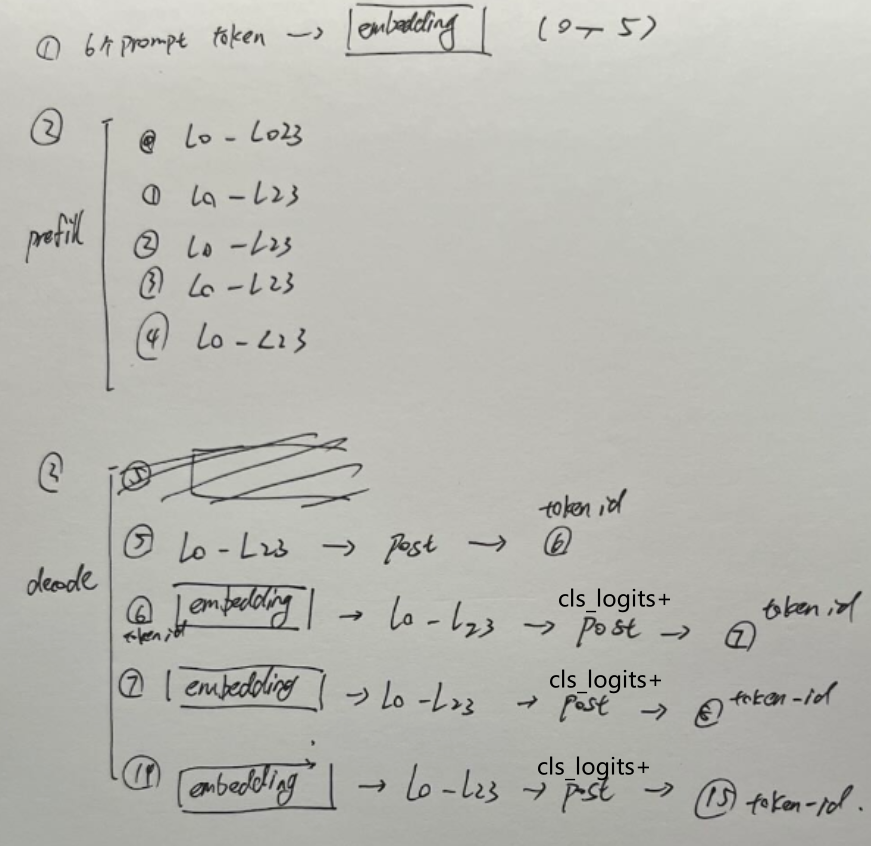
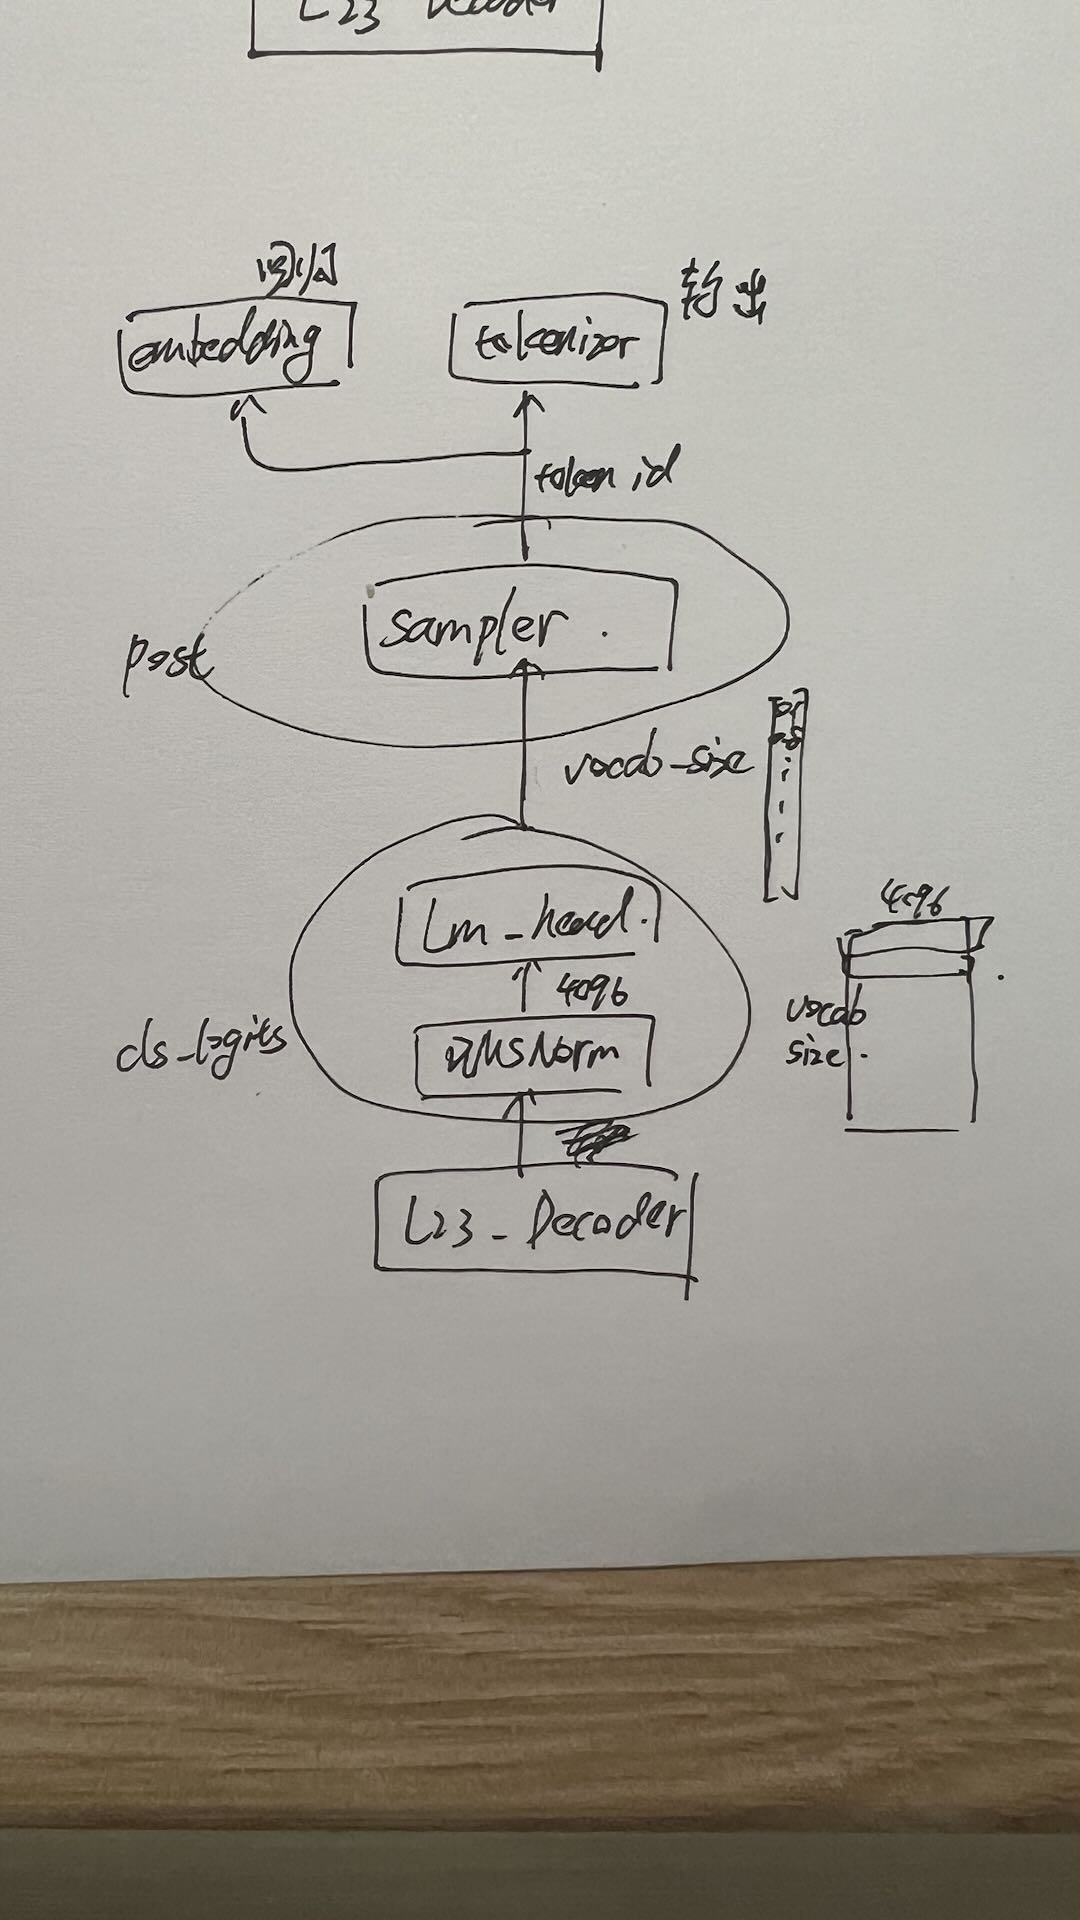
profile流程分析
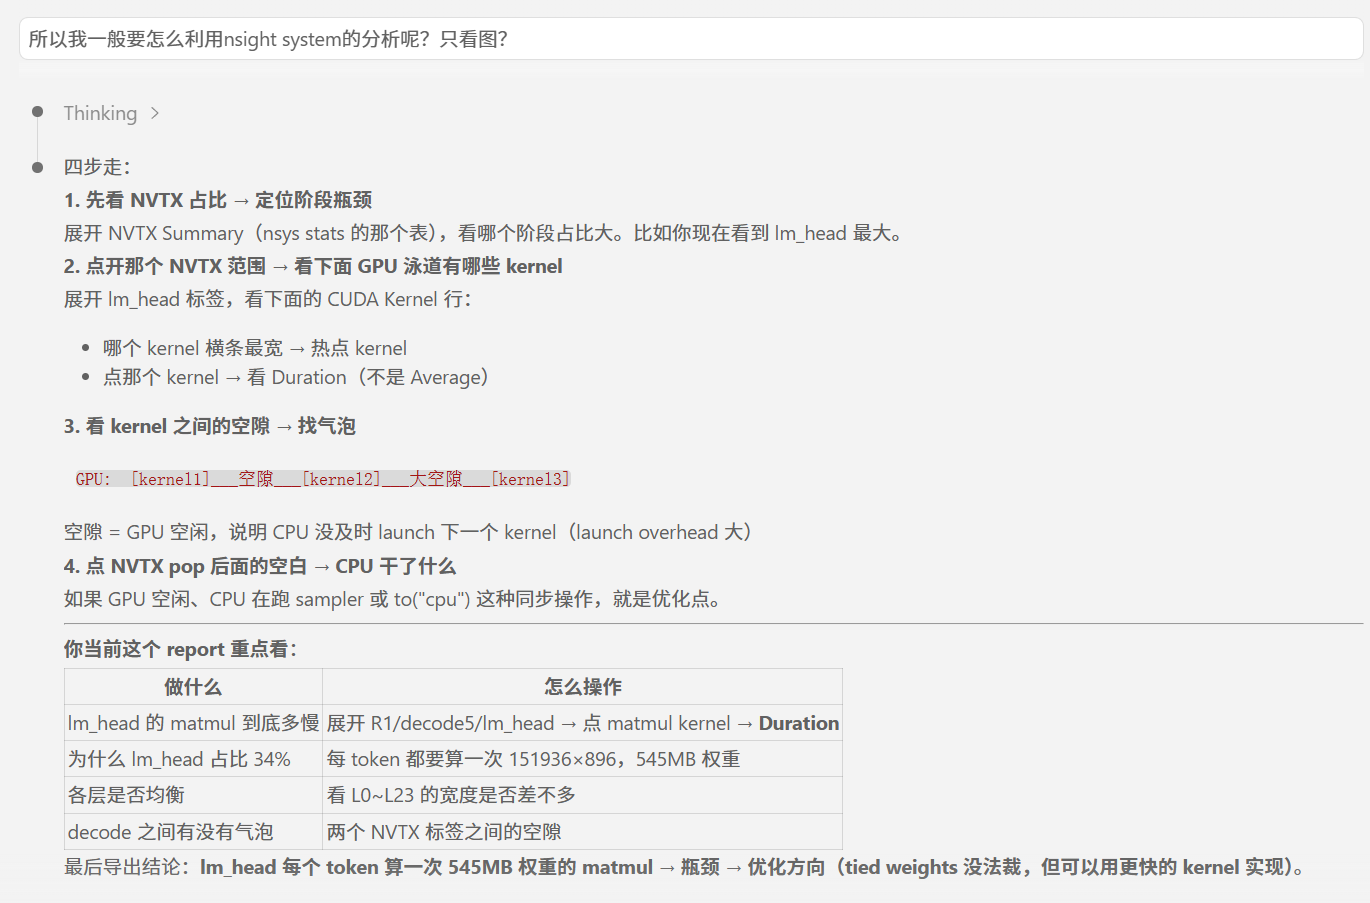
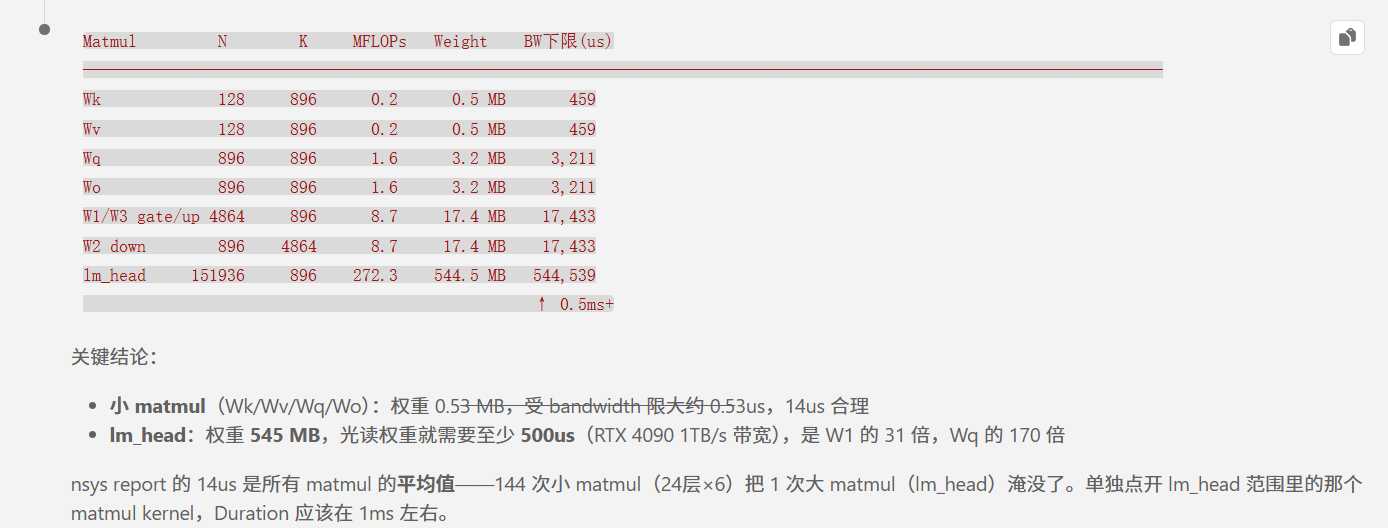
下面是性能分析报告
分析结论:
- decode阶段
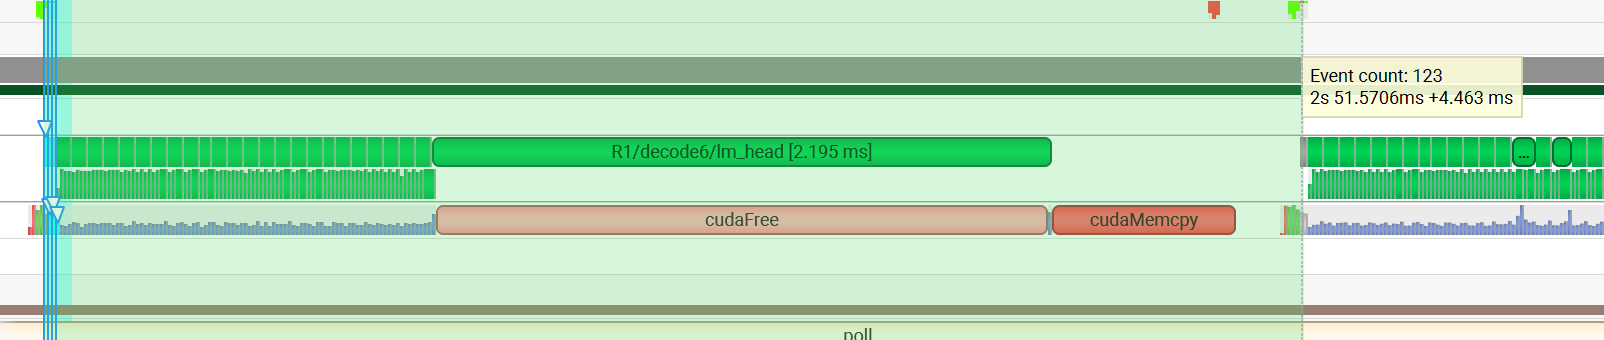
可以看到,输出单个token耗时4.46ms,对比benchmark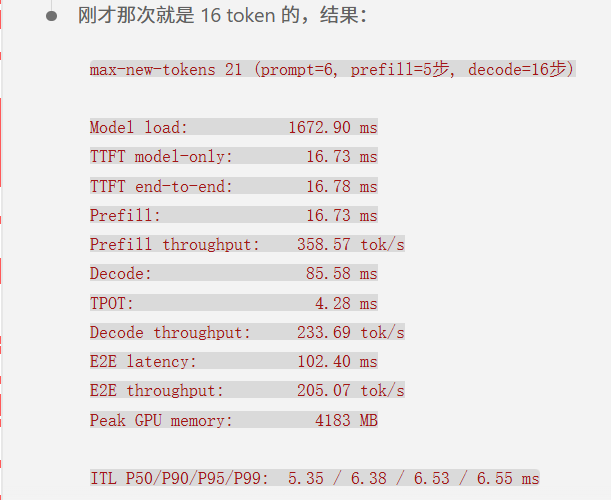
实际我用gputimer测量下来发现,TPOT是4.6ms, cls_logits下的matmul也就500us,占比不大。不算特别瓶颈。
128长度profile分析
baseline 的朴素实现的benchmark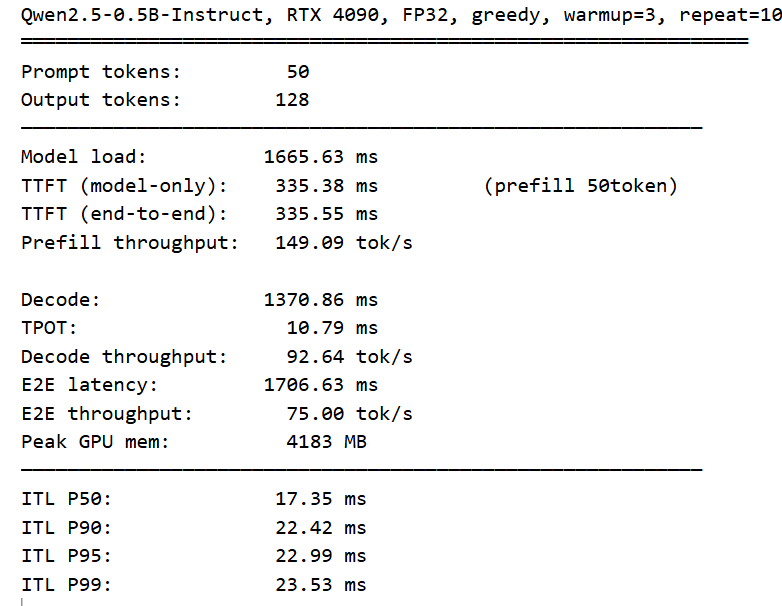
nsys分析
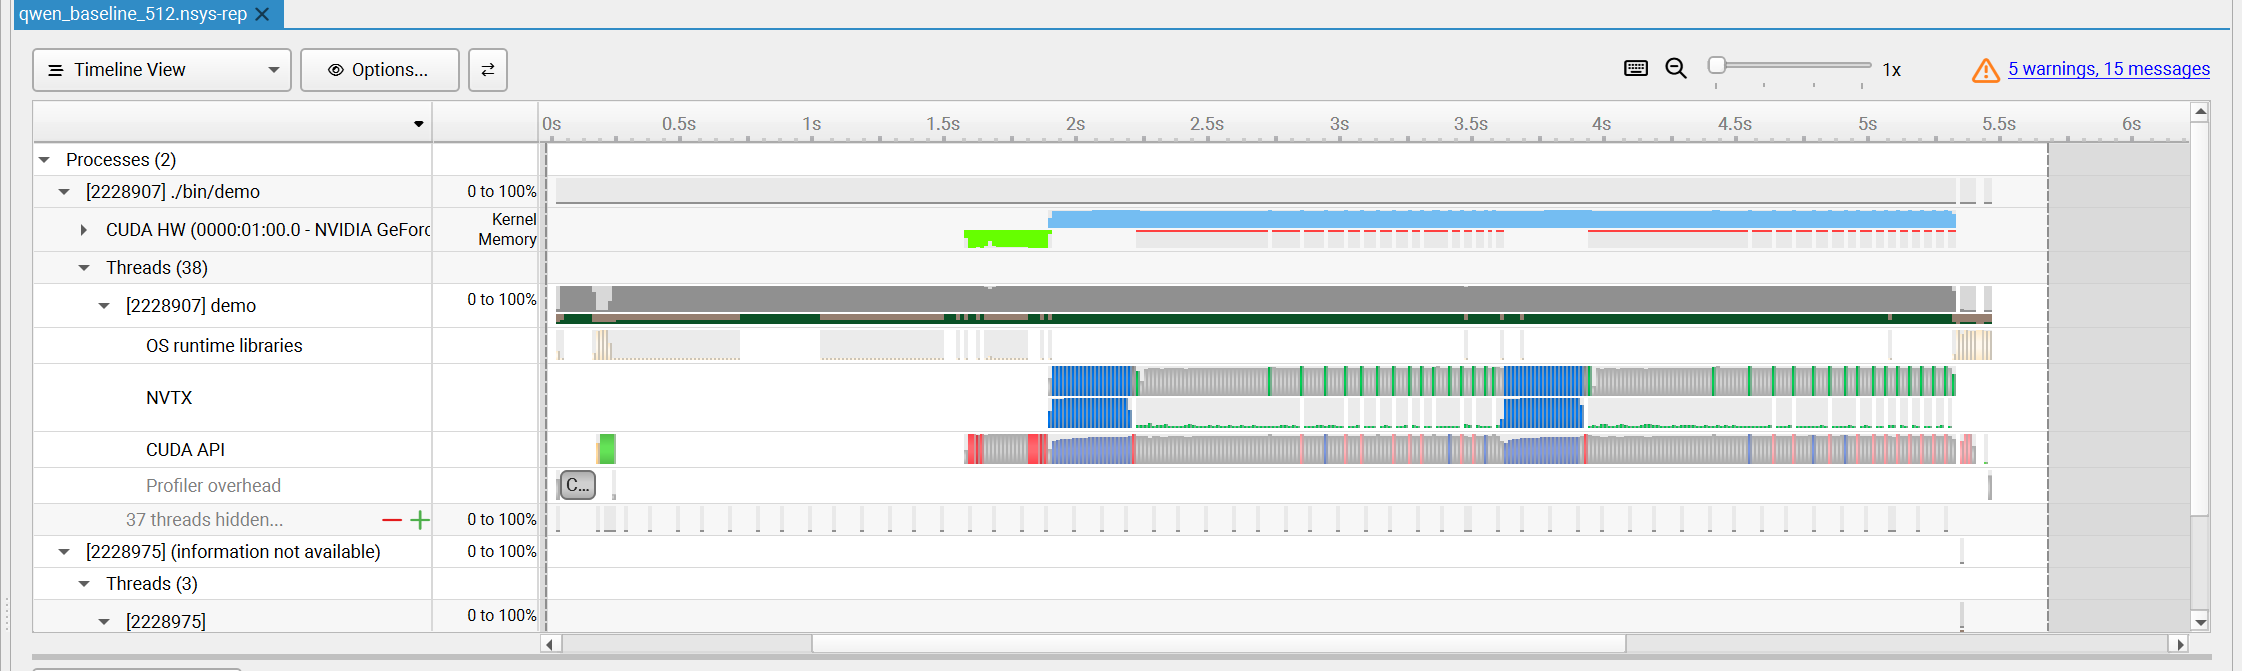
可以看到,两个阶段
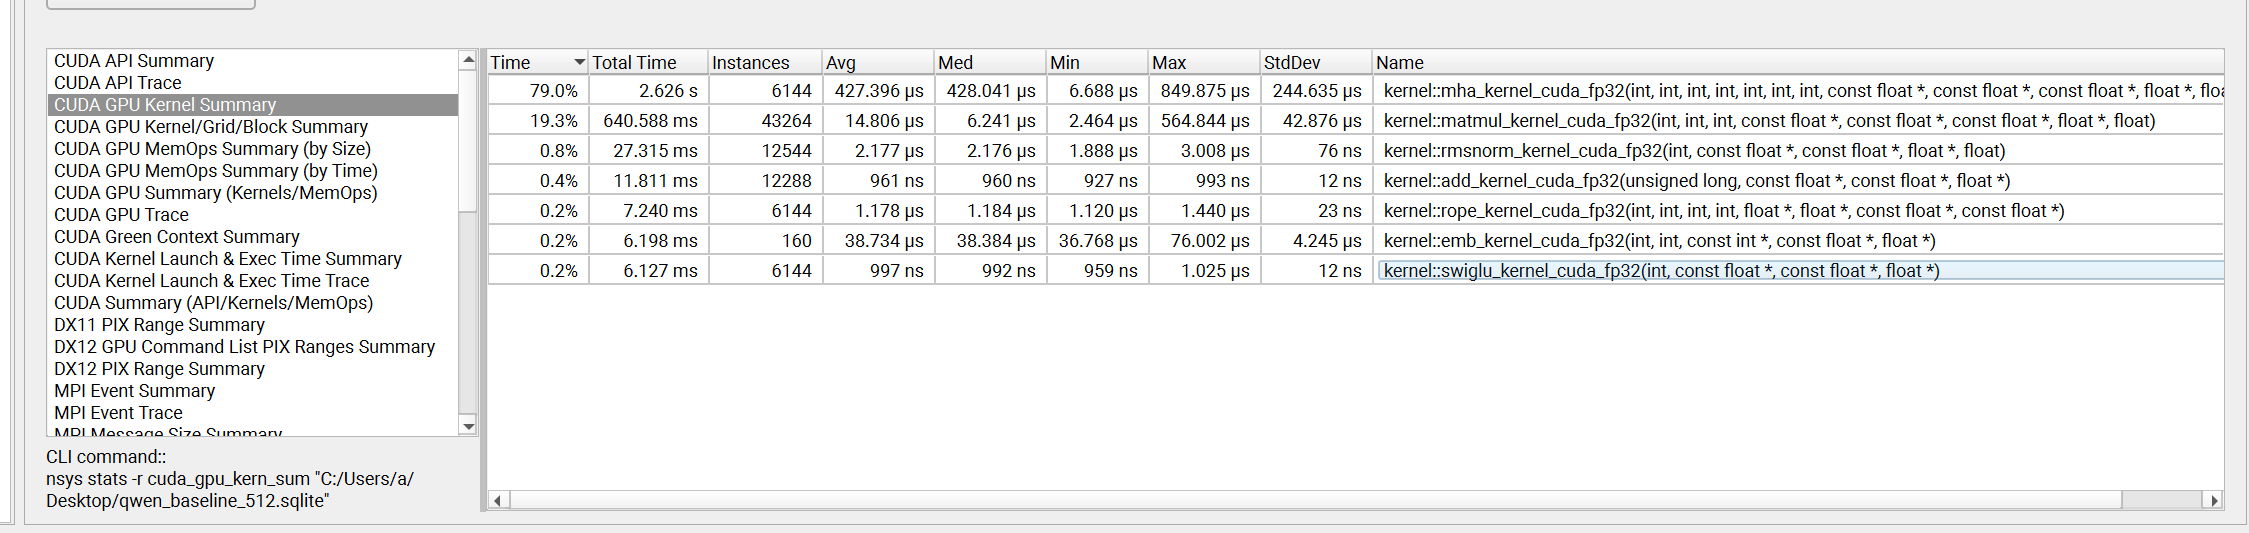
- prefill
- decode
优化matmul算子,mha算子
可以看到matmul算子耗时,以及mha算子的耗时最多,先优化一版本两个算子
目前先把老师的两个算子移植过来。
可以看到性能暴涨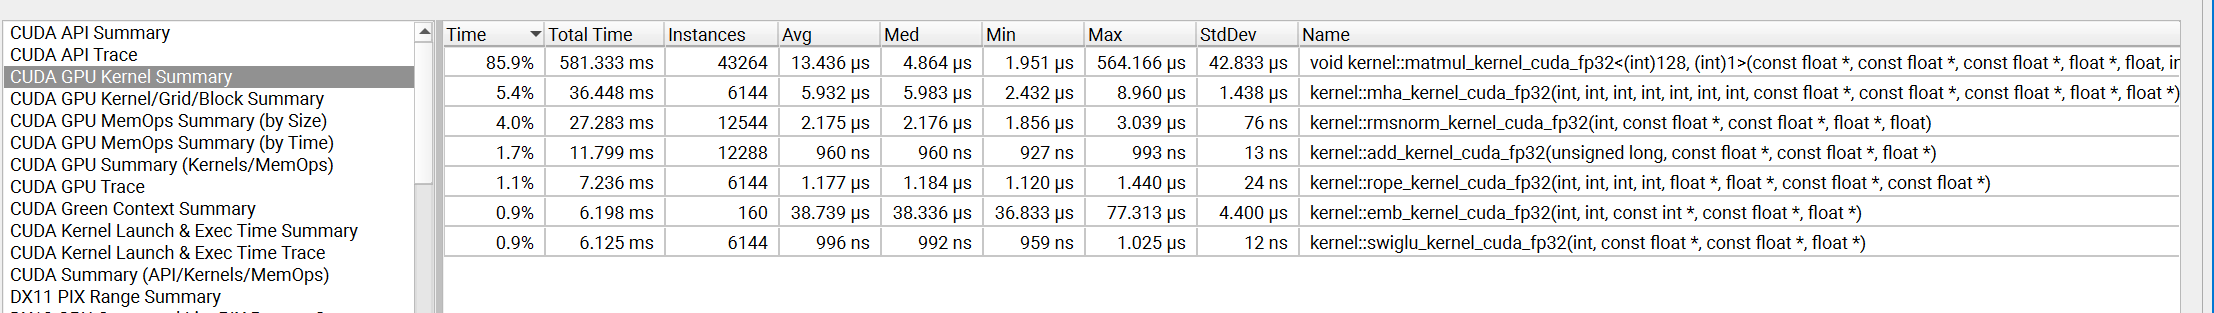
benchmark对比:
(前)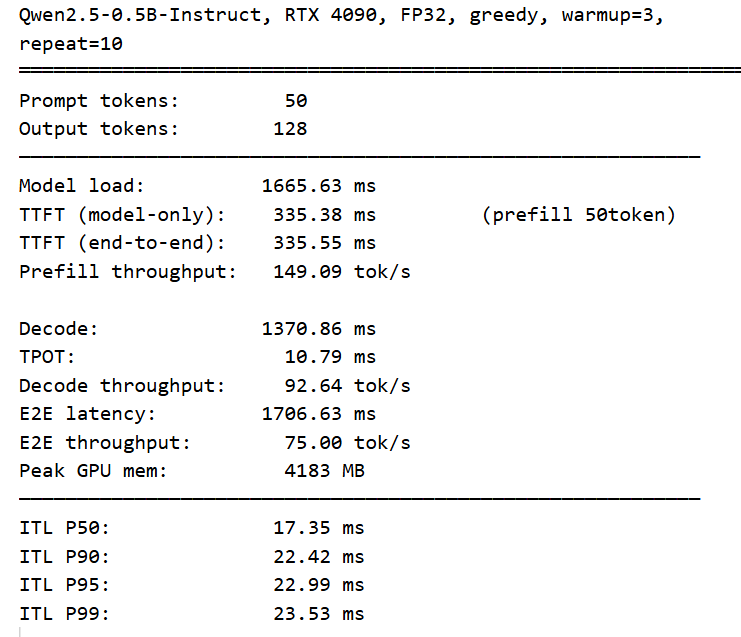
(后)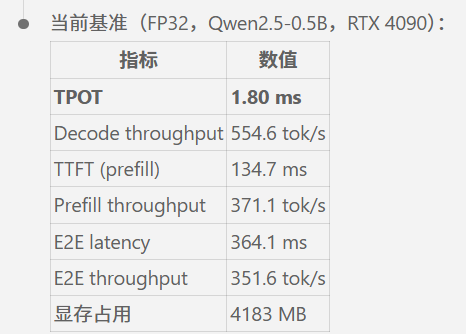
(前,可以看到cls_logits长时间,是由于matmul引起的,导致cudaFree一直在同步等待)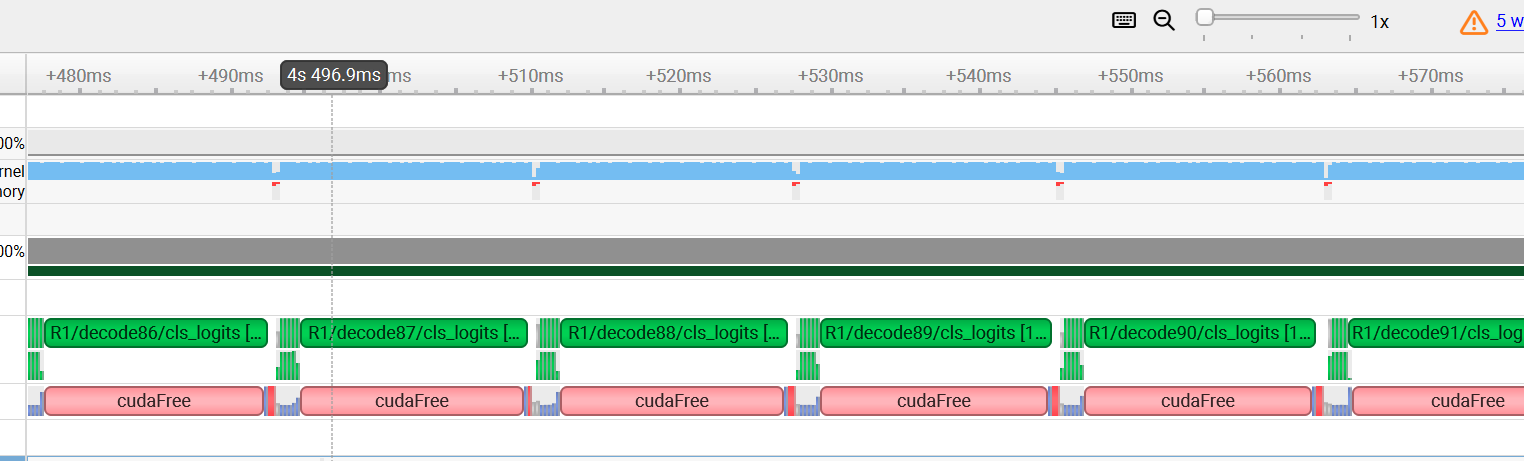
(后,可以看到,decoder阶段和cls,post阶段基本差不多)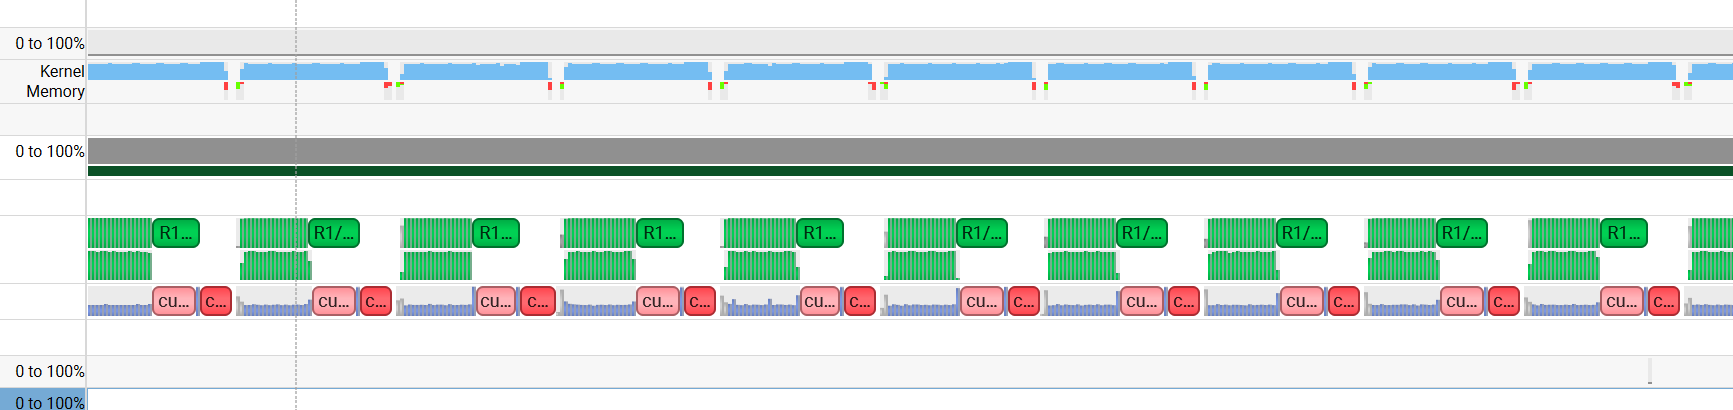
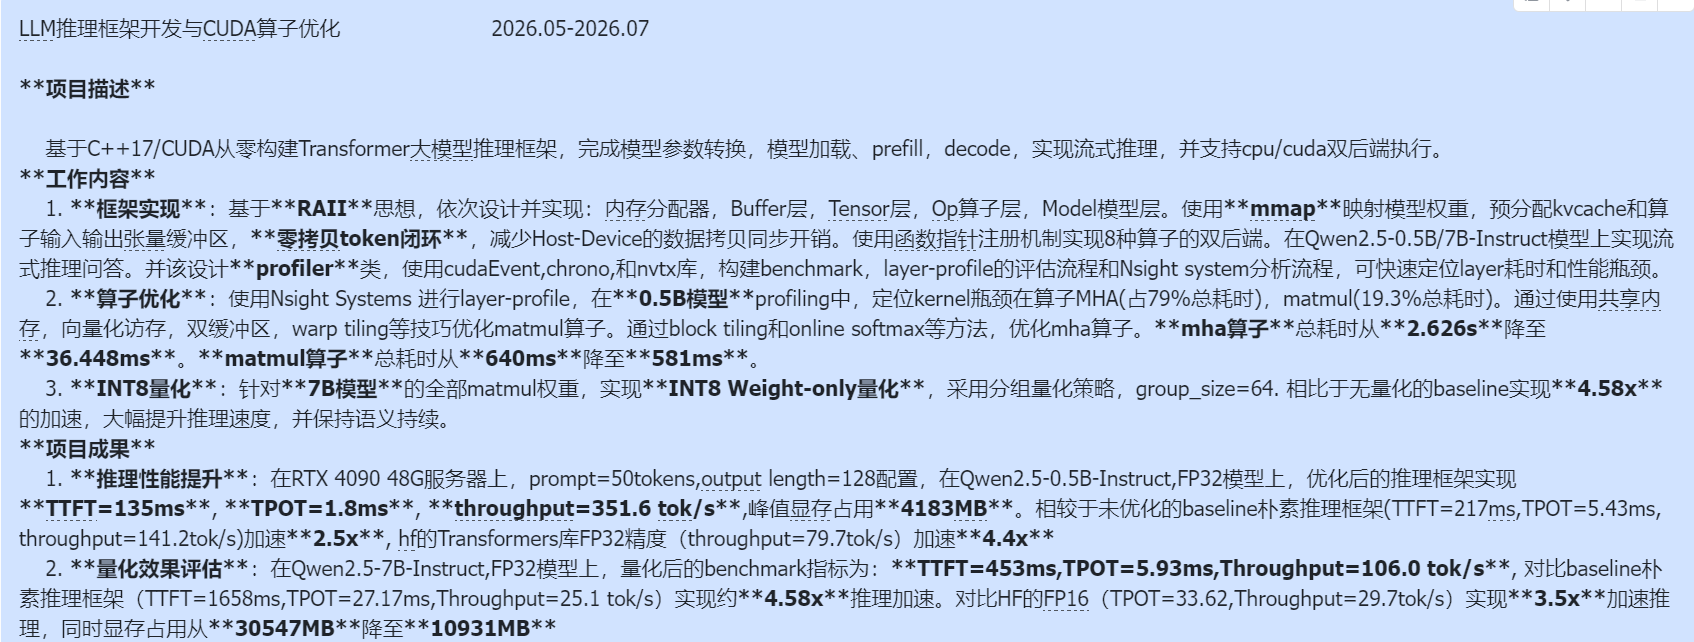
简历描述
项目汇总
项目一:Mini CUDA LLaMA Inference Engine
目标:
从零实现一个支持 LLaMA/Qwen 小模型单机推理的 CUDA 推理框架 |
模块:
1. 工程基础 |
项目二:Mini-vLLM / nano-vLLM Optimization
目标:
基于 nano-vLLM 实现高吞吐推理调度和 KV Cache 管理优化 |
模块:
1. vLLM 基础机制 |