infra FlashAttention学习
这篇是我在学习triton算子的时候,开始正式学习flashattention的原理,发现有很多版本,所以单独写一篇来记录:
先验知识
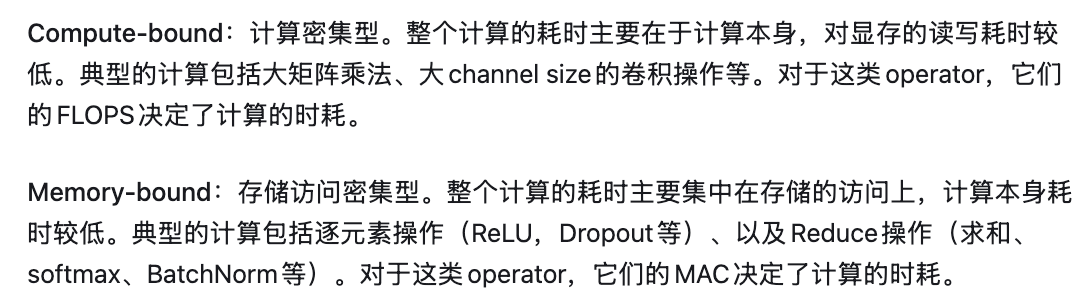
MAC(Memory Access Cost,存储访问开销)
朴素注意力算子
关于注意力计算,一开始我们已经学习了:
- 单头注意力self-Attention
- 多头注意力MHA
- 分组多头注意力GQA
我们原始的朴素注意力的计算,主要有3个阶段
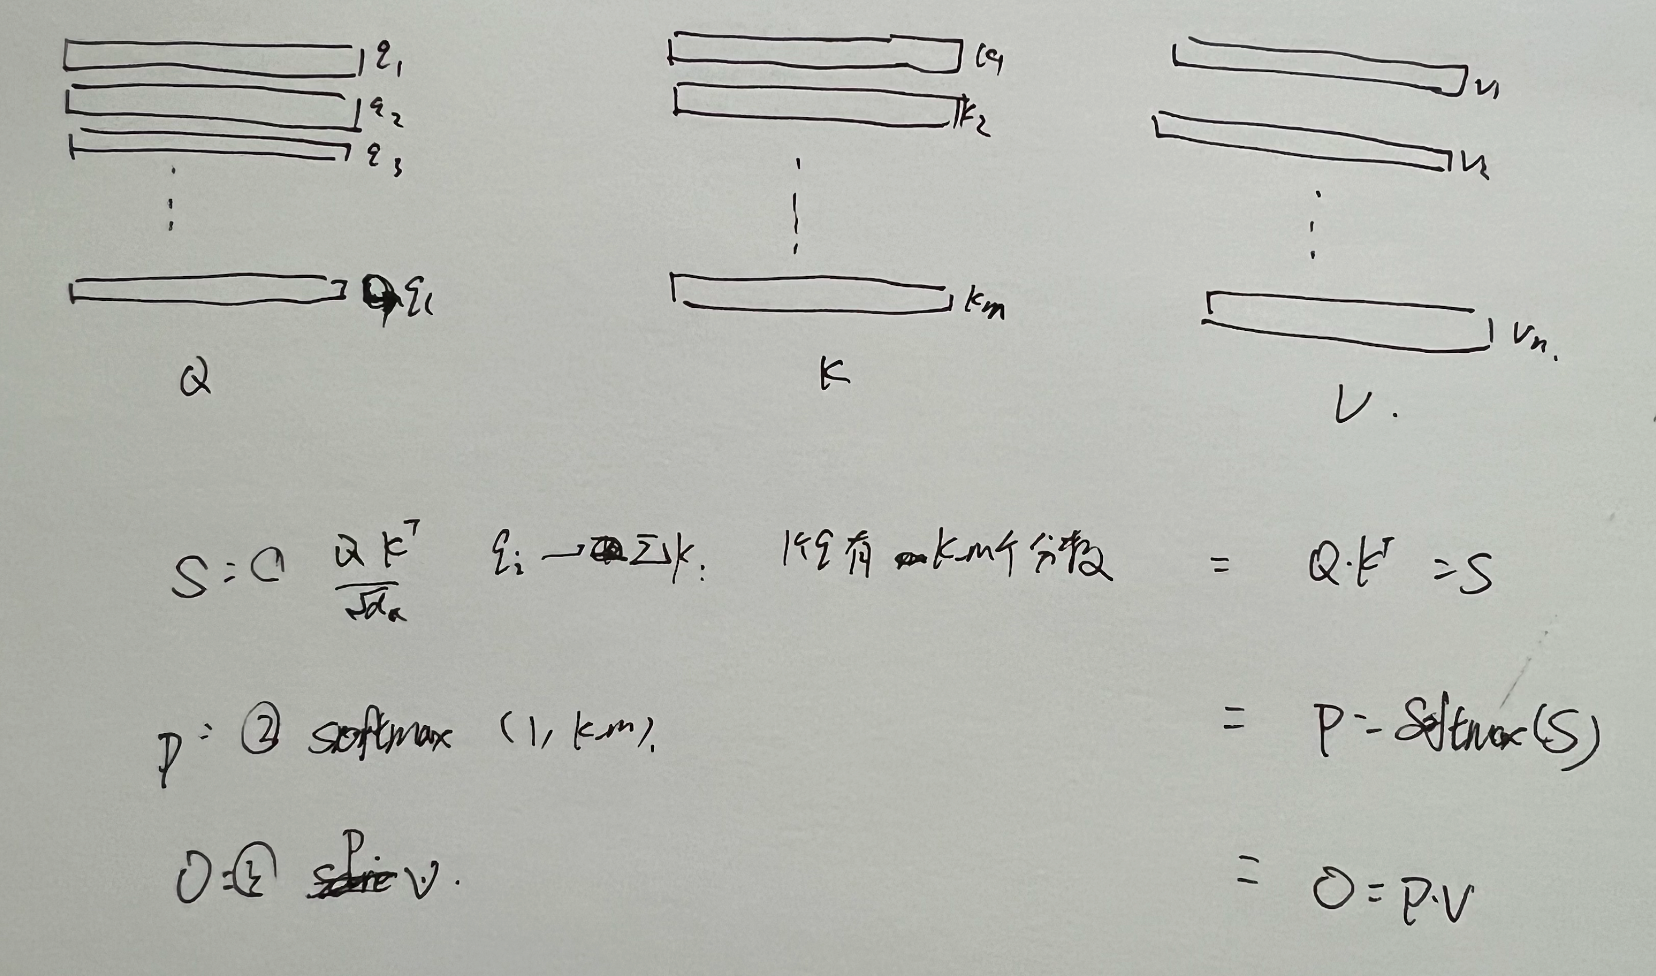
所以,一共包含8次HBM全局显存的读写操作
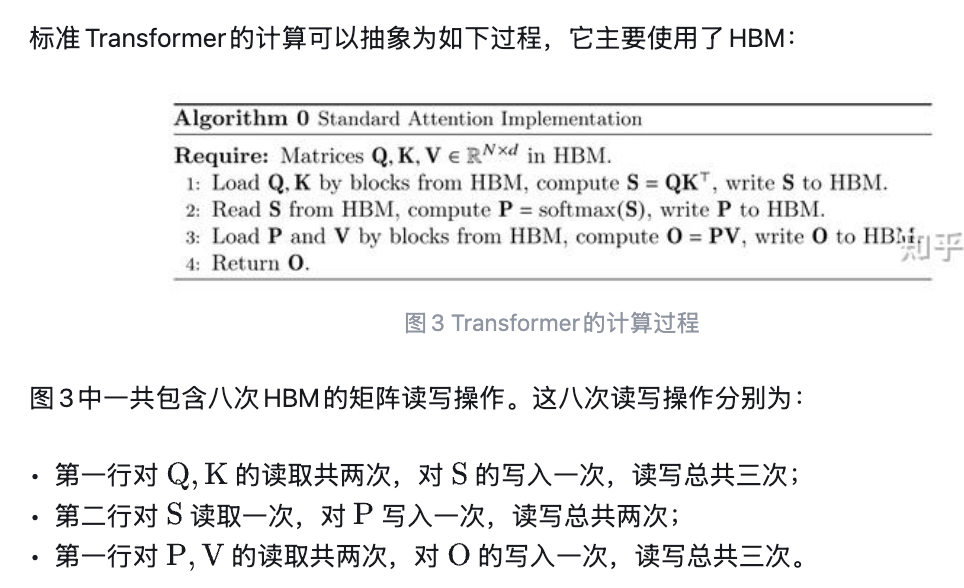
v1
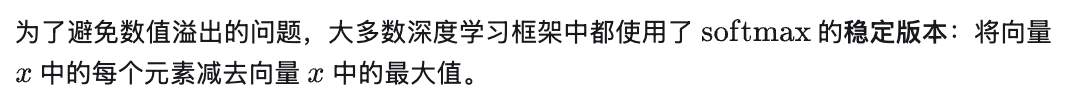
softmax的更新
选用稳定版的softmatx
分块向量中softmax的计算
x 向量,划分成 x1 + x2向量,不能单独计算各自的softmax(x1), softmax(x2)
x1向量,计算出m(x1), l(x1)后,仅保存这两个值,就不用保存x1向量的完整向量了
- m(x1)
- x1向量的最大值
- l(x1)
- 分母Σ和
这里x1就处理完了,下面开始处理x2
- 求出m(x2)
- 求出l(x2)
之后开始处理更新全局
- m(x) = max(m)
- 从m(x1), m(x2)中选一个出来
- l(x),更新计算错误的那一个分母
- 乘回去,重新除
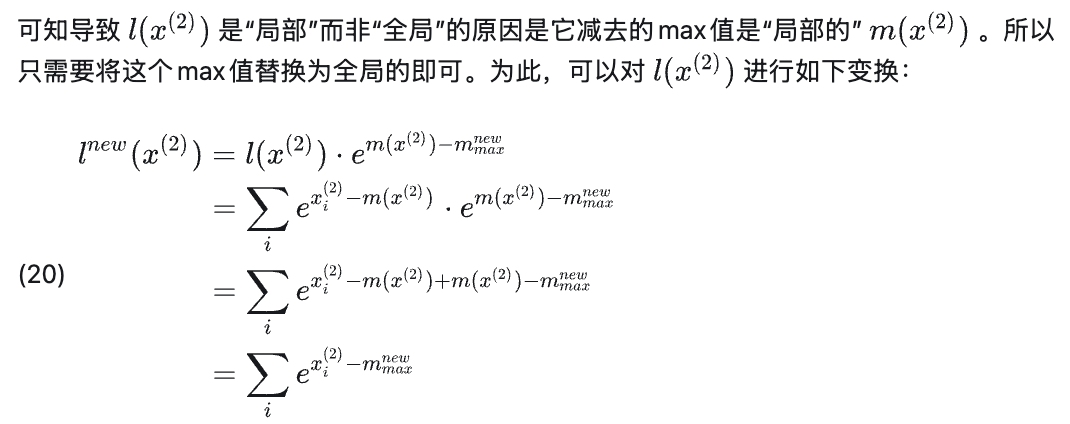
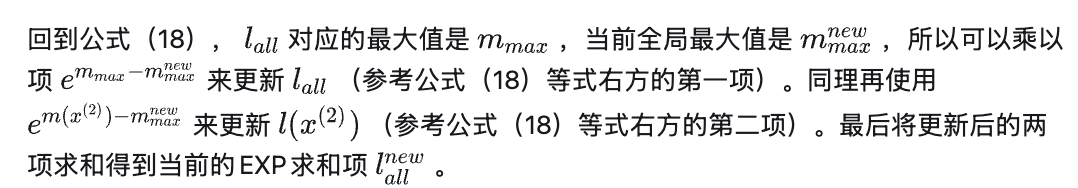
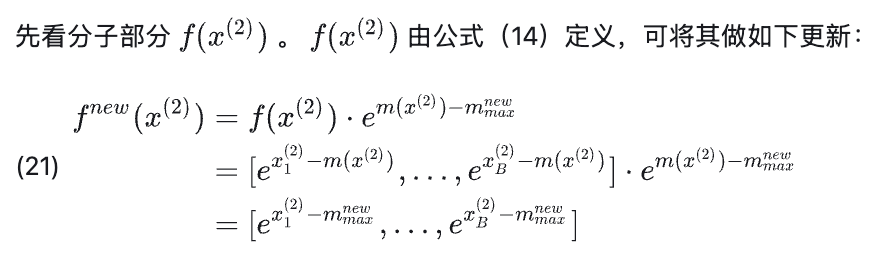
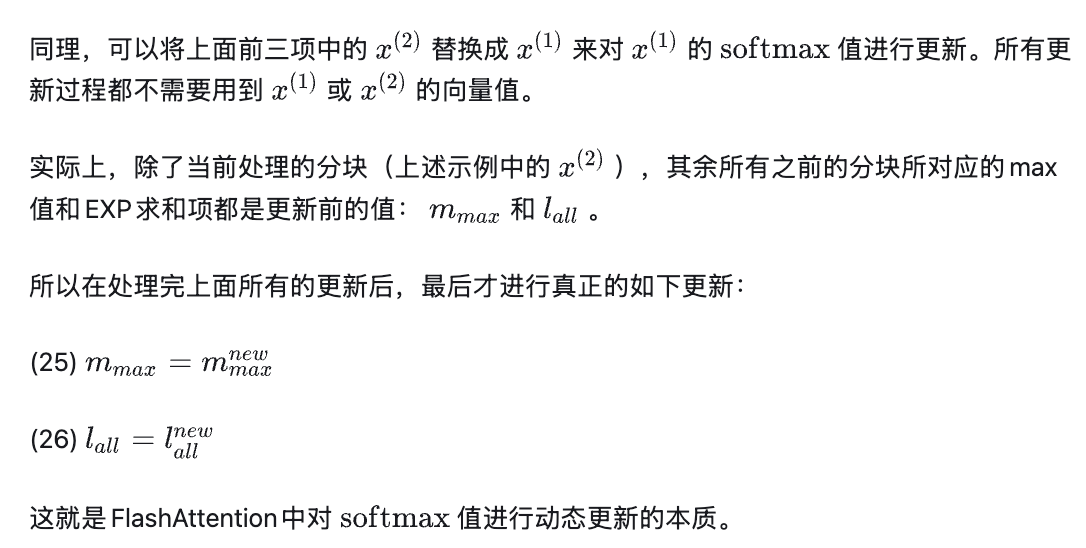
上述其实是一个增量计算的过程。我们首先计算一个分块的局部softmax值,然后存储起来。当处理完下一个分块时,可以根据此时的新的全局最大值和全局EXP求和项来更新旧的softmax值。接着再处理下一个分块,然后再更新。当处理完所有分块后,此时的所有分块的softmax值都是“全局的”。
flashattention
以下是我的理解: |
下面画个图解释一下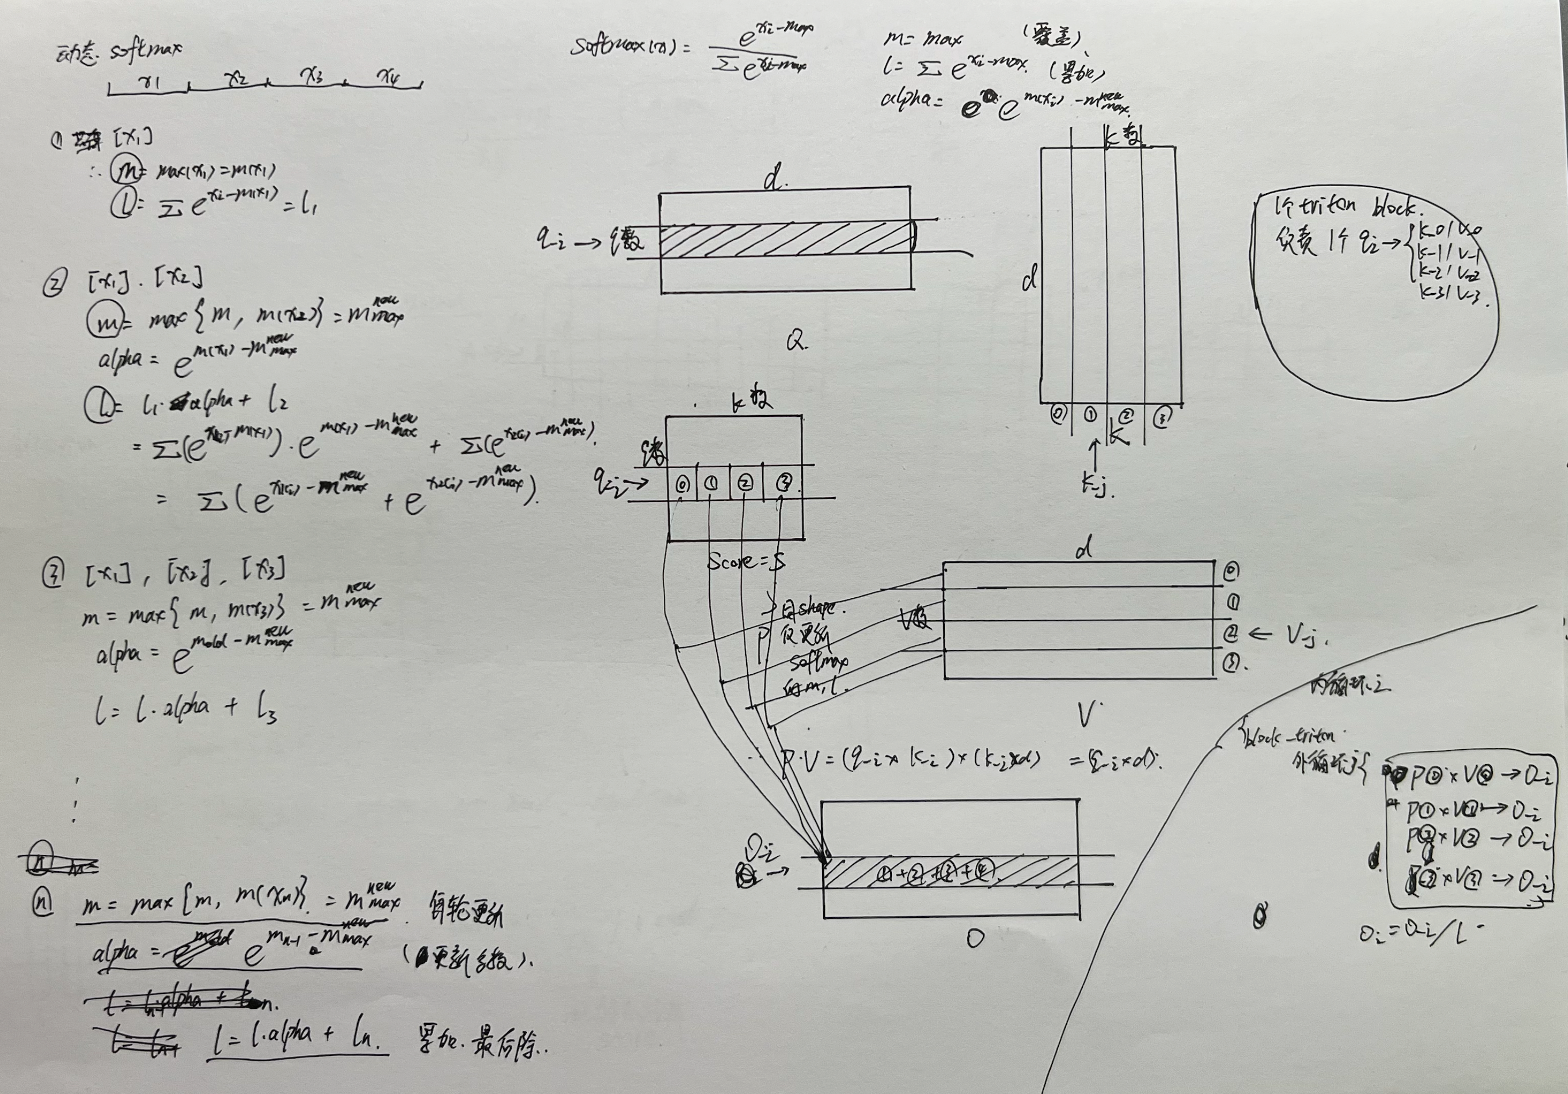
那我们vllm里面的flashattention相较于朴素实现的flashattention有哪些结合的优化呢:
pagedattention优化
朴素实现的标准flashattention, 输入都是直接一整块的张量显存,但是我们的kvcache张量线程,都已经是用block来统计的。
所以我们的flashattention传入的应该是slot_mappings,读写那个token的kvcache向量,就直接通过slot_mapping来跳转查找
变长batch
支持变长batching,朴素的batch发过来是,填充后的
req_0: 1,2,3, xx, xx, xx, xx
req_1: 43, 23,34,12, xx,xx
req_2:1, xx,xx,xx,xx,xx
这样每个req都是等长,然后内部挨个用mask来屏蔽计算的。
但是我们vllm有支持变长batch,所以发过来的就是input_ids的那样
[1, 2, 3, 43, 23, 34, 12, 1]
这样,然后通过各种索引映射表来区分那个是req0, 那个是req1, 哪个是req2
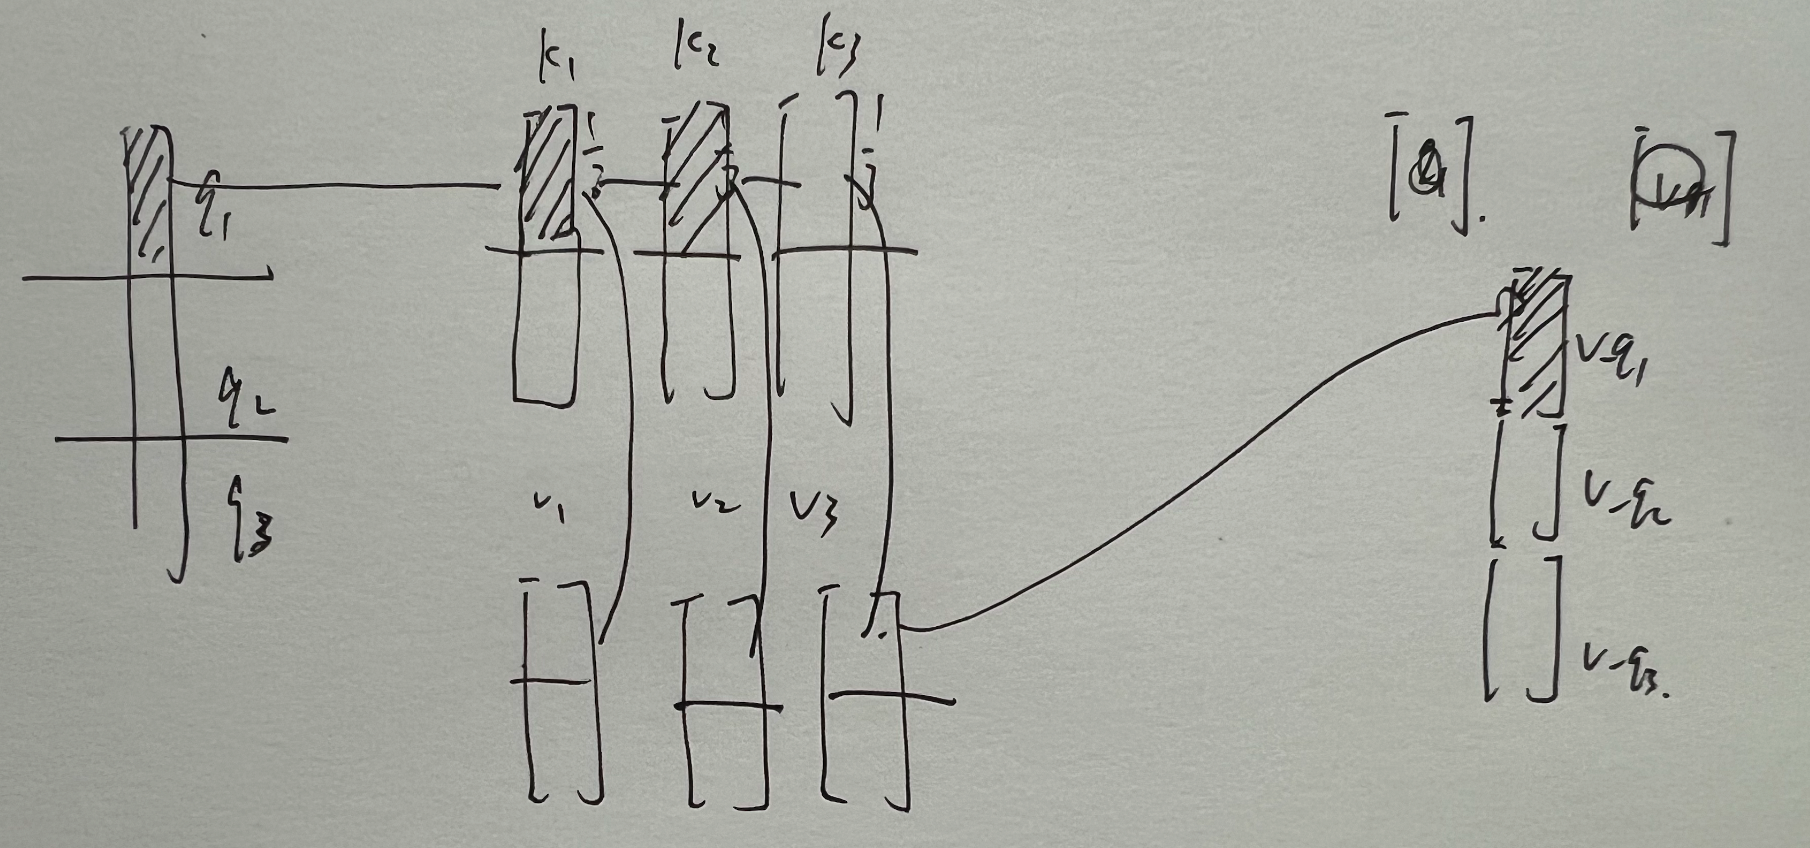
kernel一次处理的多少req的问题
我们的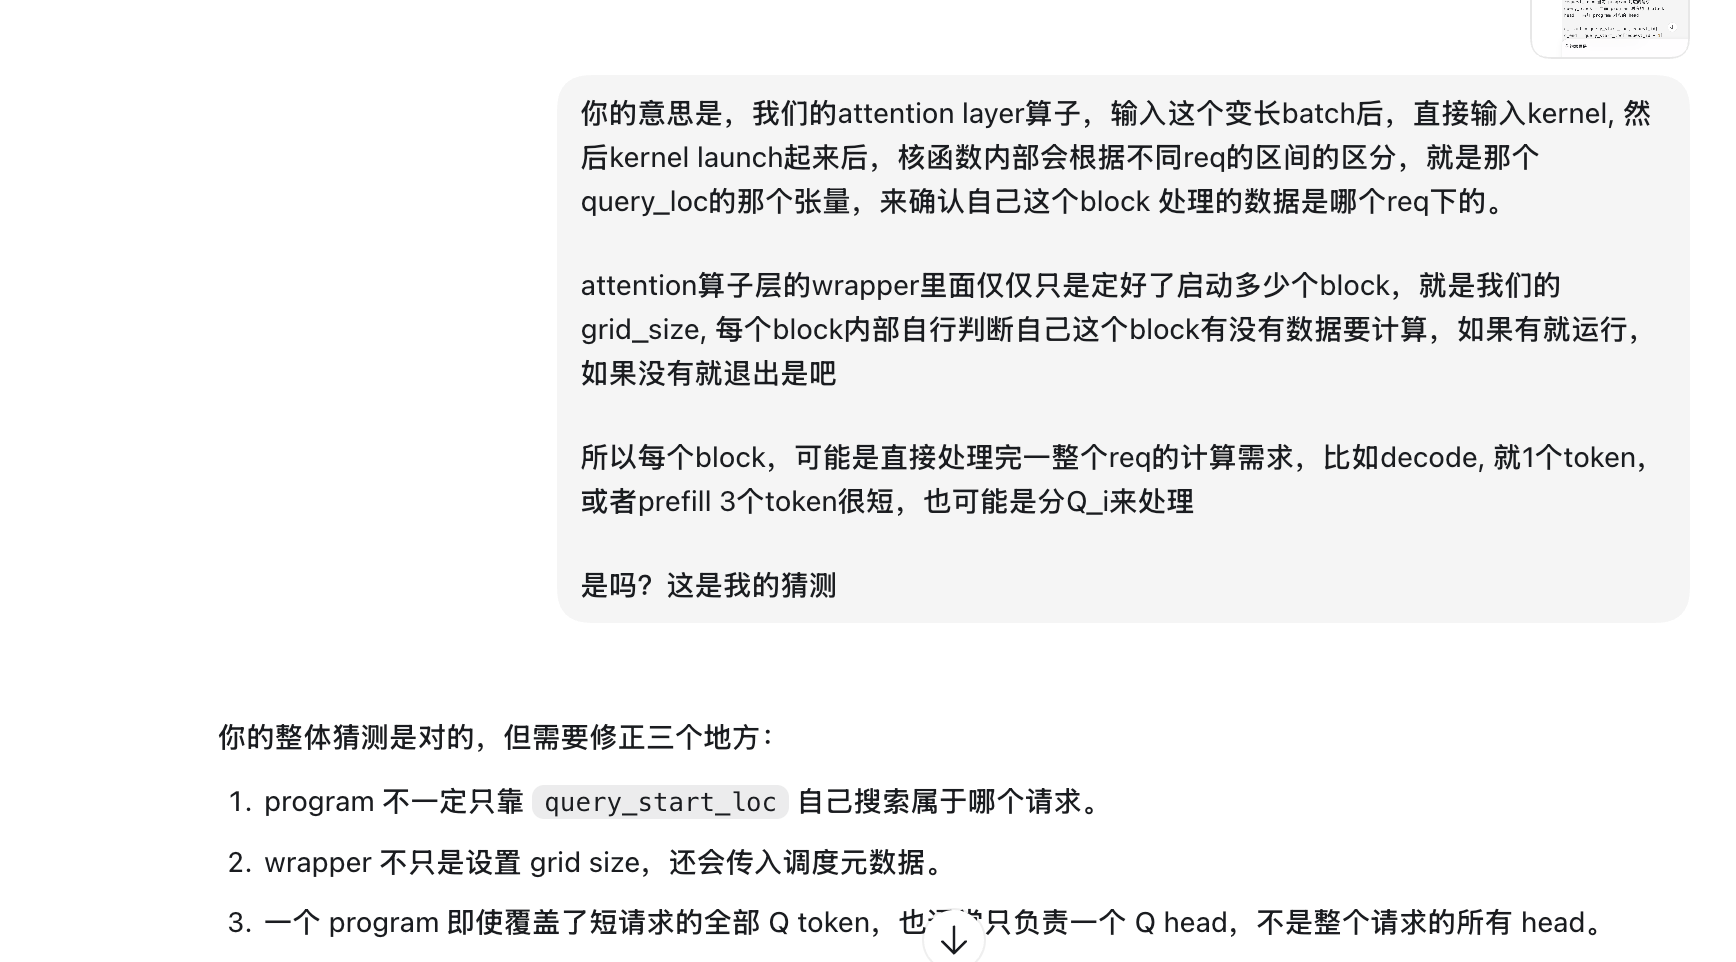
my-vllm里面的Qwen2Attention层实现
我们的Decode block里面,Qwen2DecoderLayer类里面主要分为两部分:
class Qwen2DecoderLayer: |
可以看到,Qwen2Model的一个layer的decode block里面,主要分成前面的注意力计算,以及后面的FFN的计算。
所以他是吧qkv投影放到注意力算子层里面一起实现的。
我们kuipa里面是用的matmul + gqa算子两层封装来凑起来的,vllm里面就一层封装
下面我们来看一下Qwen2Attention
class Qwen2Attention: |
注意,每个注意力层实例,里面有一个关键的self.kv_cache : torch.Tensor
这个就是model_runner在初始化kvcache后,划分出每层的tensor,然后reshape后,这个张量实例,就是保存到模型的每个注意力层的实例里面了
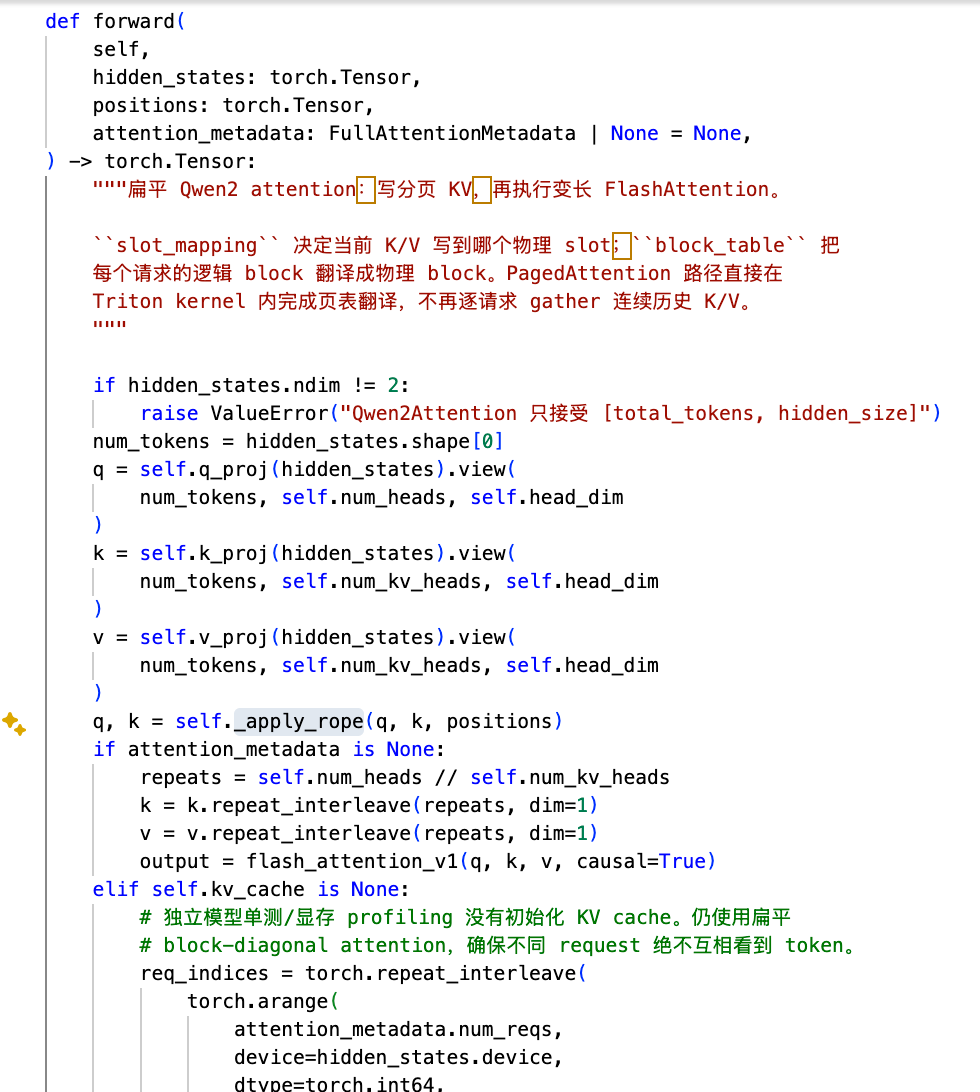
看一下前向推理,可以看到,我们这个注意力层的输入,不是向量,是一个张量,意味着这是可以批量处理的, 一口气处理一整个batch的token向量
具体实现是,里面每个投影矩阵本身是nn.Linear,支持张量输入,批量处理,然后计算结果也是张量,
torch.Tensor.view()是在不改变底层数据的前提下,重新解释tensor的形状
view 和 reshape的区别:
view() 必须尽量共享原来的底层存储
reshape()更灵活,必要时可以偷偷复制一份数据