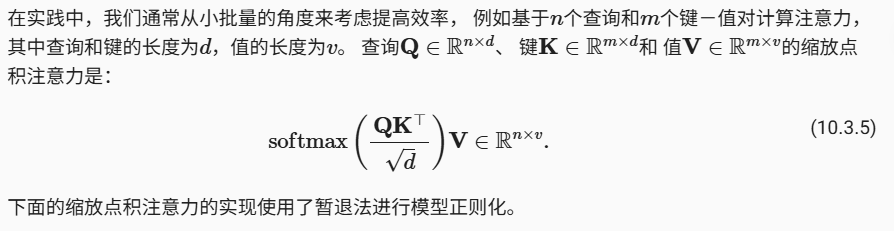
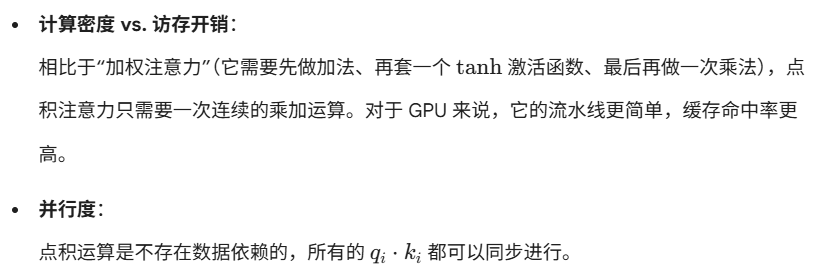
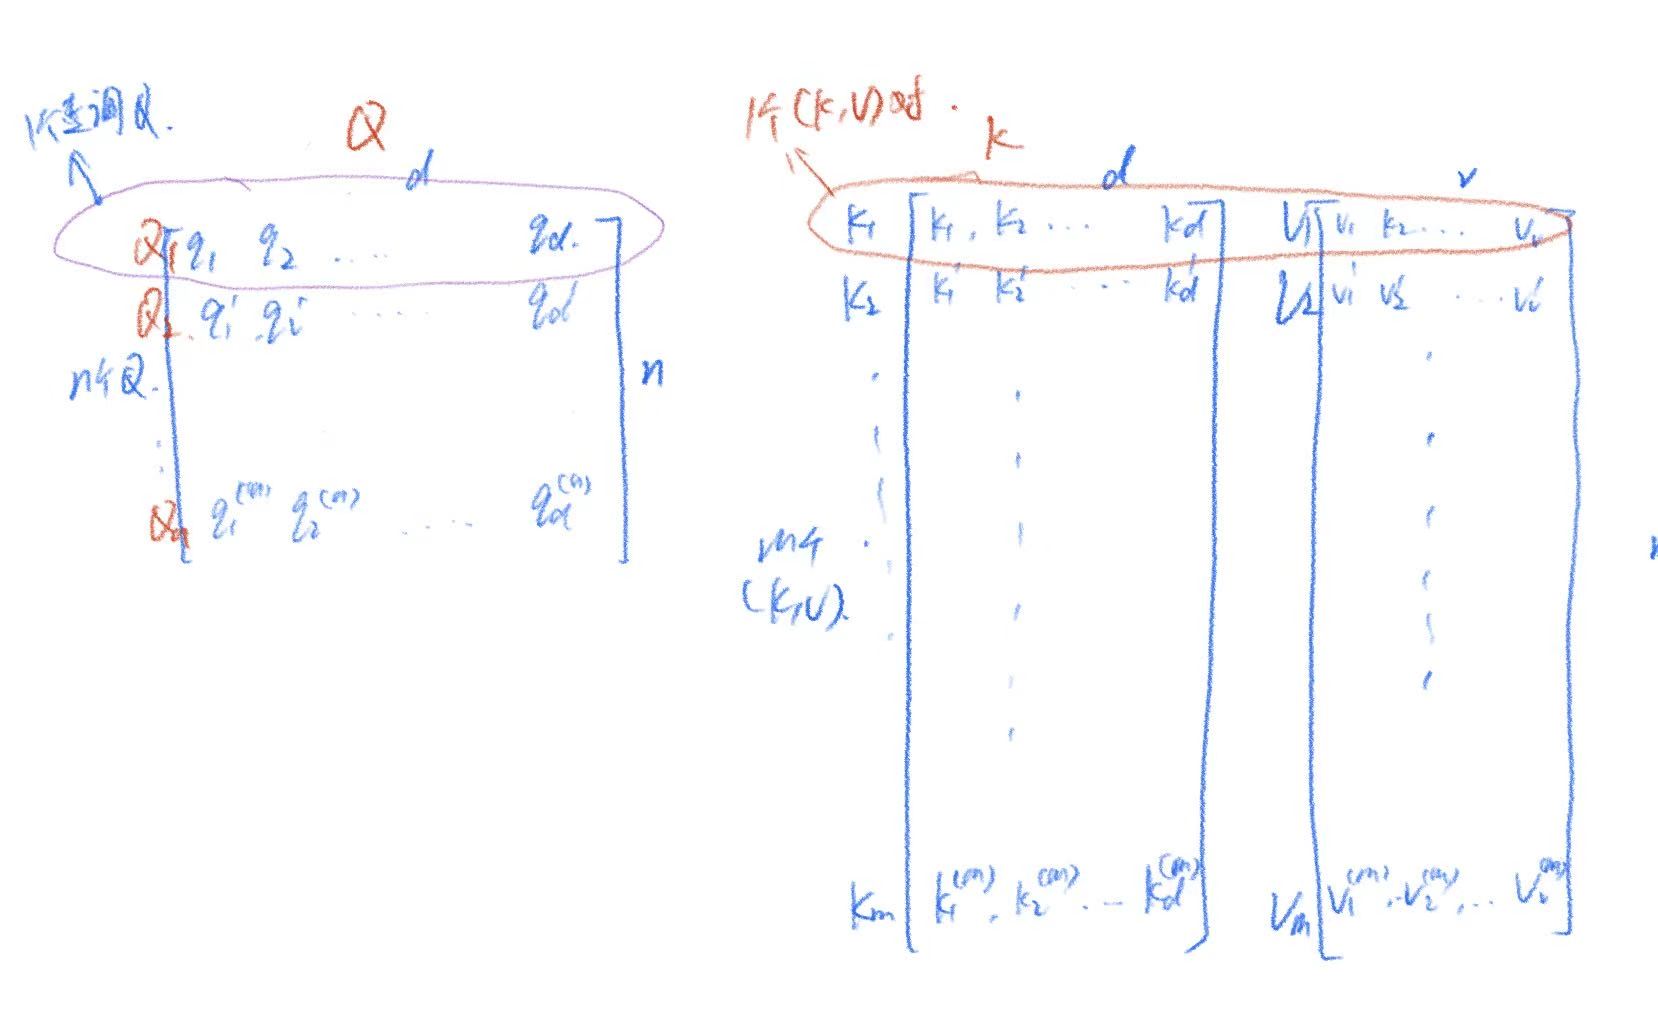
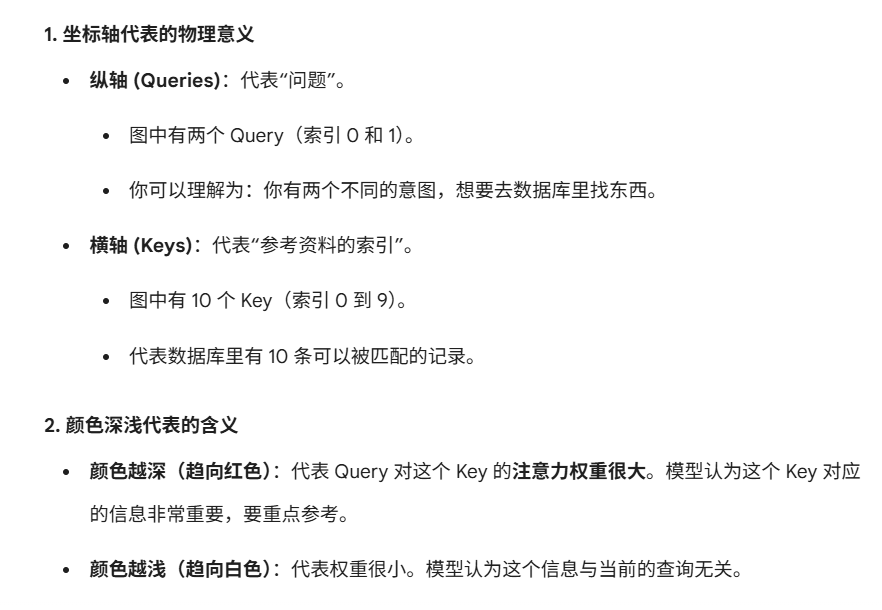
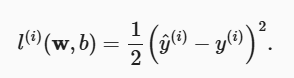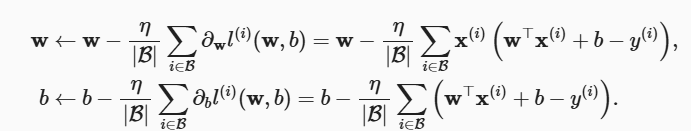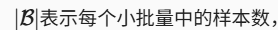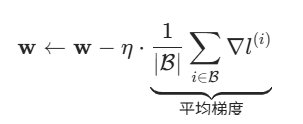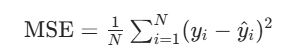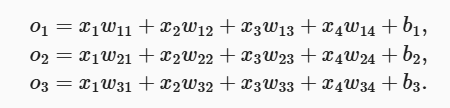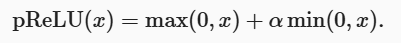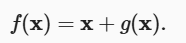深度学习基础-pytorch+python

python概念扫盲

基础的python语法,这里就不讲了,python本身底层是用c++来实现的,所以全部都是面向对象变成,里面所有的库,都是实现的类。

python的所有变量 = auto指针
指针创建在栈区,指向堆区的内存。实际的对象内存,在堆区里面。

pytorch

==pytorch特性==:
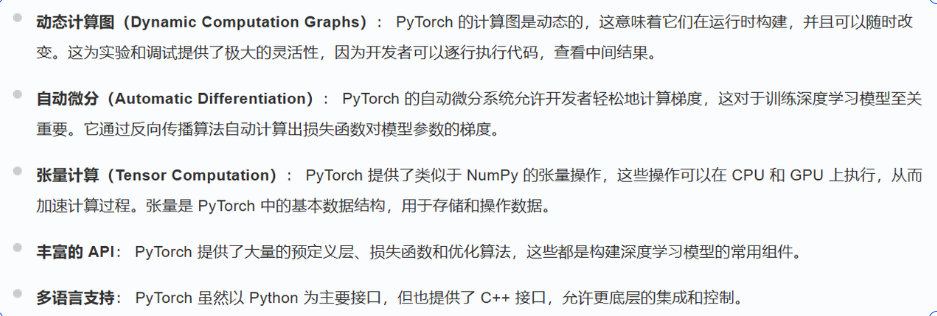
比较重要的就是:

  1. 动态计算图的理解-> 自动微分的实现
  2. torch.tensor(), 张量,和numpy库里面的数组定义类似。

==自动求导机制==

我们模型的Loss函数,需要对w, b求导,其自动求导是依赖计算图的。 当我们建立好了计算图

w → * → y_pred → - → (差) → **2 → loss
↑ ↑
x y_true

w = torch.tensor(2.0, requires_grad=True)
loss.backward()

我们通过标记变量为需要求导,相当于把这个对象的标志位,置1,这样当你调用loss.backward()的时候,他就可以根据这个计算链表图,找到对应的变量,求Loss()关于这个变量的偏微分,也就是偏导数。所有的偏导数的动态数组,就是梯度

==pytorch的作用==

我们使用pytorch,本质上,是为了快速的

  • 搭建网络模型
  • 处理数据
  • 训练/评估
  • 推理
    本质上都是在干这4件事情。所以需要学会用哪些库来实现我们想要的功能。

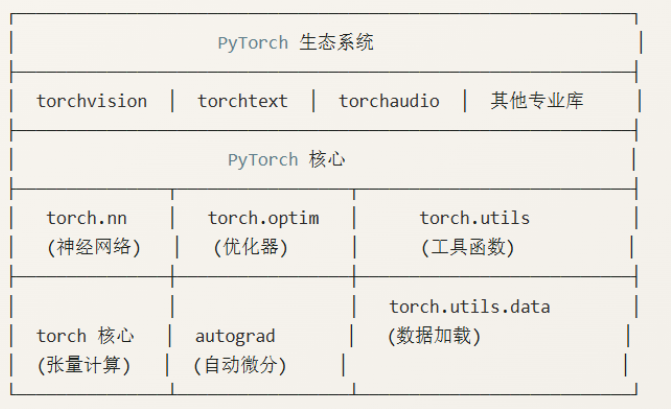
==pytorch库架构图==

pytorch是一个大的库,里面有不同功能模块子库
自动微分

pytorch里最重要的就是依靠动态计算图,来进行自动微分的计算了。

梯度

一元函数,因变量关于自变量求导,叫做导数。
y = f(x) => ∂f/∂x(导数)
多元函数,因变量关于自变量们求导,叫做梯度。
y = f(x1, x2, x3,….., xn) =>
{∂f/∂x1, ∂f/∂x2, ∂f/∂x3, …… , ∂f/∂xn} (叫做y的梯度)
所以梯度本身,就是这个多元函数(标量),关于各个自变量的导数。
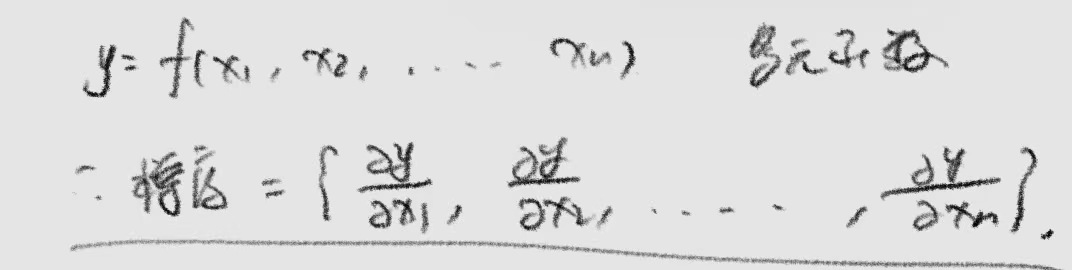
torch库自动计算梯度

上面我们定义好了梯度的计算公式,下面就是torch库,来帮我们计算梯度

我们不需要自己定义求梯度的公式。在构建前向传播的损失函数的时候。torch利用动态计算图,来表达出计算的公式。然后利用链式求导法则,来进行求导。
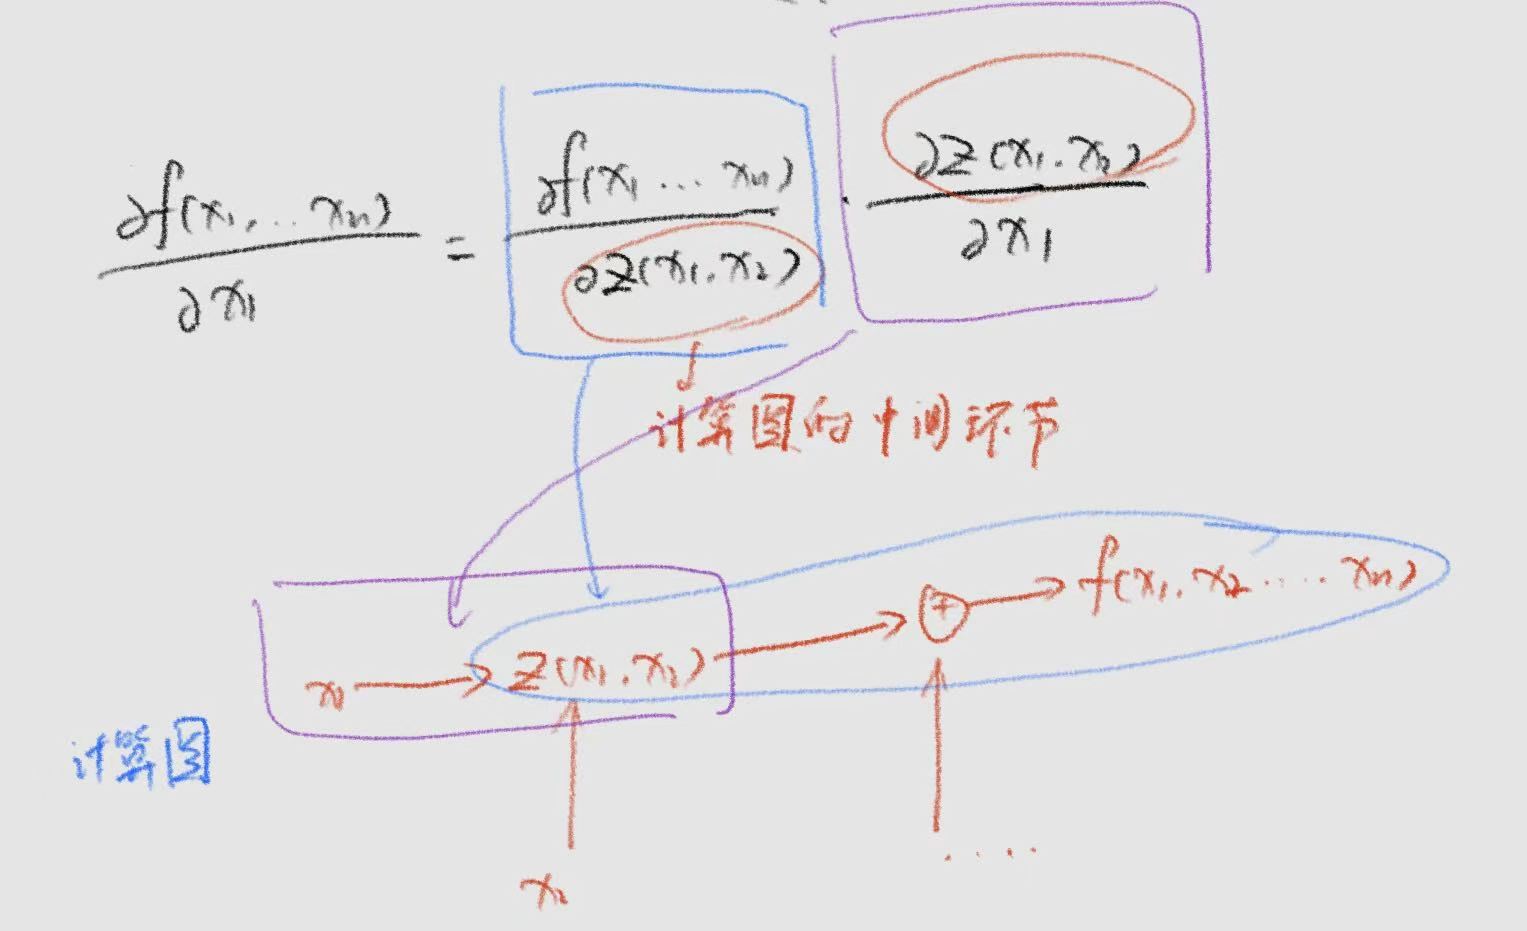
可以看到,通过链式法则,就可以把求梯度的过程,和计算图的每个环节联系上。

通过一次loss.backward(), 就可以计算一次loss(x1, x2, x3, …, xn)的梯度了(同时路上所有中间变量的梯度也都求出来了。)
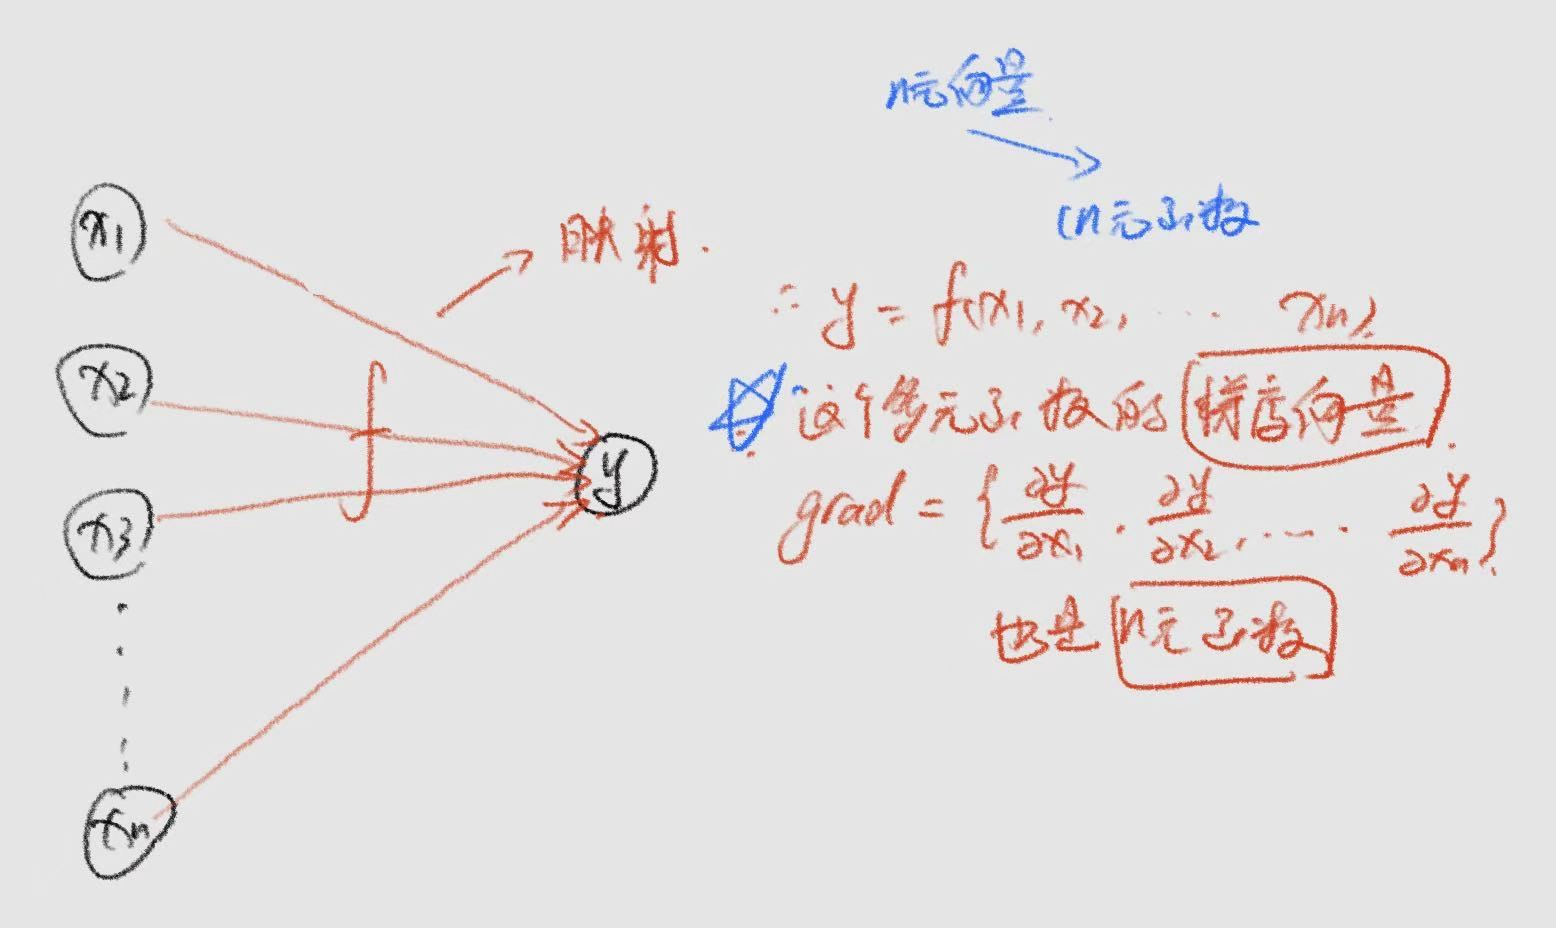
注意:n元函数loss,输入是n元向量,loss的梯度,也是一个n元向量,是关于所有自变量的向量
因此,梯度向量的每个元素,都应该存放在n元输入向量的每个元素对象的内存里面。
所以输入元素x1.grad, x2.grad, …., xn.grad. 这个成员变量,专门用来存放梯度元素分量

x = torch.randn(2,2, requires_grad=True)

print(x)

y = x + 2
z = y * y * 3
print(z)
out = z.mean()
print(out)

out.backward()
print(x.grad)

通过标记x这个变量的内部标志位 requires_grad=True, 之后,整个计算图只要包含x这个变量,全部会被标记这个标志位。
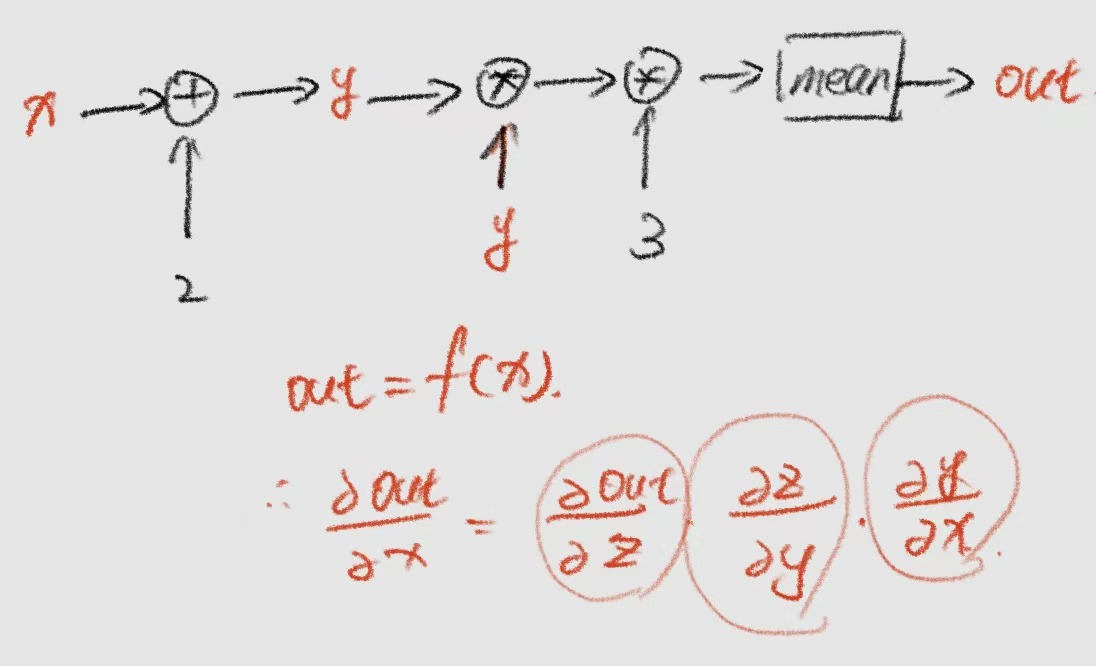
之后out.backward(), 触发torch的求导过程,并把out(x), 关于各个自变量,中间环节的导数(梯度分类),全部存放在对于的对象内存里面。

梯度本身也是一个关于(x1, x2,x3, ….., xn)的n元函数。

每次计算的梯度都不一样,当然不一样了,梯度也是一个函数(关于x的函数)
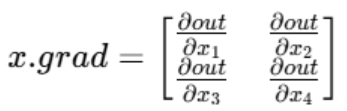
python的with 语句

python里面,with语句,通常用来申请某类资源,然后里面实现在占用这个资源时要做的事情,跳出这个过程之后,会自动释放这个资源

torch.no_grad()

用torch.no_grad(), 可以暂时关闭自动求导的标志位传到, 相当于关中断一样。

import torch

# 定义一个需要梯度的张量
x = torch.tensor([1.0, 2.0], requires_grad=True)

# 正常操作:会追踪梯度
y1 = x * 2
print(y1.requires_grad) # 输出 True,会被加入计算图

# 用 torch.no_grad():块内操作不追踪梯度
with torch.no_grad():
y2 = x * 2
print(y2.requires_grad) # 输出 False,不加入计算图

# 块外恢复正常
y3 = x * 2
print(y3.requires_grad) # 输出 True,恢复追踪


深度学习的组成

组成

我们的torch深度学习,主要做一下几件事:

  1. 数据 [[#torch 数据]]
  2. 模型 [[#torch 模型]]
  3. 衡量模型质量(定义损失函数)
  4. 训练
    1. 前向传播
    2. 计算损失(得到这次的模型性能)
    3. 反向传播(计算参数更新值)
    4. 参数更新(优化器来具体更新参数)
  5. 评估/推理

网络层/架构分类

  • FNN(前馈神经网络)[[#FNN 前馈]]
  • CNN(卷积神经网络)[[#CNN 卷积]]
  • RNN(循环神经网络)
  • Transformer (注意力机制)

一些小零件

  • 各层之间的激活函数[[#激活函数]]
  • 各种损失函数
  • 各种优化器
  • softmax层 [[#softmax运算]]

一些技巧

  • [[#dropout 暂退法]]
  • [[#权重衰退(正则化)]]
  • [[#批量规范化]]

理论角度理解深度学习

三大件

首先这一节,我从数学理论的角度来理解,深度学习的过程。简单来说,深度学习主要的三大件:

  • 数据(x,y’)
  • 模型(参数(a,b))
  • 损失函数(平均损失函数Loss)

本质上,我们定义/训练模型,依赖的是这样的架构:
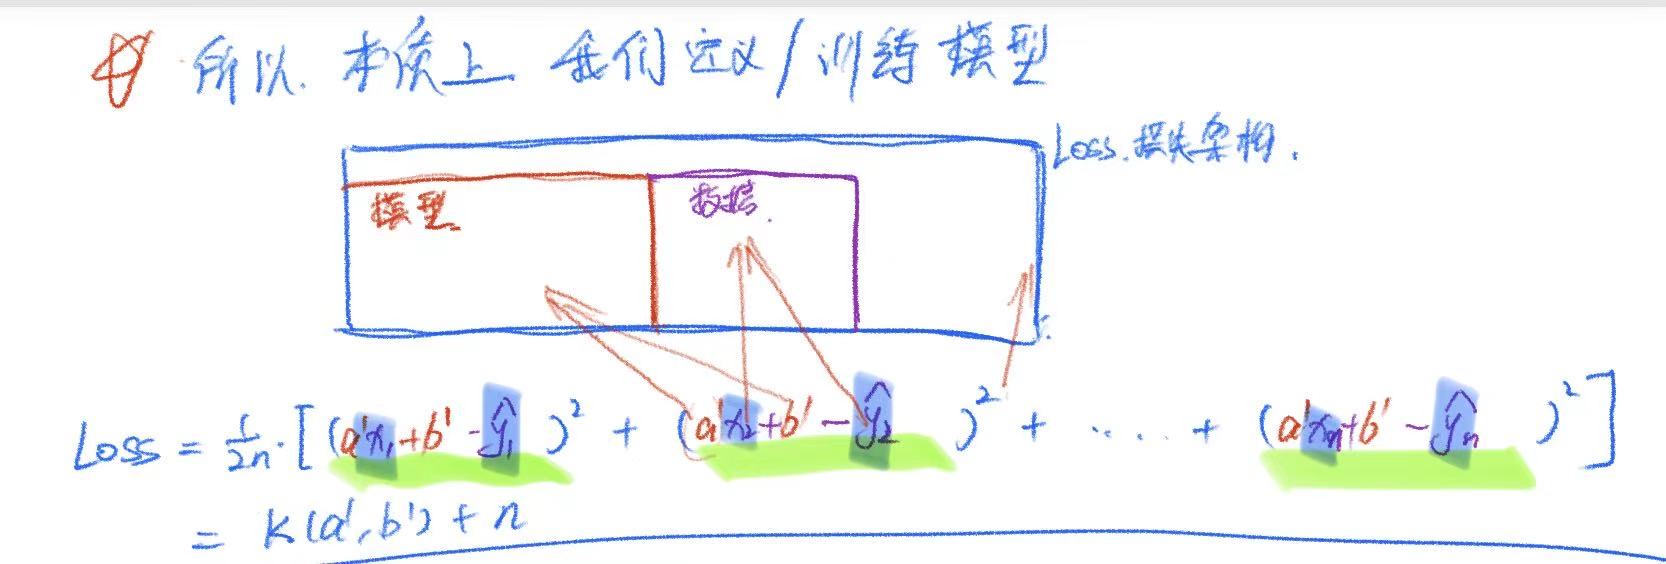
我们现在假设一个最简单的函数模型(即线性回归模型):
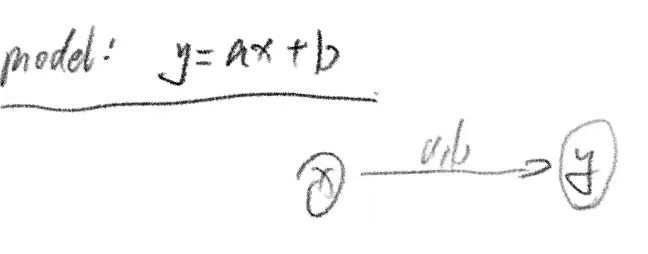
286

566

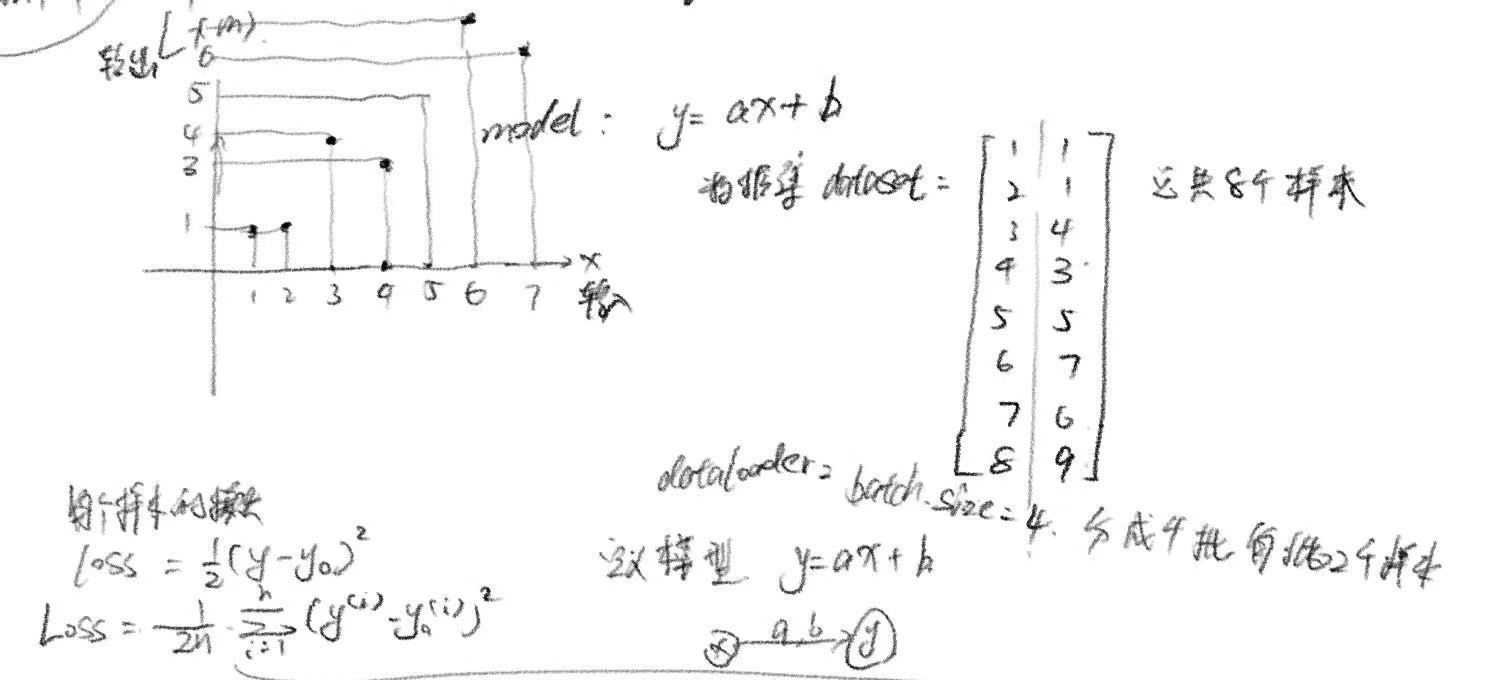
模型:
y = ax + b
所以**模型参数为(a, b)**

数据:
我这里一共准备了8个样本: 一个样本 = 一个输入+一个标签
所以dataset就是这8个样本组成的张量
dataloader是针对这个dataset的迭代器,设定一共分成batch_size批:

  • full_batch:batch_size = 1
    • 训练稳定,但是内存占用大
  • mini_batch: batch_size = 4
    • 训练速度快,内存占用小(后面分析)

**损失函数:loss

这里就先使用最简单的平方误差函数

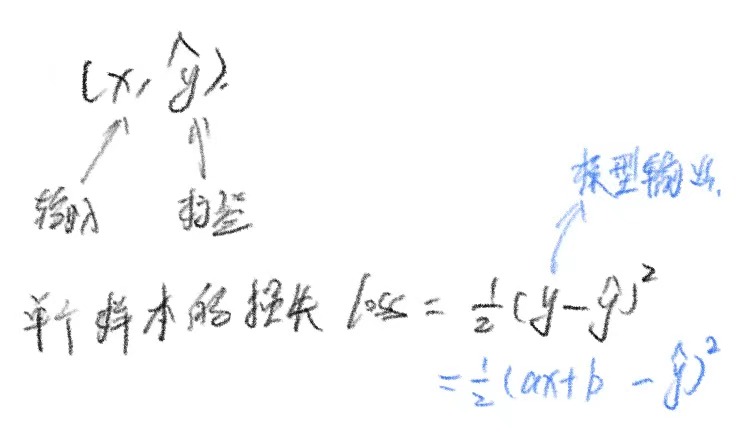
  • 单个样本的损失loss

  • 364

但是我们实际训练的时候,是不可能用单个样本的loss损失来衡量模型当前的质量的(万一这个样本本身不太好,对吧)

**平均损失函数Loss
所以我们选择一个batch,一个批的样本,来衡量模型的质量。 为了度量模型在整个数据集上的质量,我们需计算在训练集个样本上的损失均值(也等价于求和)
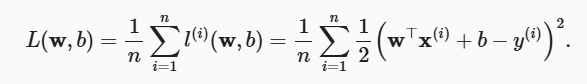
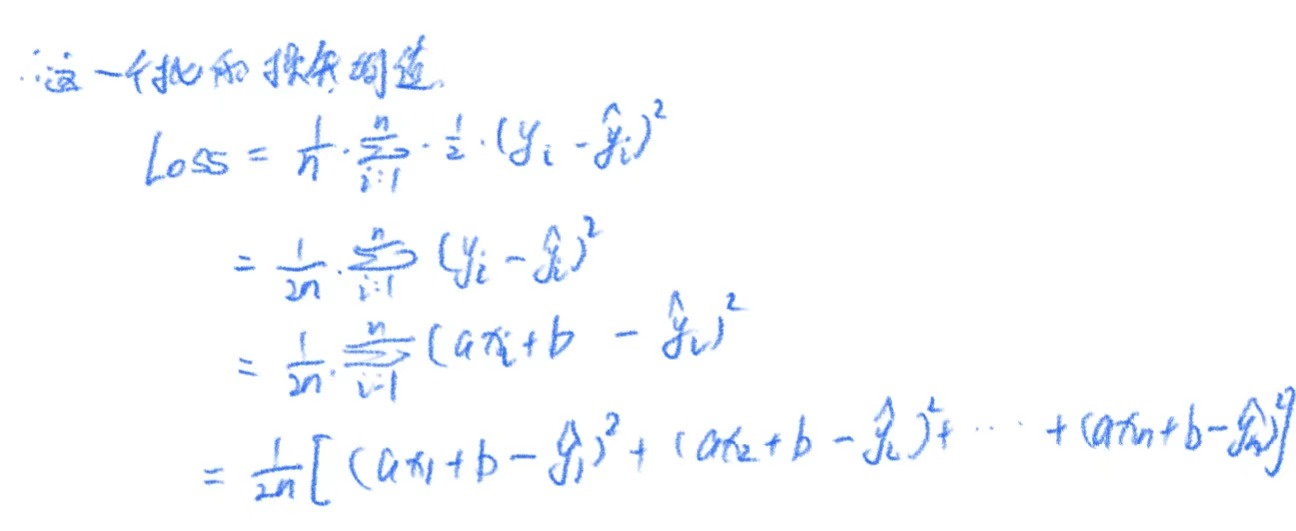
587

所以我们最终会使用这个平均损失函数Loss,来作为衡量模型质量的标准。

优化模型

我们获得了数据集,定义了模型,然后设置了Loss损失函数,来衡量模型的好坏。

最初,输入输入到模型(经过模型参数运算),得到输出,但是这个和真值标签是有差距的。

所以我们训练模型的目的,就是为了,获得一个最佳的模型参数,让这个模型的损失函数最小。

所以,训练本质上是围绕着损失函数来进行的。

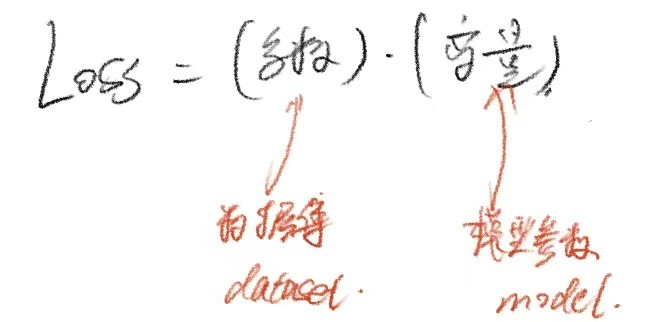
为什么损失函数能作为训练的依赖呢,因为损失函数,主要由两块组成:

  • 模型参数
  • 数据(输入+标签)

可以看到,Loss的组成里面,损失函数本身只是一个组合模型参数和数据的框架。绿色里面是我们的模型参数+数据集。

其中红色是模型参数,蓝色是我们的数据集。

当给定数据集后(即给定输入x1, x2, ….., xn, 标签y1’, y2’, …., yn’)数据集就作为Loss(a,b)这个函数的系数,然后我们当前模型的参数(a1,b1),只是这个Loss(a,b)曲线上的一个点。

我们的目的,是为了找一个(a2,b2), 当下一次再次输入这个数据集的时候(所以Loss(a,b)的系数没有变),Loss的值能够变小。

这就用到了梯度下降
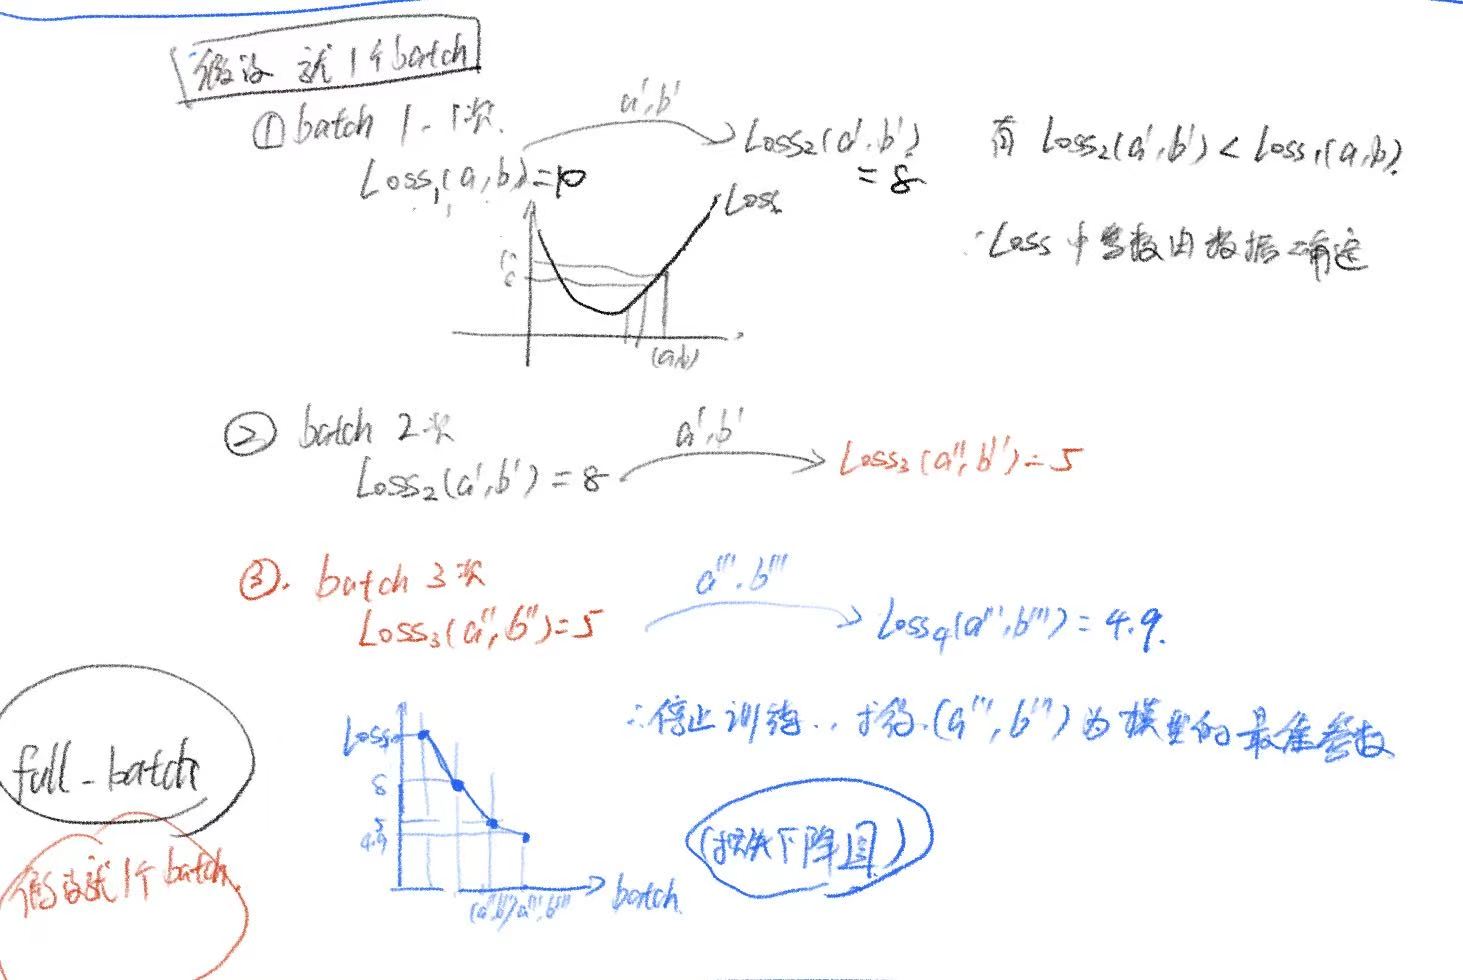
上面举了一个full-batch的例子,当只有一个batch的时候,Loss的图像本身是不会变的。因为系数不变。如果mini-batch,有多个batch,会变化,但是训练的更快了。

为什么我们使用mini-batch?
因为full-batch, 相当于一个batch里面包括了所有的样本,全部输入完了才更新模型参数。
这会导致Loss里面的n项(n个样本)太大,内存不停的占用。导致爆内存。
322

所以,这就解释了,Loss损失函数,模型参数model,数据集dataset, 这三者是一个整体,要一起讨论的。

举例证明

下面来看一下我们训练的过程
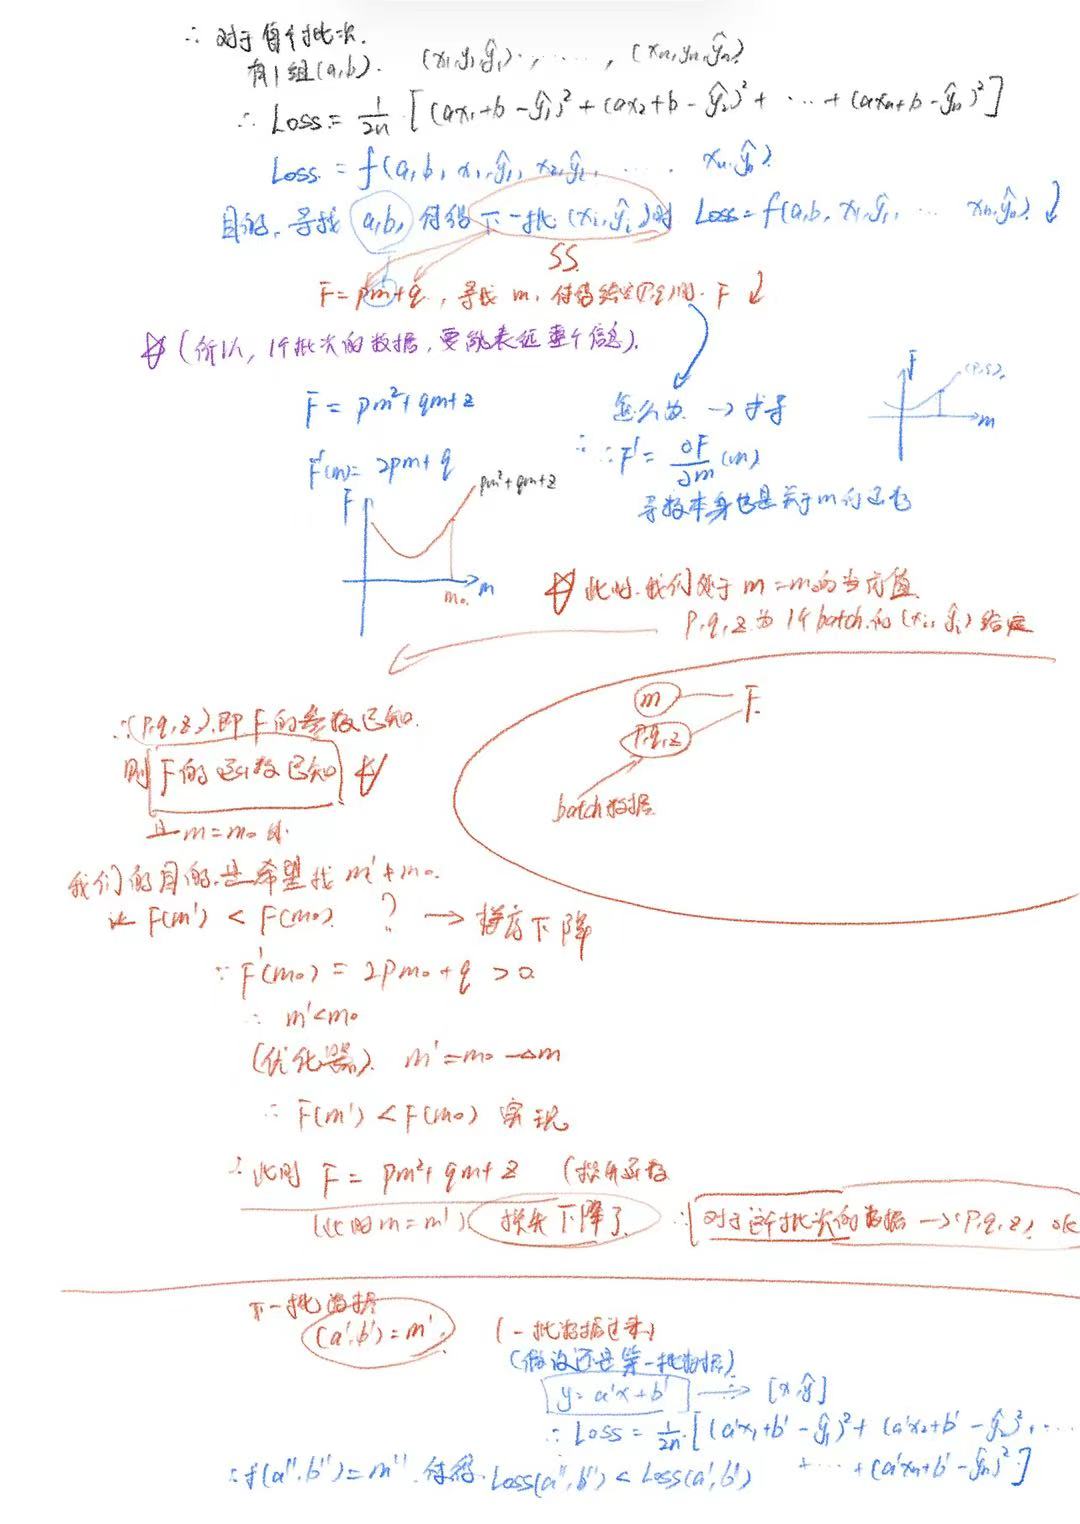
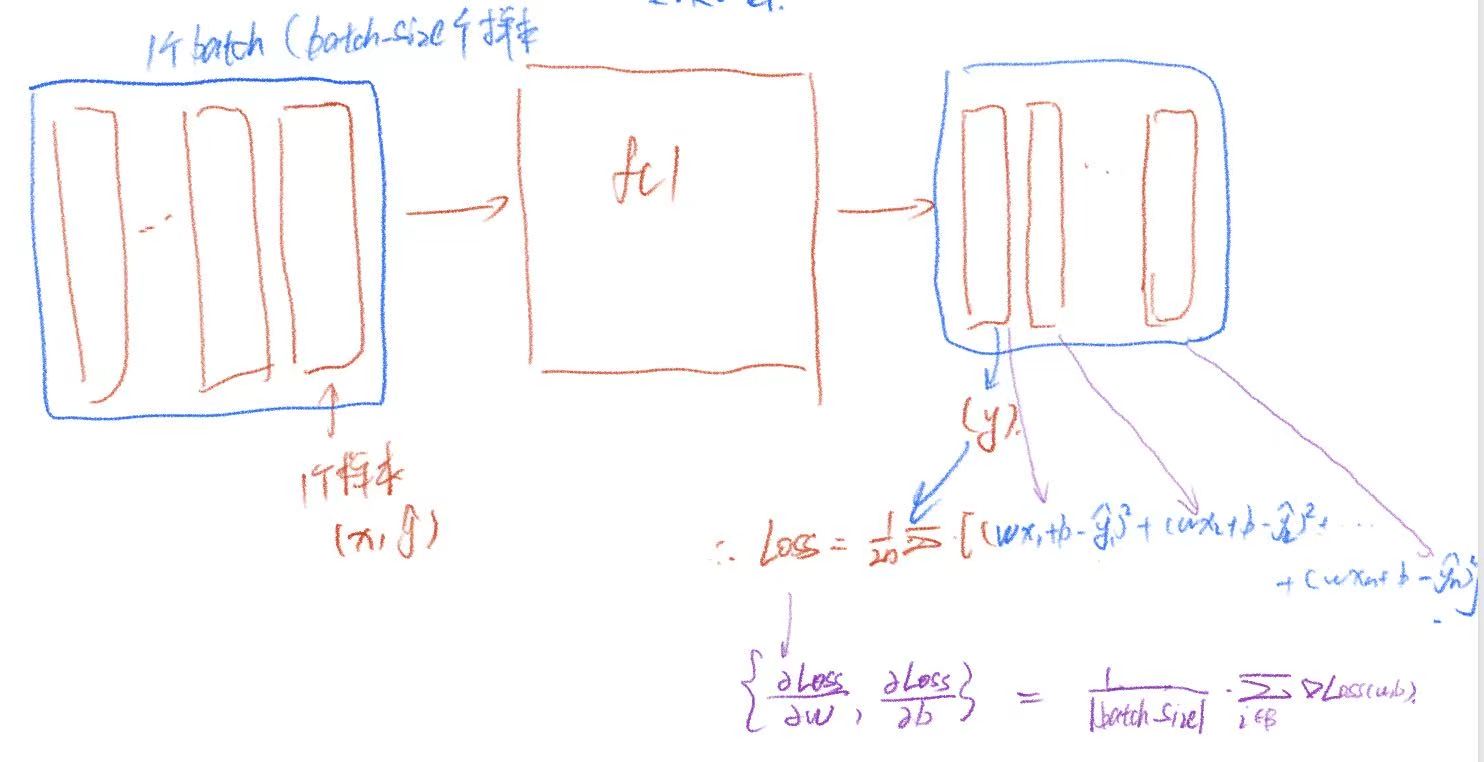
Loss函数求w,b的梯度

batch_size

  • = 一个batch批,里面有多少个样本
  • = Loss(w,b) = 1/2n * ∑((wx1+b-y1’)2+(wx2+b-y2’)2+…+(wxn+b-yn’)2) 里面有多少项

所以当batch_size > 1的时候。
Loss(w,b)关于(w,b)求出来的梯度,本质上是平均梯度。已经除了batch_size了。
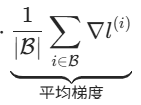
84

513

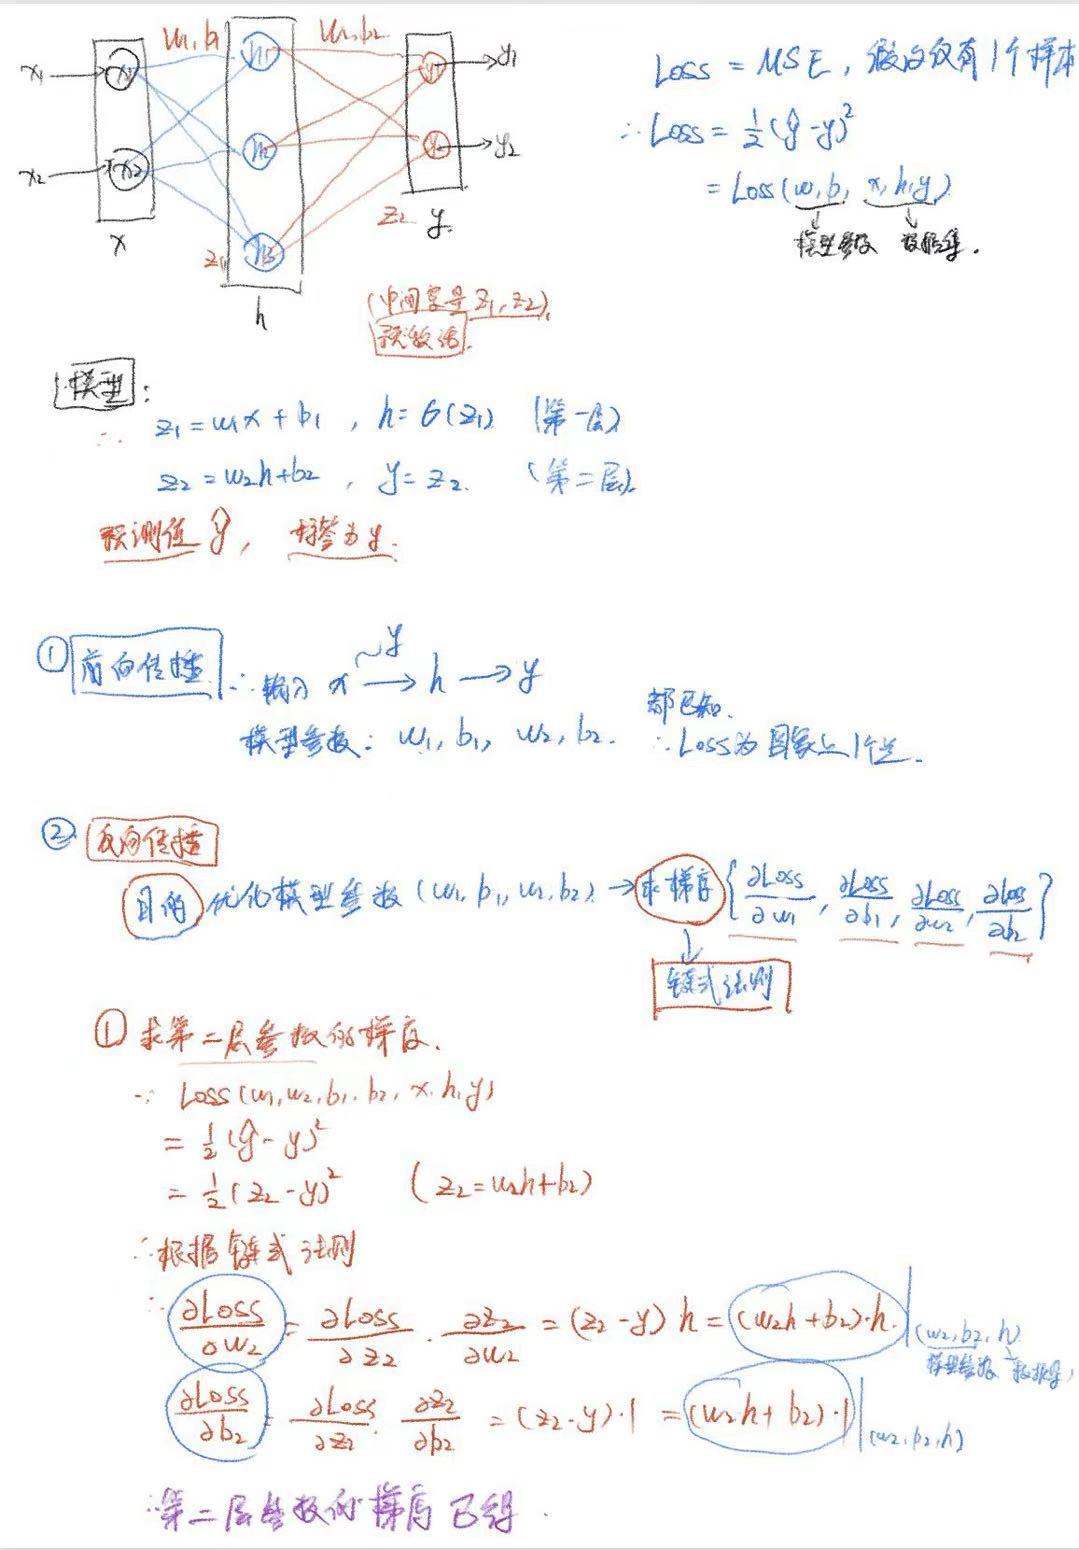
多层FNN时链式法则,反向传播更新梯度的过程

^e096f0

假设现在有一个双层的全连接网络,第一层一般用激活函数。下面给出证明过程

一般我们习惯:全连接层的:

  1. 输入:x
  2. 权重矩阵W,偏置向量b
  3. 输出(非最后一层叫预激活): z
  4. 激活函数sigma

593
584

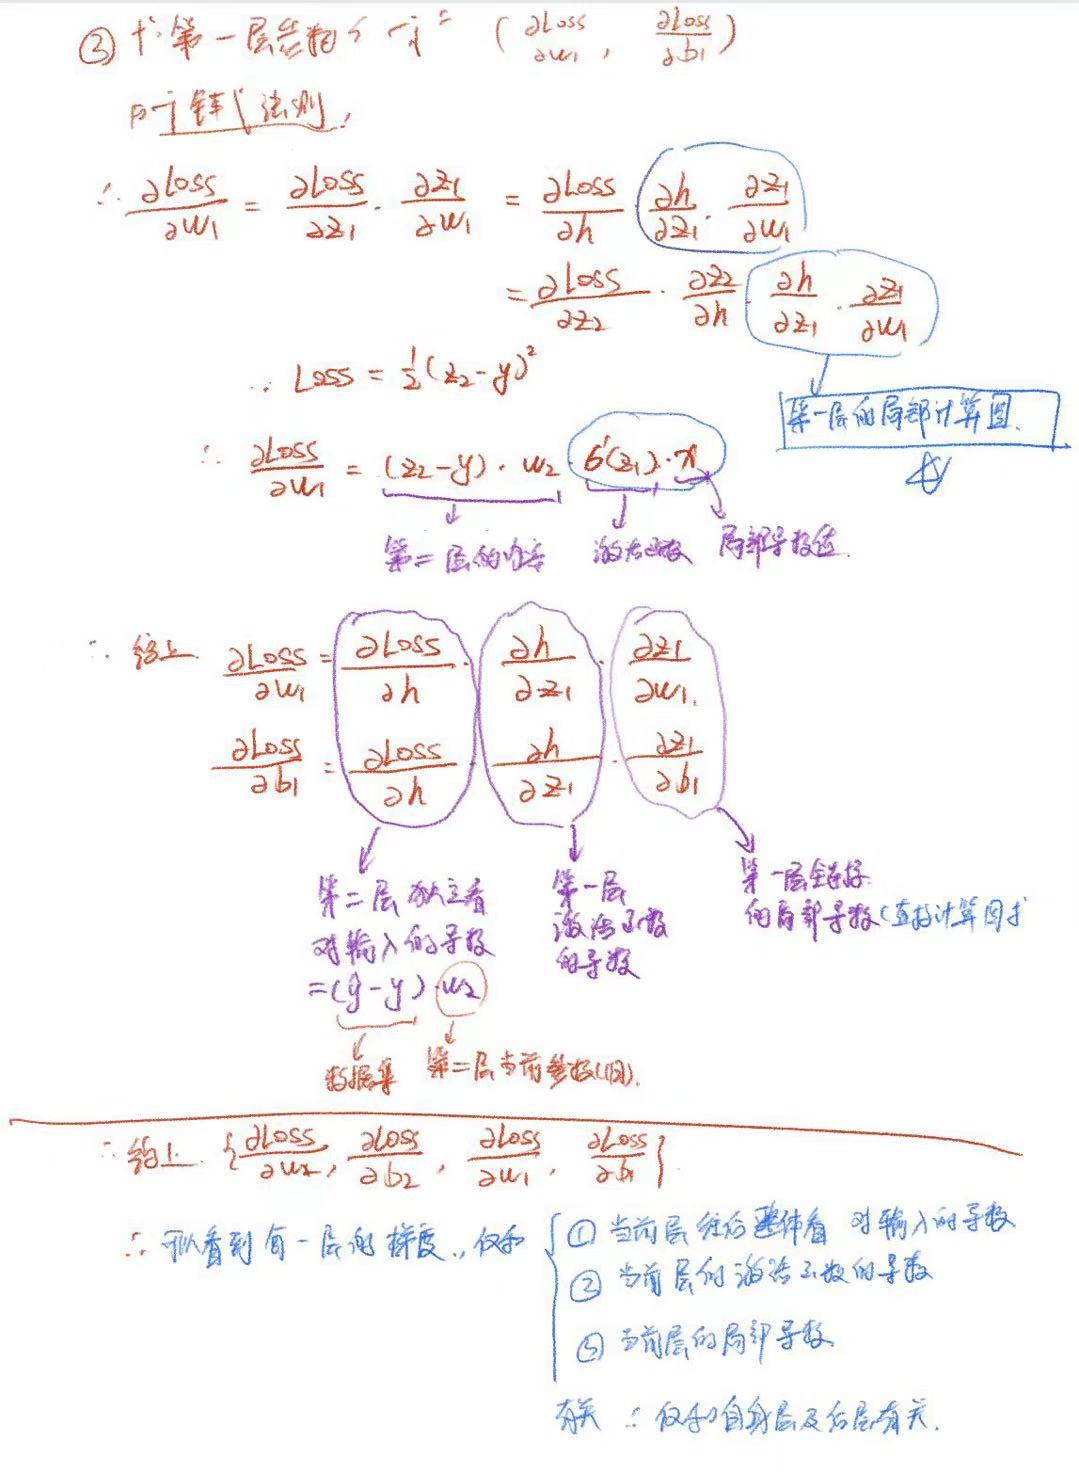
所以总结下来:每一层参数的梯度,仅和

  1. 反向传过来的上游误差:就是后面所有层 + 损失,对当前层输入的导数
  2. 当前层激活函数的局部导数
  3. 当前层线性部分((z=Wx+b))对自身参数的局部导数

有关。所以,每一层的参数的梯度,仅和自身层及后层有关。

优化参数

我们举得例子,就是最简单的y =ax + b, 就是最简单的一维输入,一维输出的简单线性回归模型

包括我们后面多维输入构成的FNN全连接层,都是这个训练逻辑,这样就很好理解了。

那么,扩展到一般的线性回归模型: y=wx + b, 其中w,b均为张量。

我们模型的参数就是(w,b), 我们训练的目的,就是更新这个(w,b), 让Loss损失函数min

那么具体更新参数呢?
前面只讲了,Loss对w,b求微分,得到关于(w,b)的平均梯度。我只知道方向要往左/右变化,那么变化多少呢?

这个就是优化器**要干的事情了

他决定了如何更新模型的参数,减去一半?还是减去多少?

下面展示一个最简单的优化器:
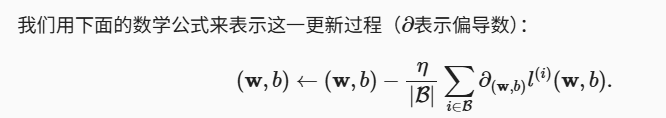
454
具体可以写成
490
186
86

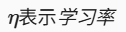
注意,这里的平均梯度,就是我们自动求导计算出来的了。我们优化器仅有两个参数:

  • 模型参数(w,b)
    • 平均梯度已经存放在参数的对象里面了。
  • 学习率(lr)
    240
    这里的批量大小,学习率,就是我们的超参数

    batch_size, 就是表示的一个batch里面有多少个样本。

梯度下降得到什么?
我们一个batch,能够得到batch_size个分类的Loss损失函数,然后Loss关于w,b求导。得到的是

我们不需要具体关心如何更新参数,直接选用torch库里面的优化器就行了。

总结

至此我们从理论层面上讲解推导了

  • 数据
  • 模型+参数
  • 损失函数
    • 优化器
      的作用。

torch 数据

这一节,来讲一下,torch库,是如何处理模型所需要的数据的

torch库里面专门用来处理数据的库是:

  • torch.utils.data.Dataset torch库的数据集类
  • torch.utils.data.DataLoader torch库的数据集迭代器类(帮助获取数据的类)

    既然都是类,那么要用,肯定要创建各自的对象,才能实际发挥作用。

创建自定义数据集

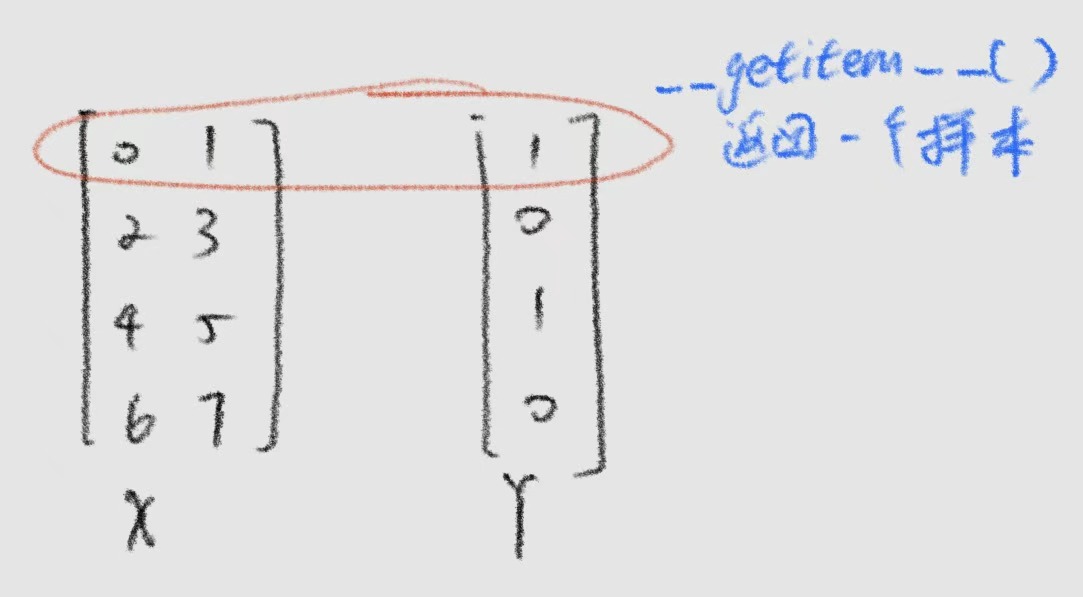
创建自定义的数据集,需要自己实现一个自定义数据集类(集成Dataset基类),然后为迭代器提供两个必要的方法。用来告诉迭代器如何访问你的自定义数据集。

import numpy as np
import torch
from torch.utils.data import Dataset, DataLoader

# 定义 自定义数据集类,继承Dataset基类
class MyDataset(Dataset):
# 类的构造函数下半段, 获取我的数据集内容
def __init__(self, X_data, Y_data):
self.X_data = X_data
self.Y_data = Y_data

# 实现内置__len__方法,用来返回数据集的数据长度
def __len__(self):
return len(self.X_data)

# 实现内置__getitem__方法,用来返回一条张量的数据样本
def __getitem__(self, idx):
x = torch.tensor(self.X_data[idx], dtype = torch.float32)
y = torch.tensor(self.Y_data[idx], dtype = torch.float32)
return x, y

# 这是我们自定义的数据X(输入),Y(标签)
X_data = np.arange(8).reshape(4,2) #先用numpy创建一个4x2的 0-7的数组
Y_data = [1,0,1,0]

# 创建出我们自己的数据集对象dataset
dataset = MyDataset(X_data, Y_data)

# 创建一个数据集迭代器,用来替我们自由的随机选择数据集。
""" 迭代器设置:指定数据集对象, batch_size批数(分成batch_size批),shuffle表示随机选取"""
dataloader = DataLoader(dataset, batch_size=2, shuffle=True)


for epoch in range(1):
for batch_idx, (inputs, labels) in enumerate(dataloader):
print("batch index = ", batch_idx)
print("(inputs, labels) = ", (inputs, labels))

batch index =  0
(inputs, labels) = (tensor([[0., 1.],
[6., 7.]]), tensor([1., 0.]))
batch index = 1
(inputs, labels) = (tensor([[2., 3.],
[4., 5.]]), tensor([0., 1.]))
batch index =  0
(inputs, labels) = (tensor([[2., 3.],
[6., 7.]]), tensor([0., 0.]))
batch index = 1
(inputs, labels) = (tensor([[0., 1.],
[4., 5.]]), tensor([1., 1.]))

可以看到,连续两次运行后,enumerate( dataloader), 枚举迭代器让它一次返回一个迭代单位

  • 第x/2批数据样本
  • 随机返回抽取

所以可以看到,每次返回的是2x2的,也就是随机两个样本组成的张量,也就是一个batch,一个批次

从这里就可以看出,深度学习的训练,对数据的使用,是以批为单位的。一批才计算一次损失,更新一次模型参数。

预定义数据集 + 数据预处理

torch里面还内置了一些比较知名的数据集。比如手写数字图片MNIST数据集。

同时,我们针对数据,肯定也希望有一些管线的预处理,来实现数据增强。比如图片的翻转,裁剪,数据范围的归一化等等。

我们这里使用的MNIST,手写图片,是属于CV领域的,所以是定义在torchvision模块库里面的。

  • torchvision.transforms (数据处理库)
    • transforms.ToTensor()
      • openCV的图片格式是(高度x宽度x通道),里面每个元素的范围是0-255
      • .ToTensor()转换维度格式化(通道x高度x宽度),元素取值范围/255(也就是0-1)
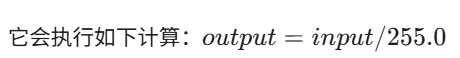
      • 这样将opencv的图片格式转成 卷积能用的张量。
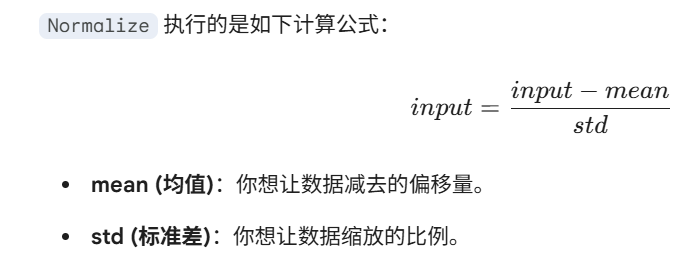
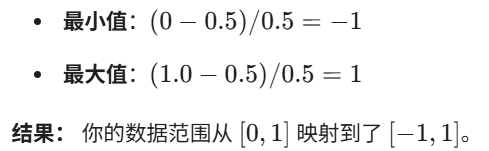
    • transforms.Normalize(mean, std) 调整每个像素的值的范围从(0-1)到(-1-1),这样方便收敛,因为以0为中心
  • torchvision.datasets (官方提供的“素材库”和“工具箱”)
    • 是一个内置数据集的库,内置了CV领域的经典公开数据集。
import  torch
import torchvision.transforms as transforms
import torchvision.datasets as datasets

# 这里我们预定义一个数据处理流(一组数据处理函数,用来实现一系列的数据处理)
transform = transforms.Compose([
transforms.ToTensor(), #转成tensor张量格式
transforms.Normalize(mean=[0.5], std=[0.5]) #归一化,核心作用是将图像的像素值分布调整到一个特定的范围(通常是 0 均值附近),从而加速模型的收敛
])

"""开始加载经典MNIST手写数据集
dataset.MNIST()库函数提供下载,读取方式
- root="./data" 指定数据集的存储目录,下载后其他项目也能指定使用
- train=True 区分训练集60000个样本/测试集10000个样本。
- transform=transform 指定每个数据样本(一张图片)的加工流水线,处理成能输入CNN的张量tensor
- download=True 自动下载开关(打开后,会自动检查root下是否有数据,有就直接加载。)
"""
# 加载了两个数据集
train_dataset = datasets.MNIST(root="./data", train=True, transform=transform, download=True)

test_dataset = datasets.MNIST(root="./data", train=False, transform=transform, download=True)


"""
开始创建两个数据集的迭代器。64个批,训练集随机采样,测试集不随机。
"""
train_dataloader = torch.utils.data.DataLoader(dataset=train_dataset, batch_size = 64, shuffle=True)
test_dataloader = torch.utils.data.DataLoader(dataset=test_dataset, batch_size=64, shuffle=False)

例子

举一个RNN的数据输入。

想要1000个样本,每个样本的序列长度为10, 输入维度input_size = 5, 输出维度为2(每个样本一个输出标签)

参数解析:

  • 一个样本(序列段)
    • seq_len(序列段长度,有多少个时间步)
    • input_size (输入特征维度)
  • 样本数量 1000
  • 批batch, 这个和迭代器绑定。

torch的随机张量:

  • torch.randn(形状) 标准正态分布
  • torch.rand(形状) [0, 1),均匀分布
  • torch.randint(), 生成指定范围内的随机整数

torch.utils.data.TensorDataset 从tensor张量直接创建数据集,属于Dataset的一个子类。

import torch
from torch.utils.data import DataLoader, TensorDataset

num_samples = 1000
seq_len = 10
input_size = 5
output_size = 2


X = torch.randn(num_samples, seq_len, input_size) # 定义num_samples个样本。元素服从标准正态分布(大部分集中于0)
Y = torch.randint(0, output_size, size=(num_samples,)) # 0表示随机数最小值,output_size 随机数最大值.[0,2)之间的整数,也就是0/1, size=指定尺寸,一维1000个。一个样本,对应一个标签值。一共1000个样本的标签

dataset = TensorDataset(X,Y)
"""
把这1000个样本,随机切割成32个批
"""
train_loader = DataLoader(dataset, batch_size = 32, shuffle=True)

所以数据的逻辑是:

  1. 元素
    1. (一个时间步)
    2. 图片的一个通道
  2. 样本(多个元素)
    1. 多个时间步
    2. 3个通道的完整一张图片。(通道x 高度 x 宽度)(很像3个时间步)
  3. 批batch(多个样本)
    1. 多个序列块
    2. 多张图片

torch 模型

这里主要记录一下,各个主流模型的定义,以及,torch库里面集成的库,用于快速构建模型

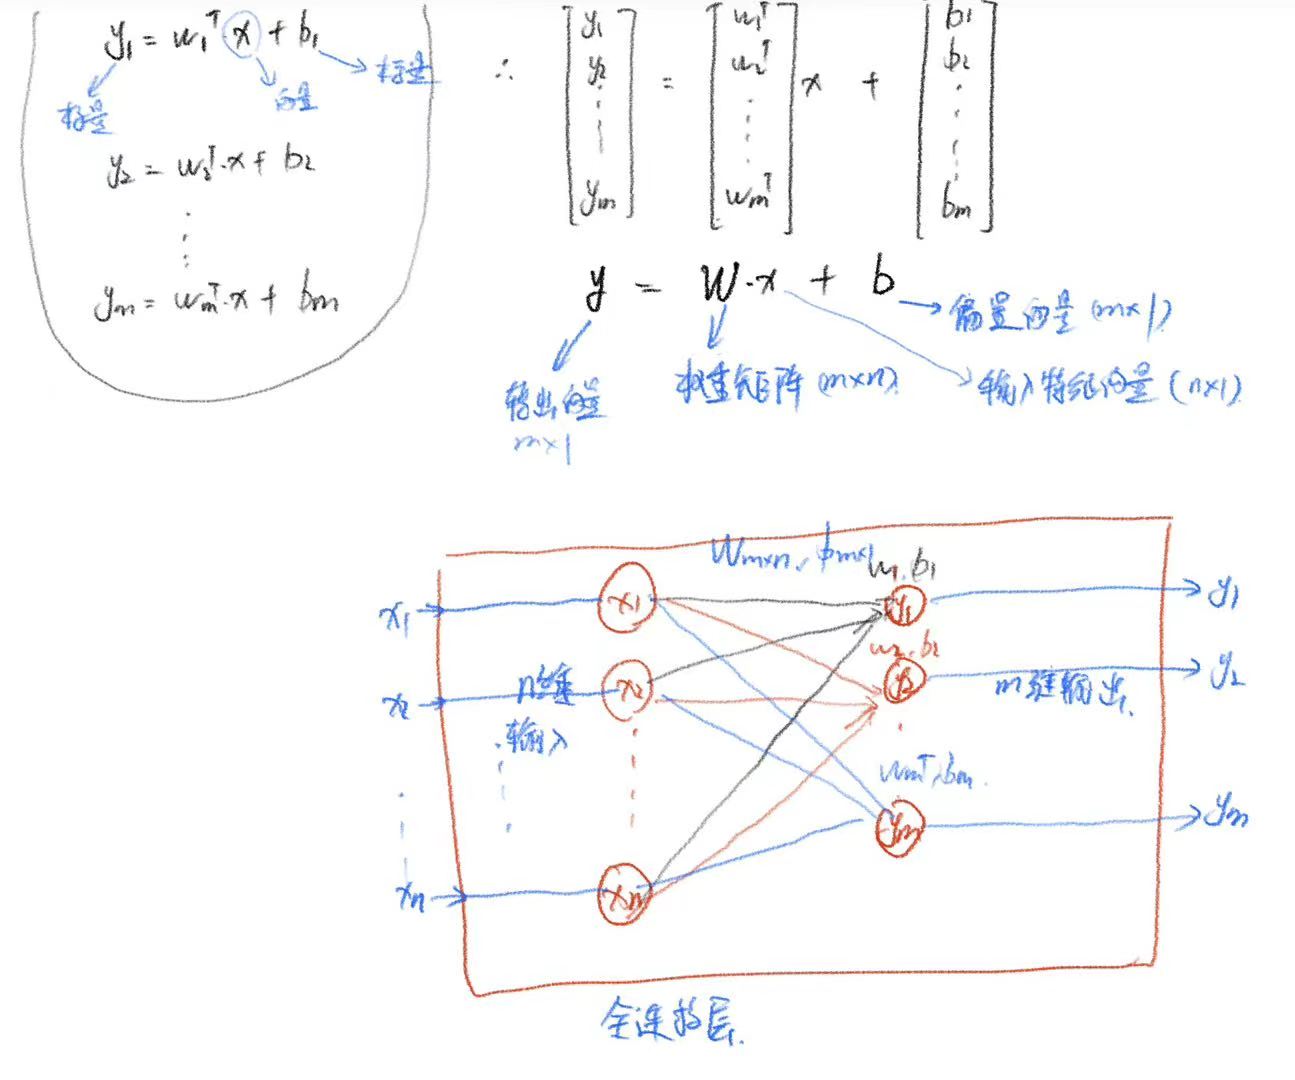
线性回归单元

线性回归单元,就是我们之前说的y =wx + b (w, x 均为n维向量,b维标量)
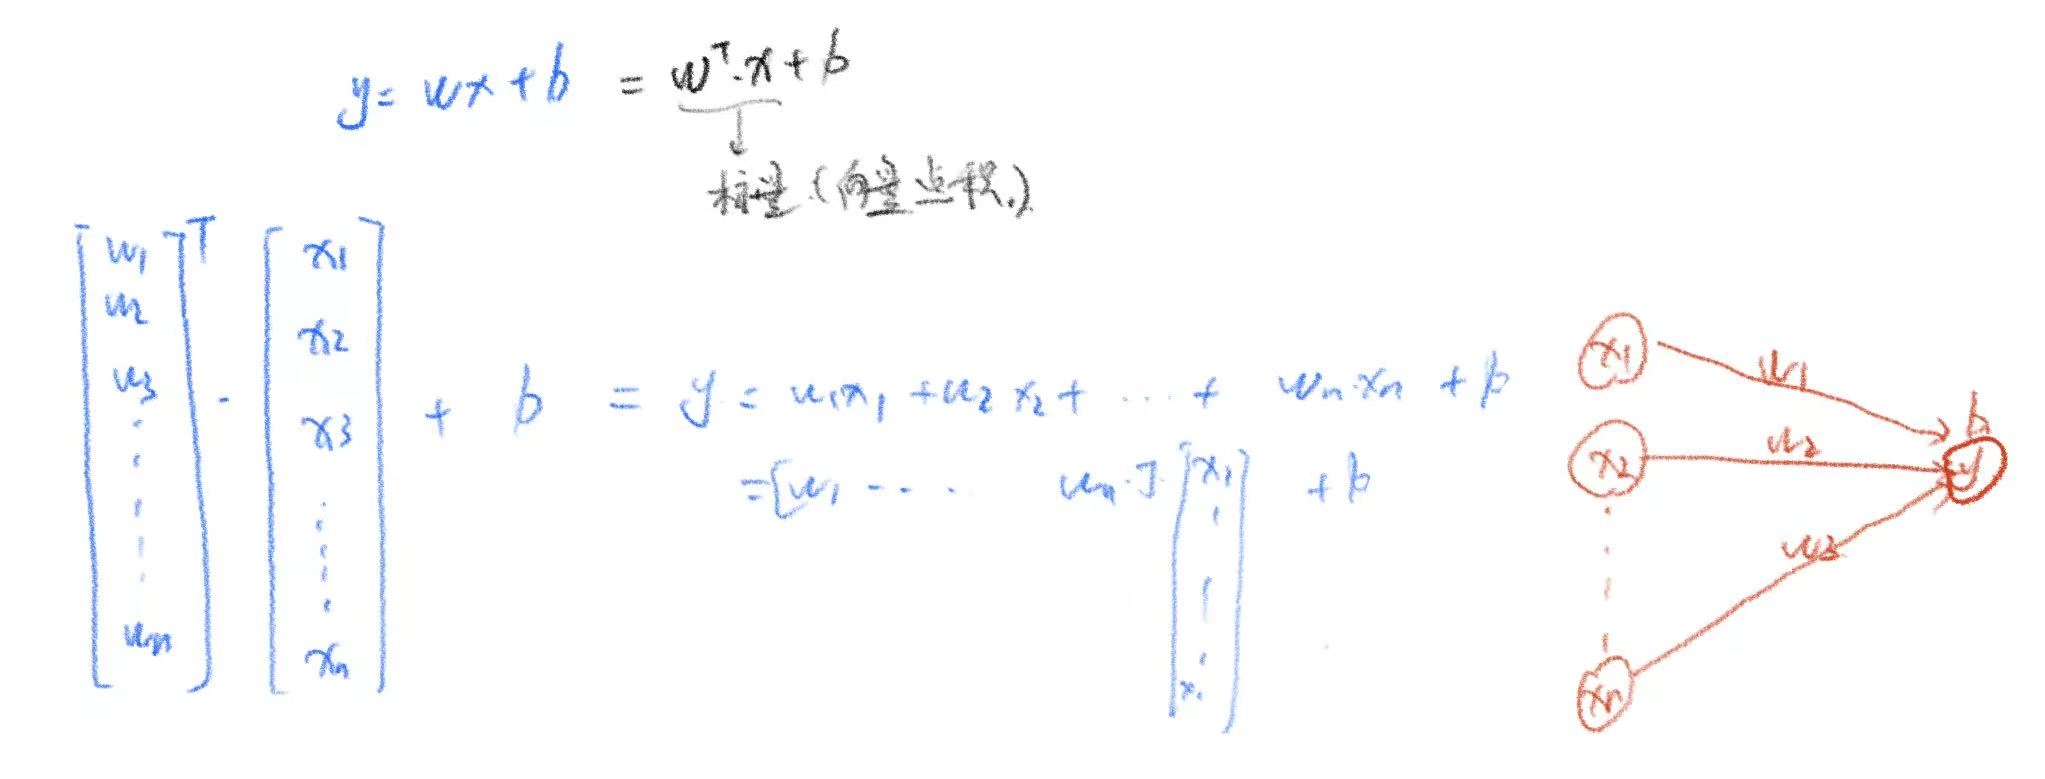
566
所以一个线性回归单元,就有一个输出,对应一个w权重向量(n维),以及一个b偏置标量。

一般把网络横过来传导观看
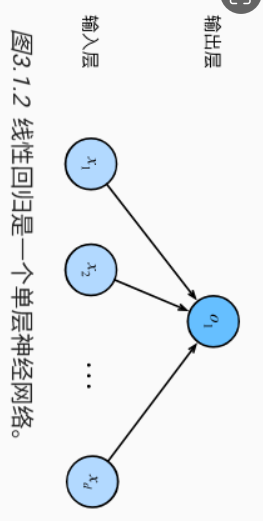
112

全连接层

上一节的线性回归单元,一个线性回归单元,对应:

  1. n维输入
  2. 1维输出
  3. 一个n维的w权重矩阵
  4. 一个1维的b偏置标量

所以,当我们把他组合起来后,就形成了我们的全连接层

所以当具有多层时,也就具有了从n维输入-> m维输出的全连接层

所以定义一个全连接层,仅需要确认:

  • 输入特征维数
  • 输出特征维数

下面对两种用途的全连接层,做一个讨论

回归

以上的一个全连接层构成的FNN前馈神经网络。这个模型输出的都是回归,也就是预测一个值,比如价格,场次,天数(int, float这些)

这里,我们主要关注**每个输出维度的值**。

torch库定义层+初始化参数

torch库可以方便的帮我们提供一个全连接的对象,以及初始化权重矩阵,偏置矩阵的方法

  • .weight.data 用来访问权重矩阵W
  • .bias.data 用来访问偏置向量b
from torch import nn

"""定义一个输入维数为2, 输出维数为1的全连接层"""
fc1 = nn.Linear(2,1)

"""权重矩阵W.normal_正太分布,期望为0, 方差为0.01的随机初始化"""
fc1.weight.data.normal_(0, 0.01)
"""偏置向量b.fill_全部0填充"""
fc1.bias.data.fill_(0)

torch 构造model对象


"""
from torch import nn
nn就是torch里面的神经网络库文件
torch.nn库, 提供了各种构造model对象的方法和类定义
用全连接层组成一个网络"""
model=nn.Sequential(fc1)

torch 创建损失函数对象


"""
torch.nn库,提供了各种损失函数的类定义
"""
loss=nn.MSELoss() #就是均方误差:Mean Squared Error, MSE

202

torch 优化器对象

"""
torch.optim库,提供了各种优化器的类定义
"""

optim = torch.optim.SGD(model.parameters(), lr=0.01)

可以看到,我们每次用Loss来自动求导后,梯度分量全部存放在W,b这些模型参数对象的.grad属性里面。所以,优化器仅需要知道模型参数对象即可。
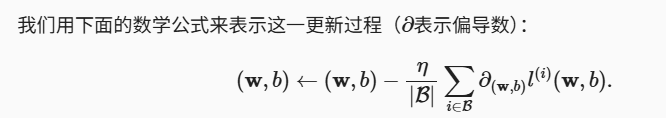
545

右边的平均梯度,就是我们反向传播自动求导的梯度,已经存放在参数对象里面了。

训练过程

model.train() #设置model对象,能够修改模型参数
for epoch in range(3):
for X,y in data_iter:
l = loss(net(X), y) # 使用损失函数对象的仿函数(预测值,标签值),固定好Loss损失函数的系数
optim.zero_grad() # 让优化器来清除模型参数对象中的梯度值
l.backward() # Loss(w,b)计算平均梯度,写入模型参数对象中
optim.step() # 利用学习率 + 平均梯度,更新模型参数。

# 该epoch训练完成,输入测试集,计算出当前的Loss(w,b)损失,正常情况下,每轮训练后,损失是会下降的。
l = loss(model(features), labels)
print("epoch %d, loss %4f" % (epoch, l))


"""
epoch 1, loss 0.000248
epoch 2, loss 0.000103
epoch 3, loss 0.000103
"""

分类(softmax回归)

但是,有时候,我们不关心具体的值,我们只关心是0/1,也就是bool。也就是我们希望输出是一哪一个?是不是?

这个时候,我们关注的是:输出哪个维度的位置, 或者单个输出维度的二值性

这两种关注角度都可以实现我们的分类需求:

  • 输出3个维度(猫,狗,人)进行分类
  • 输出一个维度(输入1, 有人;输出0,没人)

分类问题中 标签的处理

因为是分类问题了,所以期望输出,要么关注输出的维度的位置,要么关注输出维度的二值性。

所以数据集中的标签,要做对应的one-hot编码,才能表示位置。
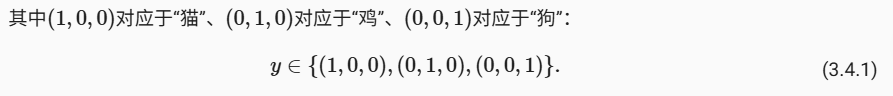
616

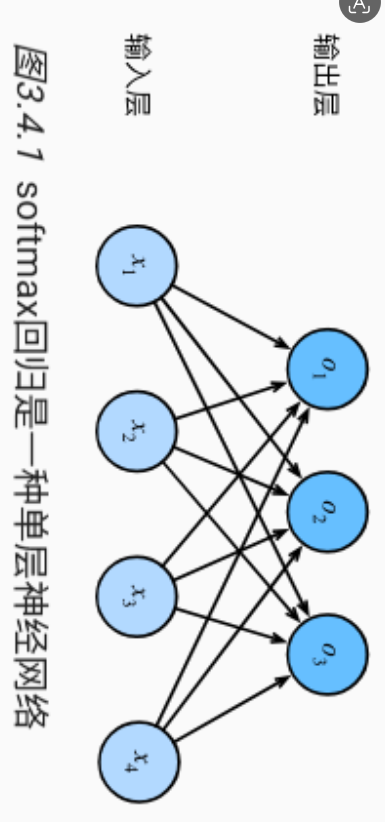
网络架构

为了估计所有可能的类别的条件概率。我们肯定需要一个至少单层的模型,有多个输出,每个类别对应一个输出。

所以结构仍然是一个全连接层。

  • 输入维度4
  • 输出维度3(分类3类)
  • 权重矩阵(W)
  • 偏置向量(b)
    310
    129

所以softmax回归,本质上,并不是网络结构的变化,而是对输出内容的理解发生了变化,也就是数据集的标签发生了变化。

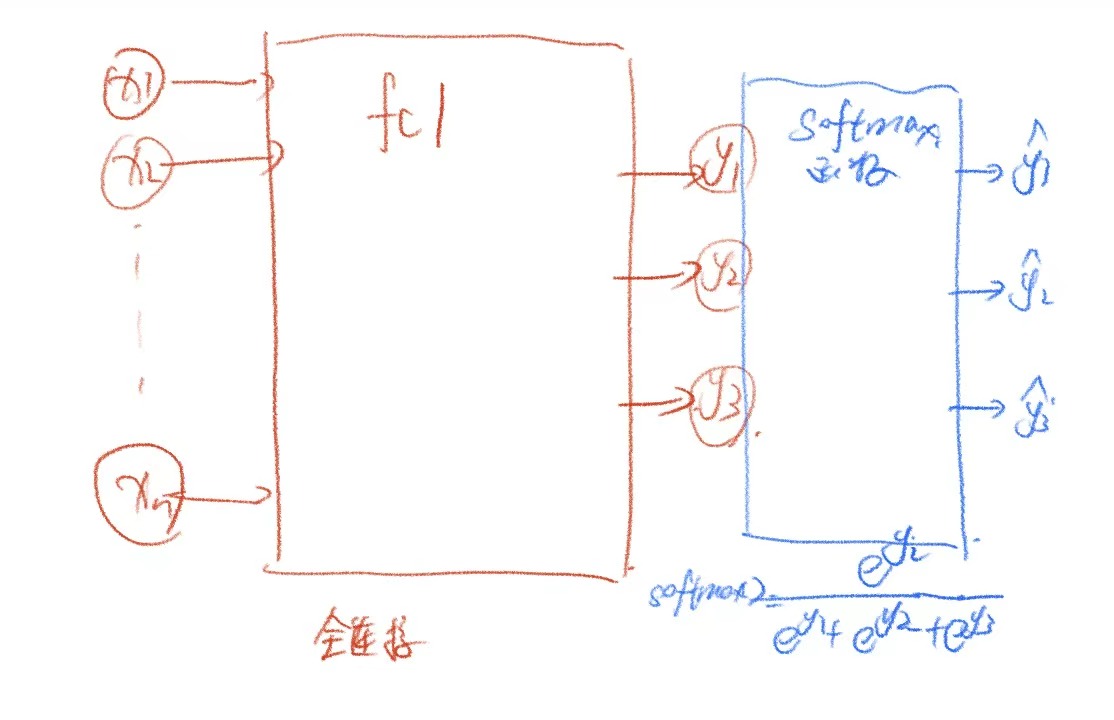
softmax运算

现在我们的模型的每一个输出,都能回归出一个值,范围是随机一个数字, 因为每个输出的标签不是0,就是1.

这就会导致,三个输出回归出来的值可能是这样{0.7,0.4, 0.9}

光看这个值,看不出这个回归出来的每个类别的打分,有什么意义

  • (不是概率,因为和不为1)
  • (每个输出,也可能回归出负数)

所以,要将每个输出,改造成概率。要做到:

  • 每个类别,输出非负
  • 总和为1

所以,对输出,做一个softmax处理,全部去e的幂次方,然后取比例权重。
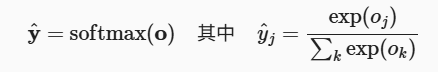
329

然后选择最大的概率的那个,就是我们识别出来的分类。

425

交叉熵损失函数

前面在讲全连接层回归的时候,我们使用的是均方误差损失函数。

但是在这种分类问题中,我们一般不适用均方误差函数。因为我们设置损失函数,本质上就是希望,能去衡量出模型的优劣,具体说就是,能够反应预测值与标签值的差距大小嘛。

而我们的标签值是独热编码(1,0,0)这种。而我们的预测值,是softmax函数处理之后的每个分类的概率(0.7,0.2,0.1)这种。通过观察可以发现。

我们通过使用交叉熵损失函数,定义如下:
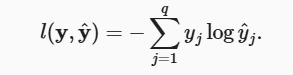
242
这个是单个样本的损失,可以看到,yj是标签,yj’ 是预测的值,q是类别的数量。

所以,当我们输入一个样本之后,这个交叉熵损失函数,就可以很好的衡量,这个预测的值准不准。
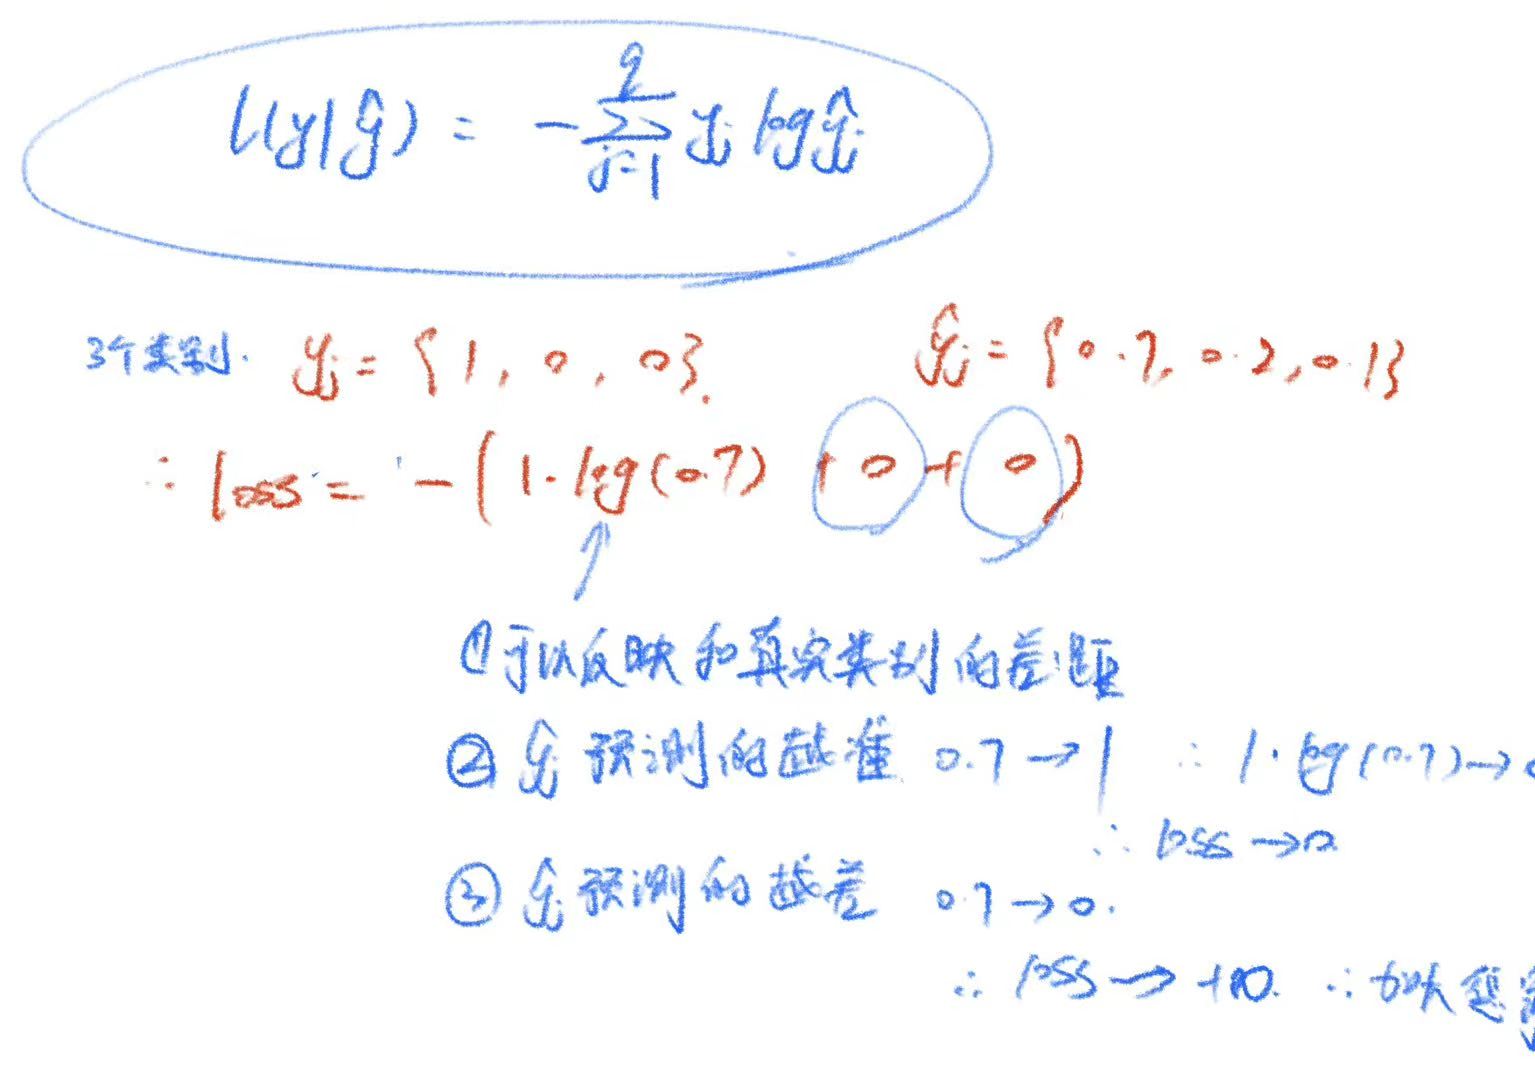
379

使用交叉熵损失函数,反向传播的时候,和多层回归最大的不同,就是,多了一个softmax环节嘛。

那么同样利用链式法则,把softmax()函数当成一个激活环节,把前面的输入作为预激活输出。这样只要知道Loss对预激活输出的梯度,这样就可以和前面的多层反向传播对上了[[#^e096f0]]

所以我们将y = softmax(o)代入loss,然后求导即可。
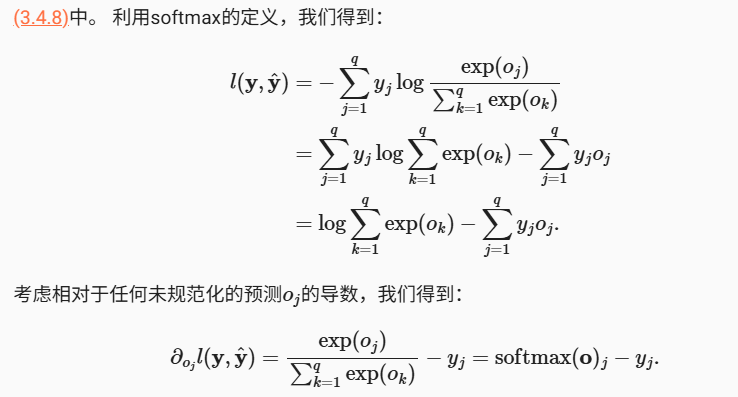
418

以上就解释了单个样本的损失,当一个batch有多个样本的时候,我们通常就是所有样本的损失加起来,求平均,得到平均损失。
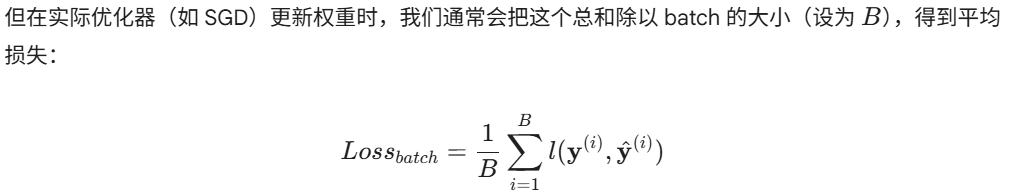
518

torch实现softmax回归

如果我们要从零开始实现,也很简单,就是自己实现前向传播的公式就行了,torch构建出的计算图,就是为了实现数学公式,比较麻烦的是,要自己计算,记录,传播。

import torch
import torch.nn as nn
from d21 import torch as d21


"""数据集"""
# 一批数据集是256个样本
batch_size = 256
# 准备好数据集的迭代器
train_iter, test_iter = d21.load_data_fashion_mnist(batch_size)


"""模型"""
# nn.Flatten()展平层,是把一张单通道图片样本(1x28x28)(通道x高度x宽度)压平
# 就一层FNN
net = nn.Sequential(nn.Flatten(), nn.Linear(784,10))

# 初始化模型参数
def init_weights(m):
if type(m) == nn.Linear:
nn.init.normal_(m.weight, std=0.01)

net.apply(init_weights)


"""损失函数对象
pytorch里面,softmax()函数,通常不放在模型里面。而是集成在交叉熵损失函数里面。

reduction='mean', 表示返回一个标量:所有样本的损失的平均值,求出来的就是平均梯度了。
reduction='sum', 表示返回一个标量:所有样本的损失的和
reduction='none', 返回每个样本的损失构成的张量

所以你可能还需要手动求平均,
"""
loss = nn.CrossEntropyLoss(reduction='none')


"""创建优化器对象
优化器对象,需要平均梯度
"""
trainer = torch.optim.SGD(net.parameters(), lr=0.1)


"""训练"""
num_epochs=10
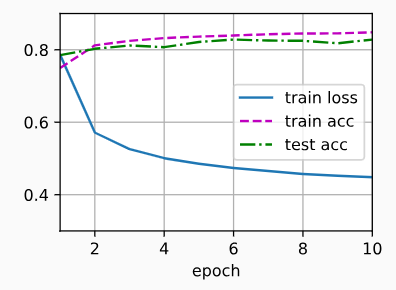
d21.train_ch3(net, train_iter, test_iter, loss, num_epochs, trainer)

246

有几点需要注意:

  • pytorch里面,softmax 通常不放在模型里面,而是集成在 nn.CrossEntropyLoss 损失函数中直接计算。

    • 原因:如果你先在模型里算 softmax,得到的概率 $\hat{y}_j$ 可能会因为非常小而被计算机四舍五入成 0(下溢)
    • 当损失函数接着去计算 $\log(\hat{y}_j)$ 时,$\log(0)$ 会变成 **$-\infty$
    • 从而使模型容易跑崩。
  • pytorch里面,创建损失函数对象,loss=nn.MSE(),然后使用的时候,是传入loss(预测值,标签值),为什么不需要知道模型参数?

    • 当你执行 预测值 = model(输入) 时,PyTorch 会在后台悄悄建立一张计算图
    • 这个 预测值 张量内部包含了一个指向生成它的操作(比如线性层、激活函数)的指针,而这些操作又连接着模型的 权重(weight) 和 偏置(bias)

FNN 前馈

前面我们从最简单的线性回归单元->全连接层->单层/多层全连接回归模型->softmax回归

前面重心放在理解,数据,模型,损失函数,梯度下降,softmax。

下面,我们来具体的研究模型这件事,首先第一个就是FNN,多个全连接层组成的神经网络,也叫多层感知机MLP

多层感知机MLP

前面我们的一层全连接层, z = wx + b, 本质上都是线性的映射(仿射变换)

但是,我们很难使用一层全连接的线性映射,来表示特征x-> 标签y的映射。

所以,我们需要使用多层全连接层,也就是加入隐藏层h1,h2,…

我们可以通过在网络中加入一个或多个隐藏层来克服线性模型的限制, 使其能处理更普遍的函数关系类型。 要做到这一点,最简单的方法是将许多全连接层堆叠在一起。 每一层都输出到上面的层,直到生成最后的输出

假设L层 全连接层,我们把前面的L-1层,看作表示,最后一层看作线性预测器。这种架构通常称为_多层感知机(multilayer perceptron),通常缩写为MLP_
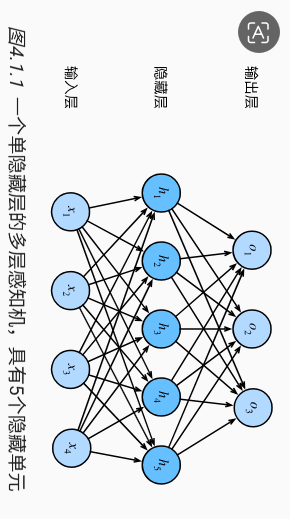
199

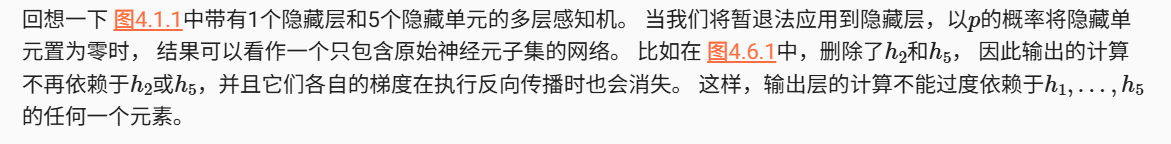
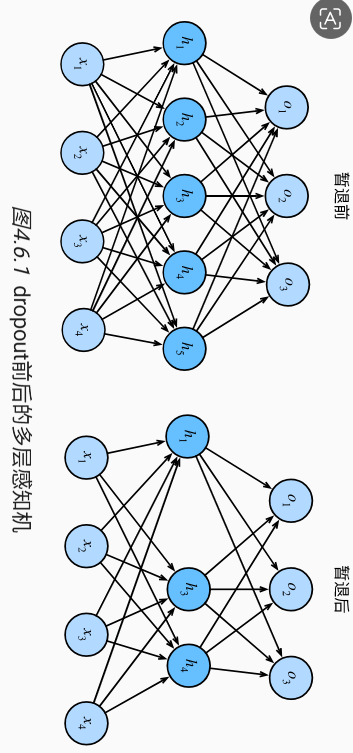
如上图所示,输入4个维度,输出3个维度,中间隐藏层的单元5个维度。这个MLP的层数为2

然而,这种层层堆叠的MLP,它的参数开销很高。所以在不改变输入,输出大小的情况下,对模型的参数和有效性之间要衡量一下。

激活函数

前面我们提到的MLP的,他的各层全连接层,是首位相接的,但是,这会有一个问题:
线性函数带入线性函数,还是线性,这回导致维数下降。

所以,为了发挥多层架构的潜力,我们还需要一个关键的连接因素:
在仿射变换之后,对每个隐藏单元,应用非线性的激活函数, 激活函数的输出,被称为活性值

有了激活函数,就不可能再将我们的多层感知机退化成线性模型
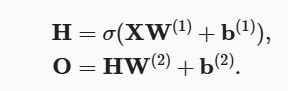
211

全连接层输出(预激活值)z = wx + b
隐藏层单元(活性值)h=σ(z)
最后一层的线性预测器(输出)o =wh + b

这样之后,模型才能充分发挥各层的潜力。

ReLU函数

ReLU()函数 , 也叫修正线性单元
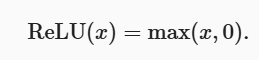
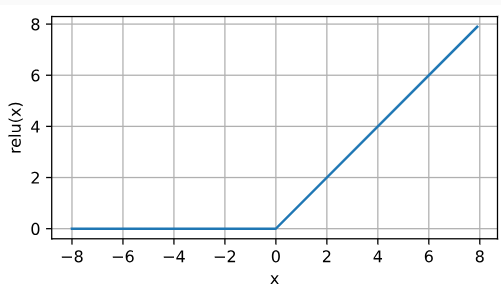
171
295

ReLU(x)
当x < 0, 导数为0, 当x > 0, 导数为1, x=0处的导数为0

ReLU函数的好处是:

  • 求导表现特别好(反向传播计算梯度的时候)
    • 要么让参数消失,要么让参数通过
  • 减轻了梯度消失问题

ReLU函数变体:

  • 参数化ReLU, pReLU
    • 232

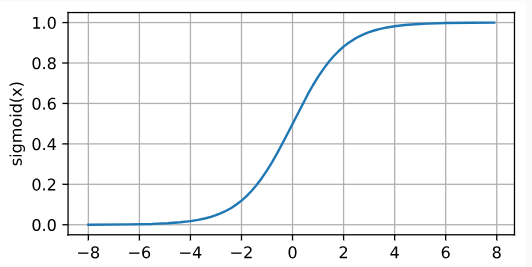
sigmoid函数

sigmoid函数,将输入变换为区间(0,1)上的输出。
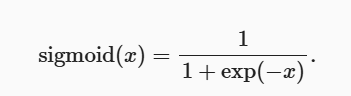
250

295

可以看到,sigmoid函数,是一个平滑,可导的阈值单元的近似。

当我们想要将输出看成是二元分类问题的概率时,就可以来用了。不过隐藏层用的较少

可以看到,sigmoid函数,本质上就是想把任意x的取值,往0/1上去近似映射。

RNN里面,利用sigmoid单元来控制时序信息流的架构。

sigmoid函数,求导之后,可以看到,x=0处,导数最大到0.25
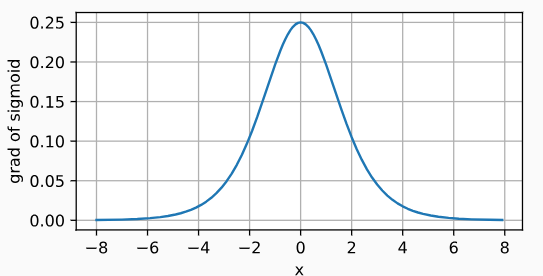
267

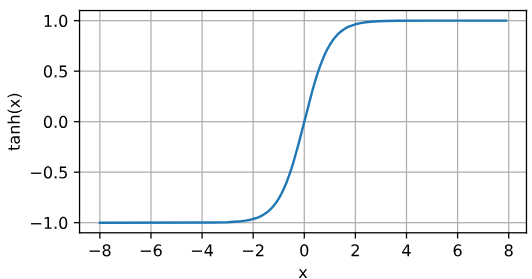
tanh函数

tanh函数,和sigmoid函数类似,不过他映射的范围不是(0,1),而是(-1,1)
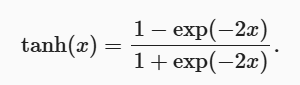

322

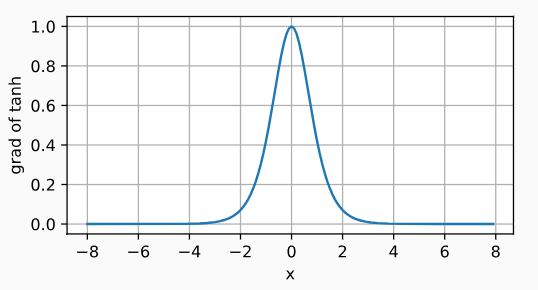
这个tanh函数求导后,x=0处取导数最大值1
243

torch实现MLP

下面用torch库来实现多层感知机,先来定义一下模型,并初始化模型参数‘

pytorch支持自动挡 创建模型

import torch
from torch import nn

"""
d2l是 动手学深度学习的 辅助库,就是个教学工具包
"""
from d21 import torch as d21


"""模型"""
net = nn.Sequential(nn.Flatten(), # 多加一个这个是为了读取图片
nn.Linear(784,256),
nn.ReLU(),
nn.Linear(256,10))

def init_weights(m):
if type(m) == nn.Linear:
nn.init_normal_(m.weight, std=0.01)

# net.apply 里面定义一个针对层的巡检规则,如果是线性层,就初始化参数为正态分布
net.apply(init_weights)

也支持手动挡 创建模型

class MyModel(nn.Module):
def __init__(self):
super().__init__()
self.fc = nn.Linear(784, 256)

# 直接初始化
nn.init.normal_(self.fc.weight, std=0.01)
nn.init.constant_(self.fc.bias, 0)

def forward(self, x):
# ...

以上使用nn.init.normal_(self.fc.weight, std = 0.01) 是手动挡实现层的参数初始化。

也可以使用自动初始化,通过根据层的输入输出神经元数量,来自动调整初始化范围, 这样就不用自己指定标准差了

  • Xavier 初始化(适用于 Sigmoid/Tanh):nn.init.xavier_normal_(m.weight)
  • Kaiming 初始化(适用于 ReLU):nn.init.kaiming_normal_(m.weight)

定义好了模型,下面开始获取数据,定义损失函数,优化器,然后训练

batch_size, lr, num_epochs = 256, 0.1, 10
loss = nn.CrossEntropyLoss(reduction='none')
trainer = torch.optim.SGD(net.parameters(), lr=lr)

train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)
d2l.train_ch3(net, train_iter, test_iter, loss, num_epochs, trainer)

模型选择,欠拟合,过拟合

我们希望模型,能够真正发现一种泛化模式,而不是简单的记住数据。所以希望有泛化能力。

损失,是针对单个样本来说的;误差,是针对整个数据集的宏观表现,比如RMSE

误差分类:

  • 训练误差:模型在训练集上的loss损失
  • 泛化误差:模型应用在从原始样本分布中抽取的无限多数据样本时,误差的期望。我们在测试集上算出的误差,本质上是对泛化误差的一种估计

几个影响模型泛化的因素:

  1. 可调整参数的数量。当可调整参数的数量(有时称为_自由度_)很大时,模型往往更容易过拟合。
  2. 参数采用的值。当权重的取值范围较大时,模型可能更容易过拟合。
  3. 训练样本的数量。即使模型很简单,也很容易过拟合只包含一两个样本的数据集。而过拟合一个有数百万个样本的数据集则需要一个极其灵活的模型。

把数据集分成3块:

  • 训练集:来训练模型(课后作业)
  • 验证集:用来选择模型(模拟考)
  • 测试集:用来得出最终选择的模型的性能(高考)

K折交叉验证
当训练数据稀缺时,把训练数据分成K个子集。然后执行K次训练和验证:每次在K-1个自己上训练,并在剩余一个子集上验证。最后结果取平均来估计训练误差和验证误差

模型泛化性能
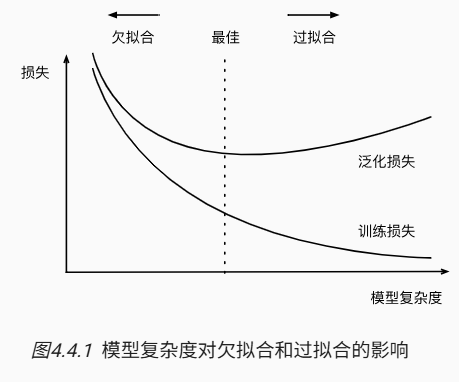
307
过拟合:训练集上效果好,但是测试集效果不好

  • 解决办法:
    • 正则化
    • 增加数据量
      欠拟合:训练集效果不好,测试集效果也不好
  • 解决办法:
    • 增加模型复杂度
    • 输入更多维度的数据
    • 增加训练轮次
    • 减少正则化

模型复杂度

前面我们讲到,如果模型出现过拟合,说明模型太复杂了,需要使用正则化技术。因为我们不太可能收集更多的训练数据。

假设我们已经有了尽可能多的高质量数据。重点便放在正则化上

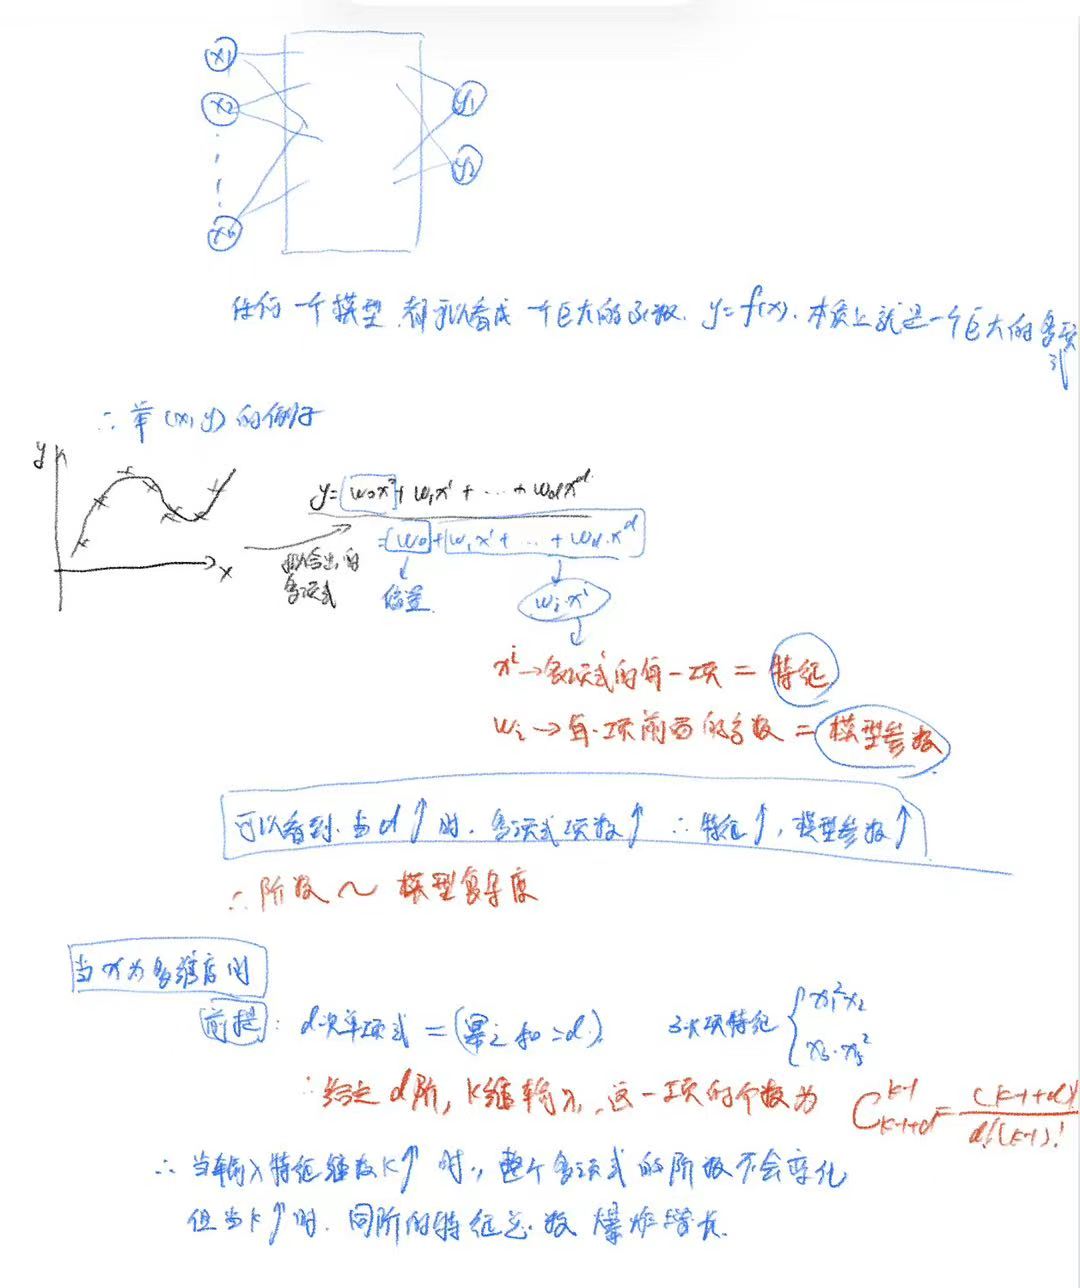
假设模型输入维度(x1,x2, ……, xn)。那么经过一层全连接后,得到的输出,是关于输入的一阶多项式。

当经过多层之后,模型拟合的多项式的阶数 = 激活函数的个数, 这只是抽象看,实际上不是多项式,而是分段线性

608

我们先来从多项式的角度理解模型复杂度
理解前提:我们的整个模型,本质上,就是一个多项式函数。就是一个巨大的函数嘛
510

所以可以看到,模型复杂度和两件事有关:

  1. 模型层数d
  2. 输入特征维度k

这里,要认识到,模型复杂度,其实是一个动态变化的东西:

  • 模型阶数d不变,导致模型多项式的阶数肯定是固定的
  • 输入特征的维度k,决定了,每一阶特征的种数,理论上你有 $C_{k-1+d}^{k-1}$ 种特征。

但是在具体训练过程中,我们会调整模型参数,也就是多项式每一项特征的系数,所以并不是所有理论的特征都会出现,因此,模型的复杂度,其实是在动态变化的。

权重衰退(L2正则化)

当理解了模型复杂度之后,我们要知道:

  • 仅仅通过限制阶数d,模型也可能复杂

我们需要一个更细粒度的工具来调整模型函数的复杂度。

所以,我们的权重衰退,本质上,就是为了降低模型复杂度。(图像上体现在平滑一点,降维了)

L2正则化:通过函数与0的距离,来衡量函数的复杂度。
那么如何衡量函数f和0的距离呢?其实没有唯一标准

现在的情况是:

  • 我们的目的:降低模型复杂度,来减少过拟合
  • 如何降低模型复杂度呢?
    • 模型阶数d,改变不了
    • 输入特征维数k,每一阶特征理论总数 $C_{k-1+d}^{k-1}$ 种特征,也变不了
    • 只能通过修改特征的系数(模型参数),来减少特征的出现。

我们就要在训练中,增加一个功能,来让模型参数w, 也就是特征系数,尽可能的->0, 这样可以有效减少出现特征的数量。

那么如何在训练中增加这个功能呢?

答案:在损失函数Loss中(训练的目的,是让Loss->0),加入一个惩罚项$|\mathbf{w}|^2$, 这样模型在优化过程中不仅要减小预测误差,还要保证权重向量尽可能小

好处是:
权重w 均匀整体的变小调整,不是简单的丢弃某个特征。同时整体上,也限制了个别特征独大。

如果没有正则化,模型可能会为了拟合某个噪声点,给某个高阶特征分配一个极大的权重,导致拟合曲线剧烈抖动。$L_2$ 正则化强迫系数保持在一个较小的范围,使得函数更加平滑

这个惩罚项,就是我们的L2的范数:

636

因此,使用L2正则化,来改造我们的损失函数

这是原来的平均损失函数(一个batch的样本)
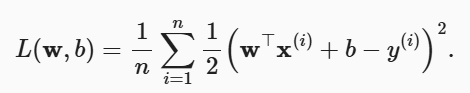
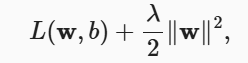
322
214

加入的λ,为正则化常数(>0)

为什么我们选择L2范数,而不是L1范数?

  • L2正则化线性模型构成经典的岭回归算法
    • 使用L2范数的一个原因是它对权重向量的大分量施加了巨大的惩罚。 这使得我们的学习算法偏向于在大量特征上均匀分布权重的模型。
    • 在实践中,这可能使它们对单个变量中的观测误差更为稳定
  • L1正则化线性模型是统计学中类似的基本模型,为套索回归。
    • L1惩罚会导致模型将权重集中在一小部分特征上, 而将其他权重清除为零。 这称为_特征选择_(feature selection),这可能是其他场景下需要的

既然已经正则化改造了我们的损失函数,下面就是梯度下降,优化器更新模型参数了。一个batch的更细如下:
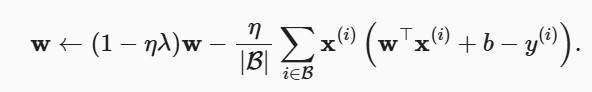
458

可以看到,具体的优化操作,:

  • 不仅根据估计值和标签值之间的差异来更新(后一项)
  • 还根据权重本身的大小来更新

这也就是为什么叫做权重衰退,权重衰减为我们提供了一种连续的机制来调整函数的复杂度

λ越小,对w的约束越小,正则化效果越小;
λ越大,对w的约束越大,图像越平滑

至于对偏置的惩罚,不同层不一样。最后一层网络输出层,不用正则化偏置。

dropout 暂退法

前面理解了L2正则化,现在换一个角度,从概率的角度看

我们假设一个先验,权重的值均取自均值为0的高斯分布。同时我们也期望模型深度挖掘特征,将权重分散到许多特征中,而不是过于依赖少数潜在的虚假关联。(特征系数,尽量平均高斯,不能就靠几个特征)

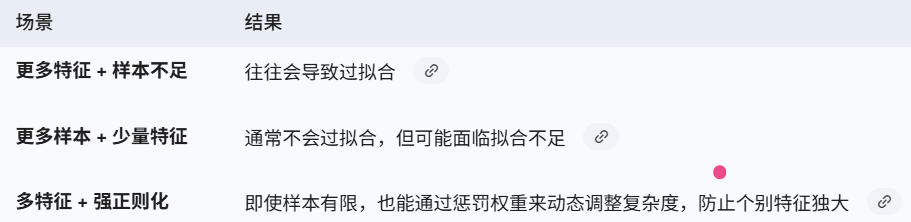
  • 当面对更多的特征而样本不足时,线性模型往往会过拟合。
  • 相反,当给出更多样本而不是特征,通常线性模型不会过拟合

所以这表明 特征,样本,过拟合之间的关系:

  • 特征:决定模型复杂度的上限
    • 阶数d越高,输入维度k越大,模型生成的特征项就越多,模型也就越“复杂”
    • 如果特征数量远超样本量,线性模型往往会通过给每个特征指定过大的权重,精准地“背下”所有训练数据的细节(包括噪声),从而导致过拟合
  • 样本:决定模型的“泛化底气”
    • 缓解过拟合:当样本数量相对于特征数量非常充裕时,线性模型通常不会过拟合。
    • 泛化的代价:然而,仅仅依靠增加样本而保持模型简单(如简单的线性模型)是有代价的:这种模型可能无法考虑到特征之间复杂的交互作用,导致其捕捉信息的能力较弱
551

泛化性-灵活性的权衡:偏差-方差权衡

  • 线性模型
    • 有很高的偏差:它们只能表示一小类函数。
    • 然而,这些模型的方差很低:它们在不同的随机数据样本上可以得出相似的结果
  • 深度神经网络
    • 位于偏差-方差谱的另一端,与线性模型不同,神经网络并不局限于单独查看每个特征,而是学习特征之间的交互

即使我们有比特征多得多的样本,深度神经网络也有可能过拟合

什么是好的预测模型?

  • 泛化性:在未知数据上有好的表现,模型相对简单
  • 平滑性:不应该对输入的微小变化敏感,加不加噪声基本不能影响。
    • 提出了一个想法:在训练过程中,他们建议在计算后续层之前向网络的每一层注入噪声。 因为当训练一个有多层的深层网络时,注入噪声只会在输入-输出映射上增强平滑性

这个想法就被称为暂退法
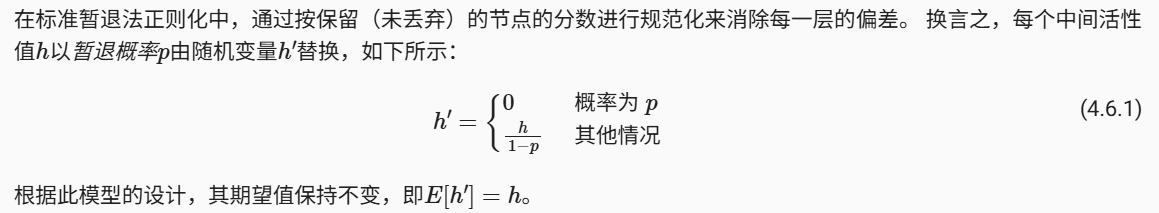
 暂退法在前向传播过程中,计算每一内部层的同时注入噪声(实际操作时通过丢弃神经元来加噪声的),这已经成为训练神经网络的常用技术。 这种方法之所以被称为_暂退法_,
 
 > 因为我们从表面上看是在训练过程中丢弃(drop out)一些神经元。 在整个训练过程的每一次迭代中,标准暂退法包括在计算下一层之前将当前层中的一些节点置零

如何注入这种噪声。
无偏向(unbiased)的方式注入噪声

  • 第一种方法:
    • 高斯噪声(添加式):这是毕晓普(Bishop)提出的方法,通过将均值为零的高斯噪声 $\epsilon \sim \mathcal{N}(0, \sigma^2)$ 添加到输入 $\mathbf{x}$ 中,产生扰动点 $\mathbf{x}’ = \mathbf{x} + \epsilon$。其期望值 $E[\mathbf{x}’] = \mathbf{x}$ 保持不变。

    • 标准暂退法(丢弃式):这是目前深度学习中最常用的方法。它不是添加高斯分布的数值,而是使用随机变量按概率 $p$ 直接“丢弃”节点


144

pytorch简洁实现

dropout1=0.2
dropout2=0.5
net = nn.Sequential(
nn.Flatten(),
nn.Linear(784, 256),
nn.ReLU(),
nn.Dropout(dropout1),
nn.Linear(256, 256),
nn.ReLU(),
nn.Dropout(dropout2),
nn.Linear(256,10)
)

def init_weights(m):
if type(m) == nn.Linear:
nn.init.normal_(m.weight, std=0.01)

net.apply(init_weights)


)

推理/训练的计算图

这里主要开始具体理解,前向传播(推理),反向传播(训练)的计算图了

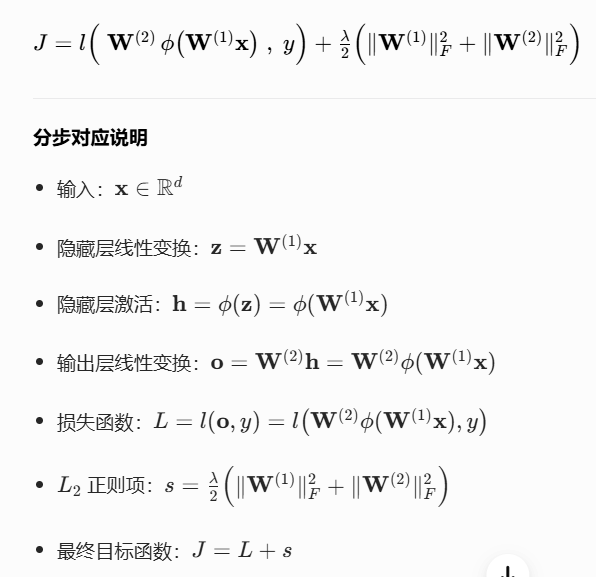
我们讨论,L2正则化的单隐藏层的MLP的网络模型上

我们先罗列好前向传播的计算
342

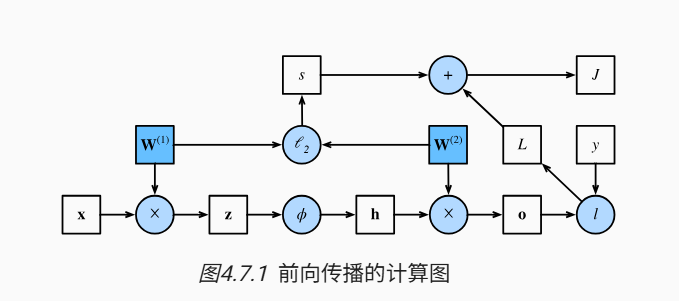
这个就是一步步推导,没什么好说的,其pytorch底层构建的前向传播的计算图如下:
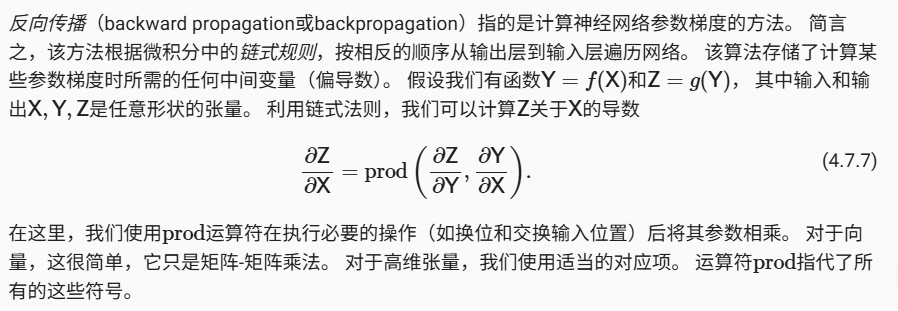
反向传播
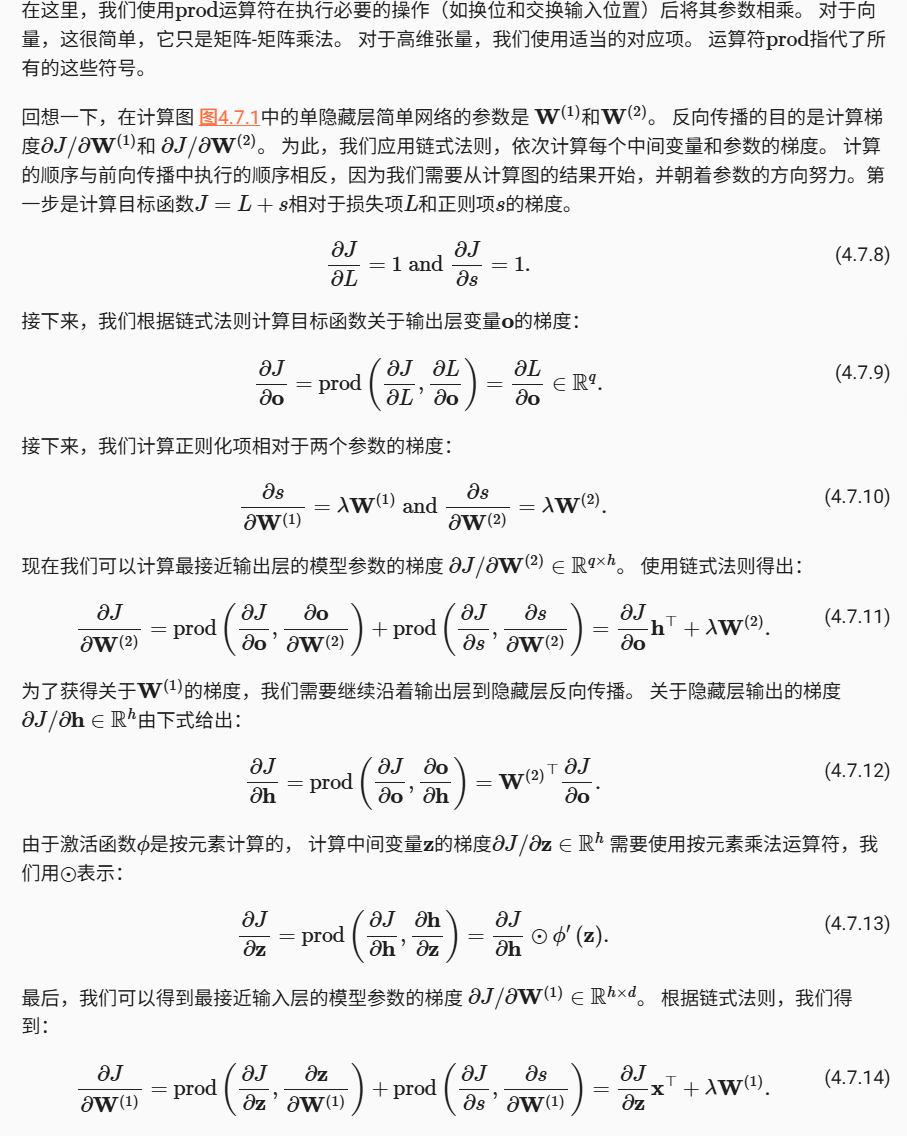
554
569

这个在讨论[[#多层FNN时链式法则,反向传播更新梯度的过程]]的时候,已经推导过了。很简单。

数值稳定性和模型初始化

前面,我们讲解了推理,训练的计算图的过程。我们计算梯度,时刻都要用到当前的模型参数,和模型数据。

所以,这就带来了两个问题,一个是稳定性,一个是模型参数的初始化。

初始化方案的选择在神经网络学习中起着举足轻重的作用, 它对保持数值稳定性至关重要
这些初始化方案的选择可以与非线性激活函数的选择有趣的结合在一起

 我们选择哪个激活函数以及如何初始化参数可以决定优化算法收敛的速度有多快

糟糕选择可能会导致我们在训练时遇到梯度爆炸或梯度消失

所以梯度消失,梯度爆炸,是指的训练有效无效这件事情。

我们现在假设一个L层,输入x, 输出o的深层网络。每一层的变换为fl, 那么可以直接写出o关于任意一层的参数的梯度。
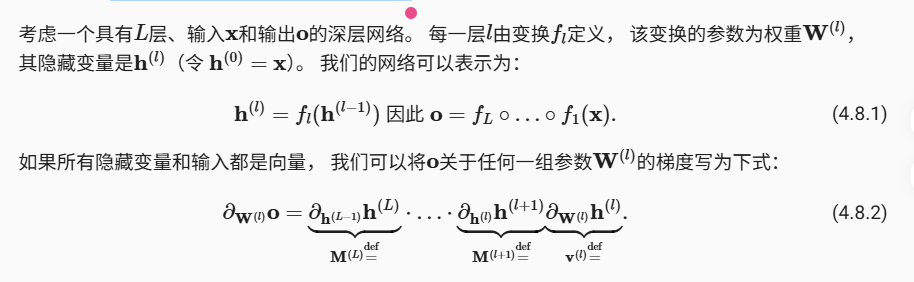
629

可以看到,和我们[[#多层FNN时链式法则,反向传播更新梯度的过程]]里面推到的一样,你看最后一项,就是第l层的局部梯度,前面是第l层向后的几层的中间梯度。

这个会带来一件事,训练(反向传播的时候),值是从后往前传导的。这会导致一个问题:

我们容易受到数值下溢问题的影响. 当将太多的概率乘在一起时,这些问题经常会出现

前面从M(L)…..M(l+1), 这几项,他们的乘积,可能非常大,也可能非常小

梯度的“乘法效应”
浅层网络的梯度计算依赖于深层网络

  • 数学对应:在公式 (4.8.2) 中,计算第 $l$ 层的梯度 $\partial_{\mathbf{W}^{(l)}}\mathbf{o}$ 时,需要乘以 $L-l$ 个矩阵 $\mathbf{M}^{(L)} \cdot \ldots \cdot \mathbf{M}^{(l+1)}$
  • 层数越多,项越多:网络越深($L$ 越大),这个连乘的项就越多,不稳定性也就被成倍放大

这就面临一些问题:

  • 梯度爆炸(gradient exploding)问题: 参数更新过大,破坏了模型的稳定收敛
    • 当矩阵的特征值很大时,乘积会变得非常大。这会导致参数更新过大,从而破坏模型的稳定收敛,模型可能直接“跑飞”了,无法找到最优解
  • 梯度消失(gradient vanishing)问题: 参数更新过小,在每次更新时几乎不会移动,导致模型无法学习
    • 这通常是因为矩阵特征值很小,导致连乘结果发生数值下溢。后果是参数更新过小,模型在每次更新时几乎不动,导致模型完全无法学习知识,就像学生听课完全听不进去一样

稳定性问题

梯度消失

我们针对sigmoid激活函数来看看,他容易导致梯度消失
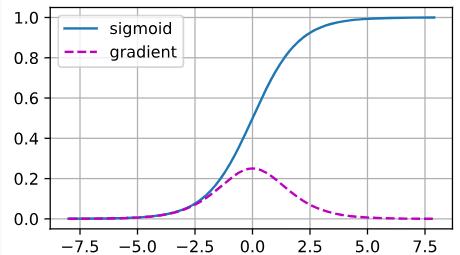
290

当输入很大/很小的时候,梯度就会消失了。所以当你反向传播的时候,如果输入很大的地方,你的梯度就是0。导致梯度消失。所以一般选择ReLU函数

梯度爆炸

简单举例就是,深层的梯度可能还算正常,但是经过100层,浅层的梯度就会变多非常大
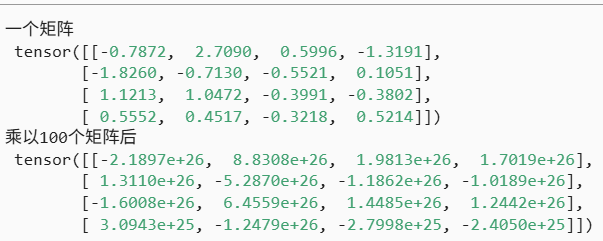
488

模型对称性问题

假如一个MLP,有一个隐藏层,两个隐藏单元,这个时候,每一层的隐藏单元之间没有什么区别。都是对称的

如果我们将隐藏层的参数全部初始化为一个常量,这个时候,这个隐藏层就好像只有一个单元。

解决办法:dropout(暂退法正则化)

参数初始化

前面我们默认使用自己写的init_weights()来初始化Linear层,使用的是正态分布来初始化权重参数。

如果不指定初始化方法, pytorch框架会使用默认的随机初始化方法

Xavier初始化

对于一个全连接层
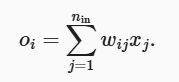
99

权重矩阵W的参数,都是从同一分布种独立抽取的。假设他具有0均值,σ2的方差(不一定是高斯)

此时假设输入x张量,也是0均值,γ2方差。且和W独立

那么输出o张量的均值和方差计算如下:
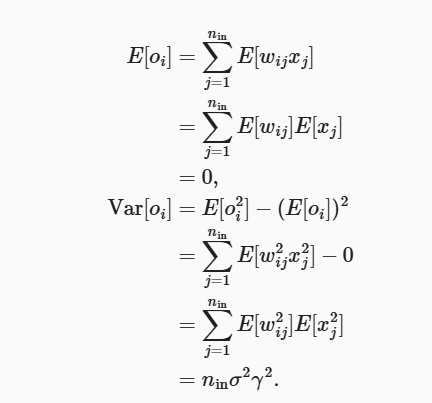
265

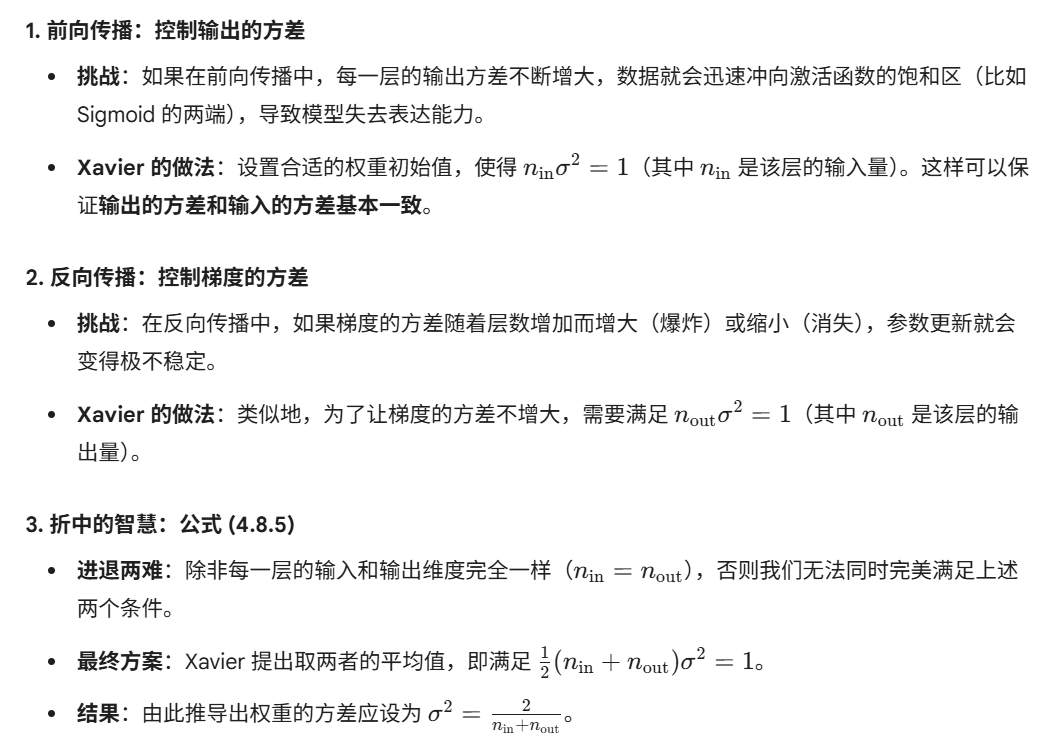
所以保持输出方差不变的方法是设置nσ2 = 1。(前向传播)
当反向传播算梯度的时候,也是要nσ2=1,否则梯度的方差也会增大。

我们只要
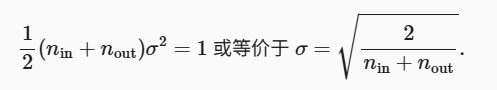
这个就是Xavier初始化的基础。
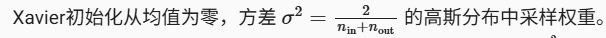
它可以让前向,反向传播的时候,方差不会增大?

没错,老师,您的总结一针见血!Xavier 初始化的核心目标就是让每一层输出的方差和每一层梯度的方差都保持稳定,从而解决您之前担心的梯度消失和梯度爆炸问题
分布偏移

这一节,主要讲的是,你的训练集,和你的测试集,分布不一样的情况

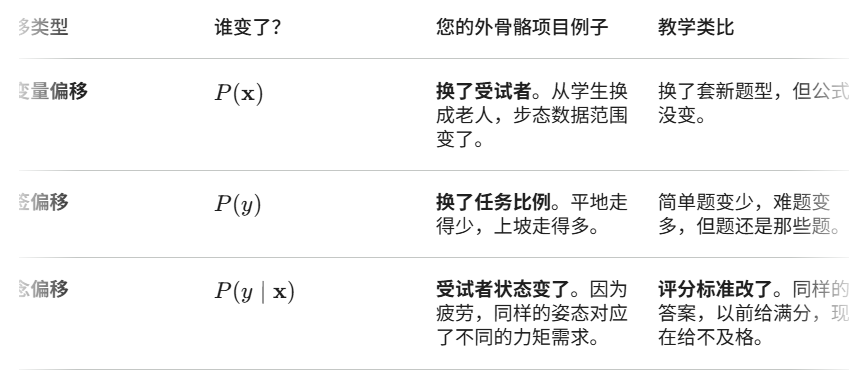
类别

协变量偏移
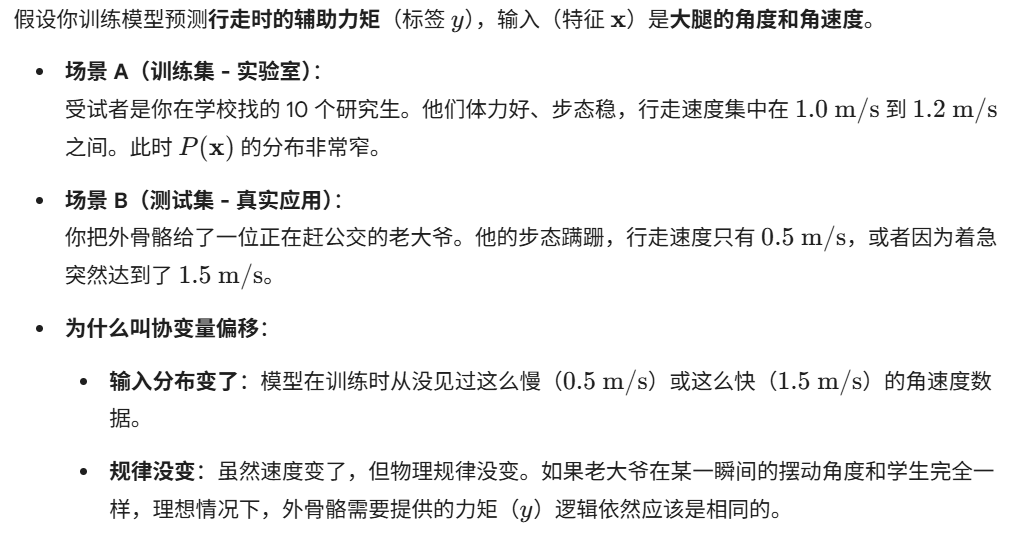
这是最主要的,训练集和测试集,分布不一样
训练集用的20岁的样本,测试集用的是60岁的样本

训练集由真实照片组成,而测试集只包含卡通图片。 假设在一个与测试集的特征有着本质不同的数据集上进行训练, 如果没有方法来适应新的领域
444

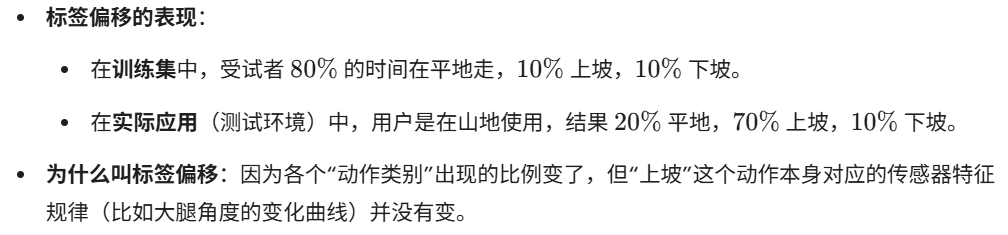
标签偏移
518

概念偏移
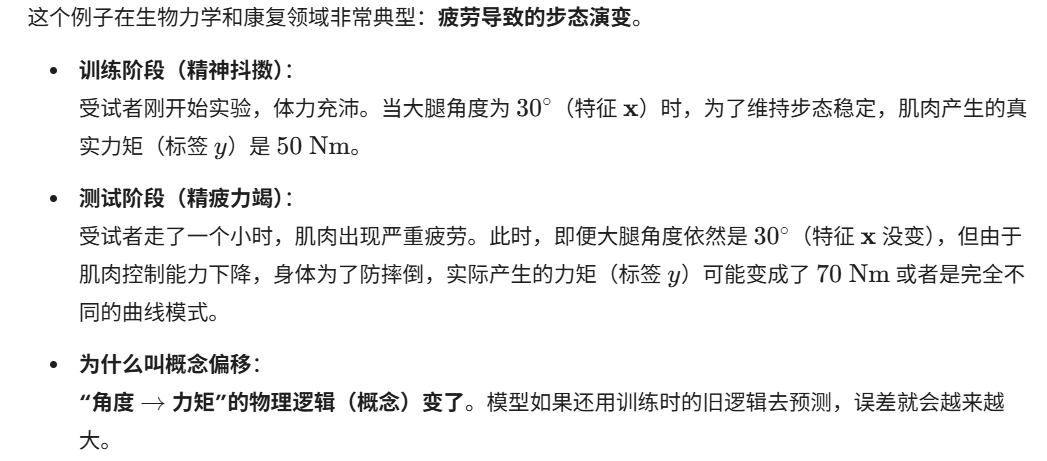
505

纠正偏差

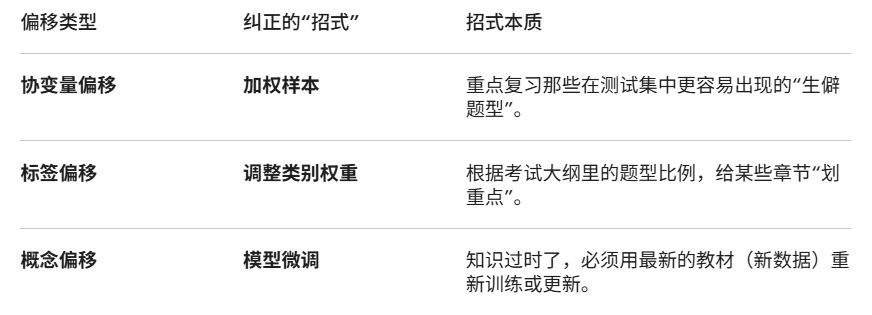
纠正偏移的核心思想其实只有一句话:既然训练集和测试集的题目分布不一样,那我们就给那些在测试集里更常出现的题目“加分”(提高权重),让模型多重视它们

1. 经验风险 vs 实际风险

  • 经验风险 (Empirical Risk):就是模型在训练集上的平均损失。我们平时的训练目标就是让它最小化。

  • 实际风险 (True Risk):是模型在真实世界(全量数据)分布下的损失。

  • 纠正的目标:因为训练集分布 $q(x)$ 和真实测试分布 $p(x)$ 不一样,我们要通过数学变换,把训练时的目标调整到接近真实风险。

2. 协变量偏移纠正:重新衡量样本权重

当你发现受试者从年轻人(训练集 $q(x)$)变成了老人(测试集 $p(x)$)时,纠正的方法是引入一个权重系数 $\beta_i$:

$$\beta_i = \frac{p(x_i)}{q(x_i)}$$

  • 直观理解:如果一个步态特征 $x$ 在老人的数据里出现的概率很高 ($p(x)$ 大),但在学生的数据里很少见 ($q(x)$ 小),那么 $\beta$ 就会很大。

  • 做法:在算损失函数时,不是简单的求平均,而是给每个样本乘上这个 $\beta$。

  • 通俗点说:这就是在告诉模型:“虽然你在学生数据里只见过几次这种蹒跚的步态,但它在实战中非常重要,你得加倍重视它!”

3. 标签偏移纠正:按类别比例“加餐”

这在分类任务中很常见。比如训练集里“平地”占 $90%$,但测试集里“上坡”占 $70%$。

  • 权重 $\beta_i$:变成了标签概率的比率 $\frac{p(y_i)}{q(y_i)}$。

  • 纠正逻辑:既然“上坡”成了测试集的主角,那就在训练时,人为地放大那些标签为“上坡”的样本的损失。

  • 优势:由于标签 $y$ 通常维度很低(比如只有 3 个动作类别),估算这个比率比估算复杂的传感器信号分布 $x$ 要容易得多。

4. 概念偏移纠正:没有捷径,只能“与时俱进”

这是最棘手的。因为 $P(y|x)$ 变了(同样的姿态,因为疲劳,所需的力矩变了)。

  • 公式没用了:这种情况下,之前的公式无法直接纠正,因为连“标准答案”都漂移了。

  • 解决办法:

    • 持续学习:不断用新产生的数据微调模型。

    • 衰减旧数据:让模型慢慢“忘掉”很久以前的状态,只学近期的规律。

578

torch 构建模型

块构建

这一节就是主要完成torch 如何构建模型的。
一个模型的构成:

  • 单元
  • 层
  • 块
  • 组件

为了实现这些复杂的网络,我们引入了神经网络块的概念。 块(block)可以描述单个层、由多个层组成的组件或整个模型本身

注意,python创建类对象的语法如下。

对象名 = 类名(参数1, 参数2, ...)

//当你执行这行代码时,Python 会在后台做两件事:

//1. 在内存中为这个对象开辟空间。
//2. 自动调用类里面的 `__init__` 方法(构造函数),把参数传进去,完成对象的初始化。

nn.Sequential()

nn.Sequential定义了一个特殊的Module, 表示为一个块的类。它重写了 __call__ 方法。所以你在代码最后写 net(X) 时,它会自动按照你定义的顺序,把数据 X 依次传给第一层、第二层……直到输出结果

import torch
from torch import nn
from torch.nn import functional as F

net = nn.Sequential(nn.Linear(20, 256), nn.ReLU(), nn.Linear(256, 10))

X = torch.rand(2, 20) # shape(2,20)
net(X)

上面的 nn.Linear(20, 256), 返回的是Linear类的实例,Linear类本身就是Module的子类

通过net(X)调用我们的模型来获得模型的输出。 这实际上是net.__call__(X)的简写

Sequential类的自己实现:

class MySequential(nn.Module):
def __init__(self, *args):
super().__init__()
for idx, module in enumerate(args):
# 这里,module是Module子类的一个实例。我们把它保存在'Module'类的成员
# 变量_modules中。_module的类型是OrderedDict
self._modules[str(idx)] = module

def forward(self, X):
# OrderedDict保证了按照成员添加的顺序遍历它们
for block in self._modules.values():
X = block(X)
return X

自定义块
前面使用自动定义的顺序块。我们也可以自己手动实现块

class MLP(nn.Module):
# 用模型参数声明层。这里,我们声明两个全连接的层
def __init__(self):
# 调用MLP的父类Module的构造函数来执行必要的初始化。
# 这样,在类实例化时也可以指定其他函数参数,例如模型参数params(稍后将介绍)
super().__init__()
self.hidden = nn.Linear(20, 256) # 隐藏层
self.out = nn.Linear(256, 10) # 输出层

# 定义模型的前向传播,即如何根据输入X返回所需的模型输出
def forward(self, X):
# 注意,这里我们使用ReLU的函数版本,其在nn.functional模块中定义。
return self.out(F.relu(self.hidden(X)))


net = MLP() # 如果我不初始化,系统会自动初始化
net(X)

自定义块的时候,可以在forward()中,自定义前向传播的程序控制流 。

这个仅展示可以随意指定计算流

class FixedHiddenMLP(nn.Module):
def __init__(self):
super().__init__()
# 不计算梯度的随机权重参数。因此其在训练期间保持不变
self.rand_weight = torch.rand((20, 20), requires_grad=False)
self.linear = nn.Linear(20, 20)

def forward(self, X):
X = self.linear(X)
# 使用创建的常量参数以及relu和mm函数(torch.mm是矩阵乘法)
X = F.relu(torch.mm(X, self.rand_weight) + 1)
# 复用全连接层。这相当于两个全连接层共享参数
X = self.linear(X)
# 控制流
while X.abs().sum() > 1:
X /= 2
return X.sum()

net = FixedHiddenMLP()
net(X)

随意组合嵌套层,块

class NestMLP(nn.Module):
def __init__(self):
super().__init__()
self.net = nn.Sequential(nn.Linear(20, 64), nn.ReLU(),
nn.Linear(64, 32), nn.ReLU())
self.linear = nn.Linear(32, 16)

def forward(self, X):
return self.linear(self.net(X))

chimera = nn.Sequential(NestMLP(), nn.Linear(16, 20), FixedHiddenMLP())
chimera(X)

参数管理

我们先定义一个MLP

import torch
from torch import nn

net = nn.Sequential(nn.Linear(4, 8), nn.ReLU(), nn.Linear(8, 1))
X = torch.rand(size=(2, 4))
net(X)

参数访问

"""
块里面的层,也重载了[]方法,可以索引每一个组件。所以net[2]表示第三个组件:8x1的那个Linear

Linear类有成员方法state_dict(), 用来返回这个层的参数
"""
print(net[2].state_dict())

"""
可以看到,就是全部打印出来了,包括这一层的权重矩阵W,以及偏置向量
OrderedDict([('weight', tensor([[-0.0427, -0.2939, -0.1894, 0.0220, -0.1709, -0.1522, -0.0334, -0.2263]])), ('bias', tensor([0.0887]))])
"""

你也可以指定Linear类的成员变量来访问具体的某一个参数

print(type(net[2].bias))
print(net[2].bias)
print(net[2].bias.data)

"""
<class 'torch.nn.parameter.Parameter'>
Parameter containing:
tensor([0.0887], requires_grad=True)
tensor([0.0887])
"""

每个参数对象,当然也有其梯度成员变量

net[2].weight.grad == None

"""
True
"""

嵌套网络也能直接print(net)来打出所有的块,层的参数

参数初始化

默认情况下,pytorch会根据一个范围均匀的初始化W,b, 这个范围是根据输入输出的维度计算的。

nn.init库提供多种初始化方法

nn.init库内置初始化

  • nn.init.normal_(参数张量对象,mean, std) 正态分布
  • nn.init.zeros_(参数张量对象) 0初始化
  • nn.init.constant_(参数张量对象,常数) 常数初始化
  • nn.init.uniform_(参数张量对象, -10, 10) 均匀分布
  • nn.init.xavier_uniform_(参数张量对象)
    • 调用xavier初始化方法,他会自动根据输入输出维度来自动化初始化,保证方差,减少梯度爆炸

然后自定义自己的初始化工作流,用nn.apply(), 来调用你的初始化函数

def init_normal(m):
if type(m) == nn.Linear:
nn.init.normal_(m.weight, mean=0, std=0.01)
nn.init.zeros_(m.bias)
net.apply(init_normal)
net[0].weight.data[0], net[0].bias.data[0]

def init_xavier(m):
if type(m) == nn.Linear:
nn.init.xavier_uniform_(m.weight)
def init_42(m):
if type(m) == nn.Linear:
nn.init.constant_(m.weight, 42)

net[0].apply(init_xavier)
net[2].apply(init_42)
print(net[0].weight.data[0])
print(net[2].weight.data)

参数绑定
多个层间共享参数:我们可以定义一个稠密层,然后使用它的参数来设置另一个层的参数(说白了,就是底层是一个内存,共享内存)

# 我们需要给共享层一个名称,以便可以引用它的参数
shared = nn.Linear(8, 8)
net = nn.Sequential(nn.Linear(4, 8), nn.ReLU(),
shared, nn.ReLU(),
shared, nn.ReLU(),
nn.Linear(8, 1))
net(X)
# 检查参数是否相同
print(net[2].weight.data[0] == net[4].weight.data[0])
net[2].weight.data[0, 0] = 100
# 确保它们实际上是同一个对象,而不只是有相同的值
print(net[2].weight.data[0] == net[4].weight.data[0])

"""
tensor([True, True, True, True, True, True, True, True])
"""

延后初始化

我们之前都是显示定义nn.Linear(20, 256)

pytorch现在也支持延后初始化,也就是懒惰模块
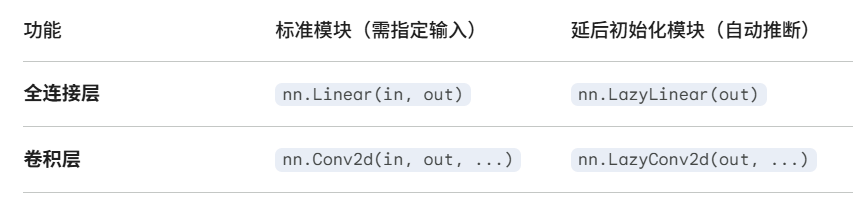
586

import torch
from torch import nn

# 使用 LazyLinear,你不需要写输入维度
net = nn.Sequential(
nn.LazyLinear(256),
nn.ReLU(),
nn.LazyLinear(10)
)

# 此时打印参数,权重还是空的,因为 PyTorch 还没“见过”数据
print(net[0].weight) # 会提示这是一个 UninitializedParameter

# 第一次“喂”数据时,延后初始化发生
X = torch.rand(2, 20)
net(X)

# 现在 PyTorch 已经推断出输入是 20,并完成了初始化
print(net[0].weight.shape) # 输出: torch.Size([256, 20])

自定义层

这个没什么好说的,就是自己继承nn.Module基类,自己手搓组件

class MyLinear(nn.Module):
def __init__(self, in_units, units):
super().__init__()
self.weight = nn.Parameter(torch.randn(in_units, units))
self.bias = nn.Parameter(torch.randn(units,))
def forward(self, X):
linear = torch.matmul(X, self.weight.data) + self.bias.data
return F.relu(linear)

torch读写文件

训练过程中,肯定需要读写到磁盘里面

加载和保存张量, 模型参数

import torch
import torch.nn as nn
import torch.nn.functional as F

"""保存,加载张量"""
x = torch.load('x-file') # 从x-file文件中,加载张量
y = torch.zeros(4)
torch.save([x,y], 'x-files')
x2,y2 = torch.load('x-files')


class MLP(nn.Module):
def __init__(self):
super().__init__()
self.hidden = nn.Linear(20, 256)
self.output = nn.Linear(256, 10)

def forward(self, x):
return self.output(F.relu(self.hidden(x)))

# 模型会自动初始化
net = MLP()
X = torch.randn(size=(2, 20))
Y = net(X)

"""保存,加载模型参数"""
torch.save(net.state_dict(), 'mlp.params')

clone = MLP() # 此时模型参数为空
clone.load_state_dict(torch.load('mlp.params'))
clone.eval()
"""
用来把模型切换到**评估模式(Evaluation Mode)**
"""

调用 model.eval() 后,模型会自动关闭所有只在训练阶段生效、影响梯度 / 输出的层,比如:

  • Dropout 层:停止随机丢弃神经元,所有神经元都参与计算
  • BatchNorm 层:停止用当前 batch 的均值 / 方差做归一化,改用训练阶段保存好的全局均值 / 方差
  • 其他训练专属的层(如 LayerNorm 相关的训练逻辑)也会进入评估状态

CNN 卷积

前面的FNN,输入是一个轴,现在变成两个轴,最典型的就是图像数据了,不过当时我们只是把图像用nn.Flatten()层展平成一个轴。忽略了每个图像的空间结构信息。

这里开始介绍卷积神经网络CNN,这是专门为处理图像数据而设计的神经网络。

CV中的要求

  • 平移不变性(translation invariance):不管检测对象出现在图像中的哪个位置,神经网络的前面几层应该对相同的图像区域具有相似的反应,即为“平移不变性”
    • 具体说就是,输入X的偏移,仅导致该层输出的偏移,而该层的模型参数不变。
  • 局部性(locality):神经网络的前面几层应该只探索输入图像中的局部区域,而不过度在意图像中相隔较远区域的关系,这就是“局部性”原则。最终,可以聚合这些局部特征,以在整个图像级别进行预测

卷积层

卷积的推导
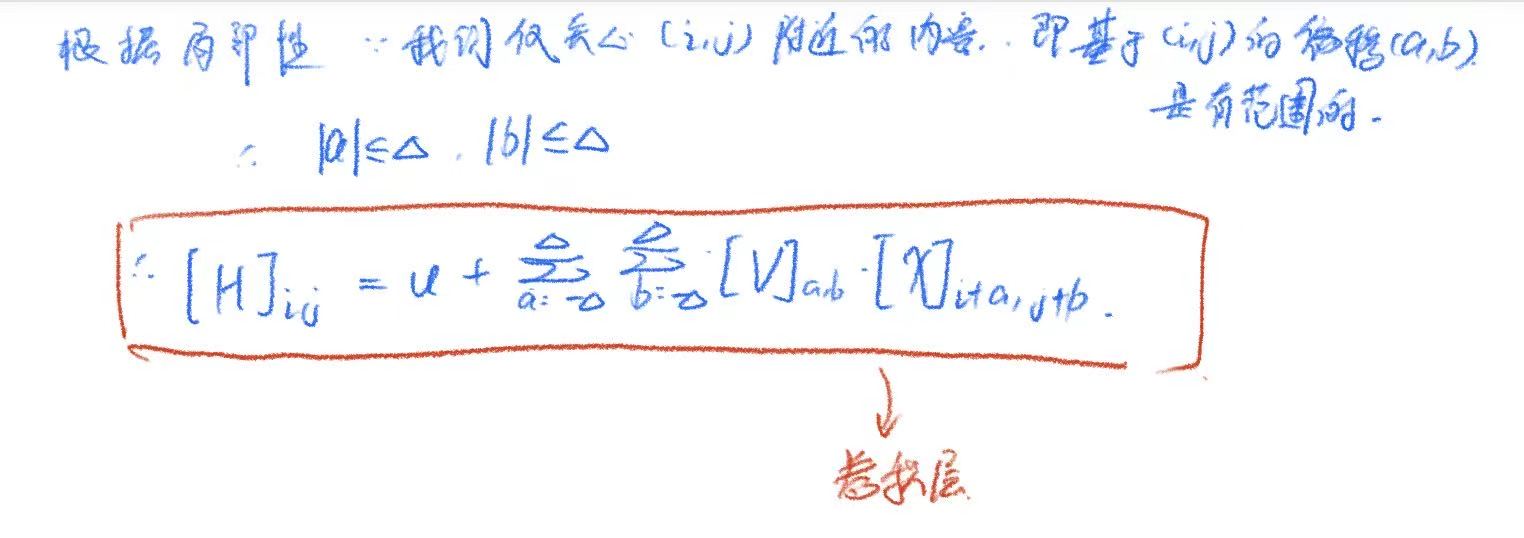
可以看到,就是从MLP的一维拓展到二维,然后根据平移不变性得到的卷积公式
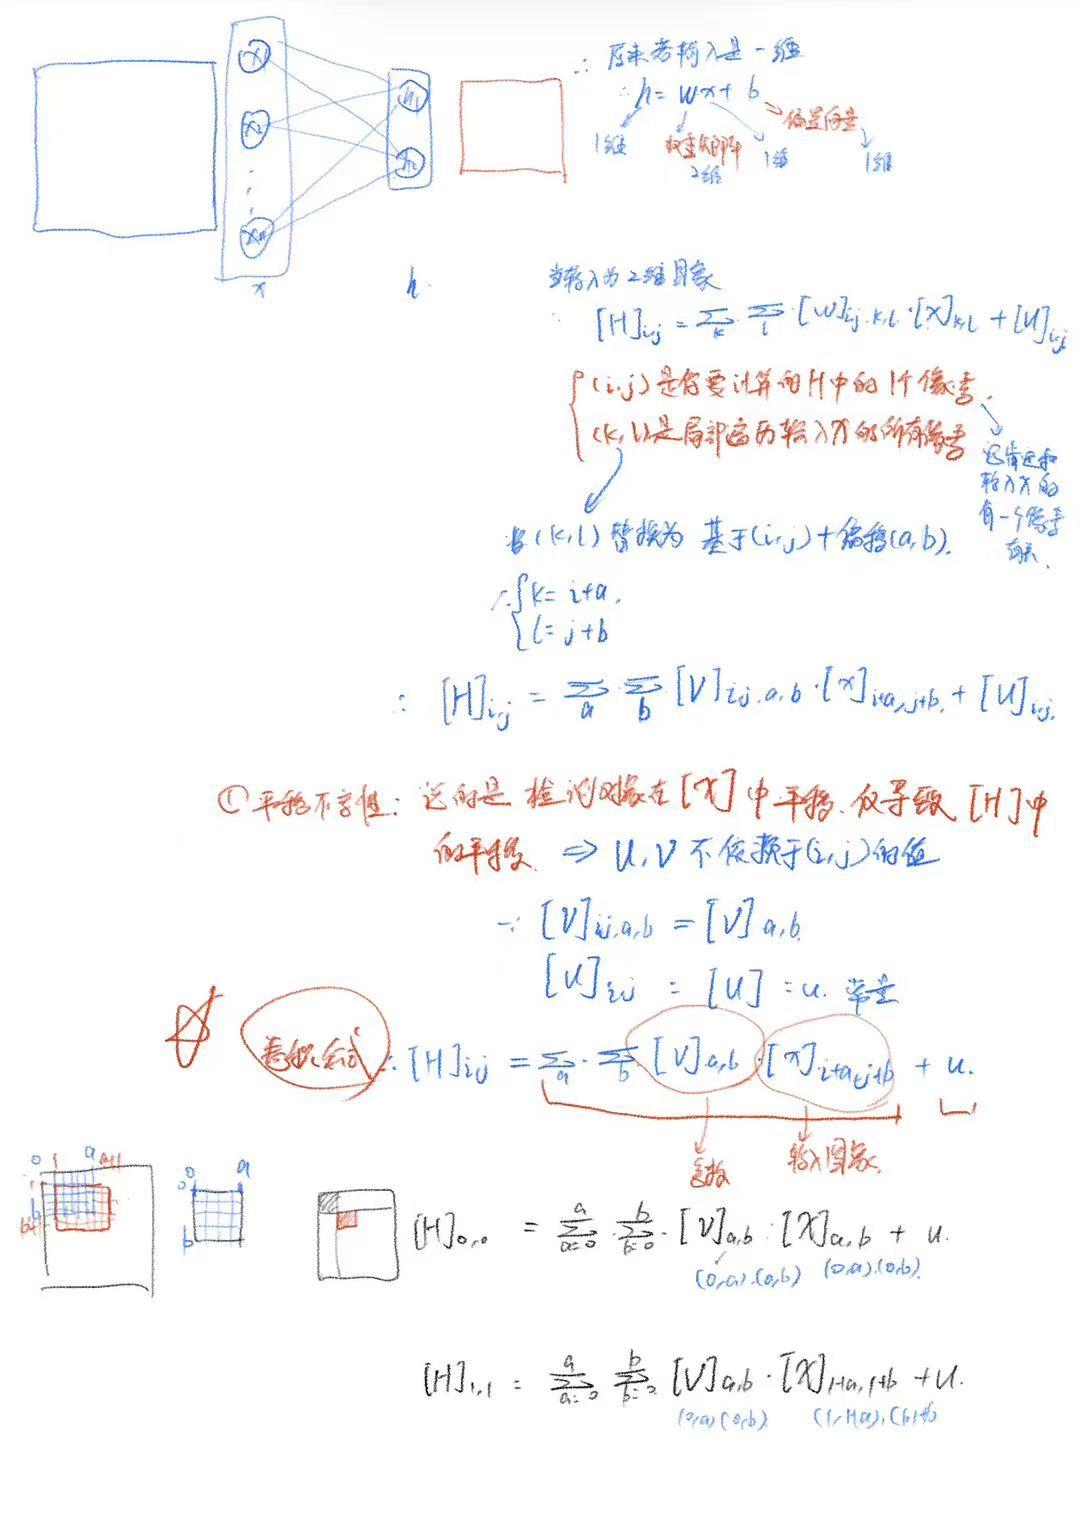
520
之后再根据局部性改写一下卷积层的函数
604

里面的V矩阵就被称为卷积核/滤波器/该卷积层的权重矩阵(通常,该权重就是可学习的参数)
Δ就表示滤波器的尺寸

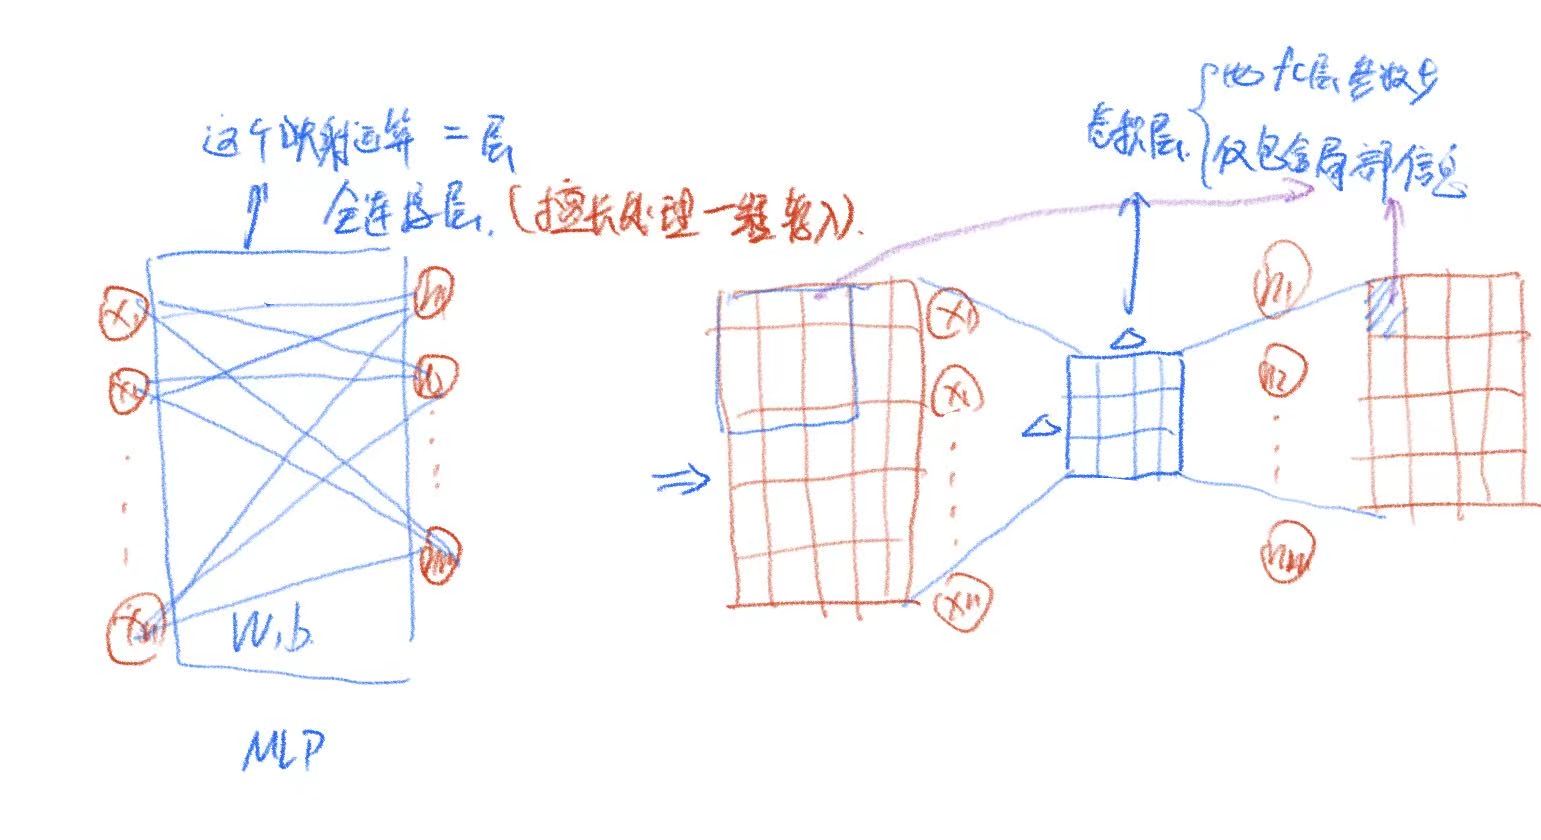
当我们处理的局部区域Δ很小的时候,

  • 卷积神经网络比MLP需要更少的网络参数,
  • 但是代价是我们的特征是平移不变
  • 而且并且当确定每个隐藏活性值时,每一层只包含局部的信息
    470

所以,卷积层,全连接层,都只是,不同功能的一个层而已,本质上都是输入到输出(预激活值/隐藏活性值)的一个映射关系。

全连接层:权重矩阵W,偏置向量b, 是需要学习的参数
卷积层:卷积核矩阵(Δ,Δ),是需要学习的参数

通过训练,来让我们的模型拟合训练数据(说白了,就是为了训练有效的卷积核)

下面再看一下数学上,卷积的公式定义
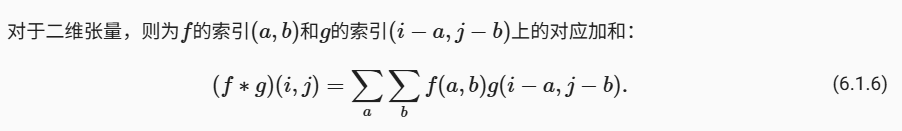
下面再解释一下通道
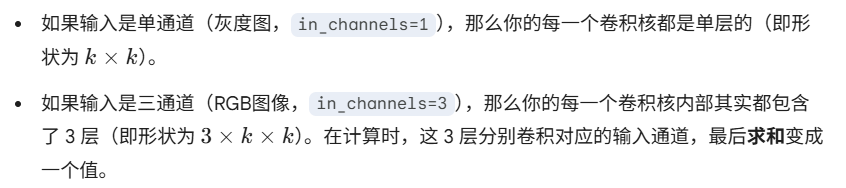
一般图像,可能一个像素,不是一个标量,而是一个3维的张量,因为有R,G,B三个通道。

所以一张图片样本的形状是(通道x 高度 x 宽度)

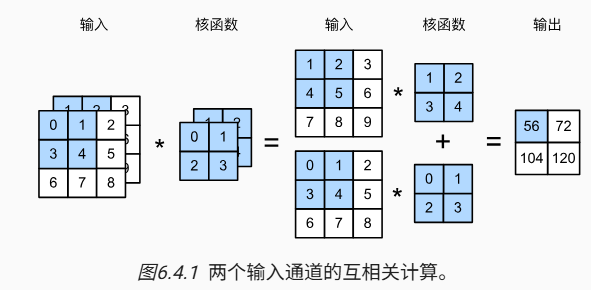
因此我们将X输入图片,变成3维,然后卷积核也增加成3维
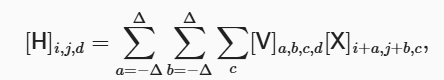
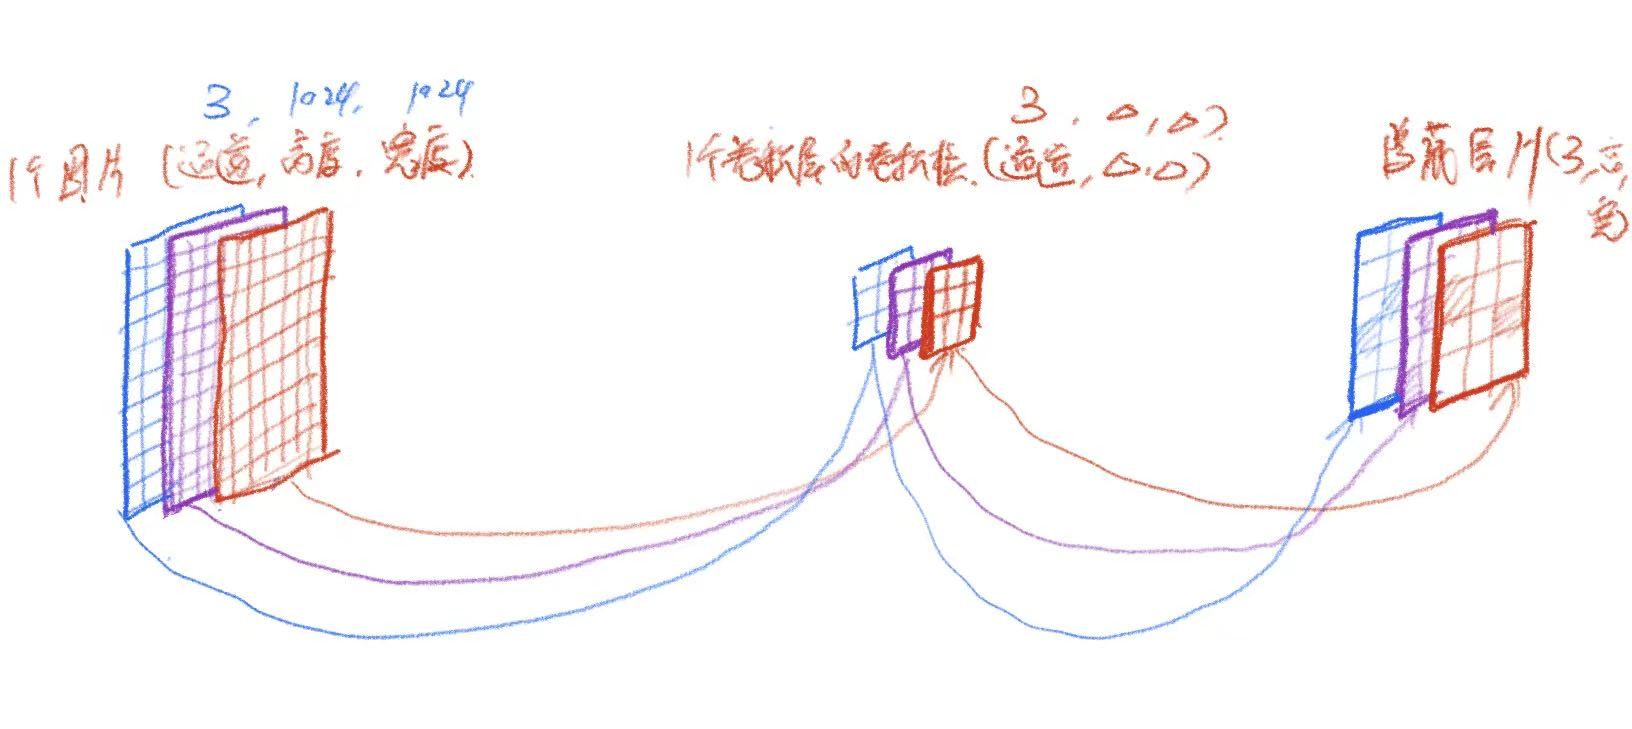
374
<font color="#ff0000">这里其实还差最后一步,一个卷积核的各个通道的输出结果,要加起来,变成单通道的输出</font>|488

下面看一下卷积层,具体是如何计算的,这里我们的卷积运算,所表达的其实是,互相关运算
在卷积层中,输入张量和核张量通过互相关运算产生输出张量
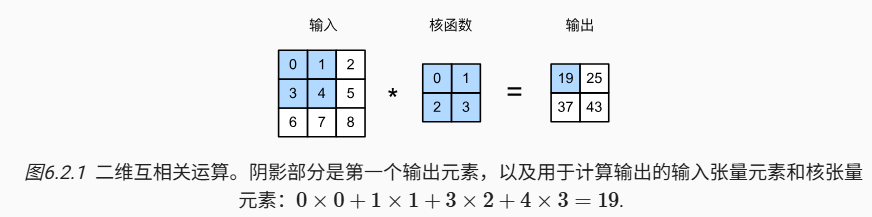
所以,知道了互相关运算的公式,你就可以自己实现卷积核运算了

知道了卷积核的一次互相关运算,我们来看一下卷积层,是如何完成这一层的计算的。

卷积层对输入和卷积核权重进行互相关运算,并在添加标量偏置之后产生输出

所以卷积层中的两个被训练的参数:

  • 卷积核权重矩阵
  • 标量偏置
    所以我们在模型一开始,肯定也要初始化卷积层的这些参数

下面我们自定义一个自己的2维卷积层

class Conv2D(nn.Module):
# kernel_size是一个张量(3,4),注意,卷积核不一定是正方形的
def __init__(self, kernel_size):
super().__init__()
self.weight = nn.Parameter(torch.rand(kernel_size))
"""
nn.Parameter(),是为了把变量注册成模型参数,这样你可以通过model.parameters()来获取。同时,优化器可以定位到这些权重。
同时自动把requires_grad 设置为 True。
"""
self.bias = nn.Parameter(torch.zeros(1))


def forward(self, x):
return corr2d(x, self.weight)+self.bias

高h, 宽w的卷积核,被称为 hxw卷积核。该卷积层,被称为hxw卷积层

卷积核举例

比如对于一个0,1的图像
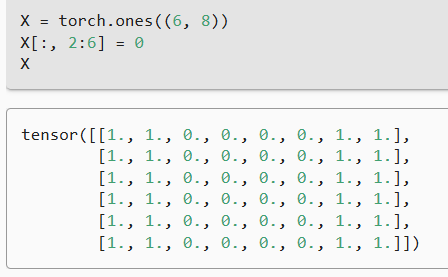
331

我们想检测他的边界线,也就是0,1的边界

我们就构造一个(1,2)的卷积核K = torch.tensor([[1.0, -1.0]])

对该图像卷积之后,
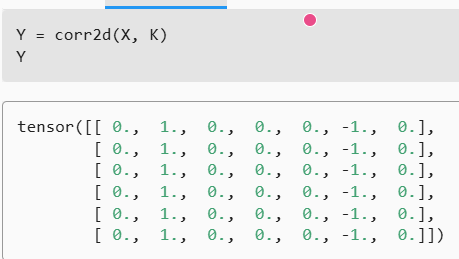
337

但这个时候,如果现在我们将输入的二维图像转置,再进行如上的互相关运算。 其输出如下,之前检测到的垂直边缘消失了。 不出所料,这个卷积核K只可以检测垂直边缘,无法检测水平边缘。卷积核失效了

所以一个特定的卷积核,只能提取一种特征。

所以我们的目的,就是要找到适合这个特征的卷积核,也就是要去学习卷积核,对应于MLP的拟合参数。

  • MLP叫拟合参数(优化参数)
  • 卷积叫学习卷积核

学习卷积核(优化参数)

当有了更复杂数值的卷积核,或者连续的卷积层时,我们不可能手动设计滤波器。那么我们是否可以学习由X生成Y的卷积核呢

仅查看“输入-输出”对来学习由X生成Y的卷积核

这里还是用的标签来实现的,然后计算该样本的平方差损失

# 构造一个二维卷积层,它具有1个输出通道和形状为(1,2)的卷积核
conv2d = nn.Conv2d(1,1, kernel_size=(1, 2), bias=False)

# 这个二维卷积层使用四维输入和输出格式(批量大小、通道、高度、宽度),
# 其中批量大小和通道数都为1
X = X.reshape((1, 1, 6, 8))
Y = Y.reshape((1, 1, 6, 7))
lr = 3e-2 # 学习率

for i in range(10):
Y_hat = conv2d(X)
l = (Y_hat - Y) ** 2
conv2d.zero_grad()
l.sum().backward()
# 迭代卷积核
conv2d.weight.data[:] -= lr * conv2d.weight.grad
if (i + 1) % 2 == 0:
print(f'epoch {i+1}, loss {l.sum():.3f}')

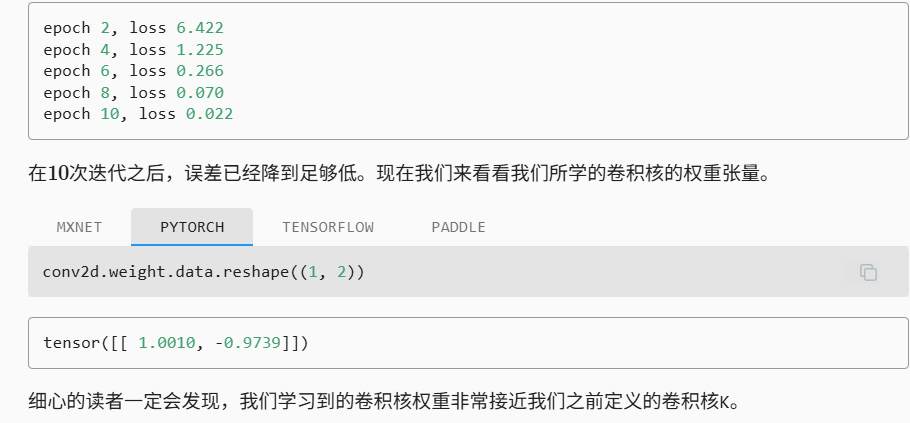
522
发现还是可以学会的,非常接近原来我们设计的[1,-1]的卷积核

为了与深度学习文献中的标准术语保持一致,我们将继续把“互相关运算”称为卷积运算,尽管严格地说,它们略有不同。 此外,对于卷积核张量上的权重,我们称其为_元素_

特征映射和感受野
卷积层,有时候,也被称为特征映射,因为被视为从一个输入,映射到下一层的空间维度的转换器。

感受野,是指的所有贡献该层的元素的前向传播的所有元素。

卷积细节

填充与步幅

前面我们 3x3 的输入,经过 2x2的卷积,最终得到了输出2x2, 发现尺寸变小了
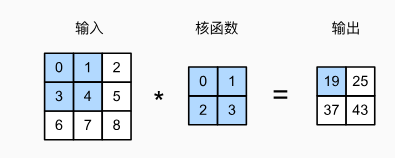
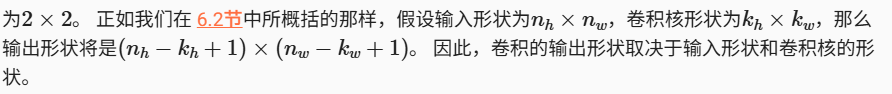
249

填充
可以发现,在应用多层卷积的时候,我们就逐渐丢失边缘像素了,多层之后,丢失的越来越多。

因此,保证每次卷积之后,输入输出尺寸不变的办法,就是填充
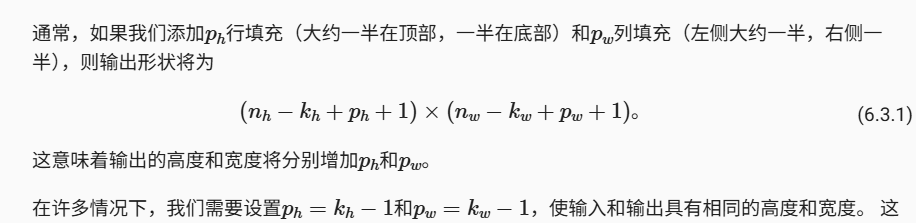
卷积神经网络中卷积核的高度和宽度通常为奇数,例如1、3、5或7
选择奇数的好处是,

  • 保持空间维度的同时,我们可以在顶部和底部填充相同数量的行,在左侧和右侧填充相同数量的列
  • 使用奇数的核大小和填充大小也提供了书写上的便利:
    • 对于任何二维张量X,当满足: 1. 卷积核的大小是奇数; 2. 所有边的填充行数和列数相同; 3. 输出与输入具有相同高度和宽度 则可以得出:输出Y[i, j]是通过以输入X[i, j]为中心,与卷积核进行互相关计算得到的。

下面我们来写一下这个填充,然后让卷积层保证输入输出同尺寸

import torch
from torch import nn

"""
nn.Conv2d(1,1)
第一个1, in_channels, 表示输入样本的通道,我们是单通道
第二个1, out_channels, 卷积后输出的通道数,表明会有多少个卷积核
kernel_size = 3, 为python的语法糖,效果等同于kernel_size=(3,3),你也可以传入(5,3)
padding=1,表示在输入的二维图像的,上下左右,各填充一行0(默认是0)
"""
conv2d = nn.Conv2d(1, 1, kernel_size=3, padding =1)
X= torch.rand(8,8)

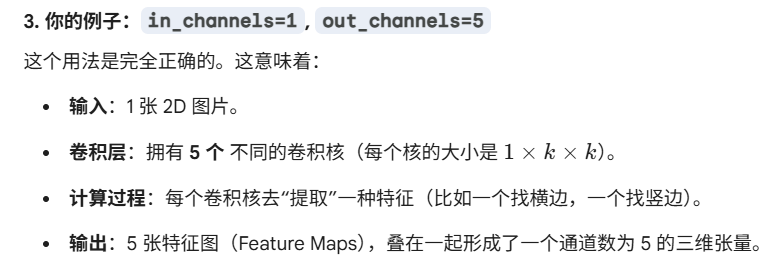
这样,我们指定了输入图像为8x8的尺寸,单通道 -> in_channels = 1
然后用nn.Conv2d来创建了一个卷积层对象

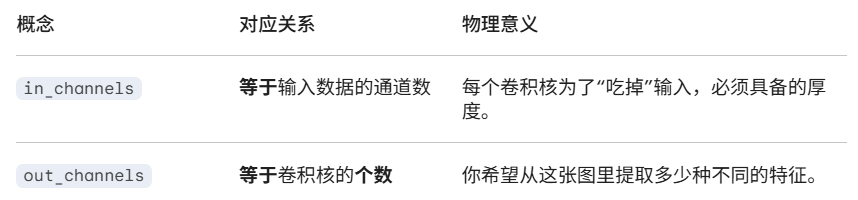
这里需要解释的是:

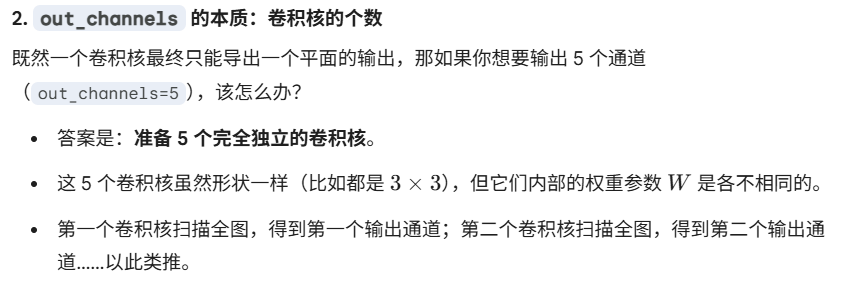
  • in_channels 决定了每个卷积核长什么样(单个卷积核本身有多少个通道)
    • 单个卷积核的通道数必须等于输入图片的通道数
  • 而 out_channels 决定了你有多少个卷积核。

434

583

所以,一个卷积层里面,会有多个卷积核,类比于一个隐藏层的隐藏单元,线性回归单元
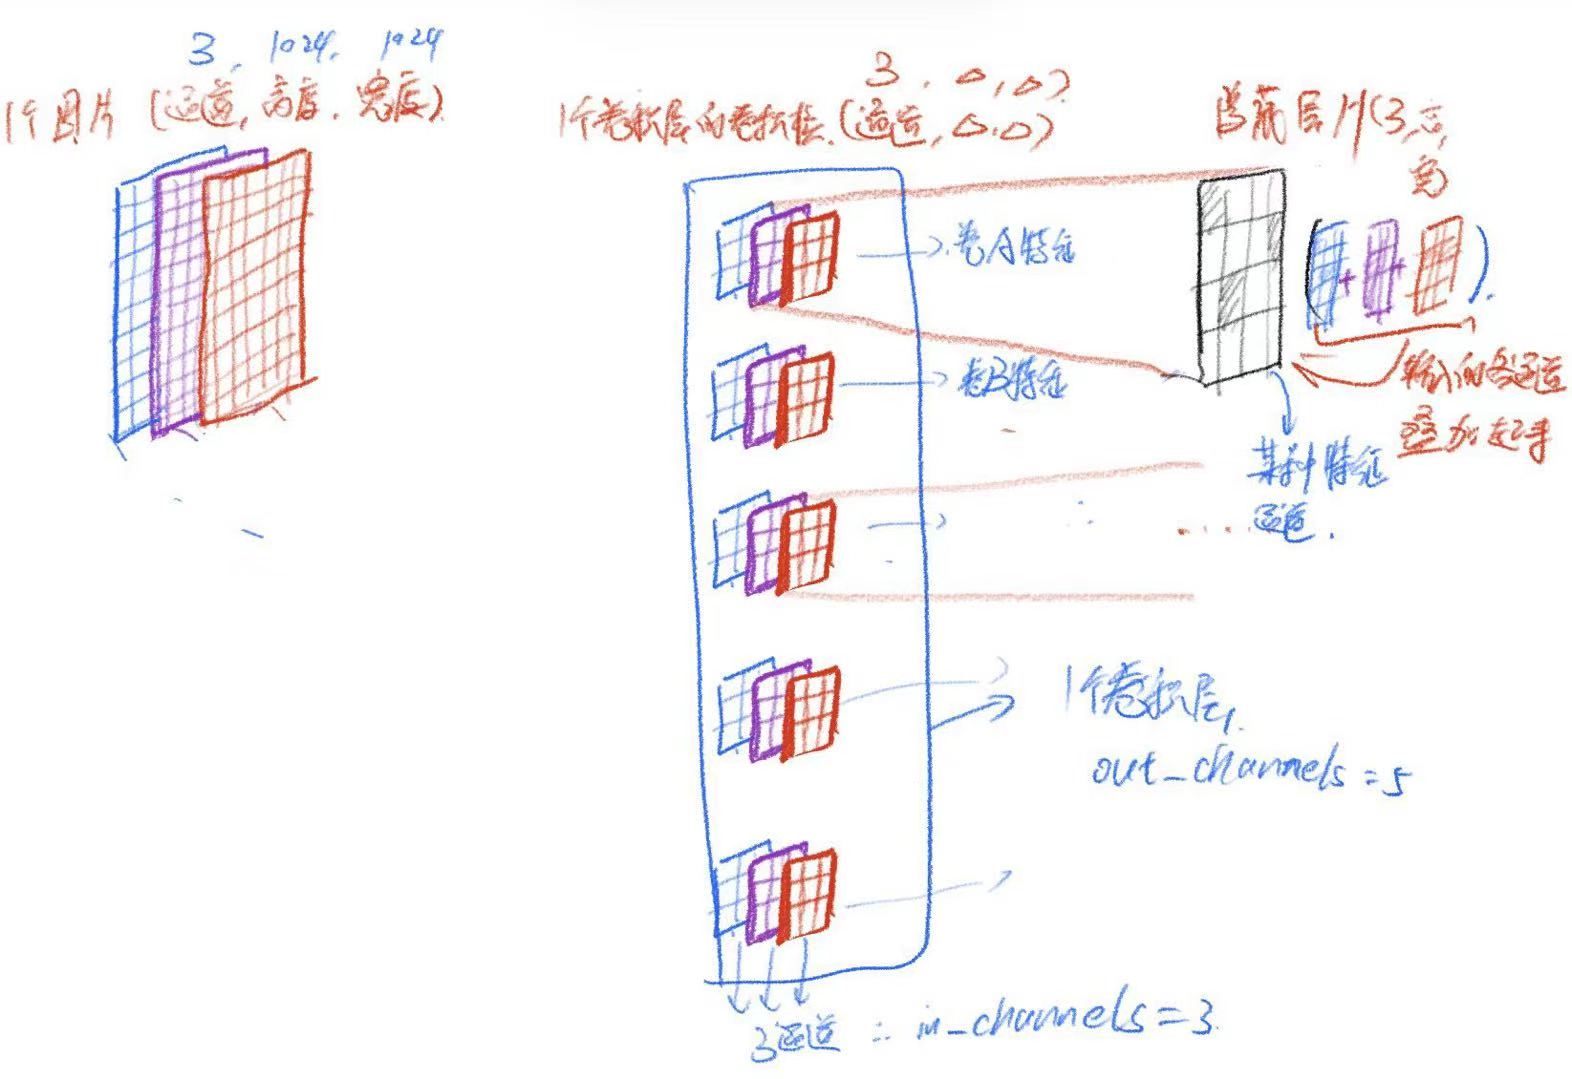

这里就展示了2通道的卷积核,最终输出1通道的输出|315

定义好了卷积层之后

import torch
from torch import nn

conv2d = nn.Conv2d(1, 1, kernel_size=3, padding=1)
"""
创建出的卷积核shape(1,1,3,3), 使用kaiming均匀分布初始化权重还有偏置标量
"""
X = torch.rand(size=(8, 8)).reshape((1,1)+X.shape) # (1,1)+(8,8)是元组拼接


"""
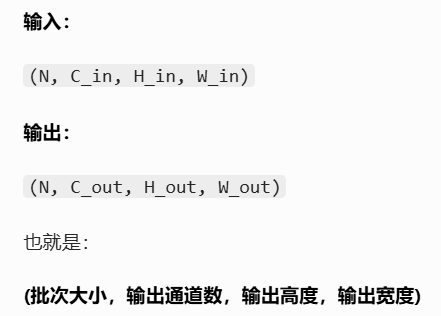
conv2d()卷积层,他的
输入张量的格式(batch_size, in_channels输入图片的通道数=卷积核通道, height, width)
输出张量的格式(batch_size, out_channels输出特征的通道数=卷积核数量, height, width)
"""
def comp_conv2d(conv2d, X):
"""
卷积层conv2d的输入输出格式(批量大小,通道,)
"""
Y = conv2d(X)
return Y.reshape(Y.shape[2:]) # 打印出shape数组的2,3位,就是(weight, width)
"""
最终返回torch.Size([8, 8])
"""

以上,我们就已经了解了一个卷积层的内部,最后总结一下
334

步幅

这个就是指的一个卷积核,如何在输入图片上移动的步长了,你可以指定每次滑动的步幅
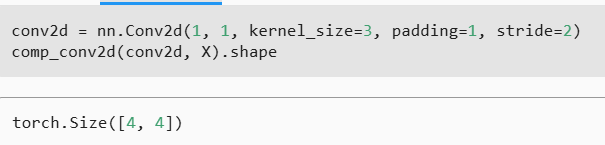
434
可以看到,当stride改成2的时候,输出尺寸从8x8, 变成了4x4了

同样复杂一点指定非正方形的卷积
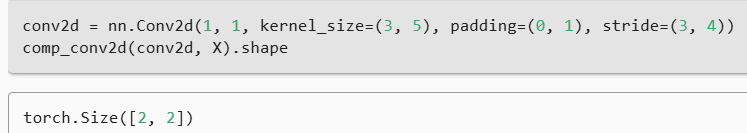
在实践中,我们很少使用不一致的步幅或填充

如何根据输入的尺寸,卷积核的尺寸,以及padding, stride来计算输出图片的尺寸,由公式
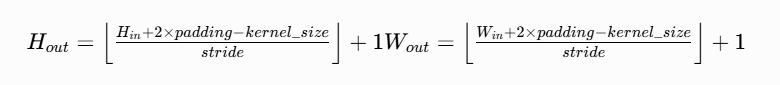
1x1卷积层

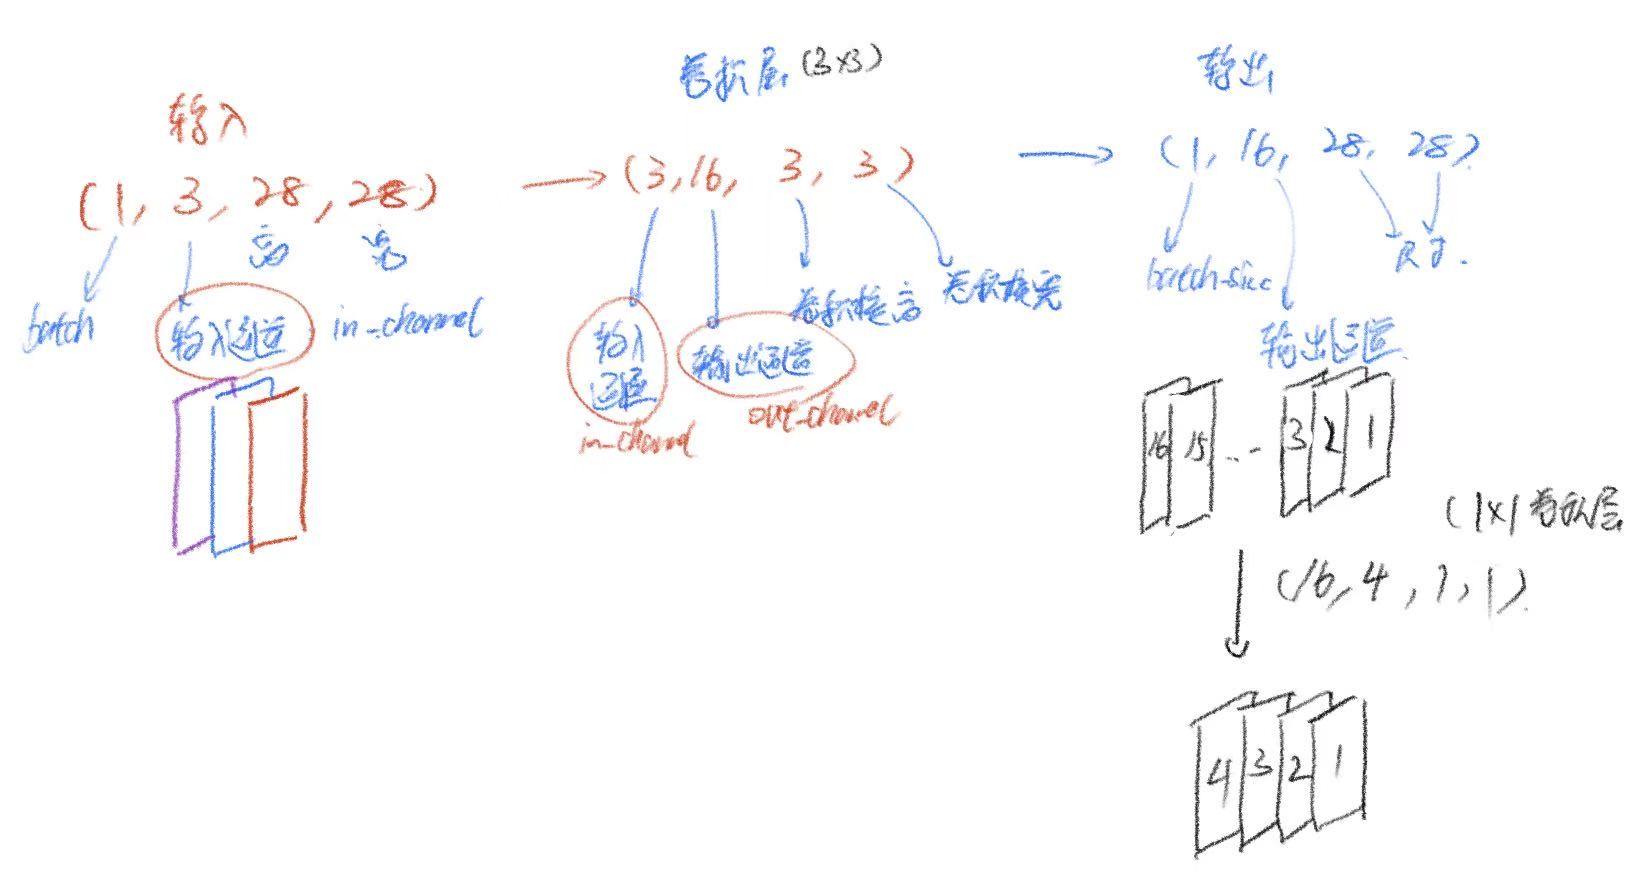
当我们的卷积核的高度=宽度=1时,每个卷积核通道内部的计算消失了,只剩下了通道上的计算。

$1 \times 1$ 卷积的唯一计算发生在通道上。

输出中的每个元素都是从输入图像中同一位置但在不同通道上的元素的线性组合。(相当于像素级别的全连接,只不过不同像素的权重都是一样的)

这使得网络能够有效地整合跨通道的特征信息。

他的最大的用处是:灵活调整通道数(升维或降维)

  • 通过设置不同的输出通道数($c_o$),$1 \times 1$ 卷积可以用来增加或减少通道的维度。
  • 这常用于在不改变图像高度和宽度(空间分辨率)的前提下,压缩模型参数或增加特征的丰富度
    570

汇聚层(池化层)

当我们处理图像的时候,中间的卷积层,会产生多通道的同尺寸图片,每个通道表示一个卷积核通道卷出来的特征。

如果我们希望降低这些中间图片特征所表示的空间分辨率,聚集信息。这样我们每个神经元对其敏感的感受野就越大了(相当于压缩了嘛)

因为我们的机器学习的任务,是和全局图像有关的,所以我们最后一层的神经元,应该对整个输入的全局是敏感的。所以要通过池化操作,来聚合信息,生成越来越粗糙的映射,最终学会全局表示的目标,同时将卷积图层的所有又是保留在中间层。

所以:
汇聚(pooling)层,它具有双重目的:

  • 降低卷积层对位置的敏感性(肯定不希望稍微偏移一个像素就识别不出来)
  • 同时降低对空间降采样表示的敏感性

所以我们的池化操作,主要是针对空间信息, 前面的1x1卷积,主要是针对通道特征信息

最大汇聚层/平均汇聚层
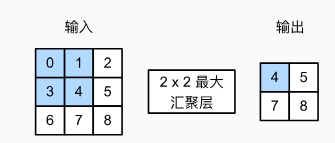

所以,本质上,池化窗口,也是一个区域,类似卷积核,只不过他不是互相关计算,而是计算该窗口的输入子张量的最大值/平均值, 分别对应了最大汇聚层,平均汇聚层

汇聚窗口形状位pxq的汇聚层,称为pxq汇聚层

这样,使用2x2的汇聚层,即使在高度,宽度上移动一个像素,卷积层仍可以识别到模式

填充和步幅

因为池化层也是一个窗口计算,所以肯定要移动,这就又带来了填充问题和步幅问题。从计算上来看,是一样的。

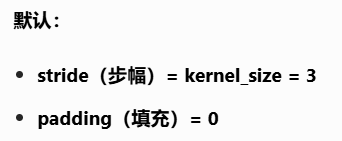
但是移动方式上,和卷积核不太一样,因为我们是池化操作,所以是降采样,因此一次移动的步幅,默认等于池化窗口的尺寸,你也可以自己指定步幅
266

X = torch.arange(16, dtype=torch.float32).reshape((1, 1, 4, 4))
"""
tensor([[[[ 0., 1., 2., 3.],
[ 4., 5., 6., 7.],
[ 8., 9., 10., 11.],
[12., 13., 14., 15.]]]])
"""

pool2d = nn.MaxPool2D(3)
"""
我们自己定义一个最大池化层,形状(3,3),因此步幅也为(3,3)
"""


poll2d(X)
"""
tensor([[[[10.]]]]), 因为一步也移动不了
"""

pool2d = nn.MaxPool2d(3, padding=1, stride=2)
pool2d(X)

"""
tensor([[[[ 5., 7.],
[13., 15.]]]])
"""

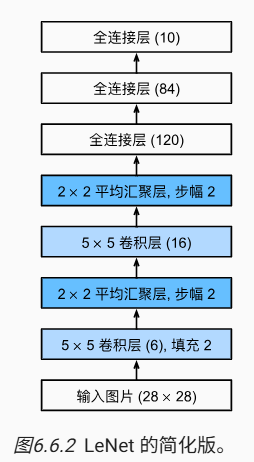
经典CNN(LeNet)

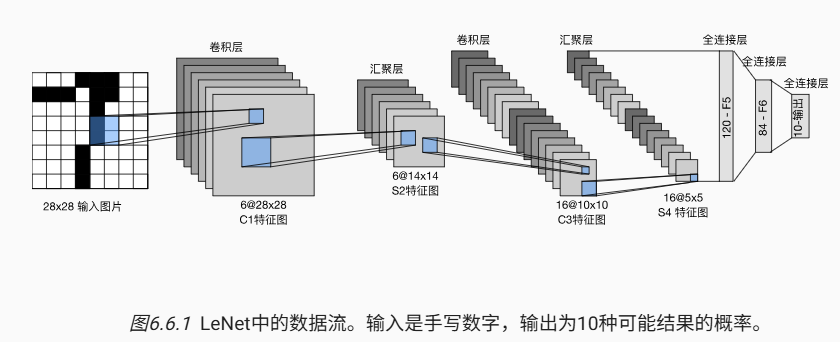
总体来看,LeNet(LeNet-5)由两个部分组成:

  • 卷积编码器:由两个卷积层组成;
  • 全连接层密集块:由三个全连接层组成。

每个卷积块中的基本单元是一个卷积层、一个sigmoid激活函数和平均汇聚层
(ReLU和最大汇聚层更有效,但是当时还没出现)

这边提一下CNN的卷积核的参数的训练(因为他这个参数量很少)
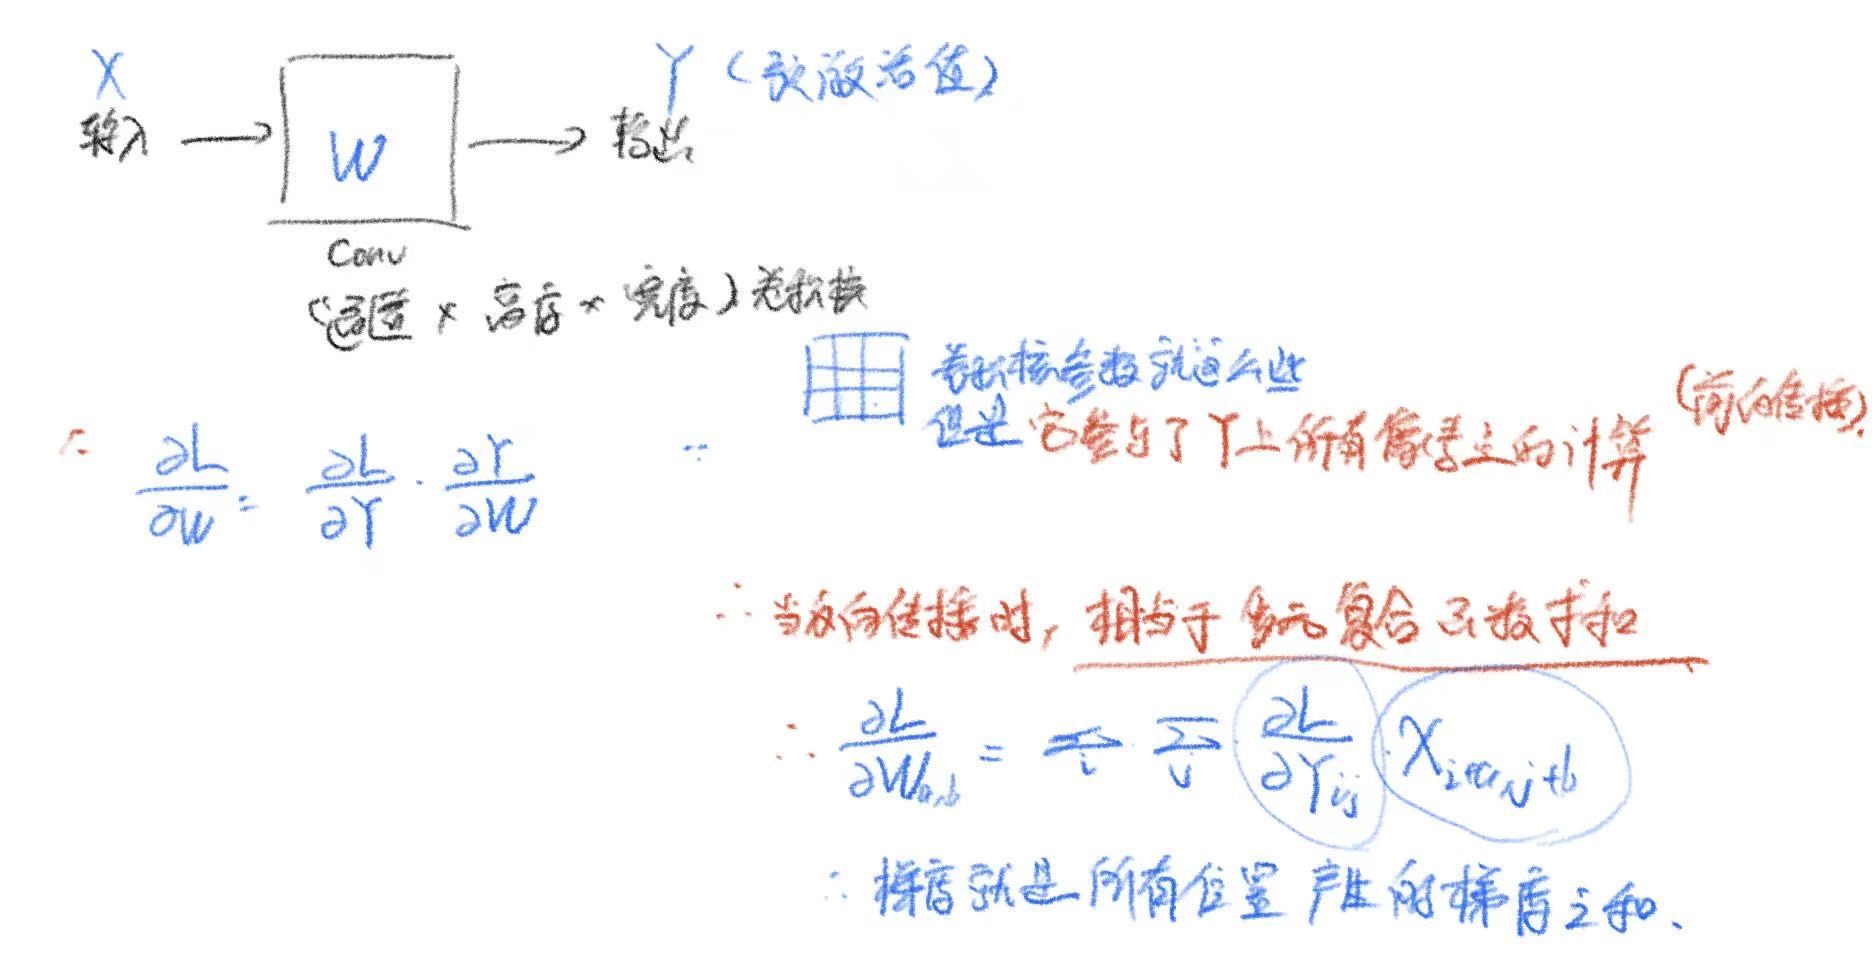
452

以 LeNet 处理 MNIST 手写数字为例:

  1. 前向传播:输入图像经过 $5 \times 5$ 卷积,得到特征图。
  2. 计算误差:在输出层计算预测值与真实标签(如数字 “7”)的损失 $L$。
  3. 误差回传:
    • 误差从全连接层传回池化层。
    • 从池化层传回卷积层(得到 $\frac{\partial L}{\partial Y}$)。
  4. 权重更新:
    • 利用上述的“累加梯度”公式算出卷积核的梯度 $\frac{\partial L}{\partial W}$。
    • 更新参数:$W_{new} = W_{old} - \eta \cdot \frac{\partial L}{\partial W}$($\eta$ 是学习率)。
import torch
from torch import nn
from d2l import torch as d2l

net = nn.Sequential(
nn.Conv2d(1, 6, kernel_size=5, padding=2), nn.Sigmoid(),
nn.AvgPool2d(kernel_size=2, stride=2),
nn.Conv2d(6, 16, kernel_size=5), nn.Sigmoid(),
nn.AvgPool2d(kernel_size=2, stride=2),
nn.Flatten(),
nn.Linear(16 * 5 * 5, 120), nn.Sigmoid(),
nn.Linear(120, 84), nn.Sigmoid(),
nn.Linear(84, 10))

156

with torch.no_grad():
这个的作用,是关闭保留中间变量的操作,因此可以:

  • 加快测试速度
  • 减小内存占用
  • 避免改变模型权重

自动梯度是前向 “留后路(建图存中间)” 给反向用;
推理不需要后路,no_grad 就是把这条后路直接封死,不占空间、不浪费性能。

现代卷积神经网络

在LeNet出来之后,开始了现代卷积神经网络

LeNet在小数据集上效果还行,但是更大,更真实的数据集上,效果就拉了。

在此之前,人们倾向于自己提取自己理解的特征,比如HOG,SIFT这些。
但是Alex这些人,他们认为:特征本身应该被学习

在合理地复杂性前提下,特征应该由多个共同学习的神经网络层组成,每个层都有可学习的参数

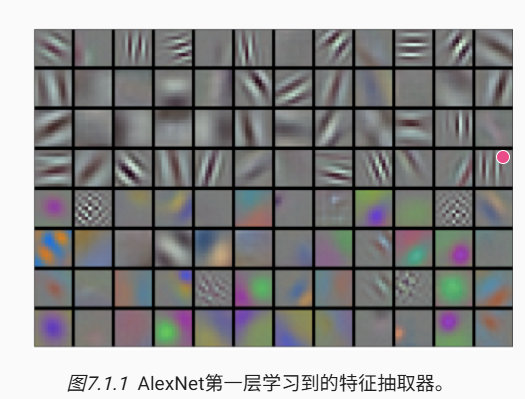
在机器视觉中,最底层可能检测边缘、颜色和纹理,由此诞生_AlexNet_

  • 在网络的最底层,模型学习到了一些类似于传统滤波器的特征抽取器
    • 300
  • AlexNet的更高层建立在这些底层表示的基础上,以表示更大的特征,如眼睛、鼻子、草叶等等
  • 更高的层可以检测整个物体,如人、飞机、狗或飞盘
  • 最终的隐藏神经元可以学习图像的综合表示

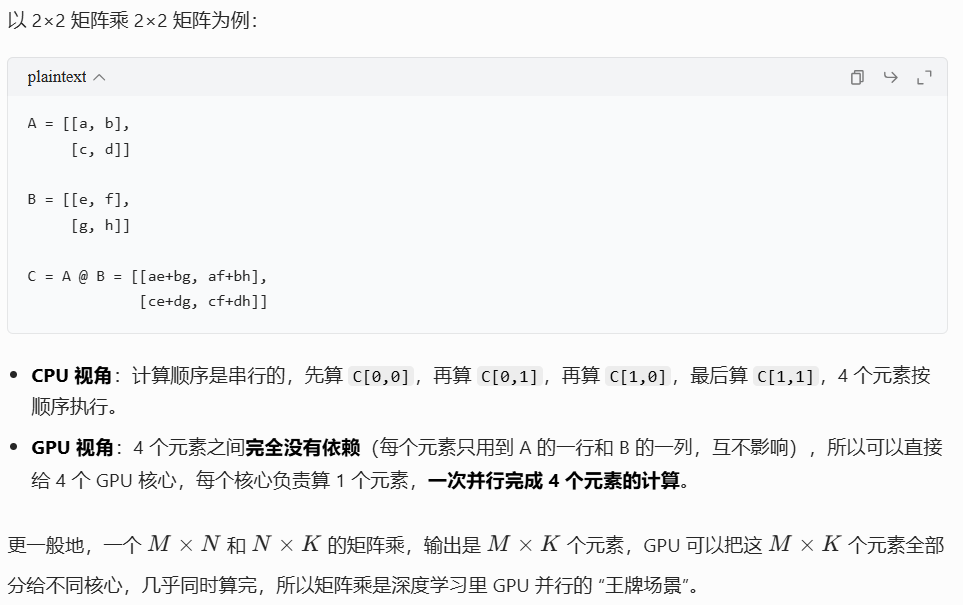
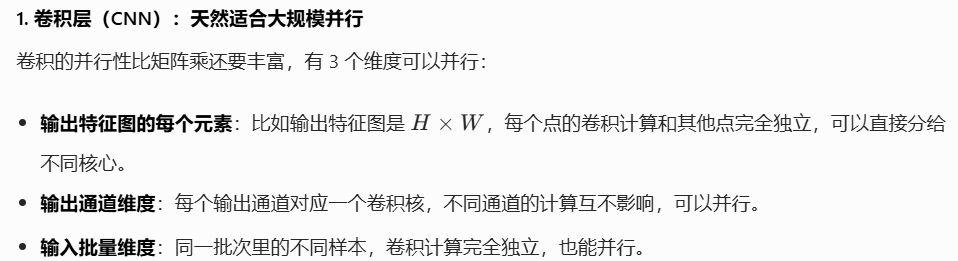
GPU并行计算优势

深度学习里面,还有哪些环节能在GPU上并行呢?

  • 卷积层运算:505
  • 激活函数:519
  • 池化层:这个和卷积类似
  • 全连接层:本质还是矩阵乘法
  • 损失函数计算:463
  • 反向传播:585

所有能并行的环节,都满足一个共同点:计算任务之间没有数据依赖

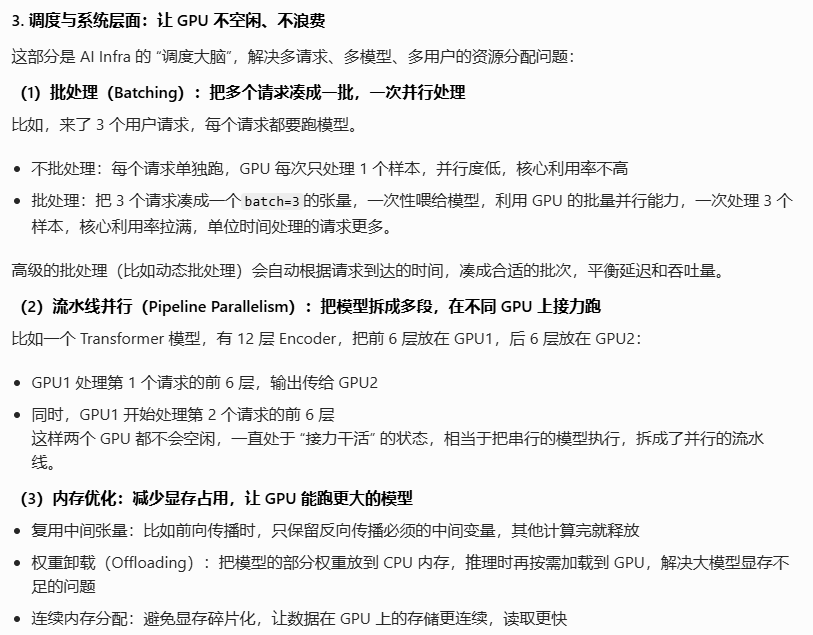
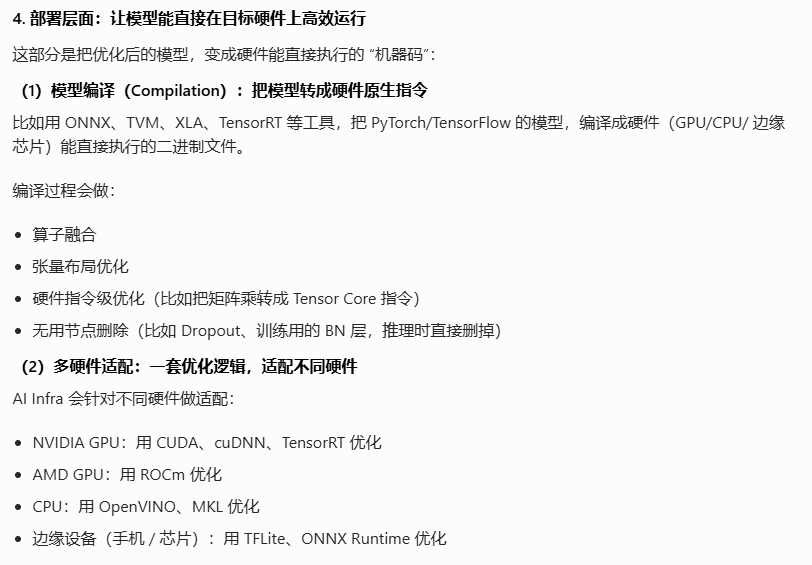
ai infra推理加速

AI Infra 在模型推理加速上,核心就是想尽办法让 GPU/CPU 少做无用功、多做有效并行、减少数据瓶颈,把模型跑的又快又省
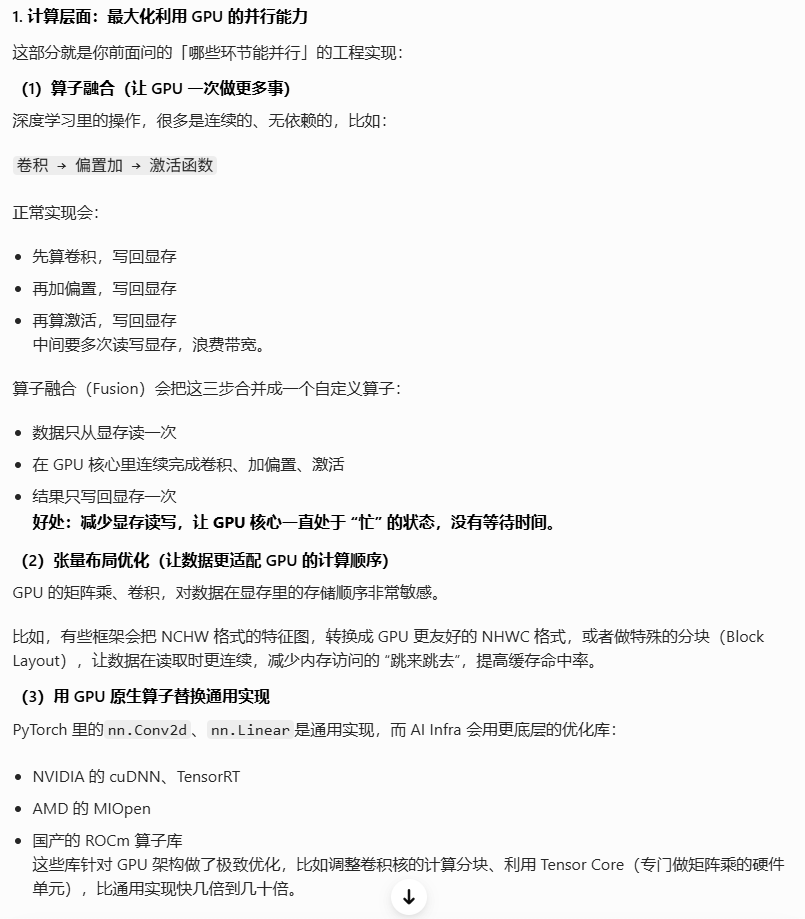
565

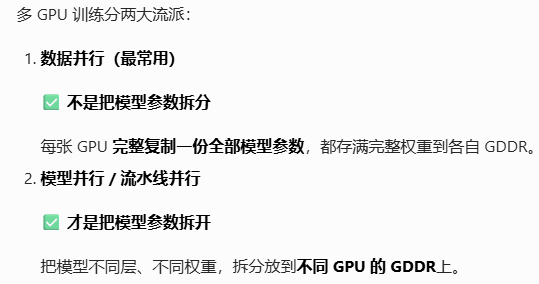
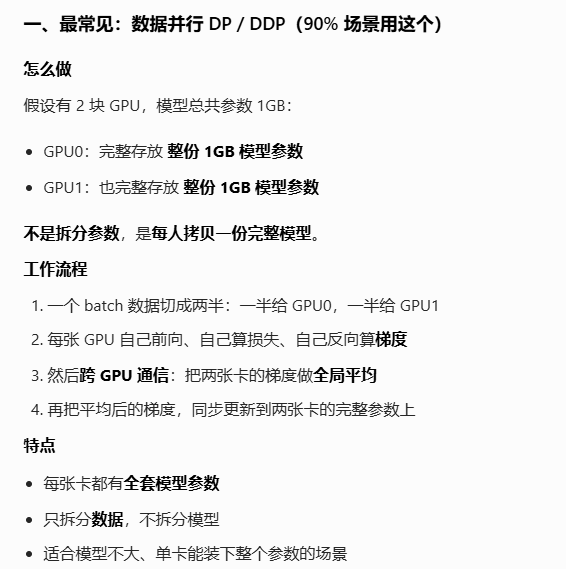
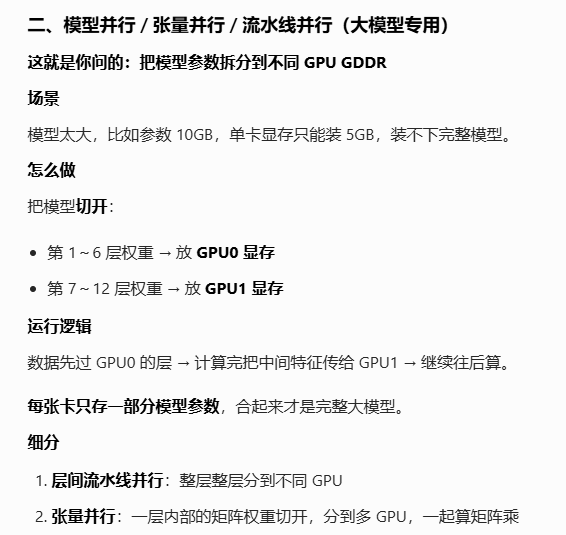
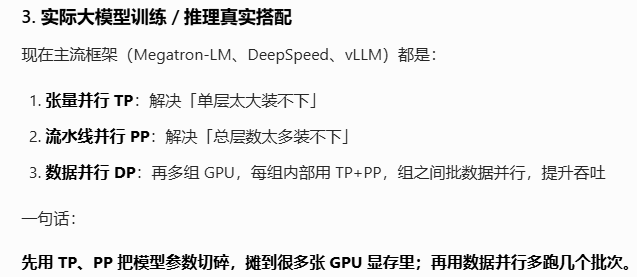
多GPU训练

一种分模型参数,一种不分参数只分数据
419

318335

AlexNet

AlexNet横空出世。它首次证明了学习到的特征可以超越手工设计的特征

 AlexNet使用了8层卷积神经网络
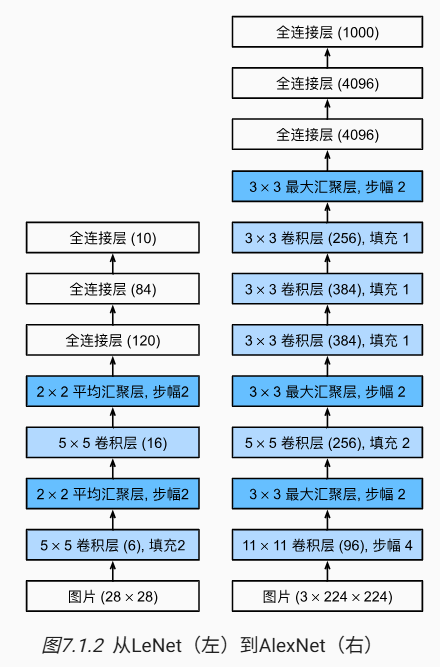
364

  1. AlexNet比相对较小的LeNet5要深得多。AlexNet由八层组成:五个卷积层、两个全连接隐藏层和一个全连接输出层。
  2. AlexNet使用ReLU而不是sigmoid作为其激活函数。

下面来分析一下AlexNet的架构设计
第一层卷积:11x11的卷积核,因为输入图片尺寸大,所以用大卷积核。
第二层卷积:5x5的卷积核
第三层卷积:3x3卷积
……
最后两个4096个输出的全连接层,总参数将近1GB

激活函数选择ReLU, 因为当sigmoid激活函数的输出非常接近于0或1时,这些区域的梯度几乎为0,因此反向传播无法继续更新一些模型参数。 相反,ReLU激活函数在正区间的梯度总是1。 因此,如果模型参数没有正确初始化,sigmoid函数可能在正区间内得到几乎为0的梯度,从而使模型无法得到有效的训练

同时AlexNet通过暂退法控制全连接的模型复杂度。而LeNet只使用了权重衰减

为了进一步扩充数据,AlexNet在训练时增加了大量的图像增强数据,如翻转、裁切和变色

这使得模型更健壮,更大的样本量有效地减少了过拟合

手动实现一个AlexNet

import torch
from torch import nn
from d2l import torch as d2l

net = nn.Sequential(
# 这里使用一个11*11的更大窗口来捕捉对象。
# 同时,步幅为4,以减少输出的高度和宽度。
# 另外,输出通道的数目远大于LeNet
nn.Conv2d(1, 96, kernel_size=11, stride=4, padding=1), nn.ReLU(),
nn.MaxPool2d(kernel_size=3, stride=2),
# 减小卷积窗口,使用填充为2来使得输入与输出的高和宽一致,且增大输出通道数
nn.Conv2d(96, 256, kernel_size=5, padding=2), nn.ReLU(),
nn.MaxPool2d(kernel_size=3, stride=2),
# 使用三个连续的卷积层和较小的卷积窗口。
# 除了最后的卷积层,输出通道的数量进一步增加。
# 在前两个卷积层之后,汇聚层不用于减少输入的高度和宽度
nn.Conv2d(256, 384, kernel_size=3, padding=1), nn.ReLU(),
nn.Conv2d(384, 384, kernel_size=3, padding=1), nn.ReLU(),
nn.Conv2d(384, 256, kernel_size=3, padding=1), nn.ReLU(),
nn.MaxPool2d(kernel_size=3, stride=2),
nn.Flatten(),
# 这里,全连接层的输出数量是LeNet中的好几倍。使用dropout层来减轻过拟合
nn.Linear(6400, 4096), nn.ReLU(),
nn.Dropout(p=0.5),
nn.Linear(4096, 4096), nn.ReLU(),
nn.Dropout(p=0.5),
# 最后是输出层。由于这里使用Fashion-MNIST,所以用类别数为10,而非论文中的1000
nn.Linear(4096, 10))

VGG网络(块)

虽然AlexNet证明深层神经网络卓有成效,但它没有提供一个通用的模板来指导后续的研究人员设计新的网络

VGG网络中使用块的概念,方便了设计新网络的能力

经典卷积神经网络的基本组成部分是下面的这个序列:

  1. 带填充以保持分辨率的卷积层;
  2. 非线性激活函数,如ReLU;
  3. 汇聚层,如最大汇聚层。

VGG网络可以分为两部分:

  • 第一部分主要由卷积层和汇聚层组成
  • 第二部分由全连接层组成

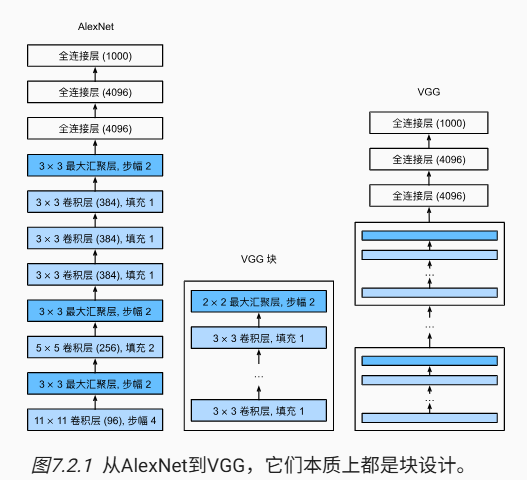
具体给架构设计是这样子的

316

这里我们自己实现一个vgg块

from mxnet import np, npx
from mxnet.gluon import nn
from d2l import mxnet as d2l

npx.set_np()

def vgg_block(num_convs, num_channels):
blk = nn.Sequential()
for _ in range(num_convs):
blk.add(nn.Conv2D(num_channels, kernel_size=3,
padding=1, activation='relu'))
blk.add(nn.MaxPool2D(pool_size=2, strides=2))
return blk

VGG神经网络连接 图7.2.1的几个VGG块(在vgg_block函数中定义)

其中有超参数变量conv_arch。该变量指定了每个VGG块里卷积层个数和输出通道数。
conv_arch = ((1, 64), (1, 128), (2, 256), (2, 512), (2, 512)) 五个卷积块

全连接模块则与AlexNet中的相同。

原始VGG网络有5个卷积块,其中前两个块各有一个卷积层,后三个块各包含两个卷积层。

第一个模块有64个输出通道,每个后续模块将输出通道数量翻倍,直到该数字达到512

由于该网络使用8个卷积层和3个全连接层,因此它通常被称为VGG-11

那么开始搭建一个完整的vgg-11模型

def vgg(conv_arch):
conv_blks = []
in_channels = 1
# 卷积层部分
for (num_convs, out_channels) in conv_arch:
conv_blks.append(vgg_block(num_convs, in_channels, out_channels))
in_channels = out_channels

return nn.Sequential(
*conv_blks, nn.Flatten(),
# 全连接层部分
nn.Linear(out_channels * 7 * 7, 4096), nn.ReLU(), nn.Dropout(0.5),
nn.Linear(4096, 4096), nn.ReLU(), nn.Dropout(0.5),
nn.Linear(4096, 10))

net = vgg(conv_arch)

450

NiN(网络中的网络)

AlexNet和VGG对LeNet的改进主要在于如何扩大和加深这两个模块

然而,如果使用了全连接层,可能会完全放弃表征的空间结构

网络中的网络(NiN)提供了一个非常简单的解决方案:在每个像素的通道上分别使用多层感知机
即将空间维度中的每个像素视为单个样本,将通道维度视为不同特征(feature)
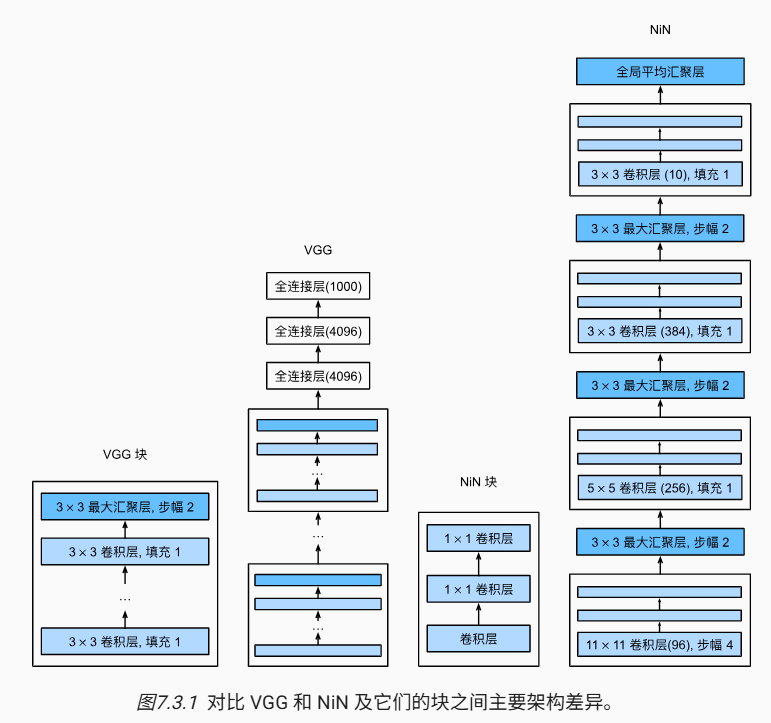
549

可以看到,NiN块,是先经过一个普通的卷积层,然后,是两个1x1的卷积层来升降维。这两个1x1的卷积层,充当带有ReLU激活函数的,逐像素全连接层。

我们也自己定义一个NiN块看看

import torch
import torch.nn as nn

def nin_block(in_channels, out_channels, kernel_size, strides, padding):
return nn.Sequential(
nn.Conv2d(in_channels, out_channels, kernel_size, strides, padding),
nn.ReLU(),
nn.Conv2d(out_channels, out_channels, kernel_size=1), nn.ReLU(),
nn.Conv2d(out_channels, out_channels, kernel_size=1), nn.ReLU()
)
"""
注意,NiN块的最后一个out_channels, 被设置成类别数,这样就相当于对每个像素,做符合类别数量的一个全连接映射。
"""

可以看到,他既不升维也不降维,单纯的就是逐像素,把每个通道作为输入,等价于像素位置上的全连接层。很妙啊

NiN和AlexNet之间的一个显著区别是NiN完全取消了全连接层,NiN使用一个NiN块,其输出通道数等于标签类别的数量

最后放一个_全局平均汇聚层_(global average pooling layer),生成一个对数几率 (logits):

在深度学习中,对数几率(Logits)本质上就是一组没有经过归一化(如 Softmax)的原始得分向量**
471

NiN 的设计思想是:与其用复杂且臃肿的全连接层去“猜”每个类别的得分,不如直接让卷积层产出对应类别的特征图,然后通过取平均值的方式提取出该类别的总体得分。

这样做最大的好处是显著减少了模型所需参数的数量,因为它彻底取消了占据 AlexNet 大部分参数量的全连接层。

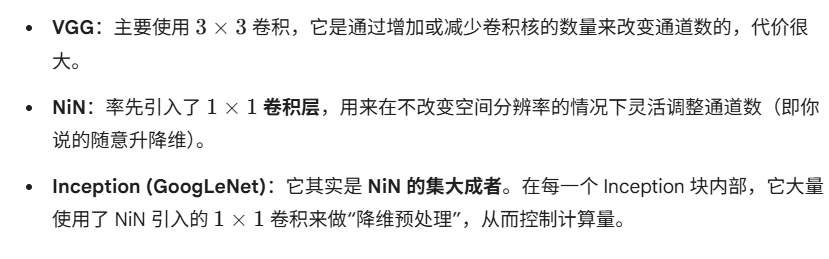
GoogLeNet(并行连接)

GoogLeNet 吸收了NiN的串联网络的思想。解决的问题是:什么样大小的卷积核最合适的问题

观点是,有时使用不同大小的卷积核组合是有利的

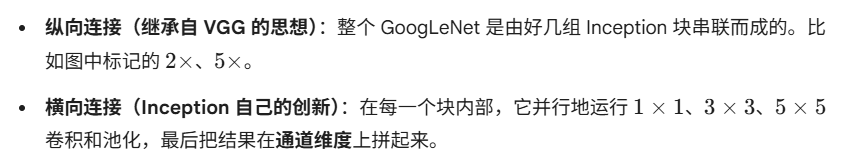
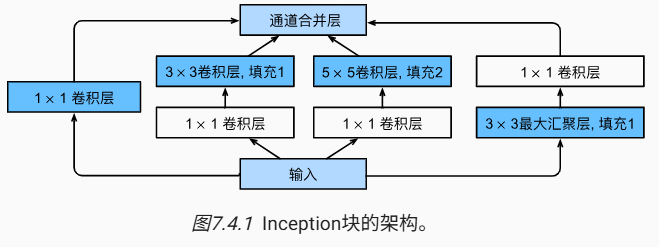
GoogLeNet里面,也设计了自己的卷积块:基本的卷积块被称为_Inception块_
424
这个块,本身由4条并行路径构成

中间两条路:先经过1x1卷积,减少输入的通道数,降低模型的复杂性(让后面的卷积核的通道减少)。

这四条路径,都是用合适的填充让输入与输出的高宽一致(说明这个块的4条路径,都是在通道上做文章,不是在图片尺寸上)

最后我们将每条线路的输出在通道维度上连结,并构成Inception块的输出。

在Inception块中,通常调整的超参数是每层输出通道数(因为是4条路汇聚起来的嘛)

import torch
import torch.nn as nn
from torch.nn import functional as F

class Inception(nn.Module):
# **kwargs表示接收任意多的额外关键字参数
def __init__(self, in_channles, c1, c2, c3, c4, **kwargs):
super().__init__()
self.p1_1 = nn.Conv2d(in_channels, c1, kernel_size=1)
self.p2_1 = nn.Conv2d(in_channels, c2[0], kernel_size=1)
self.p2_2 = nn.Conv2d(c2[0], c2[1], kernel_size=3, padding=1)
self.p3_1 = nn.Conv2d(in_channels, c3[0], kernel_size=1)
self.p3_2 = nn.Conv2d(c3[0], c3[1], kernel_size=5, padding=2)
self.p4_1 = nn.MaxPoll2d(kernel_size=3, stride=1, padding=1)
self.p4_2 = nn.Conv2d(in_channels, c4, kernel_size=1)

def forward(self, x):
p1 = F.relu(self.p1_1(x))
p2 = F.relu(self.p2_2(F.relu(self.p2_1(x))))
p3 = F.relu(self.p3_2(F.relu(self.p3_1(x))))
p4 = F.relu(self.p4_2(self.p4_1(x)))

return torch.cat((p1, p2, p3, p4), dim=1)

GoogLeNet之所以有效,是因为用来不同尺寸的滤波器去探索图像。为不同的滤波器分配不同数量的参数。

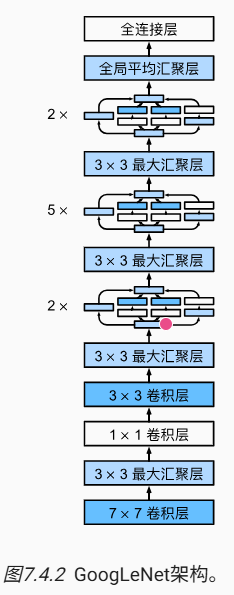
下面看看完整的GoogLeNet模型架构
150

一共使用9个Inception块和全局平均汇聚层的堆叠来生成其估计值

Inception块之间的最大汇聚层可降低维度

第一个模块类似于AlexNet和LeNet

Inception块的组合从VGG继承(因为他有多个inception块相连接)

510

478

488

下面完整实现这个GoogLeNet网络模型

b1 = nn.Sequential(nn.Conv2d(1, 64, kernel_size=7, stride=2, padding=3),
nn.ReLU(),
nn.MaxPool2d(kernel_size=3, stride=2, padding=1))

b2 = nn.Sequential(nn.Conv2d(64, 64, kernel_size=1),
nn.ReLU(),
nn.Conv2d(64, 192, kernel_size=3, padding=1),
nn.ReLU(),
nn.MaxPool2d(kernel_size=3, stride=2, padding=1))

b3 = nn.Sequential(Inception(192, 64, (96, 128), (16, 32), 32),
Inception(256, 128, (128, 192), (32, 96), 64),
nn.MaxPool2d(kernel_size=3, stride=2, padding=1))
b4 = nn.Sequential(Inception(480, 192, (96, 208), (16, 48), 64),
Inception(512, 160, (112, 224), (24, 64), 64),
Inception(512, 128, (128, 256), (24, 64), 64),
Inception(512, 112, (144, 288), (32, 64), 64),
Inception(528, 256, (160, 320), (32, 128), 128),
nn.MaxPool2d(kernel_size=3, stride=2, padding=1))

b5 = nn.Sequential(Inception(832, 256, (160, 320), (32, 128), 128),
Inception(832, 384, (192, 384), (48, 128), 128),
nn.AdaptiveAvgPool2d((1,1)),
nn.Flatten())

net = nn.Sequential(b1, b2, b3, b4, b5, nn.Linear(1024, 10))

批量规范化

训练深层神经网络是十分困难的,特别是在较短的时间内使他们收敛更加棘手。 本节将介绍_批量规范化_(batch normalization)

可持续加速深层网络的收敛速度(后面再结合残差块设计)

BatchNormalization,能够训练100层以上的网络

训练深层网络的需要

  • 使用真实数据时,我们的第一步是标准化输入特征,使其平均值为0,方差为1。这种标准化可以很好地与我们的优化器配合使用,因为它可以将参数的量级进行统一
  • 对于典型的MLP和CNN,训练时的中间层变量,可能具有更广的变化范围。

 批量规范化的发明者非正式地假设,这些变量分布中的这种偏移可能会阻碍网络的收敛。 直观地说,我们可能会猜想,如果一个层的可变值是另一层的100倍,这可能需要对学习率进行补偿调整

  • 更深层的网络很复杂,容易过拟合。 这意味着正则化变得更加重要。

批量规范化应用于单个可选层(也可以应用到所有层)
其原理如下:

  • 在每次训练迭代中,我们首先规范化输入,即通过减去其均值并除以其标准差,其中两者均基于当前小批量处理。
  • 接下来,我们应用比例系数和比例偏移。 正是由于这个基于_批量_统计的_标准化_,才有了_批量规范化_的名称。

请注意,如果我们尝试使用大小为1的小批量应用批量规范化,我们将无法学到任何东西。 这是因为在减去均值之后,每个隐藏单元将为0

所以,只有使用足够大的小批量,批量规范化这种方法才是有效且稳定的
请注意,在应用批量规范化时,批量大小的选择可能比没有批量规范化时更重要

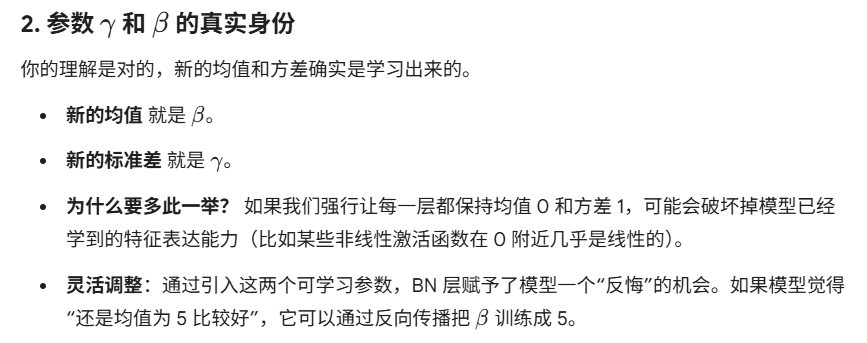
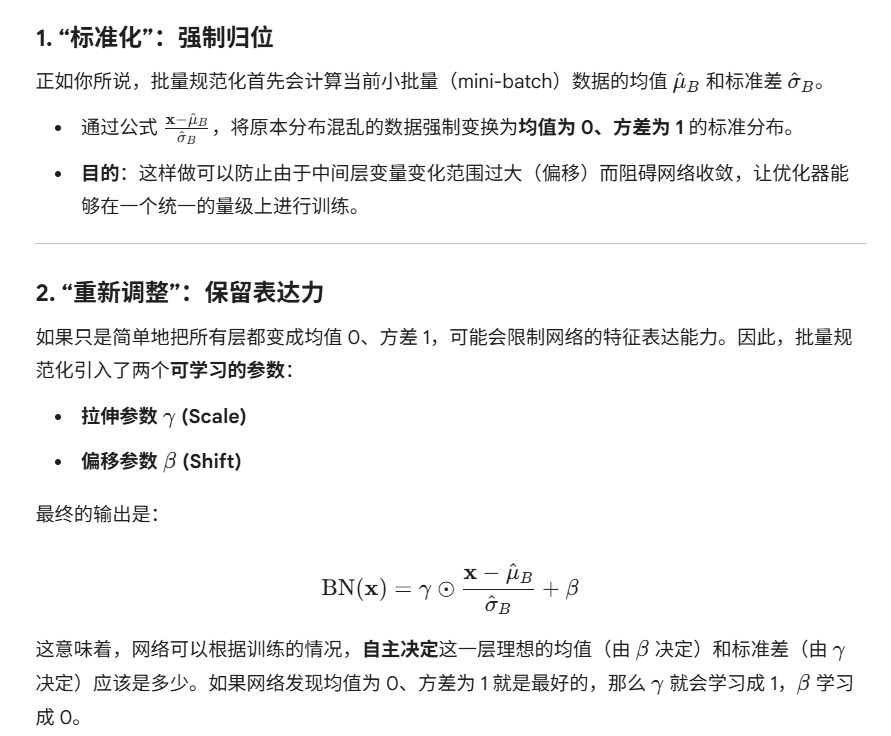
简单说,批量规范化,主要有两个部分:
534
这里的批量规范化层,引入了两个模型参数:γ(拉伸参数),β(偏移参数)

批量规范化(Batch Normalization,简称 BN)层确实是一个独立的“层”,它的核心作用就是规范化它前面那一层的输出(也就是后面那一层的输入)。
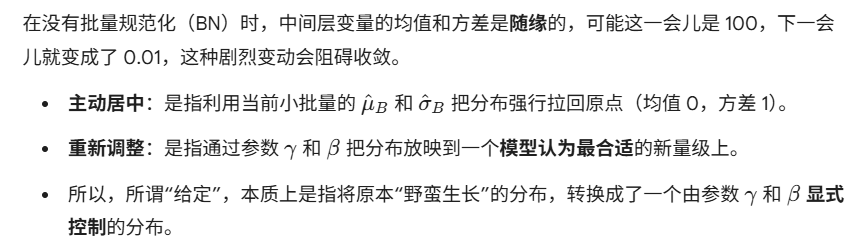
534

512

计算样本均值和方差的小巧思
605

642

批量规范化层实现

因为批量规范化层,肯定需要知道一个batch的所有内容,所以,不能像其他层那样忽略batch_size的大小。

全连接层的批量规范化
我们将批量规范化层置于全连接层中的仿射变换(预激活值)和激活函数之间
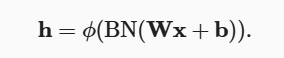
卷积层的批量规范化
我们可以在卷积层之后和非线性激活函数之前应用批量规范化

卷积有多个输出通道时,我们需要对这些通道的“每个”输出执行批量规范化,每个通道都有自己的拉伸(scale)和偏移(shift)参数,这两个参数都是标量
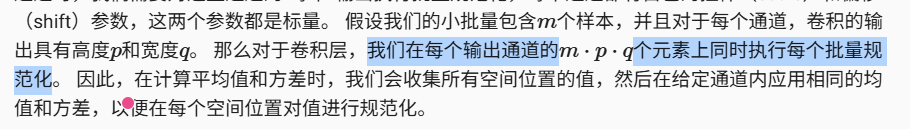

具体的计算方式为:以通道为单位算规范化
针对mxpxq的元素进行参与计算(m = batch_size)
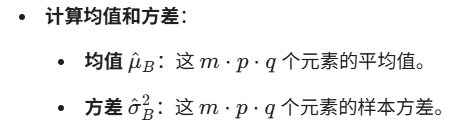
321

所以,每个卷积核通道,持有一组批量规范化的参数。

前向推理过程中的批量规范化
批量规范化在训练模式和预测模式下的行为通常不同
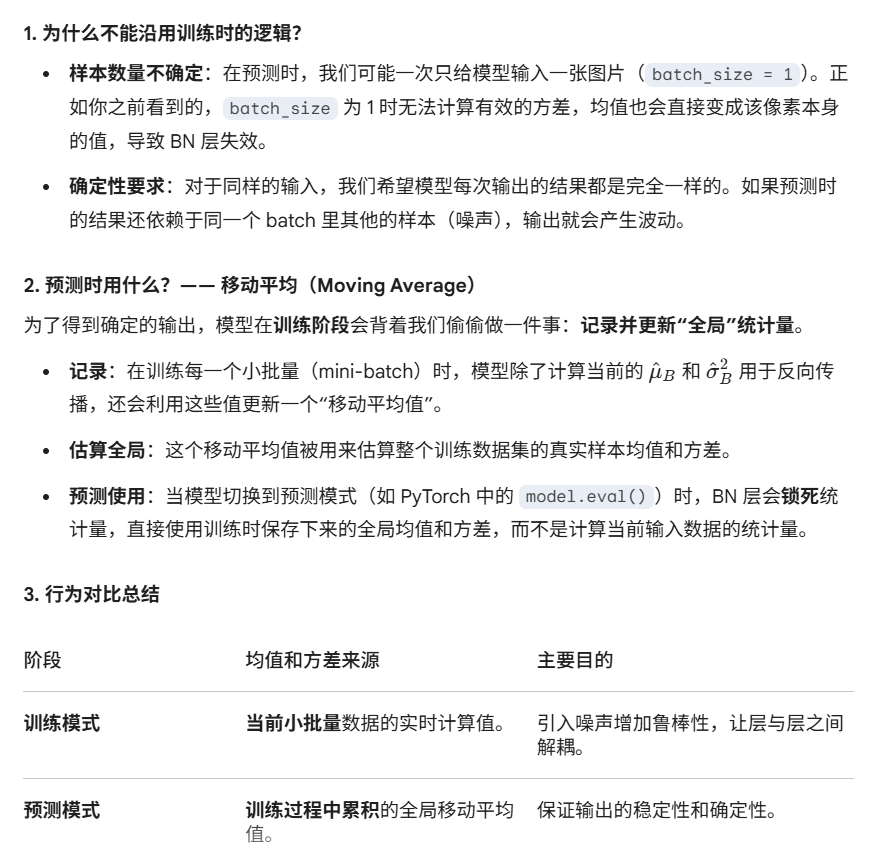
497

批量规范化层的实现

import torch
from torch import nn
from d2l import torch as d2l

def batch_norm(X, gamma, beta, moving_mean, moving_var, eps, momentum):
# 通过is_grad_enabled来判断当前模式是训练模式还是预测模式
if not torch.is_grad_enabled():
# 如果是在预测模式下,直接使用传入的移动平均所得的均值和方差
X_hat = (X - moving_mean) / torch.sqrt(moving_var + eps)
else:
assert len(X.shape) in (2, 4)
if len(X.shape) == 2:
# 使用全连接层的情况,计算特征维上的均值和方差
mean = X.mean(dim=0)
var = ((X - mean) ** 2).mean(dim=0)
else:
# 使用二维卷积层的情况,计算通道维上(axis=1)的均值和方差。
# 这里我们需要保持X的形状以便后面可以做广播运算
mean = X.mean(dim=(0, 2, 3), keepdim=True)
var = ((X - mean) ** 2).mean(dim=(0, 2, 3), keepdim=True)
# 训练模式下,用当前的均值和方差做标准化
X_hat = (X - mean) / torch.sqrt(var + eps)
# 更新移动平均的均值和方差
moving_mean = momentum * moving_mean + (1.0 - momentum) * mean
moving_var = momentum * moving_var + (1.0 - momentum) * var
Y = gamma * X_hat + beta # 缩放和移位
return Y, moving_mean.data, moving_var.data
  1. 维度判断:处理全连接层输出
  • assert len(X.shape) in (2, 4):这行代码是在确认输入的形状。在深度学习中,全连接层的输出通常是二维张量,形状为 (批量大小, 特征维度)。
  • if len(X.shape) == 2::当进入这个分支时,说明模型当前正在对全连接层的输出进行规范化。
  1. 计算特征维上的统计量
    在全连接层中,批量规范化是针对每一个特征(隐藏单元)独立进行的。
  • 均值计算 (mean = X.mean(dim=0)):
    • dim=0 表示沿着“批量(Batch)”这个维度进行计算。
    • 这意味着,如果你有 128 个样本,每个样本有 64 个特征,那么它会计算这 128 个样本在每一个特征位置上的平均值。
    • 最终得到的 mean 形状与特征维度一致(例如长度为 64 的向量)。
  • 方差计算 (var = ((X - mean) 2).mean(dim=0)):
    • 这行代码计算的是样本方差。
    • 它同样是跨样本(dim=0)进行的,用来衡量该小批量中每个特征的数据离散程度。

在处理二维卷积层的输出(形状通常为 (Batch, Channel, Height, Width))时,它的计算方式如下:

  1. 为什么是 dim=(0, 2, 3)?
    这是最关键的部分。在卷积层的批量规范化中,我们需要跨越样本和空间位置来收集数据:
  • 0 (Batch):跨越小批量中的所有样本。
  • 2 (Height) 和 3 (Width):跨越图像的所有空间坐标。
  • 结果:计算出的 mean 和 var 是针对每一个通道唯一的标量。这意味着同一个通道内所有的像素点,无论在哪个样本、哪个位置,都共用这一组均值和方差。
  1. keepdim=True 的作用
    正如注释所言,这是为了后续的广播运算(Broadcasting):
  • 如果输出通道是 $16$,不加这个参数计算出的 mean 形状可能是 (16,)。
  • 加上 keepdim=True 后,mean 的形状会保持为 (1, 16, 1, 1)。
  • 这样在执行 X - mean 时,PyTorch 会自动把这个 $1 \times 16 \times 1 \times 1$ 的张量“扩展”到和原始 X 一样的形状,从而实现对每个通道内所有像素点进行统一减法的操作。

  1. 标准化(Standardization)
X_hat = (X - mean) / torch.sqrt(var + eps)
  • 减去均值与除以标准差:这行代码实现了你之前提到的“主动居中”。它将当前通道或特征的分布强制变换为均值为 0、方差为 1 的标准分布。
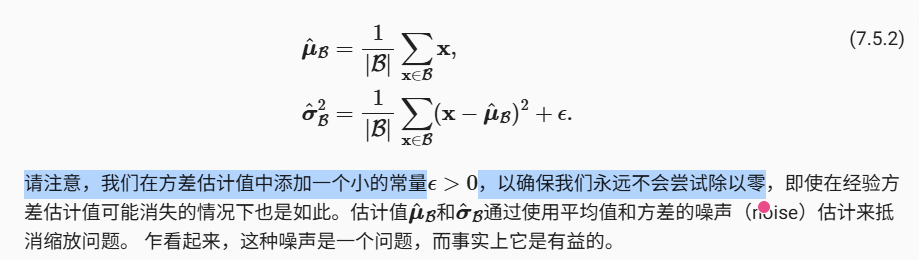
  • eps (Epsilon) 的作用:对应于你参考资料中提到的“在方差估计值中添加一个小的常量 $\epsilon > 0$”。其目的是确保分母不为零,防止在方差接近 0 时计算崩溃。
  1. 更新移动平均(Updating Moving Average)
moving_mean = momentum * momentum * moving_mean + (1.0 - momentum) * mean
moving_var = momentum * momentum * moving_var + (1.0 - momentum) * var

这是 BN 层最“聪明”的地方,它在训练时偷偷为预测模式(Inference)做准备:

  • 为什么要更新?:正如你查阅的“预测过程中的批量规范化”所述,预测时可能一次只输入一个样本,无法实时算方差。因此,我们需要通过移动平均来估算整个训练数据集的全局均值和方差。
  • momentum (动量):它决定了“记忆”的权重。
    • 通常设为一个接近 1 的值(如 0.9 或 0.99)。
    • 这意味着新的全局估算值 = 90% 的旧记忆 + 10% 的当前小批量观察值。
  • 平滑噪声:训练过程中的单个小批量均值($\hat{\mu}_B$)含有随机噪声。通过这种加权平均,模型可以抵消消缩放问题,得到一个平滑、确定的全局统计量,供预测时使用。

通常情况下,我们用一个单独的函数定义其数学原理,比如说batch_norm。 然后,我们将此功能集成到一个自定义层中,其代码主要处理数据移动到训练设备(如GPU)、分配和初始化任何必需的变量、跟踪移动平均线(此处为均值和方差)等问题

这个只是实现了批量规范化的计算,但是移动均值,移动方差的存储这些,还是需要一个具体的类来存储

class BatchNorm(nn.Module):
# num_features:完全连接层的输出数量或卷积层的输出通道数。
# num_dims:2表示完全连接层,4表示卷积层
def __init__(self, num_features, num_dims):
super().__init__()
if num_dims == 2:
shape = (1, num_features)
else:
shape = (1, num_features, 1, 1)
# 参与求梯度和迭代的拉伸和偏移参数,分别初始化成1和0
self.gamma = nn.Parameter(torch.ones(shape))
self.beta = nn.Parameter(torch.zeros(shape))
# 非模型参数的变量初始化为0和1
self.moving_mean = torch.zeros(shape)
self.moving_var = torch.ones(shape)

def forward(self, X):
# 如果X不在内存上,将moving_mean和moving_var
# 复制到X所在显存上
if self.moving_mean.device != X.device:
self.moving_mean = self.moving_mean.to(X.device)
self.moving_var = self.moving_var.to(X.device)
# 保存更新过的moving_mean和moving_var
Y, self.moving_mean, self.moving_var = batch_norm(
X, self.gamma, self.beta, self.moving_mean,
self.moving_var, eps=1e-5, momentum=0.9)
return Y

使用批量规范化层的LeNet

net = nn.Sequential(
nn.Conv2d(1, 6, kernel_size=5), BatchNorm(6, num_dims=4), nn.Sigmoid(),
nn.AvgPool2d(kernel_size=2, stride=2),
nn.Conv2d(6, 16, kernel_size=5), BatchNorm(16, num_dims=4), nn.Sigmoid(),
nn.AvgPool2d(kernel_size=2, stride=2), nn.Flatten(),
nn.Linear(16*4*4, 120), BatchNorm(120, num_dims=2), nn.Sigmoid(),
nn.Linear(120, 84), BatchNorm(84, num_dims=2), nn.Sigmoid(),
nn.Linear(84, 10))

"""训练代码"""
lr, num_epochs, batch_size = 1.0, 10, 256
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)
d2l.train_ch6(net, train_iter, test_iter, num_epochs, lr, d2l.try_gpu())

pytorch实现的batchNorm

net = nn.Sequential(
nn.Conv2d(1, 6, kernel_size=5), nn.BatchNorm2d(6), nn.Sigmoid(),
nn.AvgPool2d(kernel_size=2, stride=2),
nn.Conv2d(6, 16, kernel_size=5), nn.BatchNorm2d(16), nn.Sigmoid(),
nn.AvgPool2d(kernel_size=2, stride=2), nn.Flatten(),
nn.Linear(256, 120), nn.BatchNorm1d(120), nn.Sigmoid(),
nn.Linear(120, 84), nn.BatchNorm1d(84), nn.Sigmoid(),
nn.Linear(84, 10))

残差网络(ResNet)

当我们的网络越来越深之后,新添加的层,如何提升网络性能 -> 残差块

解释残差块的设计原理

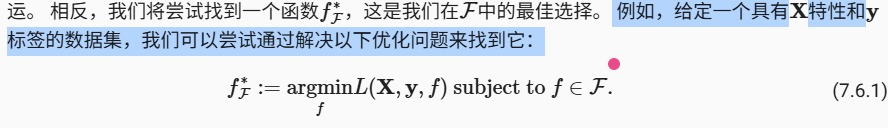
$f$ 与 $\mathcal{F}$:$\mathcal{F}$ 代表函数族(即你选择的模型架构,如一个 5 层的卷积神经网络)。$f$ 是这个族群中的某一个具体的函数(即一组特定的权重参数)。

$L(\mathbf{X}, \mathbf{y}, f)$:这是损失函数(Loss Function)。它衡量了使用函数 $f$ 对特性 $\mathbf{X}$ 进行预测时,预测结果与真实标签 $\mathbf{y}$ 之间的差距。

f是我们实际用数据训练出来的网络,但是假设我们实际真正想要的是f*,但是一般我们没办法找到

所有我们尝试找到一个f’, 他是我们在F中的最佳选择。

所以,我们实际面临的问题是这样子的:

  • 给定数据集(X,y),这个数据集,可以训练出所有的f
  • 我们期望找到f’, 他是能在(X,y)上的Loss损失min的那一个f

所以,f’ 和 f,都∈F, 也就是说,他们有一样的model结构,只是参数不同而已。

那么如何得到最好的f’呢?唯一的可能性,就是重新设计一个更强的F’架构,才能从根本上解决这个问题。(毕竟天花板摆在那里)

但是新架构F’无法保证新体系能够完全涵盖F的覆盖域,也可能更糟糕。
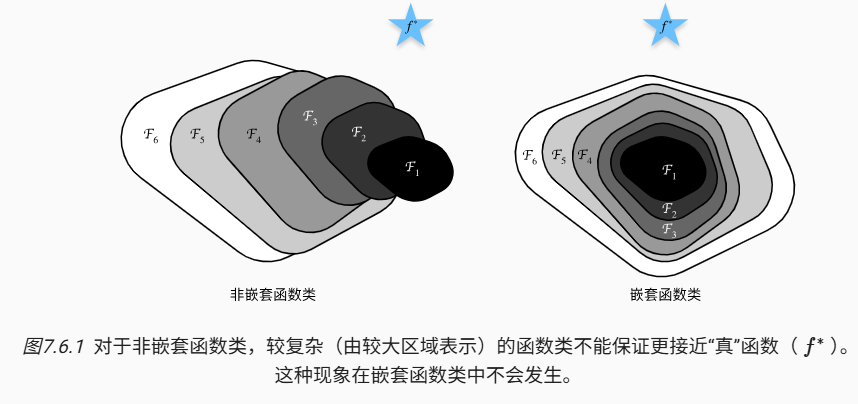
518

因此,只有当较复杂的函数类包含较小的函数类时,我们才能确保提高它们的性能

所以我们的目的,就是找到一种修改优化模型结构的方法,能确保新的模型结构F’, 能完全包含旧模型结构F的覆盖域

也就是说,对于深度神经网络,如果我们能将新添加的层,训练成恒等映射f(x)=x, 那么就能确保F‘肯定包含F这件事, 此时,由新模型结构F’ 才可能得出更优的解来拟合训练数据集。

这就是残差网络ResNet

残差网络的核心思想是:每个附加层都应该更容易地包含原始函数作为其元素之一

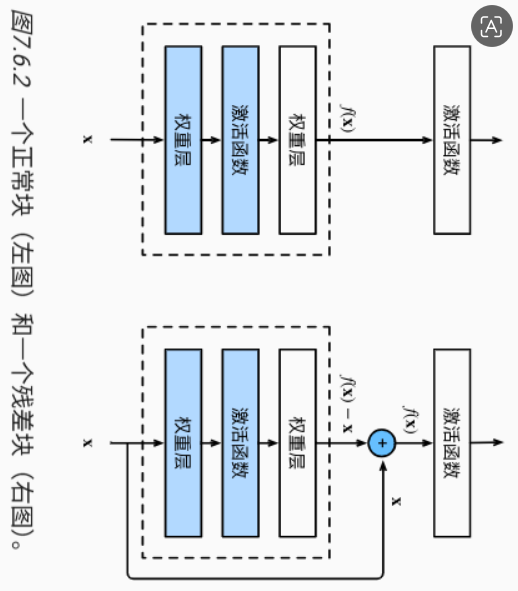
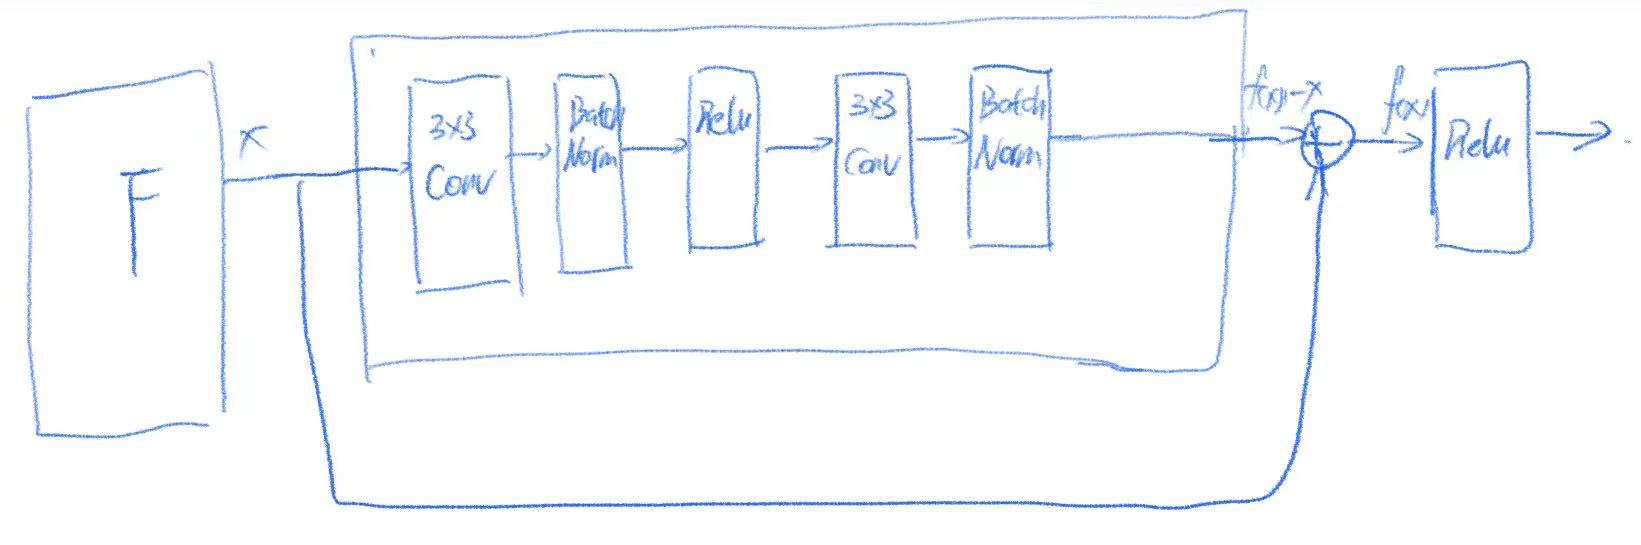
看看残差块,是如何实现这个思想的
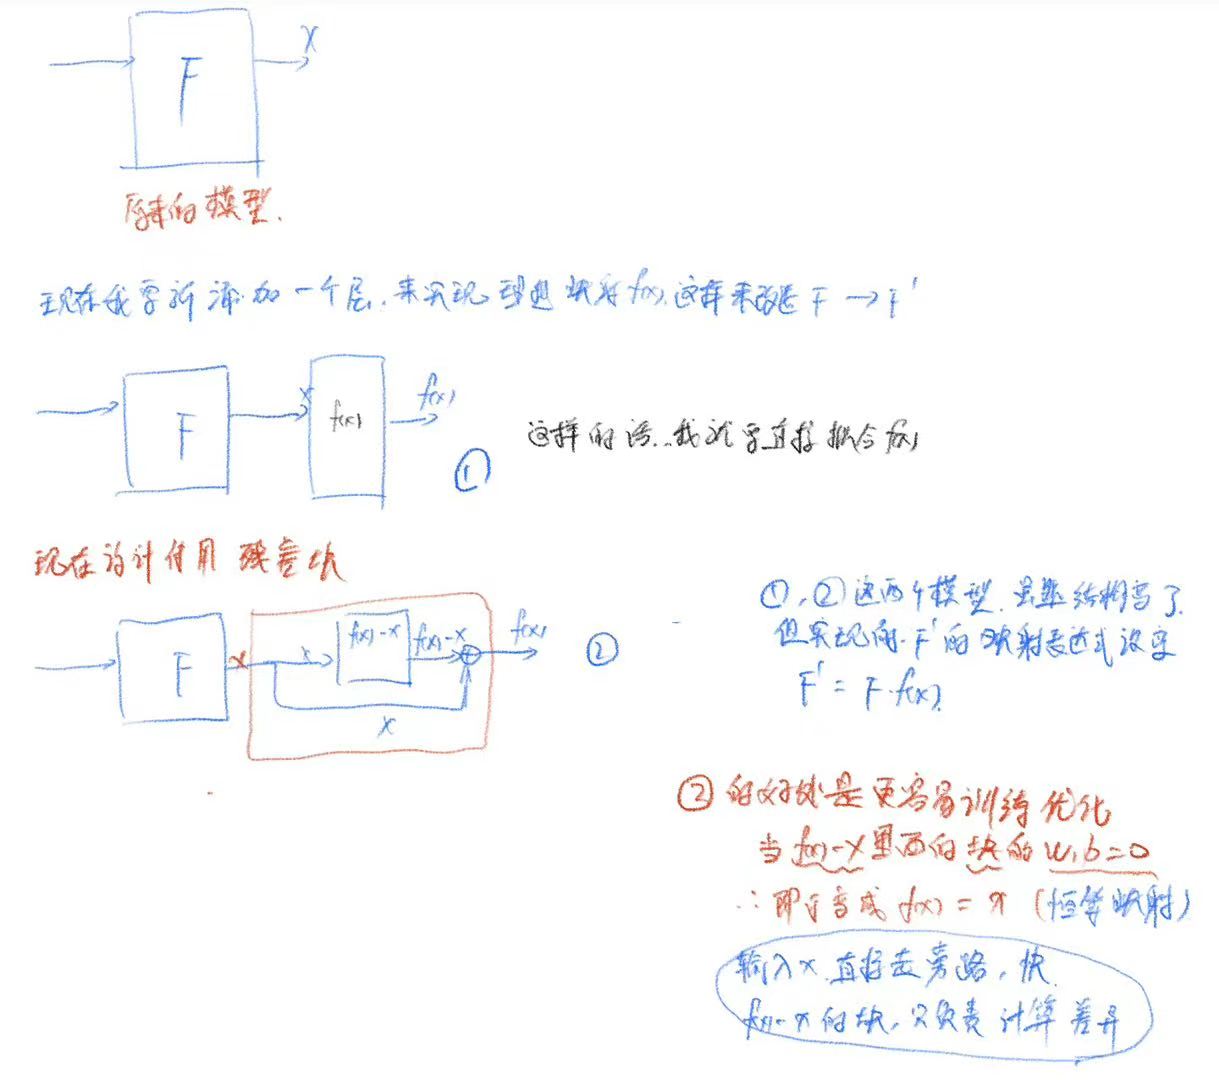
606

378

以上展示的残差块,就是我们为了改造F,新增的一个层,变成F‘

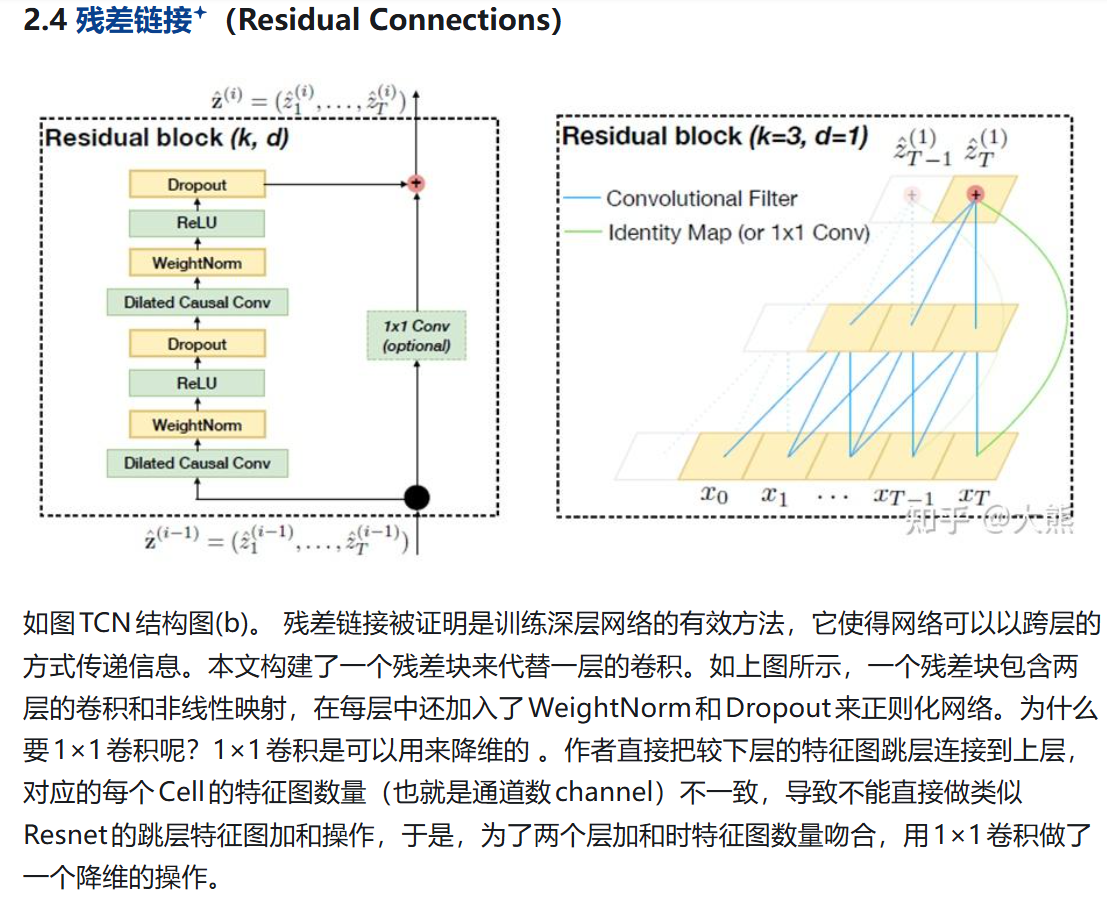
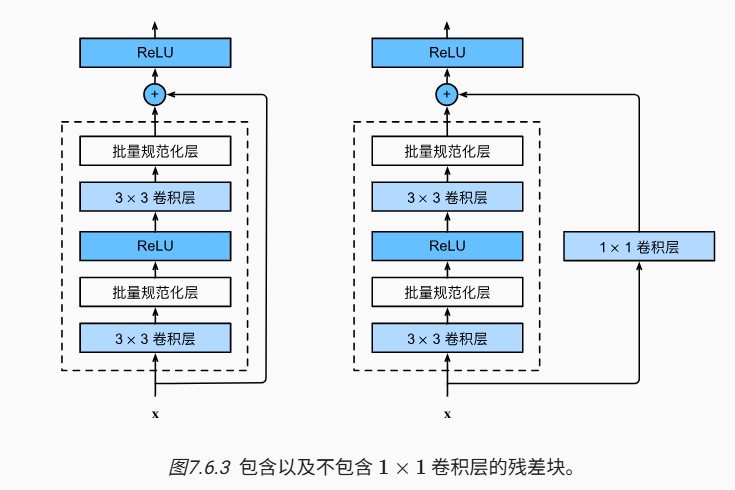
ResNet沿用VGG,残差块里首先有2个有相同输出通道数的3x3卷积层,每个卷积层后接一个批量规范化层和ReLU激活函数
503

import torch
from torch import nn
from torch.nn import functional as F
from d2l import torch as d2l

class Residual(nn.Module): #@save
def __init__(self, input_channels, num_channels,
use_1x1conv=False, strides=1):
super().__init__()
self.conv1 = nn.Conv2d(input_channels, num_channels,
kernel_size=3, padding=1, stride=strides)
self.conv2 = nn.Conv2d(num_channels, num_channels,
kernel_size=3, padding=1)
if use_1x1conv:
self.conv3 = nn.Conv2d(input_channels, num_channels,
kernel_size=1, stride=strides)
else:
self.conv3 = None
self.bn1 = nn.BatchNorm2d(num_channels)
self.bn2 = nn.BatchNorm2d(num_channels)

def forward(self, X):
Y = F.relu(self.bn1(self.conv1(X)))
Y = self.bn2(self.conv2(Y))
if self.conv3:
X = self.conv3(X)
Y += X
return F.relu(Y)

此代码生成两种类型的网络: 一种是当use_1x1conv=False时,应用ReLU非线性函数之前,将输入添加到输出。 另一种是当use_1x1conv=True时,添加通过1x1卷积调整通道和分辨率
521
之所以在残差块(Residual Block)的旁路(Shortcut)使用它能减半高和宽,秘密不在于卷积核的大小,而是在于卷积操作的一个关键参数:步幅(Stride)

ResNet除了使用残差块的设计外,还由一个不同之处是,每个卷积层后面,都增加了批量规范化。

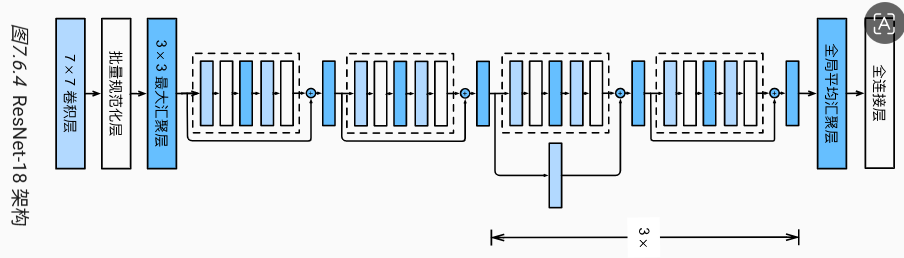
下面我们来用上面定义好的一个残差块,构建我们的resnet块

b1 = nn.Sequential(nn.Conv2d(1, 64, kernel_size=7, stride=2, padding=3),
nn.BatchNorm2d(64), nn.ReLU(),
nn.MaxPool2d(kernel_size=3, stride=2, padding=1))


def resnet_block(input_channels, num_channels, num_residuals,
first_block=False):
blk = []
for i in range(num_residuals):
if i == 0 and not first_block:
blk.append(Residual(input_channels, num_channels,
use_1x1conv=True, strides=2))
else:
blk.append(Residual(num_channels, num_channels))
return blk

# nn.Sequential(Residual_1, Residual_2)
b2 = nn.Sequential(*resnet_block(64, 64, 2, first_block=True))
b3 = nn.Sequential(*resnet_block(64, 128, 2))
b4 = nn.Sequential(*resnet_block(128, 256, 2))
b5 = nn.Sequential(*resnet_block(256, 512, 2))

net = nn.Sequential(b1, b2, b3, b4, b5,
nn.AdaptiveAvgPool2d((1,1)),
nn.Flatten(), nn.Linear(512, 10))


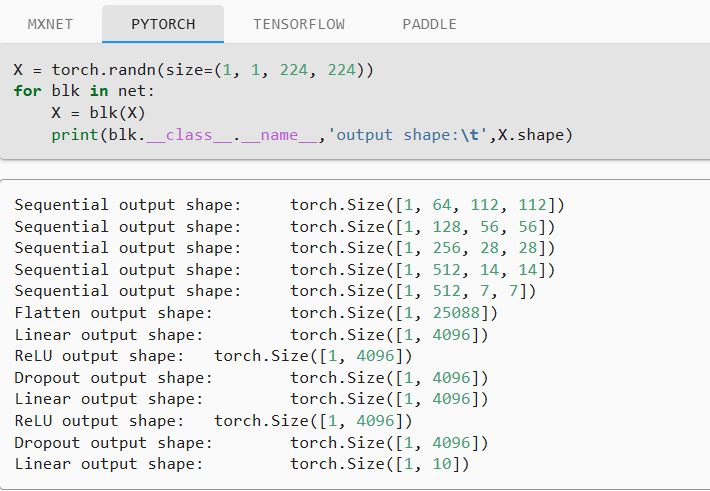
X = torch.rand(size=(1, 1, 224, 224))
for layer in net:
X = layer(X)
print(layer.__class__.__name__,'output shape:\t', X.shape)

"""
Sequential output shape: torch.Size([1, 64, 56, 56])
Sequential output shape: torch.Size([1, 128, 28, 28])
Sequential output shape: torch.Size([1, 256, 14, 14])
Sequential output shape: torch.Size([1, 512, 7, 7])
AdaptiveAvgPool2d output shape: torch.Size([1, 512, 1, 1])
Flatten output shape: torch.Size([1, 512])
Linear output shape: torch.Size([1, 10])
"""

lr, num_epochs, batch_size = 0.05, 10, 256
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size, resize=96)
d2l.train_ch6(net, train_iter, test_iter, num_epochs, lr, d2l.try_gpu())


"""
loss 0.012, train acc 0.997, test acc 0.893
5032.7 examples/sec on cuda:0
"""

稠密层(DenseNet)

ResNet极大地改变了如何参数化深层网络中函数的观点

_稠密连接网络_在某种程度上是ResNet的逻辑扩展

我们曾经,对任意函数进行泰勒展开,可以分解成很多项
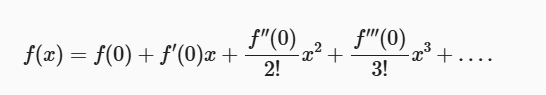
357

同样ResNet将函数展开:
137
可以看到,ResNet网络,本身就是将这个残差块的映射f(x), 分成两条路,一路x旁路,一路是差异g(x),即一个简单的线性项和一个复杂的非线性项(可以想象成泰勒展开的余项)

那么,再拓展一步,如果我们想要把f(x)再像泰勒展开一样再进一步展开呢,你看线性x,就是泰勒展开已经展开的部分,非线性项g(x), 就是余项,可以进一步展开。这个方案就是DenseNet
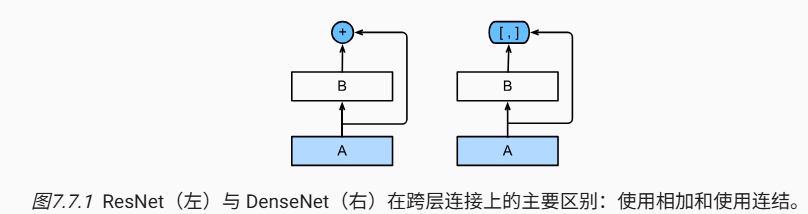
558

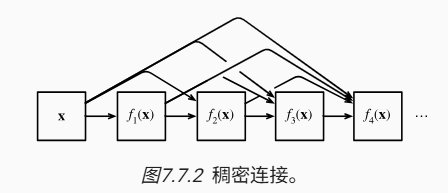
ResNet和DenseNet的关键区别在于,DenseNet输出是_连接_(用图中的[.]表示)而不是如ResNet的简单相加

所以,如果我们的这个残差块,要学习的真的是一个很复杂的映射关系,那么
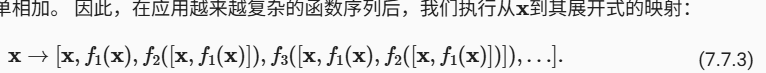
610

576
577
448

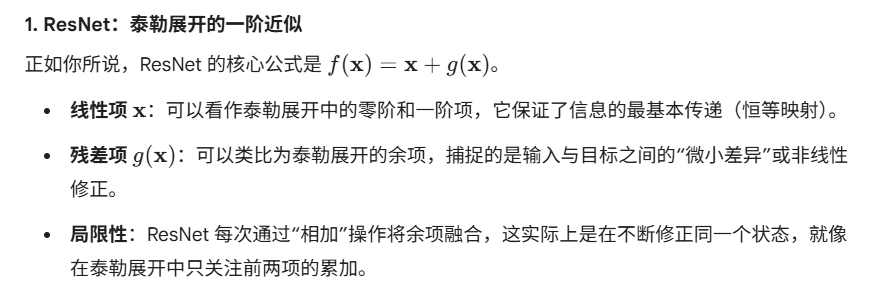
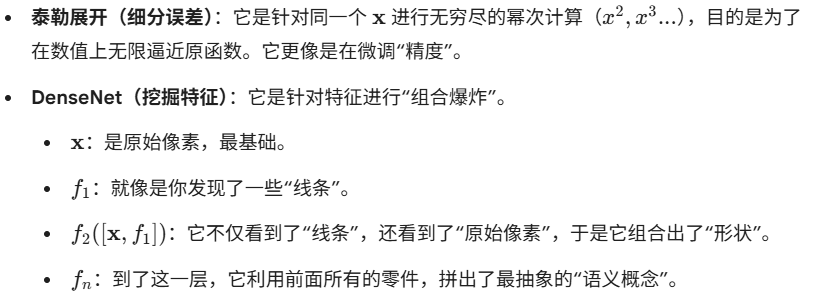
所以,稠密层里面,更高阶的余项,不是像泰勒展开那样,去不停的细分,而是说,x是基础特征,f1是基于x挖掘的一阶特征,f2是利用f1,x 组合出来的更复杂的特征,…., fn是最高级的特征

泰勒展开是“横向细分”,DenseNet 是“纵向抽象”
580

import torch
from torch import nn
from d2l import torch as d2l

def conv_block(input_channels, num_channels):
return nn.Sequential(
nn.BatchNorm2d(input_channels), nn.ReLU(),
nn.Conv2d(input_channels, num_channels, kernel_size=3, padding=1))


class DenseBlock(nn.Module):
def __init__(self, num_convs, input_channels, num_channels):
super(DenseBlock, self).__init__()
layer = []
for i in range(num_convs):
layer.append(conv_block(
num_channels * i + input_channels, num_channels))
"""
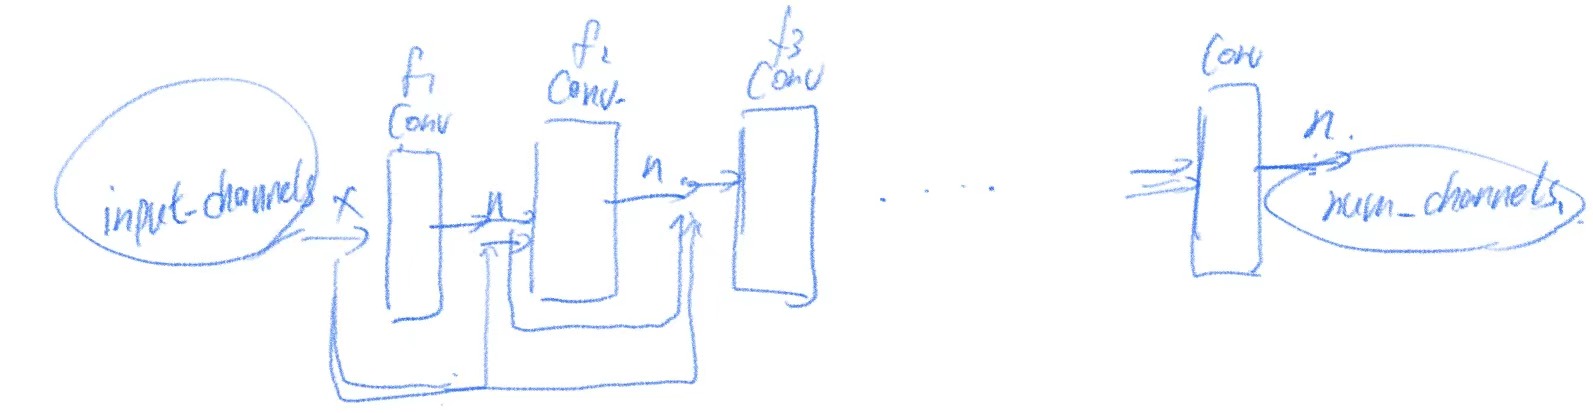
x: i
f1(x): i -> n
f2(x,f1): i+n -> n
f3(x,f1,f2): i+n+n -> n
f4(x,f1,f2,f3): i+n+n+n -> n
...
"""
self.net = nn.Sequential(*layer)
"""
net(x): i->n
"""

def forward(self, X):
for blk in self.net:
Y = blk(X)
# 连接通道维度上每个块的输入和输出
X = torch.cat((X, Y), dim=1)
return X


blk = DenseBlock(2, 3, 10)
X = torch.randn(4, 3, 8, 8)
Y = blk(X)
Y.shape

570

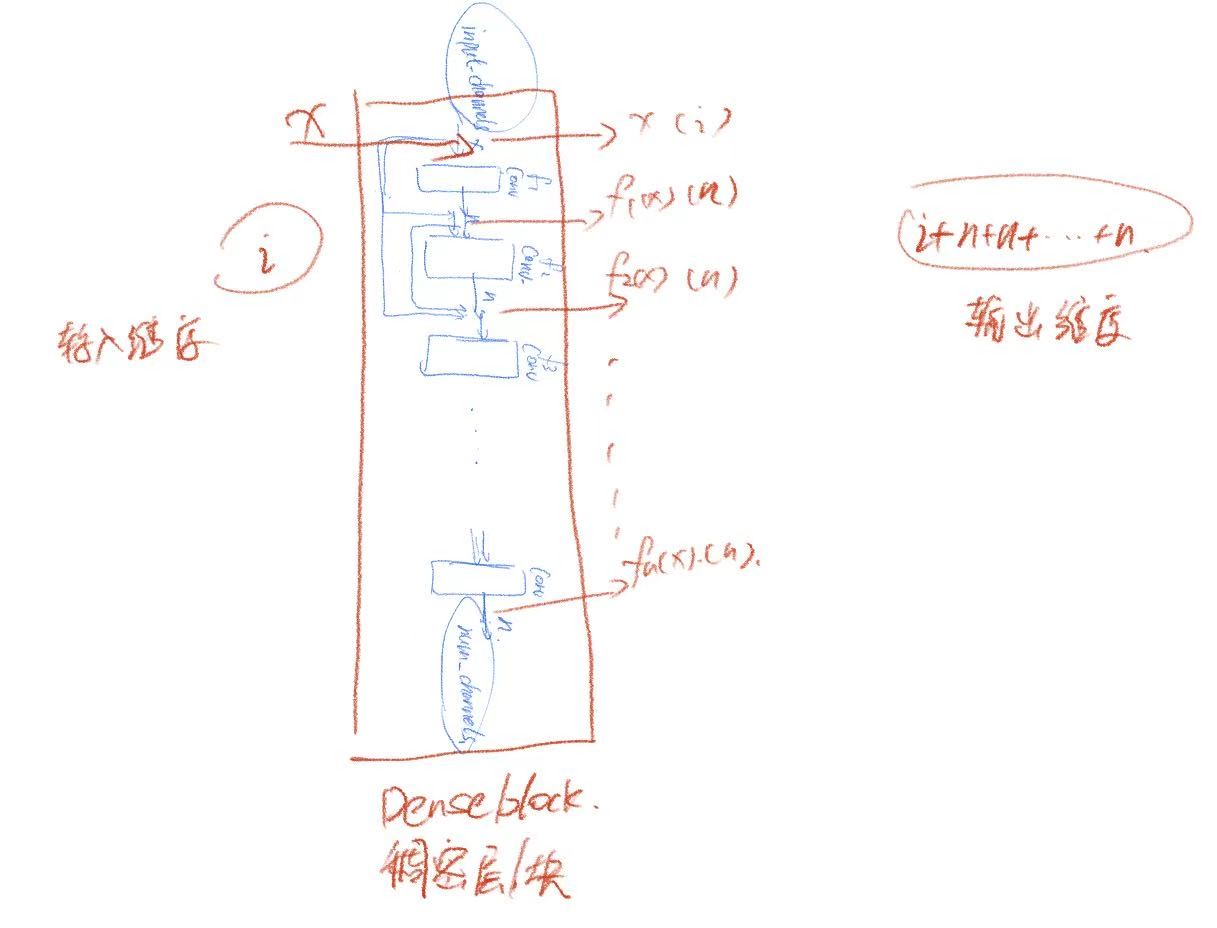
上面就是一个稠密块的结构。(两个卷积层,输入维度3, 输出维度10)

这里的输入通道,指的是x的维度,输出通道,是指的每个卷积层的输出通道,但是整个稠密层,其实是输出所有的卷积的结果,包括原始的结果。

所有实际上,一个稠密块的输出,要这么看,输入x, 输出(x, f1(x),f2(x,f1(x)))
550

由于每个稠密块都会带来通道数的增加,使用过多则会过于复杂化模型

而过渡层可以用来控制模型复杂度(通过1x1的卷积层来减小通道数,降维,然后使用步幅为2的平均池化层来减半尺寸,进一步降低模型复杂度)

def transition_block(input_channels, num_channels):
return nn.Sequential(
nn.BatchNorm2d(input_channels), nn.ReLU(),
nn.Conv2d(input_channels, num_channels, kernel_size=1),
nn.AvgPool2d(kernel_size=2, stride=2))

blk = transition_block(23, 10)
blk(Y).shape

"""
torch.Size([4, 10, 4, 4])
"""

下面来构建具体的DenseNet模型

b1 = nn.Sequential(
nn.Conv2d(1, 64, kernel_size=7, stride=2, padding=3),
nn.BatchNorm2d(64), nn.ReLU(),
nn.MaxPool2d(kernel_size=3, stride=2, padding=1))


# num_channels为当前的通道数
num_channels, growth_rate = 64, 32
num_convs_in_dense_blocks = [4, 4, 4, 4]
blks = []
for i, num_convs in enumerate(num_convs_in_dense_blocks):
blks.append(DenseBlock(num_convs, num_channels, growth_rate))
# 上一个稠密块的输出通道数
num_channels += num_convs * growth_rate
# 在稠密块之间添加一个转换层,使通道数量减半
if i != len(num_convs_in_dense_blocks) - 1:
blks.append(transition_block(num_channels, num_channels // 2))
num_channels = num_channels // 2 #//2, 表示除法,向下取整数

net = nn.Sequential(
b1, *blks,
nn.BatchNorm2d(num_channels), nn.ReLU(),
nn.AdaptiveAvgPool2d((1, 1)),
nn.Flatten(),
nn.Linear(num_channels, 10))

RNN 循环卷积

序列模型

预测明天的股价要比过去的股价更困难,尽管两者都只是估计一个数字。 毕竟,先见之明比事后诸葛亮难得多。 在统计学中,前者(对超出已知观测范围进行预测)称为_外推法(extrapolation), 而后者(在现有观测值之间进行估计)称为内插法_(interpolation)

音乐、语音、文本和视频都是连续的, 而且这个顺序是有意义的。

处理序列数据需要统计工具和新的深度神经网络架构

前面我们的FNN,CNN,都是以单个样本为单位(X,y)来作为独立的计算单元,不同的样本之间相互独立。目标是,给定一个新的X,我们能够产生对他的标签的预测y’

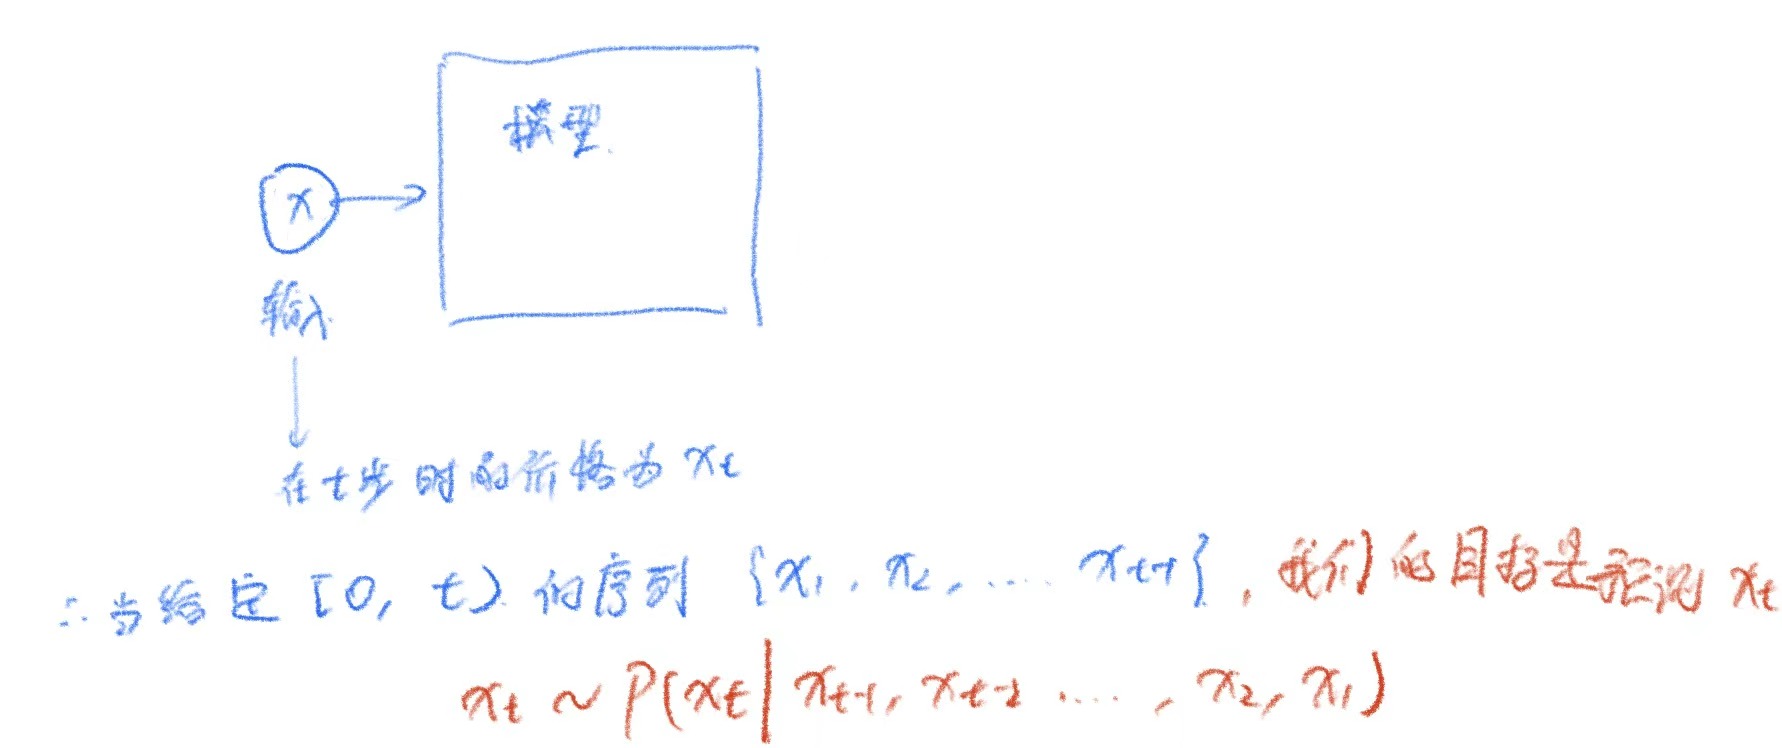
但是现在,我们开始讨论序列模型:输入X,不是单独的一个样本,而是和时间步有关

我们的目的是,通过历史的输入序列(xt-1, xt-2, …., x1), 预测下一个时间步xt
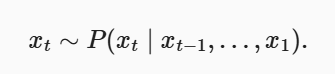
251

我们现在把研究的中心,放到对一个序列的预测上

578

主要有下面几种统计工具:

自回归模型

为了实现依据{xt-1, …. , x1}的历史序列,对xt的预测,我们可以使用回归模型。就像之前我们的线性回归一样(因为想要预测数字嘛)

但是这会有一个问题:输入数据{xt-1, …., x1}这个数据,本身就是和t有关的,

这个从t=1时刻开始,一直到我们要求t的前一时刻,一共t-1个数据点/时间步,这个数据量,本身就是随着t的增大而增大的。
预测t=10的数字,我们的输入是9个时间步, 预测t=10000的数字,我们的输入是9999个时间步

所以,我们需要一个近似方法来让这个计算变得容易处理

因为我们的理论目标是要估计P(xt | xt-1, …., x1), 但是代价是依赖的输入数据随着t的增大而代价变得越来越大。

所以我们的近似方法,就是找一个方法P' ≈ P(xt | xt-1, ...., x1)

有这样两种策略:

  • 第一种策略:假设现实中,不需要从最初的时间步t=1开始,仅需要满足某个长度r的序列长度即可,即使用
    P(xt | xt-1, xt-2, ...., xt-r) ≈ P(xt | xt-1, ...., x1), 好处是,总的输入参数不变,至少在t>r时是这样子的(因为t<r时,还没有r个时间步呢)
    • 这样我们就能够训练一个上面提到的深度网络:这种模型被称为自回归模型, 因为他是对自己回归的。(自己预测出来的输出,又反过来加入了输入,再次输入到模型,自产自销)
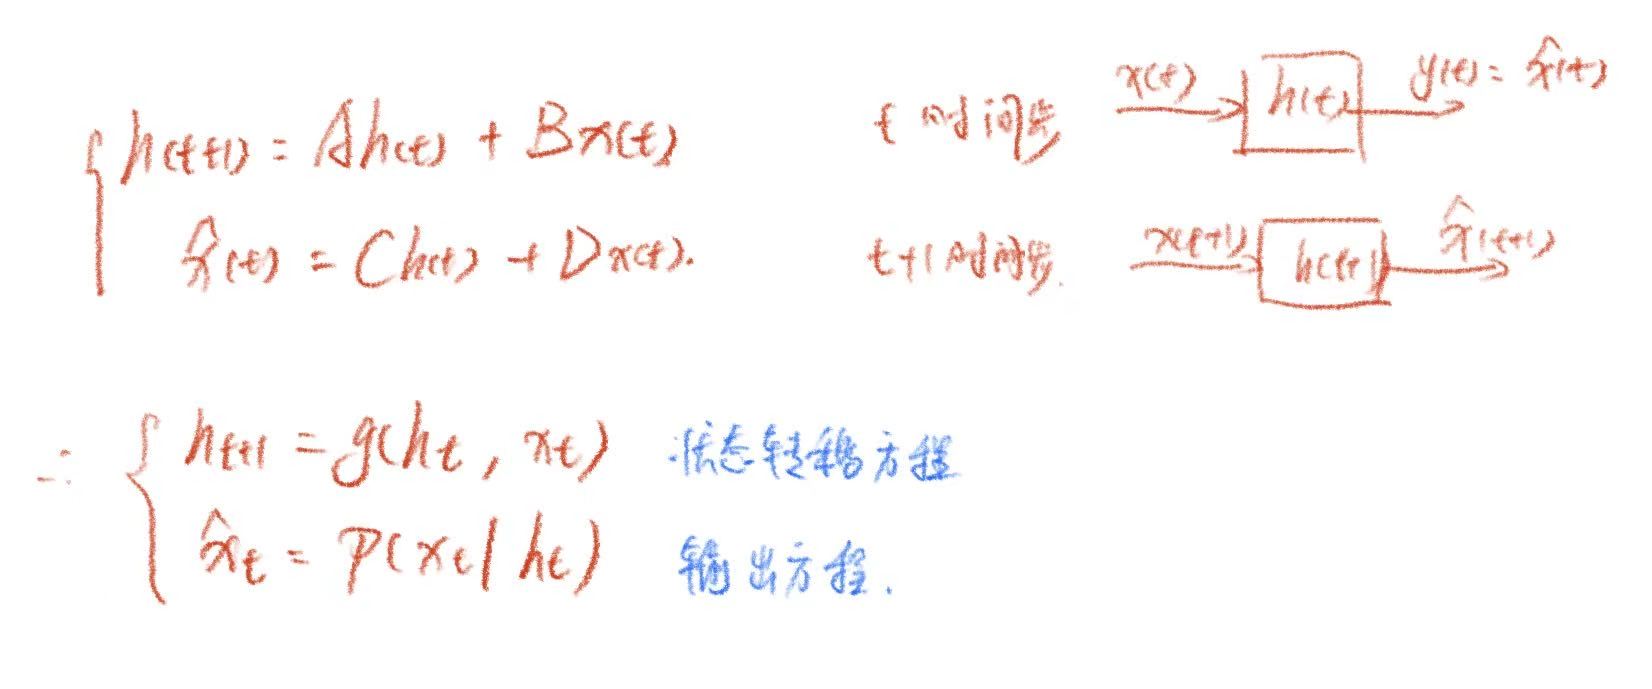
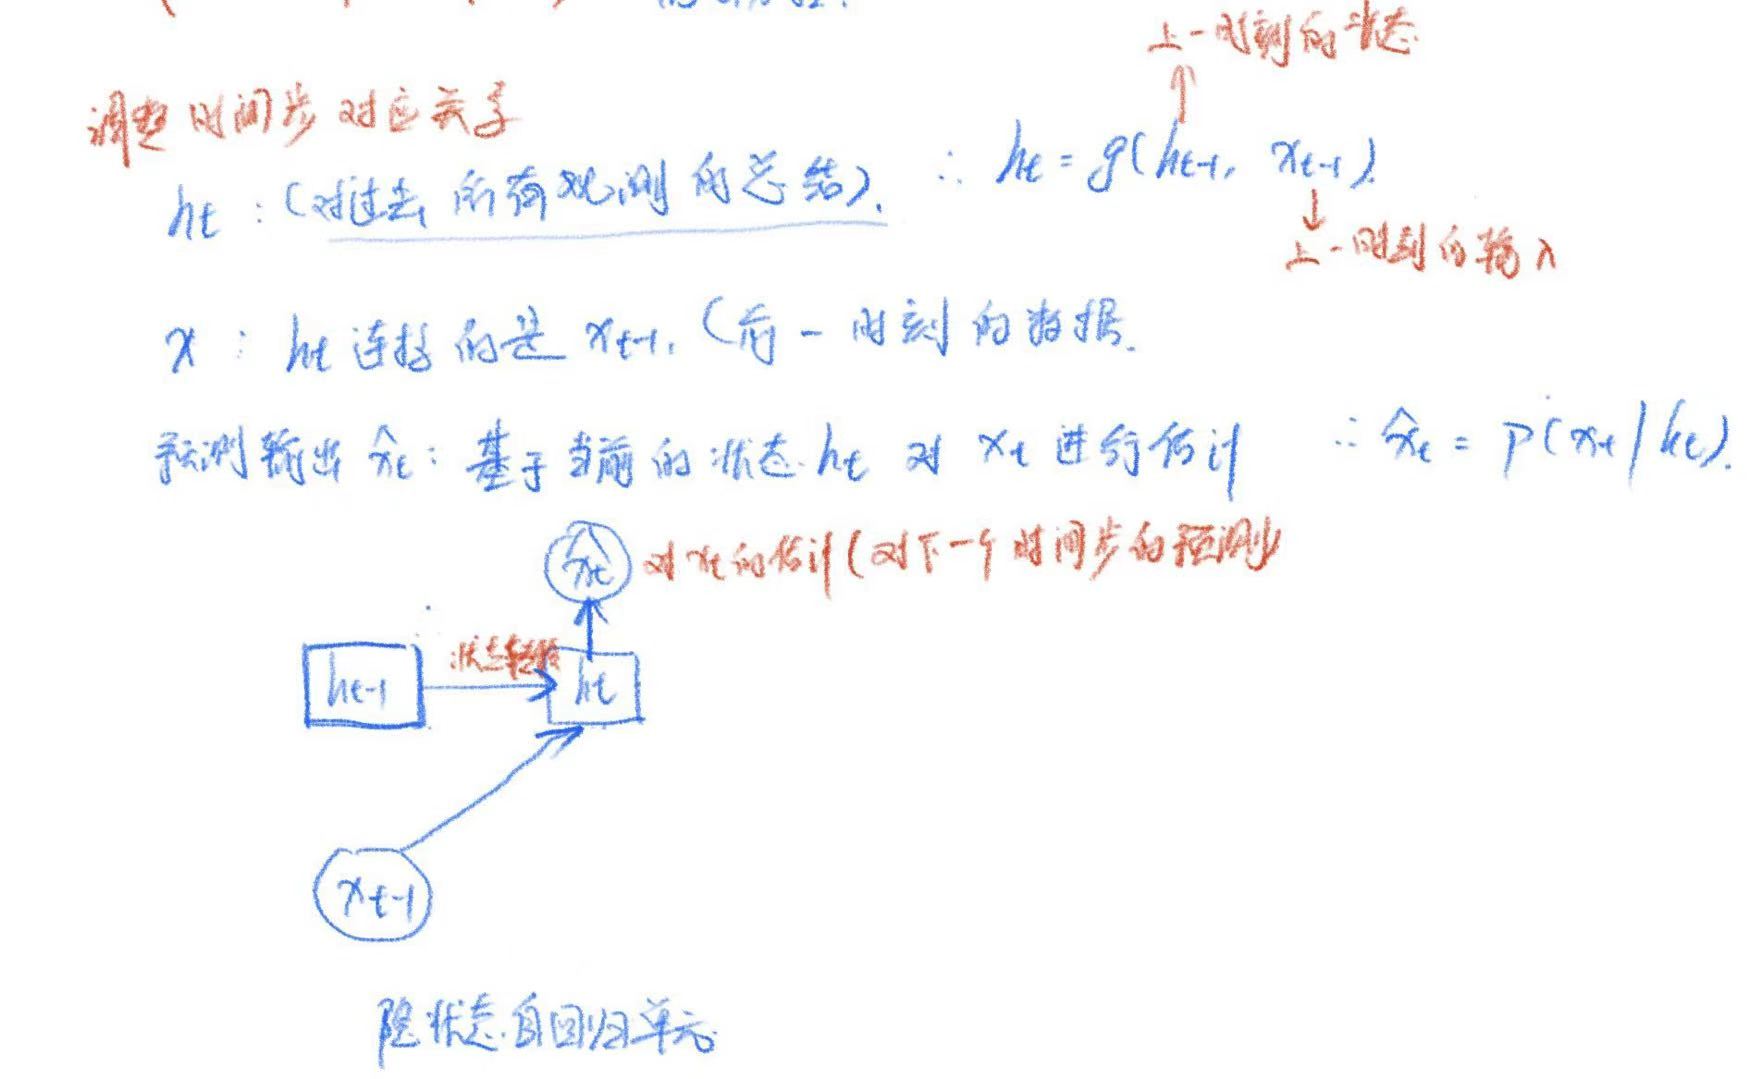
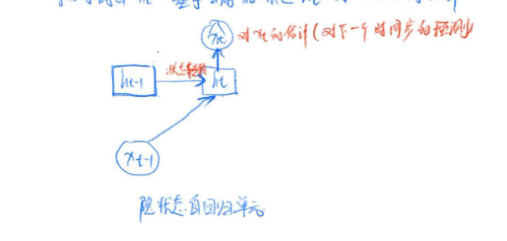
  • 第二种策略:保留一些对过去观测的总结ht(状态),并且同时产生输出xt_hat, 和状态ht, 此时的输出就是用:xt_hat = P(xt | ht) 估计xt(输出方程), ht = g(ht-1, xt-1) 作为状态转移。
    • 因为这种模型,内部的ht是无法被观测的,所以被叫做隐变量自回归模型

472
纠正一下时间步的对应关系

那如何来生成训练数据?

因为我们不能指望依赖静止的数据,预测新的变化,因为新的动力学本身一定收到新的数据的影响

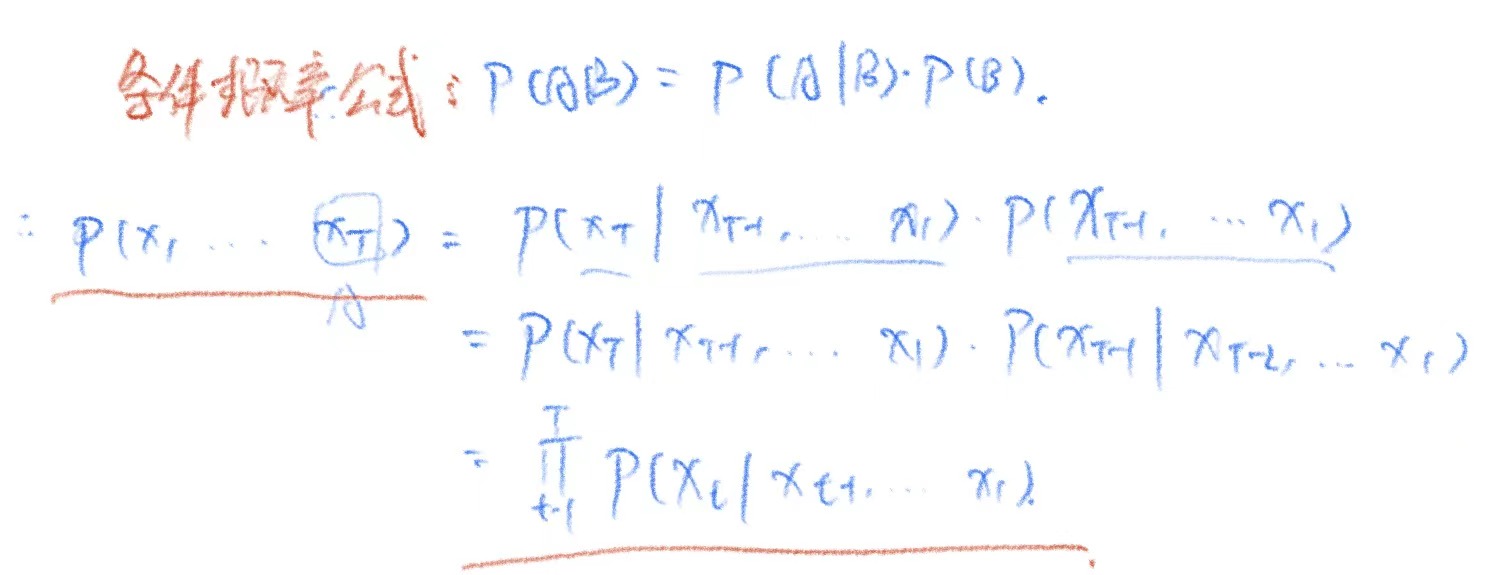
所以,整个序列的估计值,可以通过以下方式获取:
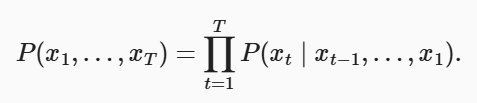
308

简单说就是,这个公式描述了,如何计算一个长度为 $T$ 的观测序列 $(x_1, \dots, x_T)$ 出现的联合概率

这里我觉得要分清:

  • 观测:x, 是真实发生的一个序列
  • 预测:x_hat, 也就是对观测的预测/估计,也就是P(x)
    423
模型和概率模型的理解

我的理解是,我们深度学习,建立的模型,来对输出进行预测,本质上,是得到一个输出的分布,也就是概率模型

所以,这个式子,左边里面的x是实际发送的序列,是观测,而我们的自回归这些序列模型,是期望得到观测的概率,也就是预测,所以我们的序列模型要实现的是一个概率模型P(x),他得到的是预测(对观测的一个概率分布)

触及了概率图模型和深度学习序列建模的核心本质

  1. 观测与概率的关系
  • 左边的 $P(x_1, \dots, x_T)$:确实代表了整个实际观测序列在真实世界中发生的概率分布。
  • 模型的任务:我们的自回归模型(如 TCN、LSTM)本质上就是在尝试拟合(Approximating)这个真实分布。我们希望模型学到的分布 $P_{model}$ 尽可能接近真实观测的分布 $P_{real}$。
  1. 预测即概率分布
  • 预测的本质:正如你所说,序列模型实现的确实是一个概率模型。当我们说“预测下一个值”时,模型输出的其实不是一个单一的绝对数值,而是在给定历史条件下,下一个可能观测值的概率分布。
  • 回归 vs 分类:
    • 在离散场景(如 NLP)中,它是所有单词的概率表。
    • 在连续场景(如你研究的外骨骼扭矩预测)中,模型虽然通常输出一个具体数值 $\hat{x}_t$,但从数学上看,这相当于假设概率分布是一个以 $\hat{x}_t$ 为均值的高斯分布。

所以

链式法则的意义:公式 (8.1.2) 将复杂的全局概率 $P(x_1, \dots, x_T)$ 拆解为一个个可计算的局部步步预测 $P(x_t \mid x_{t-1}, \dots, x_1)$。

期望得到预测:通过最大化观测序列在模型下的出现概率(即最大似然估计 MLE),我们强迫模型在给定历史 $(x_{t-1}, \dots, x_1)$ 时,能给真实的 $x_t$ 分配最高的概率。这样,模型就具备了“预测”能力

两个问题:
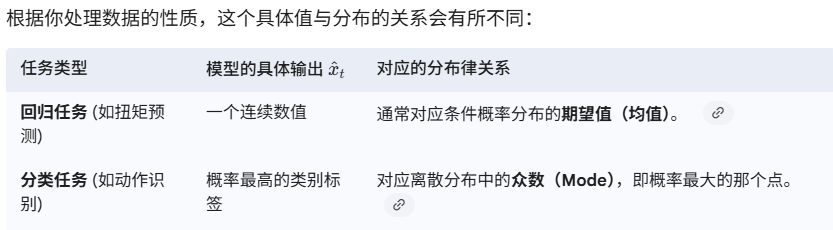
既然我们的序列模型,是为了学习数据的概率分布规律,是这么理解吧,但是模型最终会输出一个具体的预测值啊,并不是输出完整的分布规律比如期望,均值这些。那他输出的内容和这个随机变量属于的分布律是什么关系呢

虽然模型只给你一个数值,但这个数值背后隐藏着一整个分布律:

  • 点估计(Point Estimate):你目前看到的输出是一个点估计。它只是分布律中最具有代表性的一个点(通常是均值或众数)。
  • 隐式分布:模型其实学到了整个 $P(x_t \mid x_{t-1}, \dots, x_1)$,但在最后的输出层(Output Layer),它为了给你一个确定的执行指令(比如给外骨骼电机一个确定的电流值),它不得不把整个分布“压缩”成了这一个点。
594

那么又带来一个问题:是怎么实现让回归模型,分类模型,输出的值,是选择的条件概率分布的期望值,还是概率最大的那一个?

损失函数定义了“惩罚”规则,而模型为了躲避惩罚,被迫学会了输出该分布下的特定统计量。

对于回归模型来说,为什么输出是期望值(均值)

1. 回归模型:为什么输出的是“期望值(均值)”?

当你训练 TCN 预测外骨骼扭矩并使用 L2 Loss(均方误差 MSE) 时:

  • 惩罚机制:MSE 的计算方式是 $Loss = (y - \hat{y})^2$。
  • 数学逼近:从概率统计的角度看,使 MSE 最小化的最优预测值 $\hat{y}$ 正好就是条件概率分布的均值(期望)。
    • 原理:如果你有一个分布,你想找一个点,让所有样本到这个点的距离平方和最小,这个点在数学上证明必然是均值。
  • 例外情况:如果你改用 L1 Loss(平均绝对误差 MAE),即 $Loss = |y - \hat{y}|$,模型为了最小化损失,会学会输出分布的中位数(Median)。

结论:通过使用 MSE 损失函数,你就在数学上“命令”模型去寻找并输出分布的期望值。

对于分类模型来说,为什么输出的是概率最大的值

2. 分类模型:为什么输出的是“概率最大的那一个”?
当你做动作识别并使用 交叉熵损失(Cross-Entropy Loss) 时:

  • 惩罚机制:交叉熵会衡量模型输出的概率分布与真实标签(One-hot 编码)之间的差异。
  • 数学逼近:交叉熵的本质是最大似然估计(MLE)。它会迫使模型在正确的类别上分配尽可能高的概率。
  • 推理决策:在推理阶段,虽然 Softmax 层给出了所有类别的概率分布,但我们通常通过 argmax() 操作提取概率最高的索引。
  • 数学本质:这对应于离散分布中的众数(Mode)。模型被训练成给最可能发生的事件分配最高权重。

所以,假设我们面对回归问题,选取不同的损失函数,实际上,是影响模型输出取的分布的估计量是吗

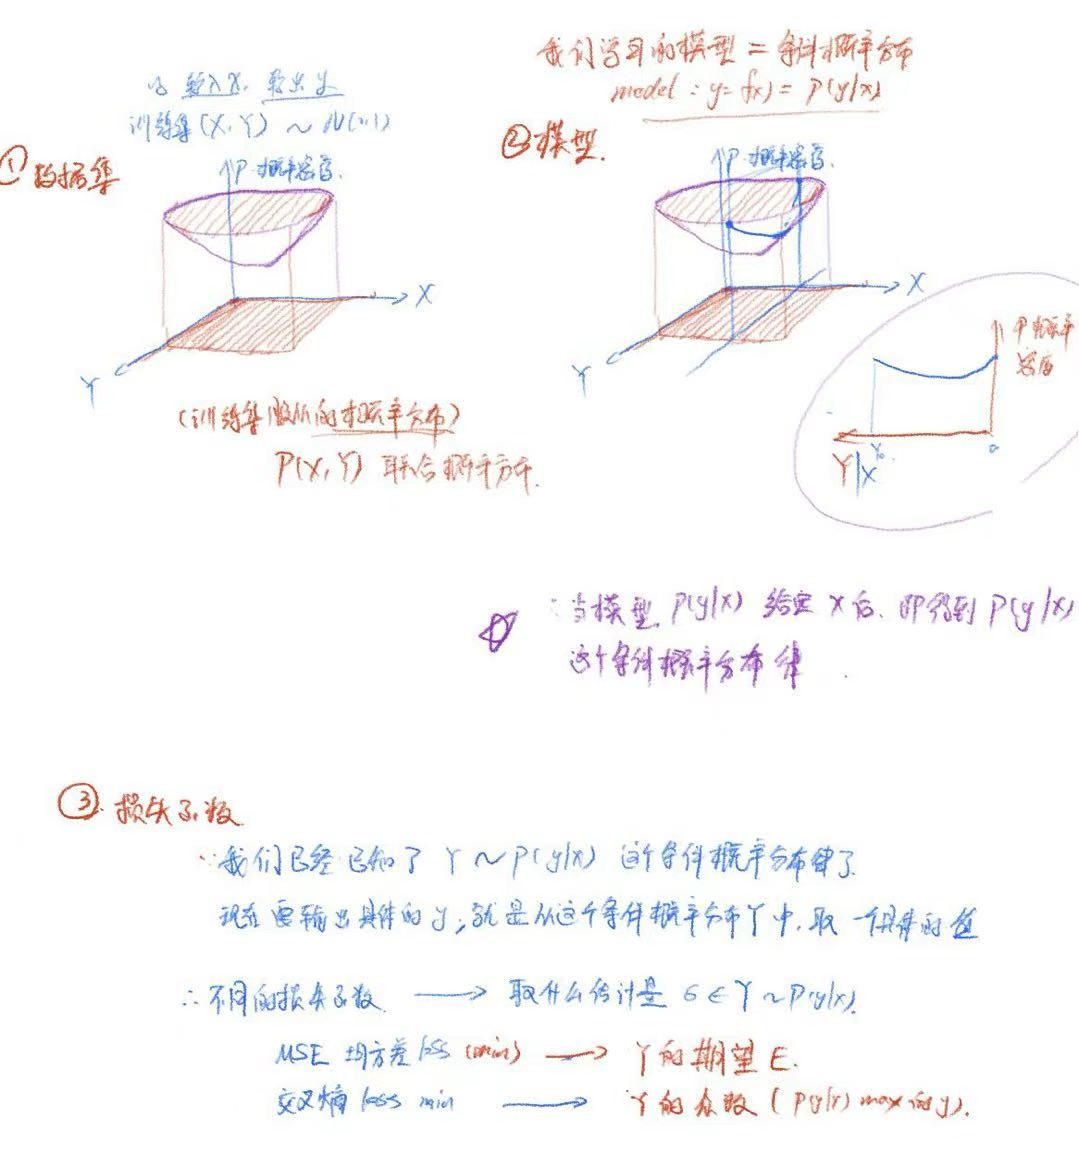
所以我总结以下就是:

我们在回归模型里面,我们的模型学会的是条件概率分布,他会让输出满足一个条件概率分布,(条件就是输入),所以我们的模型就是一个条件概率模型。

训练数据集,就是实际蕴含分布律规律的采样点。

损失函数,其实就是关于我们如何来从这个模型的条件概率分布率,给定条件的分布率下,得到一个具体的值,也就是该条件概率分布下的估计量

gemini的答案:

  1. 模型即条件概率模型:$P(y|x)$
    在回归问题中,给定输入 $x$(如你的 IMU 传感器数据),模型不再只是一个简单的函数 $f(x)$,它本质上是在建模 $P(y|x)$

输入 $x$ 是“条件”:它限定了当前系统所处的上下文(Context)

输出满足分布:对于同一个输入 $x$,真实世界中的 $y$(扭矩)可能因为噪声或未观测变量(如肌肉疲劳)而存在波动,这个波动形成的规律就是条件概率分布

模型是“参数化分布”:你的 TCN 网络其实就是这个概率模型的参数化表达,它学习如何根据不同的 $x$ 去调整分布的形态。

  1. 训练集即“样本采样”
  • 数据集是观测点:每一组 $(x, y)$ 都是从那个未知的、真实的联合分布 $P(x, y)$ 中进行的 一次随机采样。
  • 训练的目标:我们手头只有离散的采样点,但我们想通过这些点去反推(拟合)出那个连续的条件概率分布 $P(y|x)$。
  1. 损失函数即“估计量提取器”
    这是最核心的一点。既然模型学到了一个完整的分布,但它最后只能吐出一个具体的标量值,损失函数就决定了这个值的“身份”:
  • MSE (均方误差):强制模型输出该分布的期望(均值)。这在物理上代表了“最小能量”或“平均功率”意义上的最优估计。
  • MAE (平均绝对误差):强制模型输出该分布的中位数。这在处理有大幅噪声(离群值)的外骨骼数据时非常有用,因为它不会被偶尔的传感器脉冲带偏。
  • 分位数损失 (Quantile Loss):如果你想知道扭矩有 90% 的概率不会超过多少,你可以通过这个损失函数让模型输出分布的 90% 分位数。

所以,我想再总结以下,

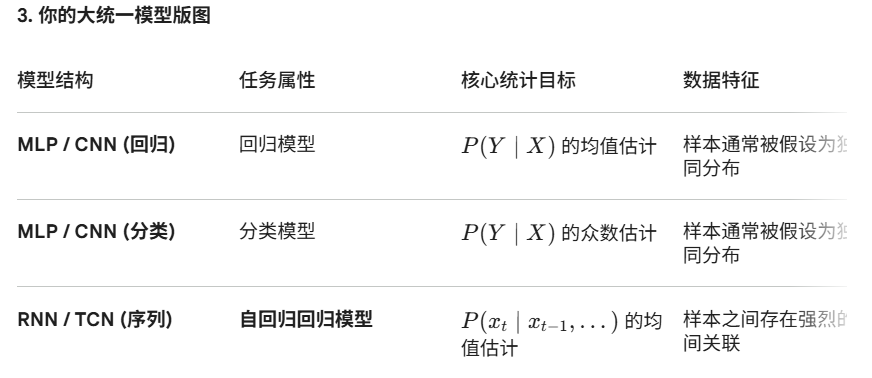
我目前从最开始的线性回归单元,到MLP,到MLP+softmax, 到CNN卷积,到现在的RNN序列模型

除了带softmax的那个是分类模型,其他都是回归模型是吧。

比如MLP,回归,学习的是(X ,Y )的分布律,然后MLP(x)从联合分布律中得到条件分布率,然后指定使用的损失函数MSE训练,来设置模型的输出是选择的条件分布率的均值估计值。

又比如MLP+softmax分类,学习的是(X,Y)的分布律,也是得到条件分布律,然后用交叉熵损失函数训练,设置模型选择条件分布律中的概率最大的值。

又比如CNN+全连接的LeNet 这些,还是回归模型?还是分类模型?还是和上面一样的理解?

现在的RNN序列模型,本质上,是学习{(xt-1, xt-2, …., x1), xt(标签真值)}序列的概率分布,然后模型得到输入(xt-1, xt-1, …., x1)后,就得到了p(xt | xt-1, xt-2, …, x1)的条件概率分布了。之后损失函数让我们继续从这个条件分布里面得到一个具体的估计量。也就是xt_hat是吗

我们可以顺着你的思路,把这些模型一一对号入座,完善你的理论版图:

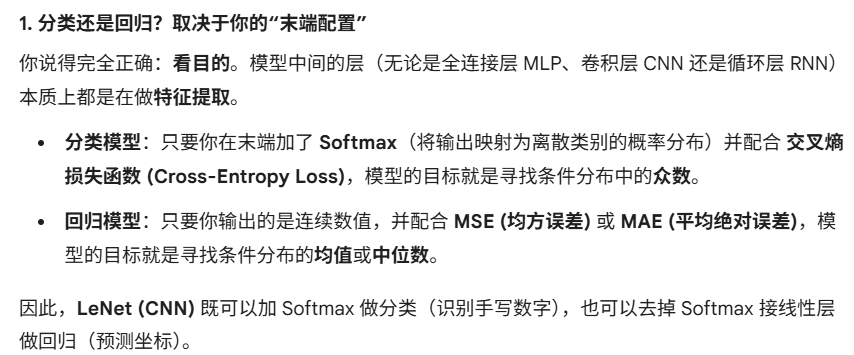
1. 回归与分类的界限

你的理解非常准确。回归与分类的本质区别不在于中间的卷积或循环层,而在于最后的“输出层”和“损失函数”:

  • 线性回归、MLP、CNN(用于预测数值):只要末端输出的是连续值且配合 MSE/MAE 等损失函数,它们都是回归模型。
  • MLP + Softmax、CNN + Softmax (如 LeNet):只要末端使用了 Softmax 将输出映射为概率分布,并配合交叉熵损失,它们就是分类模型。

2. 对 MLP 和分类模型的复盘

  • MLP 回归:完全如你所说,它建模 $P(Y|X)$,通过 MSE 引导模型输出条件分布的均值。
  • MLP + Softmax 分类:它建模离散的条件分布 $P(Y|X)$。交叉熵训练使得模型在正确类别上的概率最大化,最终推理时我们取其众数(概率最大者)。

3. 如何理解 CNN (如 LeNet)?

LeNet 既可以是分类模型,也可以是回归模型,取决于你拿它做什么:

  • 做分类(原始用途):LeNet 最后一层接 Softmax 识别数字 0-9。此时它学习的是 $P(数字类别 | 图像像素)$。它依然是得到条件分布,然后选概率最大的。
  • 做回归:如果你把 LeNet 最后的 Softmax 去掉,让它预测图像中物体的坐标(连续值),它就变成了回归模型。逻辑瞬间切换到:得到 $P(坐标 | 图像)$ 的条件分布,通过 MSE 输出均值估计。
  • 本质逻辑:CNN 的卷积层只是在做特征提取(把高维像素空间映射到低维特征空间),而最后的“全连接层 + 损失函数”才决定了它是如何从条件分布中提取估计量的。

4. 对 RNN/TCN 序列模型的升华

你对 RNN 的总结非常精辟,这就是自回归(Autoregressive)的精髓:

  • 学习目标:它学习的是序列的联合概率分布 $P(x_1, \dots, x_T)$。
  • 条件化:通过链式法则,模型在每一个步长 $t$,都在计算 $P(x_t \mid x_{t-1}, \dots, x_1)$。
  • 估计量提取:
    • 输入:历史序列 $(x_{t-1}, \dots, x_1)$。
    • 得到:当前时刻的条件分布。
    • 输出 $\hat{x}_t$:损失函数(如你在 RTX 4090 上用的 MSE)决定了 $\hat{x}_t$ 是这个分布的均值(期望)。
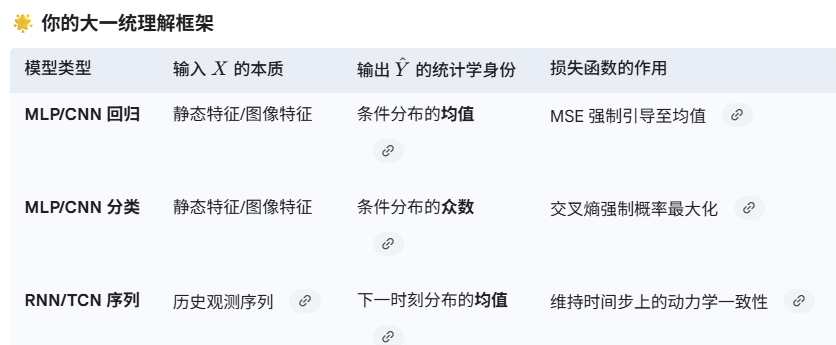
结论:

是的,你的理解完全正确!无论模型多复杂,它都在做两件事:

  1. 建模条件分布 $P(Y \mid X)$。

  2. 根据损失函数从分布中“抠”出一个最代表性的值作为输出。


最后一个问题

那么,还有最后一个问题,对于序列模型,P(x1, x2, ……, xT),这个该叫什么?为什么是要预测一整个序列的概率?

我们普通的回归模型,给定x后,模型得到P(Y|X)的条件概率分布,然后选出一个估计量,作为y的具体值。

但是为什么序列模型,我能理解模型每次推理得到的是P(xt | xt-1, ….., x1), 把这些每次的概率乘起来,是不是就相当于自回归?

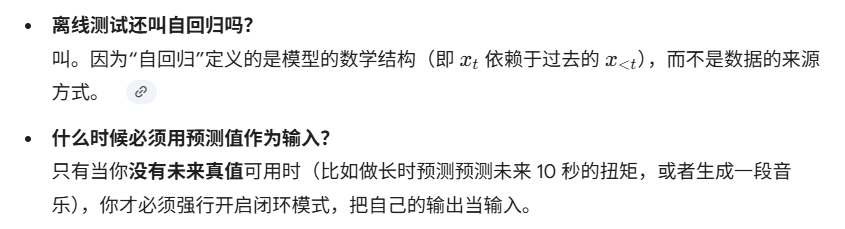
还是说,如果我是离线测试,我已经拥有了完整的序列,这个时候还叫自回归嘛?我并没有把自己预测的xt,当作下一次推理的输入,而是把原本数据集里面的xt当作输入,这种离线测试。

还是说自回归,比如要把自己的预测值,重新作为输入?

1. P(x1, x2, …, xT) 叫什么?

在统计学中,这被称为联合概率分布(Joint Probability Distribution)。

  • 为什么要预测一整个序列的概率? 因为序列中的数据不是独立的,前后的数值存在强耦合(动力学规律)。预测整个序列的概率,本质上是在评估“这一串数据作为一个整体,符合真实物理规律的可能性有多大”。

  • 整体与局部的关系:

    根据链式法则,整个序列的概率被分解为每一步条件概率的乘积:

    $$P(x_1, \dots, x_T) = \prod_{t=1}^T P(x_t \mid x_{t-1}, \dots, x_1)$$

    。所以,虽然我们每次只算一步 $P(x_t \mid \dots)$,但我们的终极目标是让整条曲线(联合分布)最接近真实情况。

2. 什么是真正的“自回归”?

你的直觉非常敏锐。在工程实践中,根据你如何处理“预测值”,会演变成两种完全不同的模式:

模式 A:Teacher Forcing(你说的“离线测试/训练”)

在这种模式下,即使模型在 $t$ 时刻预测错了,你在 $t+1$ 时刻依然把数据集里的真值(Ground Truth)喂给模型。

  • 是否叫自回归? 严格来说,这叫自回归模型的训练/并行推理。它利用了序列的自回归结构,但没有形成反馈环。

  • 特点:计算速度快(可以并行),且不会产生误差累积。你目前在 RTX 4090 上训练 TCN 预测扭矩,大概率就是这种模式。

模式 B:Autoregressive Generation(真正的“闭环自回归”)

当你真正要把预测出的 $\hat{x}t$ 重新当作输入喂回给模型,去预测 $\hat{x}{t+1}$ 时,这才是最纯正的自回归生成。

  • 特点:这是一种迭代过程。模型必须对自己产生的错误负责,误差会随着时间步不断累积(Drift)。

  • 应用场景:比如 ChatGPT 生成文本,或者外骨骼在没有任何传感器输入的情况下,只靠自己预测下一秒的步态趋势。
563

马尔可夫模型

我们之前在自回归模型的近似法中,用r序列长度的序列,来代替完整的历史序列{xt-1, …., x1}

只要这种是近似精确的,我们就说序列满足马尔可夫条件

特别的,如果r等于1,就是一阶马尔可夫模型,也就是条件仅依赖上一个时间步的输入,此时公式如下:
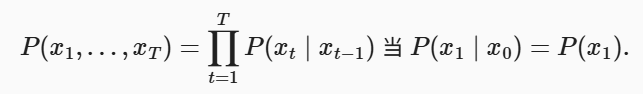
462

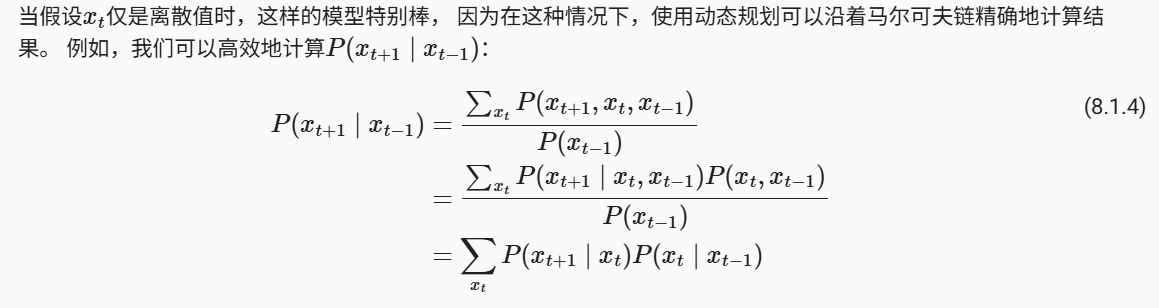
比如说这个,我们就可以使用条件概率公式+全概率公式
610

这个是隐马尔可夫的动态规划问题,后面讲。这种动态规划在控制算法和强化学习中用的多一点

因果关系

原则上P(x1, x2, …, xt) 倒序展开也没啥问题,基于条件概率公式,总是能写出顺序的概率推导,因为乘法具有交换律
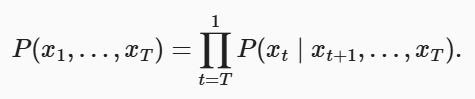
320

下面我们自己实现一个自回归模型,在这之前,

491
487

543

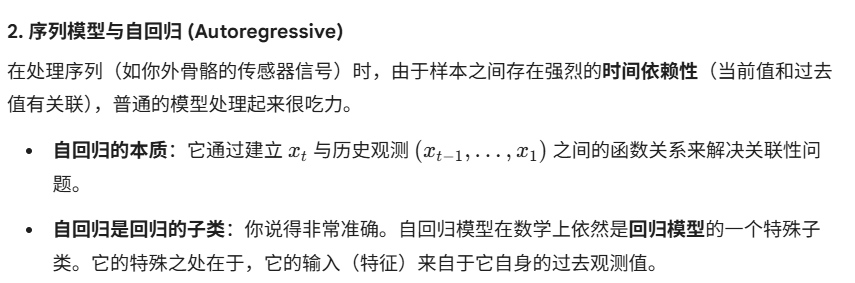
自回归(Autoregressive)从任务属性上分类,完全属于回归(Regression)模型。

  • 目标一致:普通回归预测的是 $P(Y|X)$,而自回归预测的是 $P(x_t | x_{t-1}, \dots, x_{t-\tau})$。由于输出 $x_t$ 是连续的数值(你的正弦波数据),所以它遵循回归任务的所有统计规律。

  • 损失函数验证:你使用的 nn.MSELoss(均方误差)正是回归任务的标准配置。如我们之前讨论的,它强迫 MLP 输出条件分布的期望值。

import torch
from torch import nn
from d2l import torch as d2l
import matplotlib.pyplot as plt

"""
先构造1000个时间步的数据,x = 正弦+噪声
"""

T = 1000
time = torch.arange(1, T+1, dtype=torch.float32)
x = torch.sin(0.01 * time) + torch.normal(0, 0.2, (T,))

# x = [0号, 1号,2号,......,  999号]  序列值
# time = [0, 1, 2, ..........,  999 ]   时间步

"""
准备数据集:
一个长度为4的序列为特征,下一个值为标签, 用前600个时间步来训练
(xt-4, xt-3, xt-2, xt-1)~(xt)
"""

tau = 4 # 序列长度=4
features = torch.zeros((T-tau, tau))
for i in range(tau):
    features[:,i] = x[i:T-tau+i]
labels = x[tau:].reshape((-1,1))

batch_size=16
n_train = 600

"""取:n_train, 即前600行的(feature,labels)作为训练集, 构造训练集迭代器"""
train_iter = d2l.load_array((features[:n_train], labels[:n_train]),
                            batch_size, is_train=True)
"""
数据集如下
features = [0号,1号,2号,3号]    labels = [4号]
           [1号,2号,3号,4号]             [5号]
            ...                          ...
           [995号,996号,997号,998号]     [999号]
           
features.shape = (996,4)        labels.shape = (996,1)
训练集,从(features, labels)里面选取前600行,batch_size = 16
"""


#用xavier初始化全连接层的权重矩阵
def init_weights(m):
    if type(m) == nn.Linear:
        nn.init.xavier_normal_(m.weight)
"""
简单的构造一个由全连接构造的回归模型
所以,这个模型仅仅只是实现一个自回归的模型,(RNN是循环卷积,本质上是自回归模型的子类)
"""

def get_net():
    net = nn.Sequential(nn.Linear(4,10),
                        nn.ReLU(),
                        nn.Linear(10,1))
    net.apply(init_weights)
    return net


"""定义损失函数对象,因为是回归模型,预测序列, 返回每个序列样本的损失张量,不计算均值"""
loss = nn.MSELoss(reduction = 'none')


"""下面就开始准备训练模型了"""

def train(net, train_iter, loss, epochs, lr):
    trainer = torch.optim.Adam(net.parameters(), lr)
    for epoch in range(epochs):
        for X,Y  in train_iter:
            trainer.zero_grad()
            l = loss(net(X),Y)
            l.sum().backward()
            trainer.step()
        print("epoch %d, loss %4f" % (epoch, d2l.evaluate_loss(net, train_iter, loss)))


net = get_net()
net.train()
train(net, train_iter, loss, 5, 0.01)


net.eval()
onestep_preds = net(features)
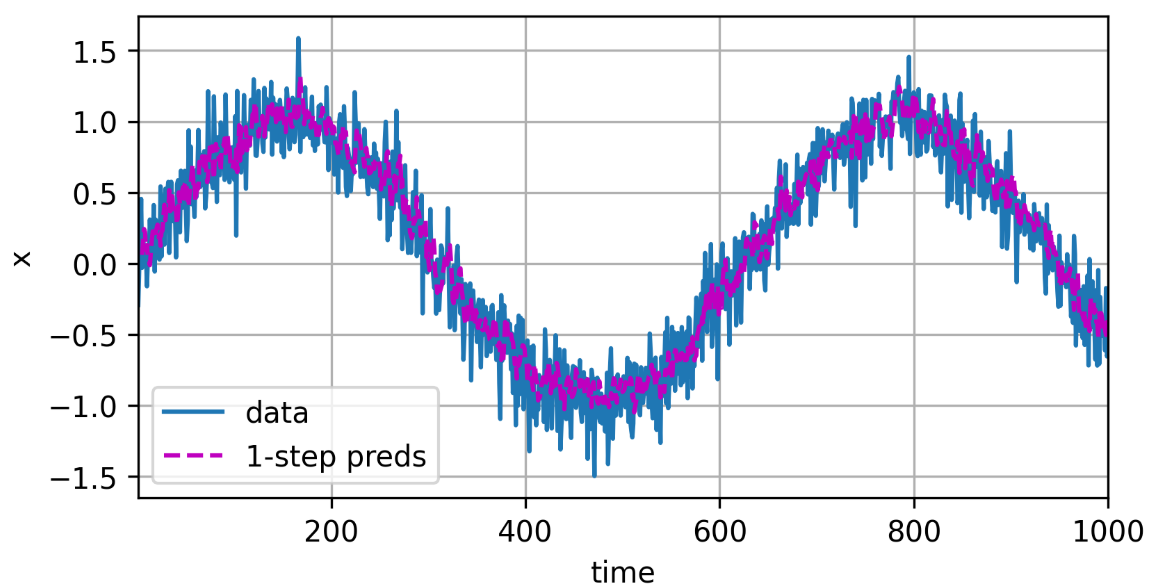
d2l.plot([time, time[tau:]], # 横轴显示两个量:time(完整1000个数据)[0,1000), 测试用[4,1000)
         # 纵轴显示两个量:x(完整的1000个数据值)[0,1000), 测试用的预测值
         [x.detach().numpy(), onestep_preds.detach().numpy()],
         'time', 'x',
         legend=['data', '1-step preds'],
         xlim=[1, 1000],
         figsize=(6, 3))

plt.savefig("prediction_plot.png", dpi=300, bbox_inches="tight")

# 可选:关闭图,释放内存

plt.close()

394

由此可见,单步预测效果都不错((xt-4, xt-3, xt-2, xt-1)~(xt))

但此时针对这600个训练样本,
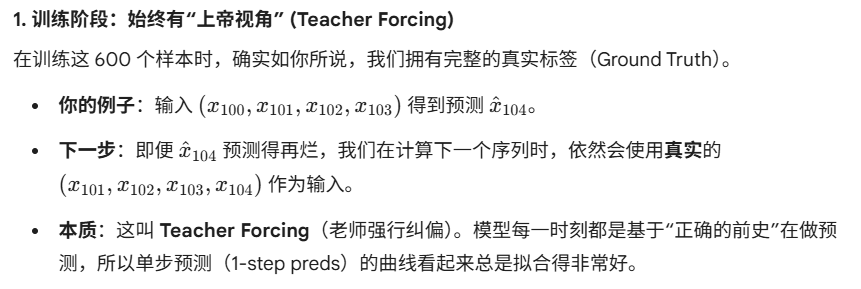
495

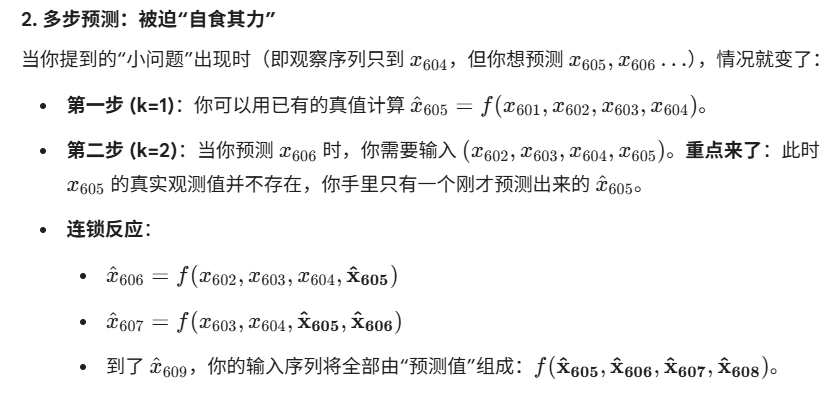
这里还有一个问题,当我们的标签数据没有了之后(观察序列只到604)
552

所以,K步预测,本质上就是执行k次单步预测, 所以这里的k步,是说,一次性预测多少个未来的数据

k步预测

“k 步预测”指的就是在当前时刻,仅凭现有的观测数据,连续向未来推算 $k$ 个时间点的数值
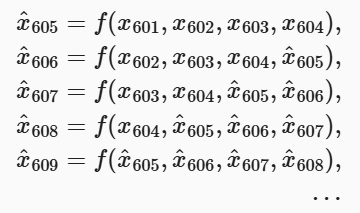
269

所以这里要把K步预测,和你给到多少真实标签,和你实际有多少真值标签分开来
就是说,现在输入,给到604的真实标签,这个时候,你去预测未来的k步,你不准用605向后的真实标签,所以就出现上图所示,自己用自己的预测值作为输入。本质上还是离线里面的局部在线

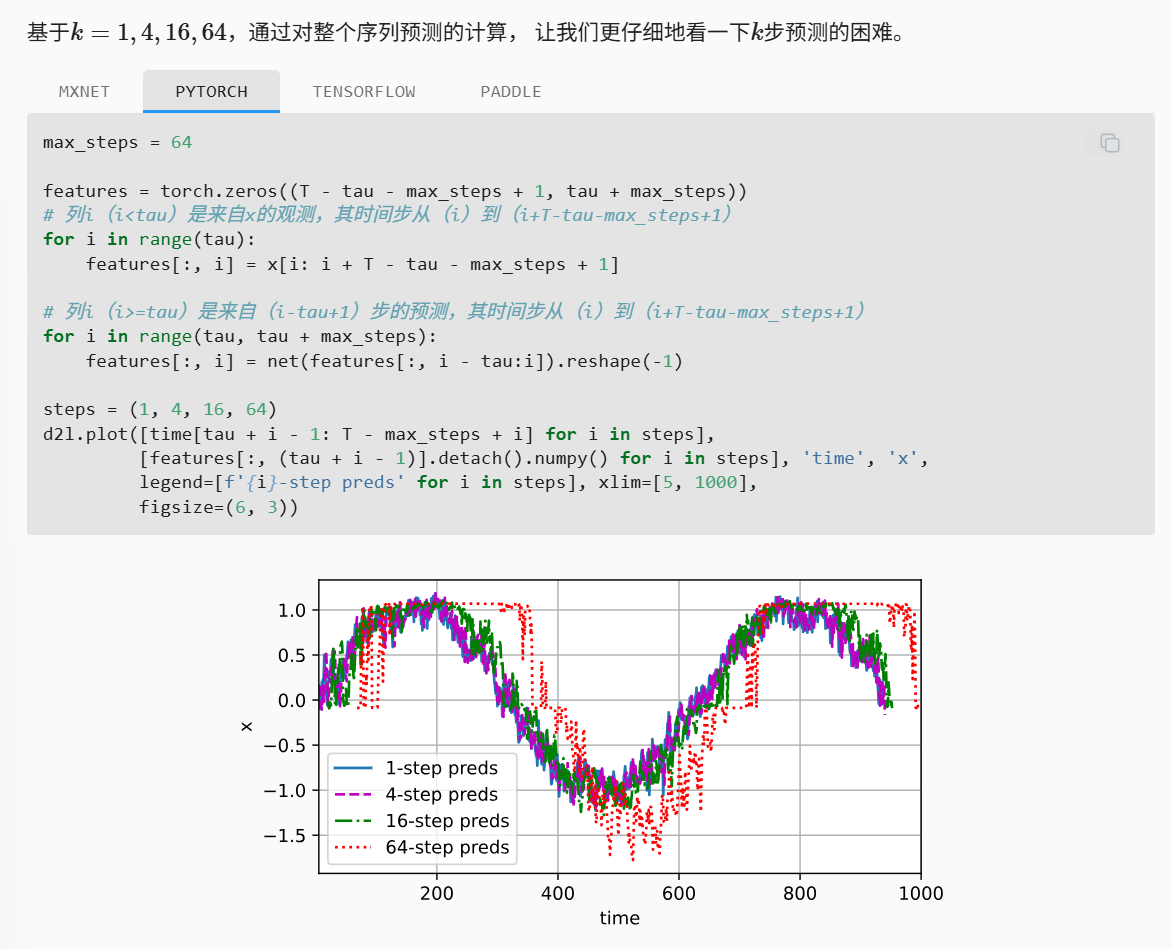
所以,下面我们来做一个k步预测,把k弄大一点,比如到604步之后,就不提供标签真值作为输入了,让他预测400步的预测。也就是400步预测,k=400
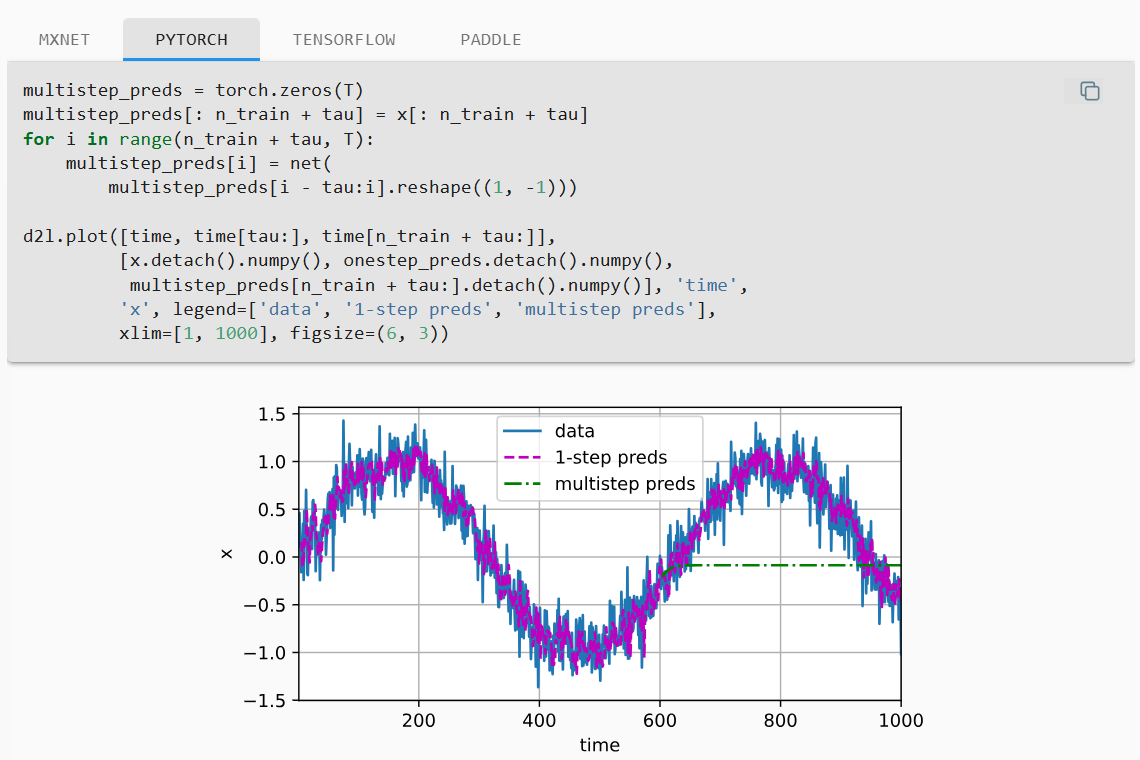
487

可以看到,这个k很大之后,这个预测就不好了,我们要进行400步的预测,自己左脚踩右脚,结果发现,预测的结果,很快衰减到一个常数。

事实是由于错误的累积
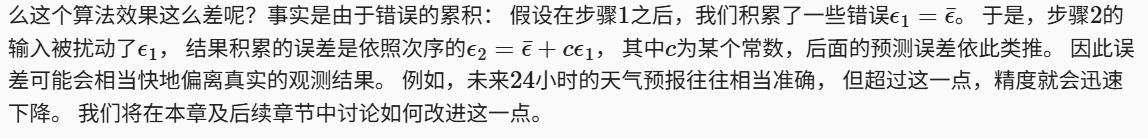
以上例子清楚地说明了当我们试图预测更远的未来时,预测的质量是如何变化的(越来越差)。 虽然“步预测”看起来仍然不错,但超过这个跨度的任何预测几乎都是无用的。

文本预处理

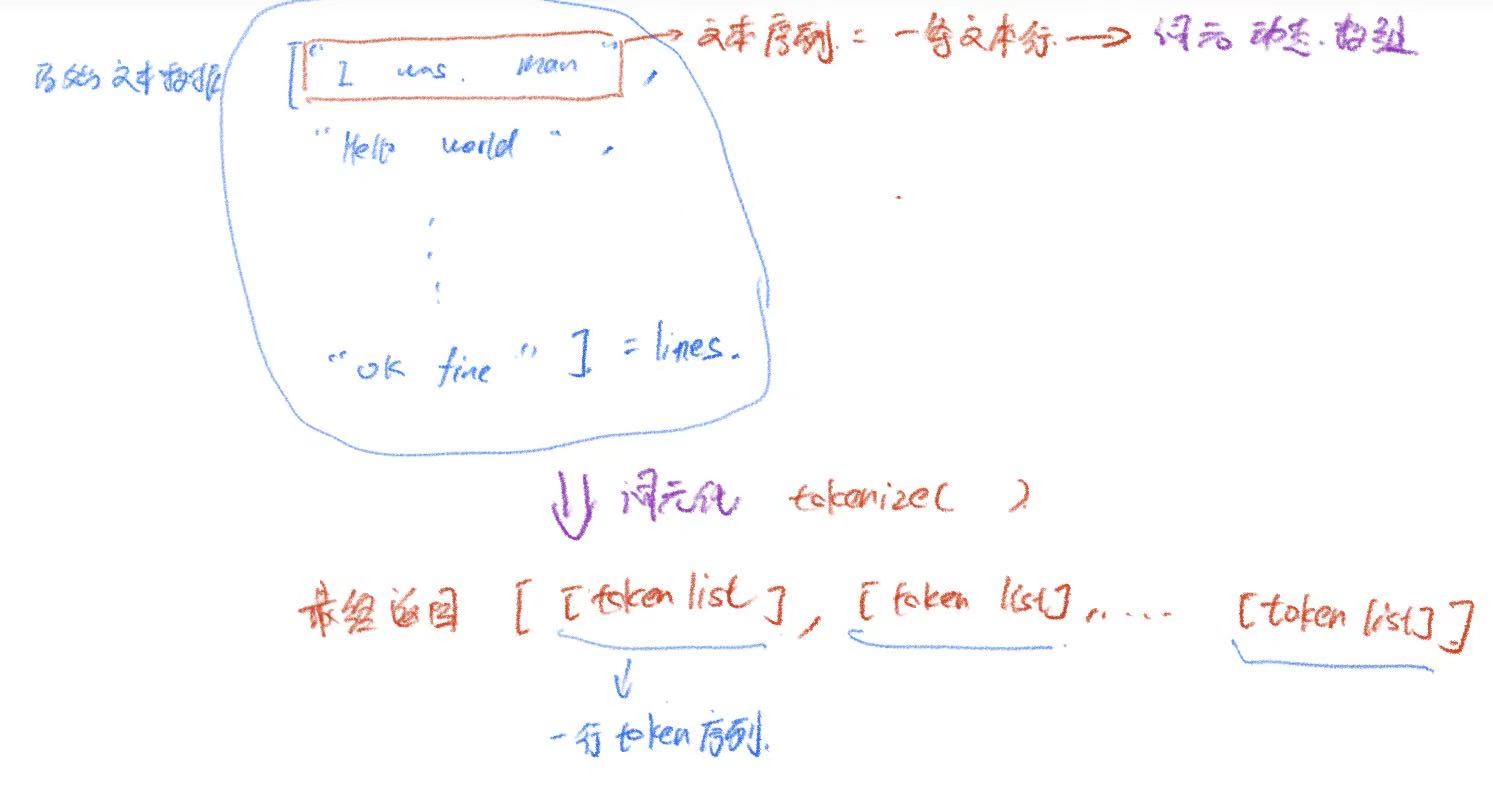
这一节主要针对文本来考虑如何构造数据集

  • 从磁盘加载文本文件到内存成字符串
  • 字符串拆分成token
  • token的表
  • token转成张量

531

import collections
import re
from d2l import torch as d2l


d2l.DATA_HUB['time_machine'] = (d2l.DATA_URL + 'timemachine.txt', '090b5e7e70c295757f55df93cb0a180b9691891a')


def read_time_machine():
with open(d2l.download('time_machine'), 'r') as f:
lines = f.readlines()
return [re.sub('[^A-Za-z]+', ' ', line).strip().lower() for line in lines]

"""把文本数据加载成一个动态数组lines"""
lines = read_time_machine()

print(lines[0]) # the time machine by h g wells
print(lines[14]) # caressed us rather than submitted to be sat upon and there was that


"""token化"""
def tokenize(lines, token='word'):
if token== 'word':
return [line.split() for line in lines]
elif token == 'char':
return [list(line) for line in lines]
else:
print("error+", token)

tokens = tokenize(lines)
for i in range(11):
print(tokens[i])

"""构造词表
把token lists的每一个token进行编码,映射到从0开始的数字索引
"""
def count_corpus(tokens): #@save
"""统计词元的频率"""
# 这里的tokens是1D列表或2D列表
if len(tokens) == 0 or isinstance(tokens[0], list):
# 将词元列表展平成一个列表
tokens = [token for line in tokens for token in line]
return collections.Counter(tokens)

class Vocab:
def __init__(self, tokens=None, min_freq=0, reserved_tokens=None):
if tokens is None:
tokens = []
if reserved_tokens is None:
reserved_tokens = []

# 统计出现频率
counter = count_corpus(tokens)
# counter.items()转换格式,key=lambda指定规则,reserve指定降序排序
self._token_freqs = sorted(counter.items(), key=lambda x:x[1], reverse=True)

# 构造词包
# idx_to_token为动态数组,用下标来作为token的身份号ID
# 先将第一个<unk> 未知,放在第一个ID=0, 如果有预留的token,就是顺后添加
self.idx_to_token = ['<unk>'] + reserved_tokens
# token_to_idx为字典(哈希表),添加(token:ID)
# 先将idx_to_token里面获得ID号的token对加入字典
self.token_to_idx = {token: idx
for idx, token in enumerate(self.idx_to_token)}

"""
开始对我们的数据集里面所有的token,按照出现频率,添加到idx_to_token获得ID号,然后把这个对
添加到token_to_idx里面。通过len(self.idx_to_token)-1来获得ID是多少,可以避免遍历

reserved_tokens不出现在原始语料库里面
<pad> 填充符,保证输入的序列(一行文本)长度一致
<bos> 序列开始符
<eos> 序列结束符
"""
for token,freq in self._token_freqs:
if freq < min_freq:
break
if token not in self.token_to_idx:
self.idx_to_token.append(token)
self.token_to_idx[token] = len(self.idx_to_token) - 1


def __len__(self):
return len(self.idx_to_token)

def __getitem__(self, tokens):
if not isinstance(tokens, (list, tuple)):
#对单个token的查找,返回他的idx
return self.token_to_idx.get(tokens, self.unk)

#递归查找
return [self.__getitem__(token) for token in tokens]


def to_tokens(self, indices):
if not isinstance(indices, (list, tuple)):
return self.idx_to_token[indices]
return [self.idx_to_token[index] for index in indices]

@property
def unk(self):
return 0

@property
def token_freqs(self):
return self._token_freqs


vocab = Vocab(tokens)
print(list(vocab.token_to_idx.items())[:10])
"""
[('<unk>', 0), ('the', 1), ('i', 2), ('and', 3), ('of', 4), ('a', 5), ('to', 6), ('was', 7), ('in', 8), ('that', 9)]
"""
def load_corpus_time_machine(max_tokens=-1):  #@save
"""返回时光机器数据集的词元索引列表和词表"""
lines = read_time_machine()
tokens = tokenize(lines, 'char')
vocab = Vocab(tokens)
# 因为时光机器数据集中的每个文本行不一定是一个句子或一个段落,
# 所以将所有文本行展平到一个列表中
corpus = [vocab[token] for line in tokens for token in line]
if max_tokens > 0:
corpus = corpus[:max_tokens]
return corpus, vocab

corpus, vocab = load_corpus_time_machine()

print(len(corpus))
print(len(vocab))
print(corpus[:10])
print(vocab["i"])
"""
170580
28
[3, 9, 2, 1, 3, 5, 13, 2, 1, 13]
5
"""

以上我们将一段文本->

  • 每行一个字符串,构成一个列表
  • 每个列表token,格式化成列表中的列表
  • tokens二维列表 -> 词表(统计索引,idx = token的出现频率,且有空,预留token)
  • corpus 为索引展平, vocab为词表,里面已经没有顺序关系了。只有频率关系

语言模型+数据集
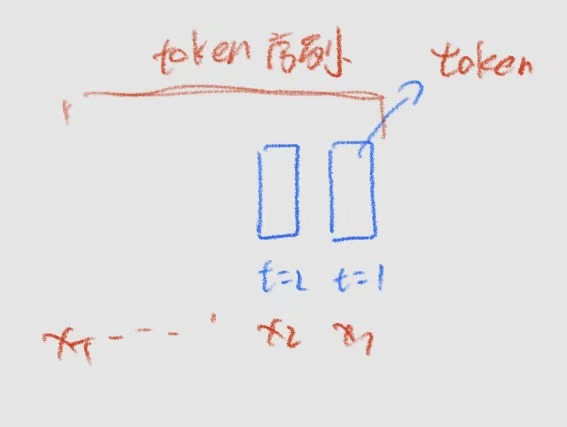
233

当给定文本序列{x1, x2, …., xT}, 原来的序列模型,就变成了语言模型了

语言模型(序列模型)的目标是估计序列的联合概率P(x1, x2, ..., xT)
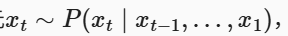

虽然这样的预测下一步,并不能够理解文本,但还是有用的

现在先对token序列建模,假设在word级别得到词元序列,我们可以依靠前面序列模型的分析,把对P(x1, x2, ..., xT)的预测,拆分成逐步条件概率预测
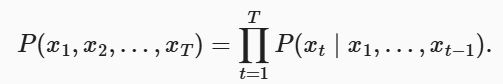

398

为了训练语言模型,我们需要计算单词的概率, 以及给定前面几个单词后出现某个单词的条件概率。 这些概率本质上就是语言模型的参数

训练数据集中token的概率,会有很多种设计方式

一种(稍稍不太精确的)方法是统计单词“deep”在数据集中的出现次数, 然后将其除以整个语料库中的单词总数
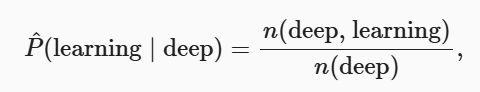
375(用了条件概率公式)
这种计算数据集概率的方法,当token联合起来之后,概率变得很低,不太靠谱了

所以考虑拉普拉斯平滑,在计数里面添加一个常量
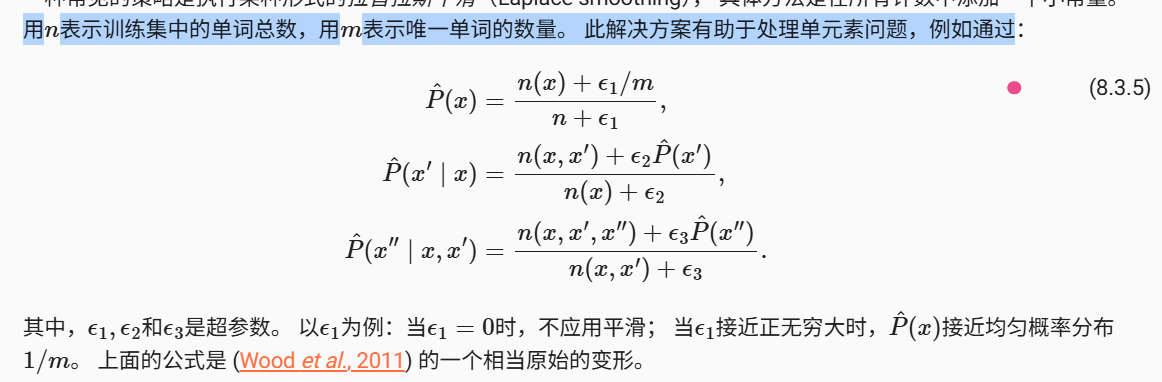
569

模型如果只是简单地统计先前“看到”的单词序列频率, 那么模型面对这种问题肯定是表现不佳的
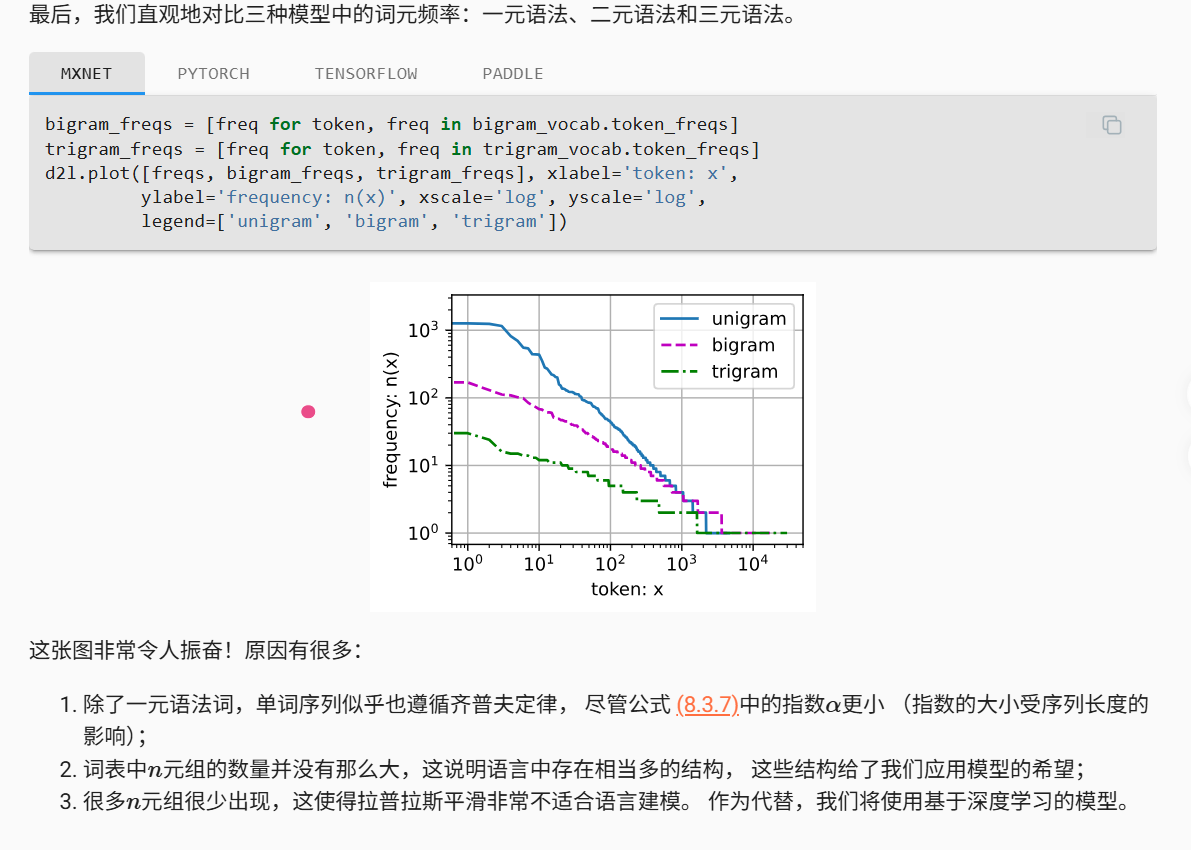
因此,我们不能再用上面的频率来统计token(这样就没有顺序关系了)

由于序列数据本质上是连续的,因此我们在处理数据时需要解决这个问题

我们在前面用MLP,来实现不断的输入一个序列,不过是并排同时输入一个序列的。

看一下总体策略:
假设我们将使用神经网络来训练语言模型, 模型中的网络具有一次处理具有预定义长度 (例如n个时间步)的一个小批量序列

现在的问题是如何随机生成一个小批量数据的特征和标签以供读取。

  • 文本序列是可以任意长的,所以,可以被我们划分成具有相同时间步的子序列。
  • 训练网络时,一个小批量的子序列,被输入模型。

438

  • token = char, 一个字符,算一个token。
  • n = 5, 表示序列长度5个token,表示一次输送5个token进入序列模型,然后预测下一个token
    • 就和8.1的序列模型一样{1,2,3,4}->5_hat

439

 因此,我们可以从随机偏移量开始划分序列, 以同时获得_覆盖性(coverage)和随机性_(randomness)
-随机采样
在随机采样中,每个样本都是在原始的长序列上任意捕获的子序列
训练的时候,迭代器给出的先后样本(来自两个相邻的、随机的、小批量(batch)中的子序列)不一定在原始序列上相邻

对于语言建模,目标是基于到目前为止我们看到的词元来预测下一个词元, 因此标签是移位了一个词元的原始序列。

下面的代码每次可以从数据中随机生成一个小批量。 在这里,参数batch_size指定了每个小批量中子序列样本的数目, 参数num_steps是每个子序列中预定义的时间步数

def seq_data_iter_random(corpus, batch_size, num_steps):  #@save
"""使用随机抽样生成一个小批量子序列"""

"""
corpus为语料库的意思, 用token索引,来翻译文本的一个大的list
num_steps 为 序列长度(包含多少个token算一个样本)
batch_size, 一个batch有多少个样本

"""
# 随机切掉corpus的开头[0, num_steps-1)个token字
corpus = corpus[random.randint(0, num_steps - 1):]
# 剩下的计算能均分成num_subseqs个num_steps字的样本
num_subseqs = (len(corpus) - 1) // num_steps
# 获得num_subseqs等分的序列样本的开头索引,并随机打乱
initial_indices = list(range(0, num_subseqs * num_steps, num_steps))
random.shuffle(initial_indices)

# 返回给定开头的序列样本
def data(pos):
# 返回从pos位置开始的长度为num_steps的序列
return corpus[pos: pos + num_steps]
"""
以上是对原始语料库进行数据处理,处理成样本
"""

"""
开始切分batch
"""
num_batches = num_subseqs // batch_size
for i in range(0, batch_size * num_batches, batch_size):
# 准备每个batch的样本集,获得输入特征+标签(下一个)
initial_indices_per_batch = initial_indices[i: i + batch_size]
X = [data(j) for j in initial_indices_per_batch]
Y = [data(j + 1) for j in initial_indices_per_batch]
yield torch.tensor(X), torch.tensor(Y)

corpus是一个按文本顺序,但是用token索引表示的超长列表
474

463(实际的一个样本是这样的)
334

523
这里的语言模型和前面的序列模型,似乎不太一致

我很好奇,这样的数据要如何输入到模型?我在前面序列模型的学习是,假设还是一个样本{13,14,15,16,17} = {xt-5, xt-4, xt-3, xt-2,xt-1}, 要来预测xt, 就是输入到MLP里面,把给定的历史输入序列,一次性输入MLP,得到xt_hat.

但是现在,一个样本是{13,14,15,16,17}->似乎没有时间步的概念了,按照现在的逻辑是,xt-1 -> xt, 就是 13-> 14, 14->15的感觉,似乎不一样,序列模型和语言模型

这正是全连接网络(MLP)与循环神经网络(RNN)在处理序列数据时最本质的逻辑差异
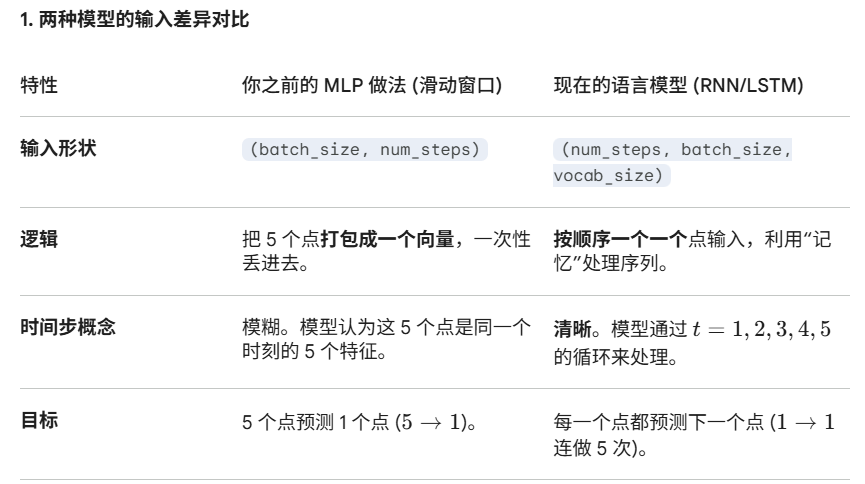
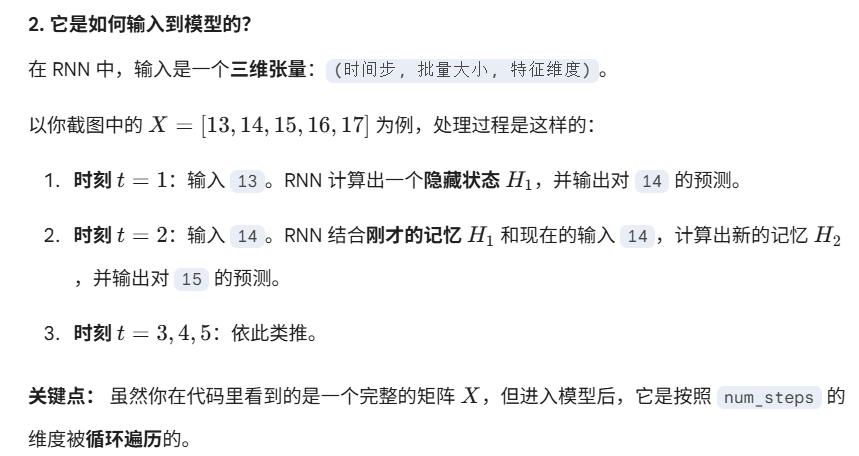
512

546

622

463

630

标准的 MLP 序列模型确实不是严格意义上的自回归模型。

594

前面已经指出,我们构造的数据集,不再是像前面序列模型MLP那样,一口气输入模型,然后预测xt, 现在的挨个输入,挨个预测。
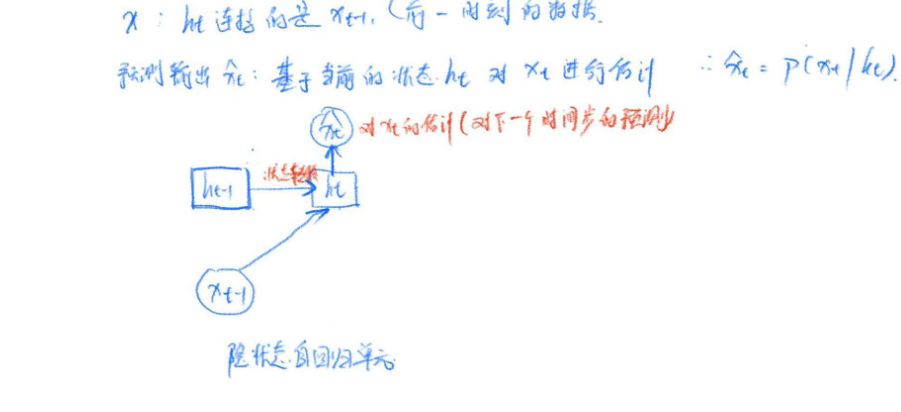
539
所以,原来的P(14,15,16,17,18) = P(14|13) * P(15| 14, 13) * P(16| 15, 14, 13) * P(17| 16, 15,14,13) * P(18 | 17, 16, 15,14, 13) 我们的计算公式。左边是我们的预测目标,右边就是体现的逐个token输入,逐步预测
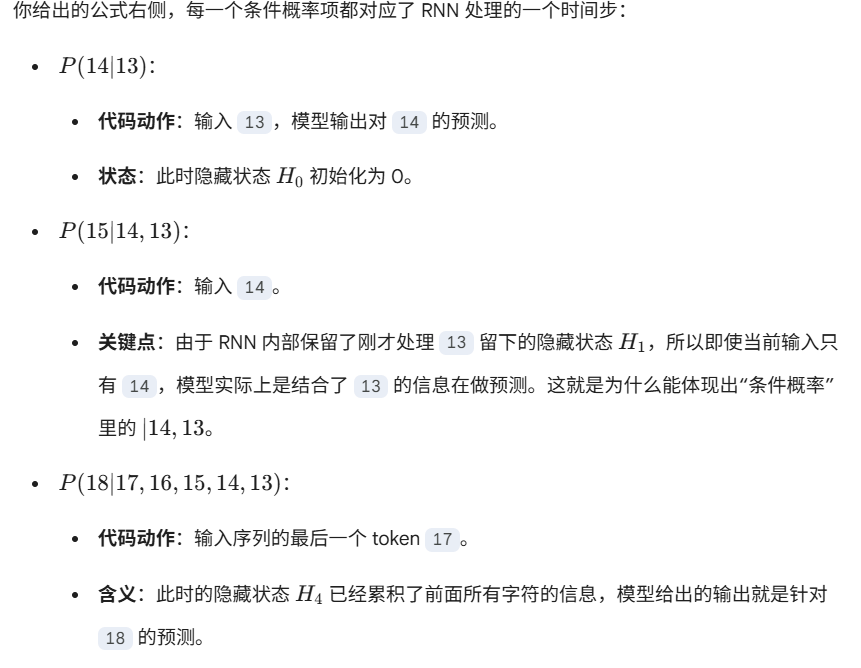
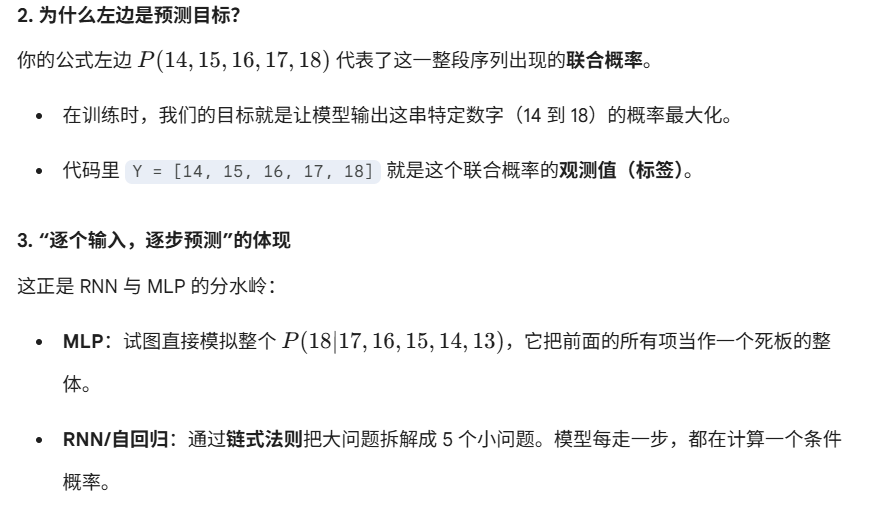
472

561

顺序分区
顺序分区(Sequential Partitioning) 是另一种从长序列语料库中采样的方法

它保证了相邻的小批量(Mini-batch)在时间顺序上是连续的

核心逻辑:保留“跨 Batch”的记忆

在顺序分区中,迭代过程中两个相邻的batch中的子序列在原始序列上也是相邻的。
小批量 1 结束后,小批量 2 会紧接着从小批量 1 停止的地方开始读取。

目的:这样做是为了在训练循环神经网络(RNN)时,可以将上一个小批量的最终隐藏状态(Hidden State)直接传递给下一个小批量,从而让模型学习到比 num_steps 更长的依赖关系
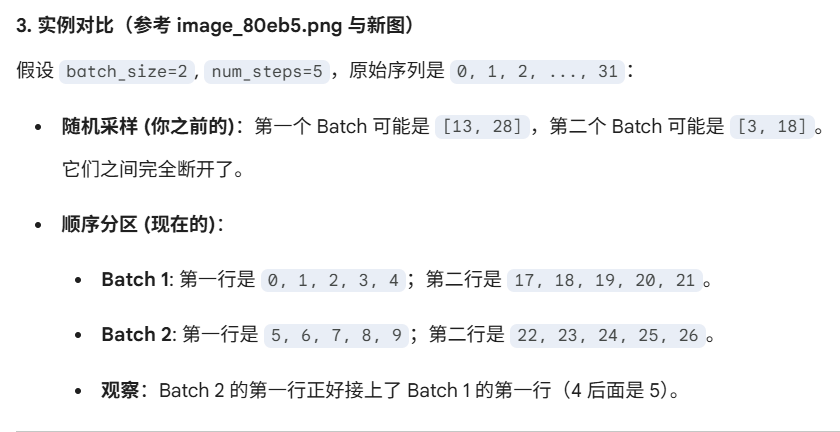
循环神经网络RNN
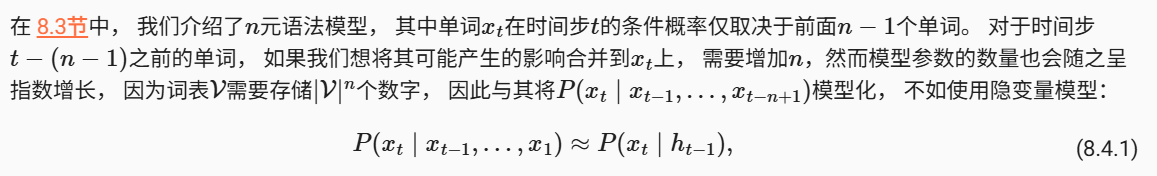
开始引入隐变量

从一开始的考虑所有的历史输入: P(xt| xt-1, …, x1)
随着时间推移,历史序列会无限变长,计算量和参数量会呈指数级爆炸
-> 马尔可夫n阶,n元语法模型: P(xt | xt-1, …, xt-n+1)
马尔可夫性质。模型假设“只有最近的 $n-1$ 个词对现在有影响”,再久远的过去都可以忽略不计
-> 隐变量模型: P(xt | ht-1)

  • $h_{t-1}$ 就像是一个“压缩包”,它试图把从 $x_1$ 到 $x_{t-1}$ 的所有有用信息都揉进一个向量里。
  • 预测 $x_t$ 时,模型只需要看一眼这个“压缩包”即可。

其中,ht-1, 叫做隐状态/隐藏变量, 他存储了到t-1时间步的序列信息。

隐藏层
隐藏层是在从输入到输出的路径上(以观测角度来理解)的隐藏的层
隐状态
而隐状态则是在给定步骤所做的任何事情(以技术角度来定义)的_输入_,并且这些状态只能通过先前时间步的数据来计算

循环神经网络(recurrent neural networks,RNNs) 是具有隐状态的神经网络

MLP是没有隐状态的神经网络

有隐状态的循环神经网络
有了隐状态之后,情况完全不一样

最终理解

import math
import torch
from torch import nn
from torch.nn import functional as F
from d2l import torch as d2l
import time_machine_loader as my


"""
构造数据集
"""
lines = my.read_time_machine()
tokens = d2l.tokenize(lines, token='char')
vocab = d2l.Vocab(tokens, min_freq=0, reserved_tokens=['<pad>'])
# 按频率编码, 总共29个索引编码(a-z, , <unk>,)
# vocab,字典{(token, ID)}

# 用ID表示文本
corpus = [vocab[token] for line in tokens for token in line]
print("======", len(corpus)) # 170580


# 35个token=一个样本,32个样本=一个batch
batch_size = 32
num_steps = 35 # 样本长度
dataset = my.TimeMachineDataset(corpus, num_steps)
# 样本= <class 'tuple'> X = torch.Size([35]) Y = torch.Size([35])
print("=====dataset", len(dataset), "样本=", type(dataset[0]),"X = ", dataset[0][0].shape,"Y = ", dataset[0][1].shape) # 170580 / 35 = 4873, dataset一共包含4873个样本序列

# 构造迭代器,32个样本为一个batch,随机抽取,不足的丢弃
train_iter = my.DataLoader(dataset, batch_size=batch_size, shuffle=True,drop_last=True)
print("======", len(train_iter)) # 4872 / 32 = 152个batch
for (X,Y) in train_iter:
# (batch_size, seq_len), 每个token目前还是ID
print("X.shape=", X.shape) # X.shape= torch.Size([32, 35])


# batch_size = 2, seq_len = 5
# X(2,5)(batch_size, seq_len)
X = torch.arange(10).reshape(2,5)

# 测试:(5,2,29)=(batch_size, seq_len,input_size)
print(F.one_hot(X.T, len(vocab)).shape)


"""
创建模型参数的矩阵,向量, 定义了模型的结构
(input_size, hidden_size, device)-> gpu
"""
def get_params(vocab_size,num_hiddens,device):
num_inputs = num_outputs = vocab_size

def normal(shape):
return torch.randn(size = shape, device = device)* 0.01

W_xh = normal((num_inputs, num_hiddens))
W_hh = normal((num_hiddens, num_hiddens))
b_h = torch.zeros(num_hiddens, device=device)

W_hq= normal((num_hiddens, num_outputs))
b_q = torch.zeros(num_outputs, device=device)

# rnn的参数列表
params = [W_xh, W_hh, b_h, W_hq, b_q]
for param in params:
param.requires_grad_(True) # 标记为需要求导

return params


# 返回一个0的一个批量并行计算的 H0
# H0 (batch_size, hidden_size) -> gpu
def init_rnn_state(batch_size, num_hiddens, device):
return (torch.zeros((batch_size, num_hiddens), device=device),)

# 定义一个batch的所有样本一次前向传播的计算, state为H, params为模型参数,inputs为X:(seq_len,batch_size, input_size)
"""
inputs, 一个batch的数据:(seq_len, batch_size, input_size)
params = 模型的参数矩阵
state = 当前的模型的隐变量H0
"""
def run(inputs, state, params):
W_xh, W_hh, b_h, W_hq, b_q, = params
H, = state
outputs = []

# X为batch的所有样本的t时刻的输入,X = Xt:(batch_size, input_size)
# H为batch的所有样本的t时刻的隐状态,H = Ht:(batch_size, hidden_size)
# Y为该batch的所有样本的t时刻的输出,Y = Yt:(batch_size, input_size)
# outputs:(seq_len, batch_size, input_size)
# return: (seq_len*batch_size, input_size), ((batch_size, hidden_size),)
for X in inputs:
H = torch.tanh(torch.mm(X, W_xh) + torch.mm(H, W_hh) + b_h)
Y = torch.mm(H, W_hq) + b_q
outputs.append(Y) # Y为batch所有样本t时刻的预测输出

return torch.cat(outputs, dim=0), (H,)
"""
inputs: 一个batch的所有样本序列 (seq_len, batch_size, input_size)
state: batch中每个独立样本对应的ht隐状态的矩阵(batch_size, num_hiddens)
outputs: 一个batch的所有样本序列全部预测完之后的输出(seq_len, batch_size, input_size)
H = 最后的隐状态
"""


"""RNN 模型

vocab_size = input_size
num_hiddens = hidden_size
get_params = 模型参数
init_state = H0初始隐状态(batch_size, hidden_size)
forward_fn 输入一个batch的数据

"""
class RNNModelScratch:
def __init__(self, vocab_size, num_hiddens, device, get_params, init_state, forward_fn):
self.vocab_size, self.num_hiddens = vocab_size, num_hiddens
self.params = get_params(vocab_size, num_hiddens, device)
self.init_state = init_state
self.forward_fn = forward_fn

"""
模型调用model(X, state)
X 一个batch的完整数据(未hot编码)(batch_size, seq_len)
"""
def __call__(self, X, state):

"""
X: (seq_len, batch_size, input_size)
"""
X = F.one_hot(X.T, self.vocab_size).type(torch.float32)

return self.forward_fn(X, state, self.params)

# 获得H0 = 0
def begin_state(self, batch_size, device):
return self.init_state(batch_size, self.num_hiddens, device)

device = torch.device("cuda")

# hidden_size = 512
num_hiddens = 512
net = RNNModelScratch(len(vocab), num_hiddens=num_hiddens,
device=device,get_params=get_params,
init_state=init_rnn_state, forward_fn=run )


# (batch_size, seq_len)每个元素是一个ID
print(X.shape)

# state = (batch_szie, hidden_size) = 0 (H0)
state = net.begin_state(X.shape[0], device=device)

# 前向传播(x->gpu)X为随机生成的,state=H0,为0矩阵
# Y=(seq_len*batch_size, input_size), new_state=((batch_size, hidden_size),)
Y, new_state = net(X.to(device=device), state)

print("net return outputs [seq_len*batch_size, input_size]", Y.shape)
print(new_state)


"""
预测函数
prefix:给定输入序列
num_preds,自回归多少步
net: 模型
vocab: 词表,用来翻译prefix

"""
def predict_ch8(prefix, num_preds, net, vocab, device):
# H0 = (batch_size, hidden_size) = (1, 512)
state = net.begin_state(batch_size = 1, device=device)

# 把prefix的第0个token放入list, 定义匿名lambda,返回outputs最后一个token的IDtensor
outputs = [vocab[prefix[0]]]
get_input = lambda: torch.tensor([outputs[-1]], device=device).reshape((1, 1))


# 先更新隐状态,模型参数目前是随机的
# 预热,目的是更新H状态,不要让他处于H0的0, 同时也让给定的序列加入我们最终的输出
# y 是一个 token
for y in prefix[1:]:
# 模型net基于上一个,和当前的状态,预测,_ = (1*1,input_size), state=((1, hidden_size),)
_, state = net(get_input(), state)
# 把标签保存下来
outputs.append(vocab[y])

# state已经被更新过好几次了,y = (1*1,input_size)
for _ in range(num_preds): #预测num_preds步
y, state = net(get_input(), state) # 这边是做真正的自回归
outputs.append(int(y.argmax(dim=1).reshape(1))) # argmax从hot编码得到IDX

# 返回整个自回归的序列
return "".join([vocab.idx_to_token[i] for i in outputs])


result = predict_ch8("time traveller ", 10, net, vocab, device=device)
print(result)


"""梯度裁剪
仅能解决梯度爆炸
"""
def grad_clipping(net, theta):
# 如果是继承的基类,就直接用基类的方法返回要求梯度的参数
if isinstance(net, nn.Module):
params = [p for p in net.parameters() if p.requires_grad]
else:
# 自定义的类,直接访问公共的参数列表
params = net.params

# params = [Wxh, Whh, Whq, b_h, b_q]
# 每个模型参数都有梯度, d(Loss)/d(Wxh).shape = Wxh.shape,
# 参数矩阵里面每个元素,都有梯度,所以梯度张量的shape = 参数张量的shape
# 单个参数梯度的各个元素的梯度平方和,然后所有参数的梯度全部加起来,开方
norm = torch.sqrt(sum(torch.sum((p.grad**2)) for p in params))
# > 阈值,容易发送梯度爆炸
if norm > theta:
for param in params:
param.grad[:] *= theta/norm #对每个参数的梯度,进行压缩


"""训练一个epoch
net: 模型
train_iter: 训练集迭代器
loss:损失函数对象
updater: 优化器(每个batch,H的计算图也牵涉了其他batch,需要detach清除计算图)
use_random_iter: 随机采样(每个batch开始要清空H隐状态), 否则是顺序分区(无需清空H)

"""
def train_epoch_ch8(net, train_iter, loss, updater, device, use_random_iter):
state, timer = None, d2l.Timer()
metric = d2l.Accumulator(2)

# 每个for一个batch
# X (batch_size, seq_len), Y(batch_size, seq_len)
for (X, Y) in train_iter:
# state = None, 说明是第一个batch
# use_random_iter=True, 说明是随机采样,需要每个batch开头,重置H0
if state is None or use_random_iter:
# 在第一次迭代或使用随机抽样时初始化state = H0
state = net.begin_state(batch_size=X.shape[0], device=device)
else:
# 不是第一次,且顺序分区
# 如果是官方的net对象,并且,state此时不是元组,(就是官方的GRU)
if isinstance(net, nn.Module) and not isinstance(state, tuple):
state.detach_()
else:
# 我们自定义/官方的LSTM
# 每个batch,我们都要断开该batch的所有样本的隐状态的梯度图,清除上一个batch的隐状态的计算图
# state = (batch_size, hidden_size)
for s in state:
s.detach_() # s = ht(某个样本,上一个batch留下来的ht(1,hidden_size))

# 标签y=(seq_len * batch_size),里面元素是ID
y = Y.T.reshape(-1)

# 训练集(X,y)->gpu
X , y = X.to(device), y.to(device)

# X在net里面被转成了(seq_len, batch_size, input_size)
# y_hat=(seq_len*batch_size, input_size), state元组=((batch_size, hidden_size),)
y_hat, state = net(X, state)


# 交叉熵损失函数(二维张量o,标签值)
# y->hat -> 哪个词的概率分布,词表的ID就是哪个词的ID
# loss得到(seq_len*batch_size,)个loss(一个token一个loss)
# .mean,求均值
"""
y_hat 经过 softmax 后 = [0.1, 0.05, 0.02, ... , 0.07] 一共29个概率,加起来=1
y = 真实 ID = 5
就是MLP分类里面的softmax回归
"""
l =loss(y_hat, y.long()).mean()

# 如果指定的官方优化器
if isinstance(updater, torch.optim.Optimizer):
updater.zero_grad()
l.backward()
grad_clipping(net, 1)
updater.step()
else:
# 自己定义的优化器
l.backward()
grad_clipping(net, 1)
updater(batch_size=1)

# l是这个batch的平均损失, y.numel()获得batch的token个数
# metric是自定义的工具类,metric[0] 总loss, metric[1], token个数
metric.add(l * y.numel(), y.numel())

# e^(平均损失) = 困惑度
return math.exp(metric[0] / metric[1]), metric[1]/timer.stop()


#@save
"""
多个epoch训练
"""
def train_ch8(net, train_iter, vocab, lr, num_epochs, device,
use_random_iter=False):
"""训练模型(定义见第8章)"""
# 交叉熵损失
loss = nn.CrossEntropyLoss()
animator = d2l.Animator(xlabel='epoch', ylabel='perplexity',
legend=['train'], xlim=[10, num_epochs])
# 初始化
if isinstance(net, nn.Module):
updater = torch.optim.SGD(net.parameters(), lr)
else:
# 我们自定义的优化器
updater = lambda batch_size: d2l.sgd(net.params, lr, batch_size)

# 定义一个函数predict
predict = lambda prefix: predict_ch8(prefix, 50, net, vocab, device)
# 训练和预测
for epoch in range(num_epochs):
ppl, speed = train_epoch_ch8(
net, train_iter, loss, updater, device, use_random_iter)
if (epoch + 1) % 10 == 0:
print("epoch=", epoch)
print(predict('time traveller'))
animator.add(epoch + 1, [ppl])
print(f'困惑度 {ppl:.1f}, {speed:.1f} 词元/秒 {str(device)}')
print(predict('time traveller'))
print(predict('traveller'))


num_epochs = 500
lr = 1
train_ch8(net, train_iter=train_iter, vocab=vocab, lr=lr, num_epochs=num_epochs, device=device)


BPTT 通过时间反向传播

现代循环神经网络

GRU 门控循环单元

LSTM 长短期记忆网络
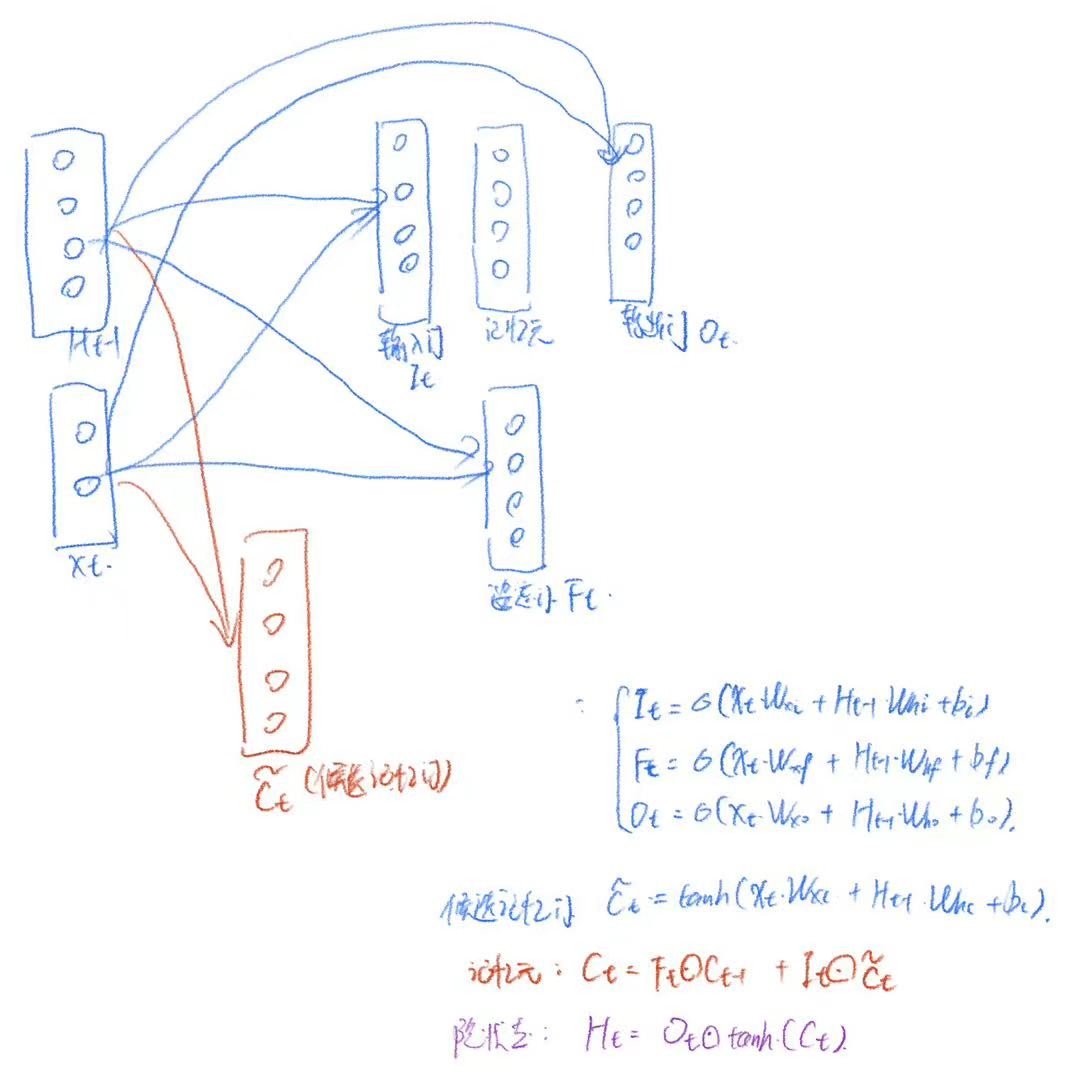
480

深度循环神经网络

前面RNN,就是一个普通的隐状态层,他利用输入+上一时刻的本层的隐状态来得到
后面提到了GRU,LSTM,就是优化了这个隐藏层的设计,加入了一些门控的设计,让隐状态Ht的计算变得复杂,本质结构并没有变化,都是针对单层而言的。

现在的深度循环神经网络,是通过在向后,增加到多层,后面层的隐藏层,不仅以来前一层(第一层就是输入)的隐状态输出,还有自己本层的上一时刻的隐状态。
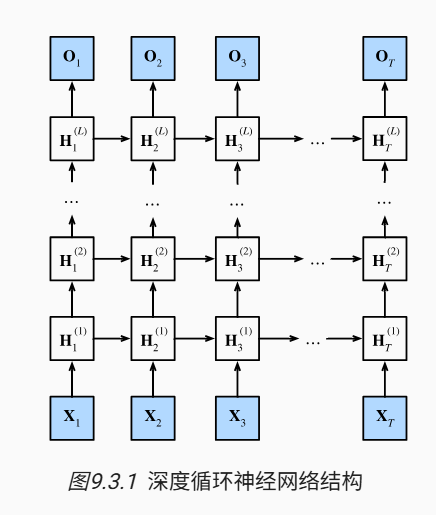
303
网络时移图如上所示。

  • 加入了门控机制:更好的捕捉时间步距离很长的序列的依赖关系
    • GRU:
      • 重置门:捕捉短期依赖
      • 更新门:捕捉长期依赖
  • 多层的深度设计:解决了单层只能学习输入数据和隐藏层一层之间的非线性映射关系。复杂语义不行的问题。
    • 每一层对上一层进行加工
      • 浅层:低级特征(语法,词法,简单组合)
      • 深层:高级特征(长文本的逻辑结构,情感转折,语义内涵)

数学上已经证明,深层网络可以用比浅层网络更少的神经元,去拟合极其复杂的函数。
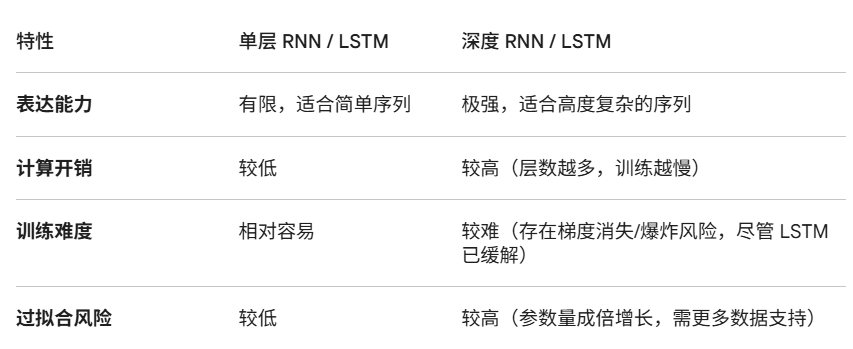
545

编码器解码器架构

451

解决的问题是:输入输出都是长度可变的序列,我们要把可变长度的输入,通过编码器转成固定长度的状态编码,然后输入到解码器,解码器将这个状态映射到长度可变的序列。

在编码器-解码器(Encoder-Decoder)架构中,这两个“输入”有着完全不同的功能和来源

1. 编码器的输入 (Encoder Input)

  • 来源: 这是我们要处理的源序列(Source Sequence)。
  • 内容: 比如在机器翻译中,如果你想把中文翻译成英文,编码器的输入就是完整的中文句子(如:“我爱人工智能”)。
  • 作用: 编码器负责将这个原始输入“压缩”成一个包含语义信息的固定形状的状态(Context Vector)。

2. 解码器的输入 (Decoder Input)

  • 来源: 在训练阶段和推理(预测)阶段略有不同。
  • 内容: 它通常是目标序列(Target Sequence)的已知部分。
    • 在训练时(Teacher Forcing): 解码器的输入是翻译后的正确英文句子(如:“I love AI”),但会做一个偏移(Shift),让模型学习根据已经出现的单词预测下一个单词。
    • 在预测(推理)时: 解码器的输入是上一个时间步自己生成的单词。
  • 作用: 解码器需要根据编码器提供的“状态”以及它“目前已经生成了什么”,来决定下一个词该输出什么。
特性 编码器输入 解码器输入
所属序列 源序列 (Source) 目标序列 (Target)
语言 通常是语言 A (如中文) 通常是语言 B (如英文)
时间点 一次性输入完整序列 随时间步逐个输入(Autoregressive)
510
#@save
class EncoderDecoder(nn.Module):
"""编码器-解码器架构的基类"""
def __init__(self, encoder, decoder, **kwargs):
super(EncoderDecoder, self).__init__(**kwargs)
self.encoder = encoder
self.decoder = decoder

def forward(self, enc_X, dec_X, *args):
enc_outputs = self.encoder(enc_X, *args)
dec_state = self.decoder.init_state(enc_outputs, *args)
return self.decoder(dec_X, dec_state)

序列到序列学习

利用编码器解码器结构+深层循环神经网络实现机器翻译问题:

  • 输入:a长度的序列(英语)
  • 隐状态:固定长度的状态向量
  • 输出标签:b长度的序列(法语)

这里,我们使用两个循环神经网络的编码器解码器。来实现翻译

这里有几个设计点:

  • 编码器本身是一个循环神经网络,解码器本身也是一个独立的循环神经网络
  • 特定的”bos”表示序列开始词元,它是解码器的输入序列的第一个词元
  • 解码器循环神经网络,一旦预测“eos”出就停止预测
  • 使用循环神经网络编码器最终的隐状态来初始化解码器的隐状态

501
442

编码器

这个循环神经网络,我们使用的是单向循环神经网络:

假设输入的batch_size = 1, 输入序列{x1, x2,… , xT}

状态转移如下:
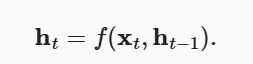
158

上下文变量就是用q方法,得到的向量,他是依赖所有的状态量得到的
468

所以,如果选择q(h1, …, hT) = hT时,上下文变量就是最后的hT

我们使用的是一个单向循环神经网络来设计编码器

注意,我们使用了_嵌入层_(embedding layer) 来获得输入序列中每个词元的特征向量

 嵌入层的权重是一个矩阵, 其行数等于输入词表的大小(vocab_size)

其列数等于特征向量的维度(embed_size)
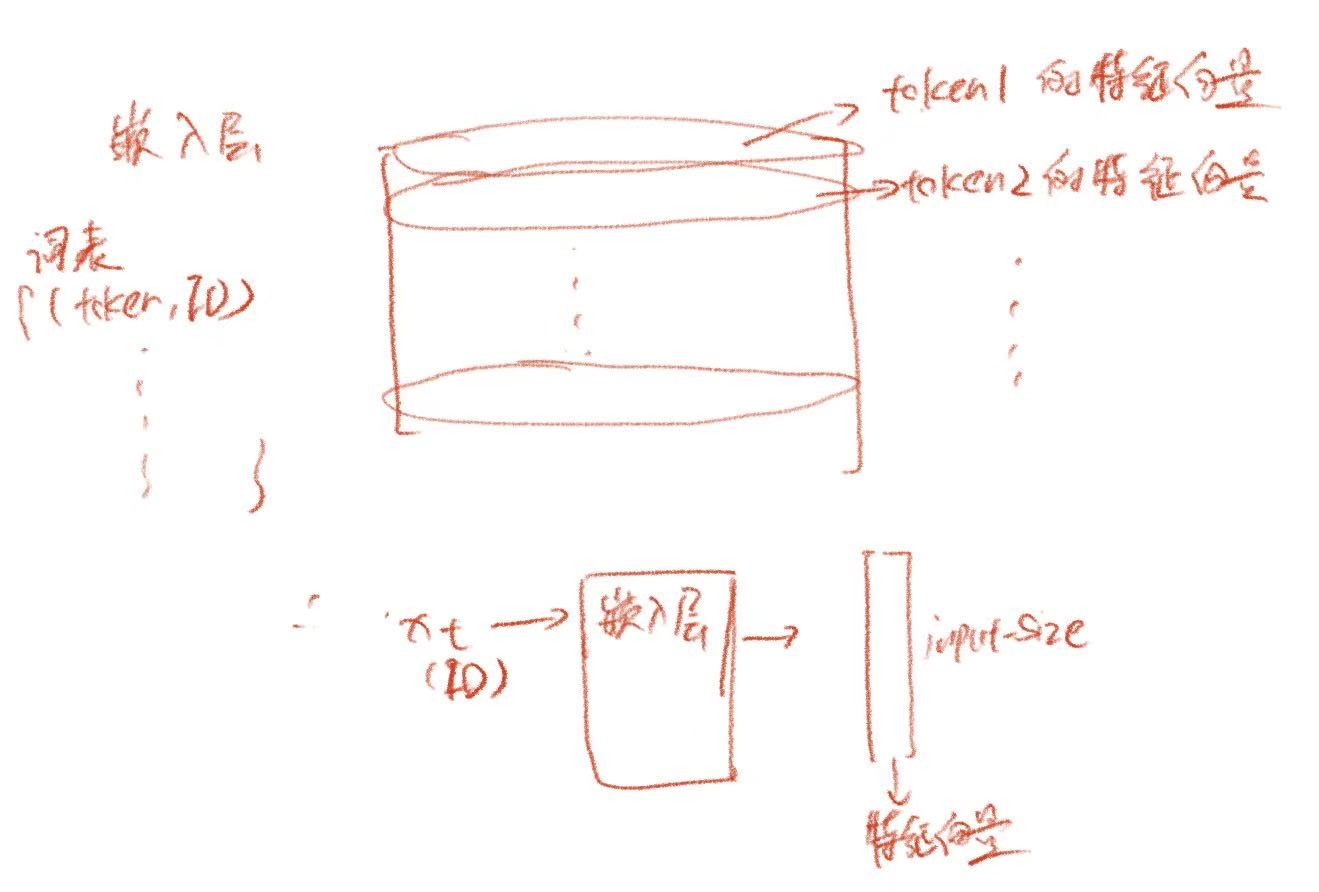
327

本文选择了一个多层门控循环单元来实现编码器

import collections
import math
import torch
from torch import nn
from d2l import torch as d2l

class Encoder(nn.Module):
"""编码器-解码器架构的基本编码器接口"""
def __init__(self, **kwargs):
super(Encoder, self).__init__(**kwargs)

def forward(self, X, *args):
raise NotImplementedError


#@save
class Seq2SeqEncoder(Encoder):
"""用于序列到序列学习的循环神经网络编码器"""
def __init__(self, vocab_size, embed_size, num_hiddens, num_layers,
dropout=0, **kwargs):
super(Seq2SeqEncoder, self).__init__(**kwargs)
# 嵌入层(embed_size = 特征向量维度 = input_size)
self.embedding = nn.Embedding(vocab_size, embed_size)
self.rnn = nn.GRU(embed_size, num_hiddens, num_layers,
dropout=dropout)


def forward(self, X, *args):
# 输出'X'的形状:(batch_size,num_steps,embed_size)
X = self.embedding(X)
# 在循环神经网络模型中,第一个轴对应于时间步,(num_steps,batch_size,embed_size)
X = X.permute(1, 0, 2)

# 如果未提及状态,则默认为0
output, state = self.rnn(X)
# output的形状:(num_steps,batch_size,num_hiddens)
# state的形状:(num_layers,batch_size,num_hiddens)
return output, state
# 这个state, 返回的是所有隐藏层的最后一个时间步的状态

"""
编码器循环神经网络:
10种token, input_size=8, hiddens_size=16, 隐藏层2层
"""
encoder = Seq2SeqEncoder(vocab_size=10, embed_size=8, num_hiddens=16,
num_layers=2)
encoder.eval() # 设置该隐藏层可以修改参数
X = torch.zeros((4, 7), dtype=torch.long) # X= (batch_size, seq_len),元素为ID
output, state = encoder(X)

print(output.shape)

199
以上,我们已经实现了编码器这一部分了,最后输出的这个state, 返回的是所有隐藏层的最后一个时间步的状态, 也就是我们编码器输出的上下文变量c
158
468

解码器

来自训练数据集的输出序列{y1, y2,…, yT’}, 对于每个时间步t‘, 解码器输出yt’的预测概率取决于前面的输入,以及上下文变量c
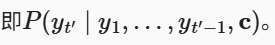
242

为了在序列上模型化这种条件概率, 我们可以使用另一个循环神经网络作为解码器

390

所以,状态转移为:

当实现解码器时, 我们直接使用编码器最后一个时间步的隐状态来初始化解码器的隐状态

所以s0 = hT

所以,这就要求,编码器和解码器的状态h=s,都是同尺寸,同层数,因为编码器返回的状态是最后一步的所有层的状态:(num_layers,batch_size,num_hiddens)

为了预测输出词元的概率分布, 在循环神经网络解码器的最后一层使用全连接层来变换隐状态

class Seq2SeqDecoder(Decoder):
"""用于序列到序列学习的循环神经网络解码器"""
def __init__(self, vocab_size, embed_size, num_hiddens, num_layers,
dropout=0, **kwargs):
super(Seq2SeqDecoder, self).__init__(**kwargs)
self.embedding = nn.Embedding(vocab_size, embed_size)
self.rnn = nn.GRU(embed_size + num_hiddens, num_hiddens, num_layers,
dropout=dropout)
self.dense = nn.Linear(num_hiddens, vocab_size)

def init_state(self, enc_outputs, *args):
return enc_outputs[1]

# X = Y(batch_size, seq_len), 训练数据
# state(num_layers,batch_size,num_hiddens)
def forward(self, X, state):
X = self.embedding(X).permute(1, 0, 2)
# X(seq_len, batch_size, input_size)
# seq_len, 是训练集的标签Y的序列长度


# 编码器的上下文变量context:(num_layers,batch_size,num_hiddens)
# state的形状:(num_layers,batch_size,num_hiddens)
context = state[-1].repeat(X.shape[0], 1, 1)
# context (num_steps(目标序列长度), batch_size, num_hiddens)
# X(num_steps(目标序列长度), batch_size, input_size)
X_and_context = torch.cat((X, context), 2) # 输入Y + C
# Y+X (num_steps(目标序列长度), batch_size, input_size + num_hiddens)
# 就是embed_size + num_hiddens


output, state = self.rnn(X_and_context, state)
output = self.dense(output).permute(1, 0, 2)
# output的形状:(batch_size,num_steps,vocab_size)
# state的形状:(num_layers,batch_size,num_hiddens)
return output, state


decoder = Seq2SeqDecoder(vocab_size=10, embed_size=8, num_hiddens=16,
num_layers=2)
decoder.eval()
state = decoder.init_state(encoder(X))
output, state = decoder(X, state) # X= (batch_size, seq_len),元素为ID,但是含义不一样

print(output.shape)
print(state.shape)

注意,这里虽然还是用X(4,7)作为输入,但是意义完全变了,这里的X其实是Y,也就是训练集的标签Y

当我们在线测试的时候,一个时间步,喂入上一个时间步的输出,就相当于一次性给入整个训练集标签了

损失函数

在每个时间步,解码器预测了输出词元的概率分布

类似于语言模型,可以使用softmax来获得分布,并通过计算交叉熵损失函数来进行优化

注意:我们之前用填充词添加到序列里面,这样能够让不同长度的序列,能够相同形状进行加载,所以我们在损失计算的时候,需要排除掉这些填充词

模型架构(Encoder-Decoder)确实支持不同长度,但为了计算效率,我们必须在“批处理(Batching)”这一层做填充。
358
478

所以,我们还是要对不同长度的序列,做填充,这样才能把不同长度的序列,塞到一个X(seq_len, batch_size, input_size)里面,让self.rnn, 进行批量化计算,一次计算一个batch的样本。

将填充词元的预测排除在损失函数的计算之外,在代码实现上,我们通常使用 掩码(Masking) 技术

准备一个 Mask:对于一个带有填充的序列,我们生成一个同维度的布尔矩阵,有效词元处为 1,填充处为 0。(seq_len, batch_size, input_size)

过滤 Loss:在计算交叉熵损失时,只保留 Mask 为 1 的部分的损失,将 Mask 为 0 的部分强制置为 0。

在训练过程中,由于我们采用了“方方正正”的矩阵输入,模型的输出也确实是“方方正正”的。
450

例如,如果两个序列的有效长度(不包括填充词元)分别为1和2, 则第一个序列的第一项和第二个序列的前两项之后的剩余项将被清除为零

现在,我们可以通过扩展softmax交叉熵损失函数来遮蔽不相关的预测, 自己实现一个带遮蔽功能的softmax交叉熵损失函数

训练

训练,输入的一个样本(X,Y)包含两个序列,
我们需要先把X输入到编码器中,然后以他的状态为基础,

这个时候,整个序列-序列模型,其实就已经是一个单纯的解码器的循环神经网络了。

我们循环神经网络的训练中,是
(abcde)->(bcdef), 通过把后一个token作为该输入token的标签来的,这就是语言模型

语言模型的训练样本,就是一个序列,把下一个token作为当前token输入的预测的标签,

一旦编码器(Encoder)完成了任务,接下来的训练过程在本质上就是一个带条件的语言模型(Conditional Language Model)训练。
633

“把下一个 token 作为当前 token 输入的预测标签”正是 Teacher Forcing(强制教学) 的精髓。
331

因为语言模型,他的样本就是一个序列,通常也只预测下一位,也就是我们的经典的自监督学习

预测

所以,如果输入的状态被重置,那么解码器的循环神经网络GRU,就会认为是另一个batch的输入,

所以如果是随机采样,不同batch之间不应该有状态的相关,所以,如果我们自己实现循环神经网络,就需要自己手动不同batch输入时,清除状态。

如果是顺序采样,那么前后两个batch的状态是需要继承的。所以本质上这几个batch是一个大序列里面的连续的,

所以在预测的时候,我们使用(1,1)的输入,虽然每次把预测的输出当作输入自回归给模型作为输入,严格意义上来说自回归,是顺序分区下的不同batch,这些个不同batch的样本序列,共用一个状态

我们训练的时候则是随机采样下的,一个状态,只在同一个batch来训练的。
629

626

完整实现(非常有学习价值)

数据集准备脚本
translate.py

import os
import torch
from d2l import torch as d2l

d2l.DATA_HUB['fra-eng'] = (d2l.DATA_URL + 'fra-eng.zip', '94646ad1522d915e7b0f9296181140edcf86a4f5')

def read_data_nmt():
data_dir = d2l.download_extract('fra-eng')
with open(os.path.join(data_dir, 'fra.txt'), 'r', encoding='utf-8') as f:
return f.read()

raw_text = read_data_nmt()


def preprocess_nmt(text):
def no_space(char, prev_char):
return char in set(',.!?') and prev_char != ' '

text= text.replace('\u202f', ' ').replace('\xa0', ' ').lower()
out = [' ' + char if i > 0 and no_space(char, text[i-1]) else char for i, char in enumerate(text)]

return ''.join(out)

text = preprocess_nmt(raw_text)


def tokenize_nmt(text, num_examples=None):
source = []
target = []

for (i, line) in enumerate(text.split('\n')):
# 是否超出要读取的样本数
if num_examples and i > num_examples:
break;

parts = line.split('\t')
if len(parts) == 2:
source.append(parts[0].split(' '))
target.append(parts[1].split(' '))
return source, target

source, target = tokenize_nmt(text)
print(source[:6])
print(target[:6])


src_vocab = d2l.Vocab(source, min_freq=2, reserved_tokens=['<pad>', '<bos>', '<eos>'])
print(len(src_vocab))
print(type(src_vocab))
print(len(src_vocab.token_to_idx))


def truncate_pad(line, num_steps, padding_token):
if len(line) > num_steps:
return line[:num_steps]
return line + [padding_token]*(num_steps - len(line))

print(truncate_pad(src_vocab[source[0]], 5, src_vocab['<pad>']))


def build_array_nmt(lines, vocab, num_steps):
lines = [vocab[l] for l in lines]
lines = [l + [vocab['<eos>']] for l in lines]
array = torch.tensor([truncate_pad(line=l,num_steps=num_steps, padding_token=vocab['<pad>']) for l in lines])
valid_len = (array != vocab['<pad>']).type(torch.int32).sum(1)
return array, valid_len


def load_data_nmt(batch_size, num_steps, num_examples = 600):
text = preprocess_nmt(read_data_nmt())
source, target = tokenize_nmt(text, num_examples)
src_vocab = d2l.Vocab(source, min_freq=2,
reserved_tokens=['<pad>', '<bos>', '<eos>'])
tgt_vocab = d2l.Vocab(target, min_freq=2,
reserved_tokens=['<pad>', '<bos>', '<eos>'])


src_array, src_valid_len = build_array_nmt(source, src_vocab, num_steps)
tgt_array, tgt_valid_len = build_array_nmt(target, tgt_vocab, num_steps)

data_arrays = (src_array, src_valid_len, tgt_array, tgt_valid_len)
data_iter = d2l.load_array(data_arrays, batch_size)
return data_iter, src_vocab, tgt_vocab

train_iter, src_vocab, tgt_vocab = load_data_nmt(batch_size=2, num_steps=8)

for X, X_valid_len, Y, Y_valid_len in train_iter:
print('X:', X.type(torch.int32))
print('X的有效长度:', X_valid_len)
print('Y:', Y.type(torch.int32))
print('Y的有效长度:', Y_valid_len)
break

encoder_decoder.py

import collections
import math
import torch
from torch import nn
from d2l import torch as d2l
import translate
import sys

class Encoder(nn.Module):
"""编码器-解码器架构的基本编码器接口"""
def __init__(self, **kwargs):
super(Encoder, self).__init__(**kwargs)

def forward(self, X, *args):
raise NotImplementedError


class Decoder(nn.Module):
"""编码器-解码器架构的基本解码器接口"""
def __init__(self, **kwargs):
super(Decoder, self).__init__(**kwargs)

def init_state(self, enc_outputs, *args):
raise NotImplementedError

def forward(self, X, state):
raise NotImplementedError

class EncoderDecoder(nn.Module):
"""编码器-解码器架构的基类"""
def __init__(self, encoder, decoder, **kwargs):
super(EncoderDecoder, self).__init__(**kwargs)
self.encoder = encoder
self.decoder = decoder

def forward(self, enc_X, dec_X, *args):
enc_outputs = self.encoder(enc_X, *args)
dec_state = self.decoder.init_state(enc_outputs, *args)
return self.decoder(dec_X, dec_state)


#@save
"""
嵌入层+2层GRU
"""
class Seq2SeqEncoder(Encoder):
"""用于序列到序列学习的循环神经网络编码器
vocab_size: token种类
embed_size: input_size
num_hiddens: hidden_size
num_layers: 隐藏层层数
"""
def __init__(self, vocab_size, embed_size, num_hiddens, num_layers,
dropout=0, **kwargs):
super(Seq2SeqEncoder, self).__init__(**kwargs)
# 嵌入层(embed_size = 特征向量维度 = input_size)
self.embedding = nn.Embedding(vocab_size, embed_size)
self.rnn = nn.GRU(embed_size, num_hiddens, num_layers,
dropout=dropout)


# X,一个batch的所有token: (batch_size, seq_len),每个元素是ID
def forward(self, X, *args):
X = self.embedding(X)
# 输出'X'的形状:(batch_size, seq_len, embed_size)

# 交换轴0,轴1,(seq_len, batch_size, embed_size)
X = X.permute(1, 0, 2)

# 如果未提及状态,则默认为0
output, state = self.rnn(X)
# output的形状:(seq_len, batch_size, hidden_size)
# state的形状:(num_layers,batch_size, hidden_size), 两层隐藏层,最后一个时间步的状态
return output, state
# 这个state, 返回的是所有隐藏层的最后一个时间步的状态


"""
编码器循环神经网络:
10种token,
input_size=8,
hiddens_size=16,
隐藏层2层
"""
encoder = Seq2SeqEncoder(vocab_size=10, embed_size=8, num_hiddens=16,
num_layers=2)
encoder.eval() # 设置该隐藏层可以修改参数

# X= (batch_size, seq_len),元素为ID
X = torch.zeros((4, 7), dtype=torch.long)

# output的形状:(seq_len, batch_size, hidden_size)
# state的形状:(num_layers,batch_size, hidden_size), 两层隐藏层,最后一个时间步的状态
output, state = encoder(X)


print(output.shape)


class Seq2SeqDecoder(Decoder):
"""用于序列到序列学习的循环神经网络解码器
vocab_size: token种类
embed_size: input_size
num_hiddens: hidden_size
num_layers: 解码器隐藏层层数

"""
def __init__(self, vocab_size, embed_size, num_hiddens, num_layers,
dropout=0, **kwargs):
super(Seq2SeqDecoder, self).__init__(**kwargs)

"""
注意,我们训练的时候,需要批量化输入,但是在实际测试的时候,不需要
"""
# 解码器也有嵌入层,用来预处理数据,输入(batch_size, seq_len)
self.embedding = nn.Embedding(vocab_size, embed_size)

# 和编码器一样的两层隐藏层,输入是(Y-embed_size + C-num_hiddens)
self.rnn = nn.GRU(embed_size + num_hiddens, num_hiddens, num_layers,
dropout=dropout)

# 输出层,MLP,输出的是token种类的打分
self.dense = nn.Linear(num_hiddens, vocab_size)


# 处理编码器得到的context C
def init_state(self, enc_outputs, *args):
return enc_outputs[1]

"""
解码器输入:yt-1 + C(上下文变量)
输出: 预测yt

数据集:(X,Y), X(英语)给编码器作为输入,Y(法语)给解码器作为标签
就像你训练RNN一样,你肯定是把序列逐个输入,然后和标签比较,不是一直自回归。

训练预测下一个
(abcde)-(bcdef), 你肯定是
输入a,得到y1_hat, 和y1比较得到loss
输入b, 得到y2_hat, 和y2比较得到loss
...
输入d,得到yt_hat, 和yt比较得到loss

测试:
输入a, 预测b, 输入预测b, 预测c, ....
"""
# X = Y(batch_size, seq_len_y)
# 编码器的隐藏层状态:state(num_layers, batch_size, hidden_size)
def forward(self, X, state):

X = self.embedding(X).permute(1, 0, 2)
# X(seq_len_y, batch_size, input_size). seq_len_y, 是训练集的标签Y的序列长度


# state的形状:(num_layers, batch_size, hidden_size)
# state[-1], 第二层隐藏层的最后一个Ht (batch_size, hidden_size)
# X.shape[0] = seq_len_y
context = state[-1].repeat(X.shape[0], 1, 1)
# 编码器的上下文变量context:(seq_len_y, batch_size, hidden_size)
"""
为什么仅选择最后一层的Ht作为上下文变量?
更高层代表更高级的特征
- 编码器的所有隐藏层的最后时间步的状态,已经作为解码器的最初状态了
- 用更高的特征Context, 来作为补充输入,作为额外强化记忆
- 解码器本身的输入维度已经固定了(input_size + hidden_size)
- 如果所有层的最后状态,作为context, 就会变成(input_size + num_layers * hidden_size)
会导致信息冗余,增加训练难度
"""


# 编码器的隐藏层的输入张量
X_and_context = torch.cat((X, context), 2) # 输入Y + C
# X_and_context = Y+X (seq_len_y, batch_size, input_size + num_hiddens)


# state: 用编码器的最后一步的隐状态HT 去初始化 解码器的初始状态H0'
# X_and_context: Yt-1 + C
output, state = self.rnn(X_and_context, state)
# 经过隐藏层之后,
# output: (seq_len_y, batch_size, hidden_size)
# state: (num_layers, batch_size, hidden_size)


output = self.dense(output).permute(1, 0, 2)
# output的形状:(batch_size, seq_len_y, vocab_size)
# state的形状:(num_layers,batch_size,num_hiddens)
return output, state


"""
解码器:
token种类10
input_size = 8
hidden_size = 16
隐藏层2层
"""
decoder = Seq2SeqDecoder(vocab_size=10, embed_size=8, num_hiddens=16,
num_layers=2)
decoder.eval()

#数据集(X,X)
# X (batch_size, seq_len_y)
# state:(num_layers,batch_size, hidden_size)
state = decoder.init_state(encoder(X))

# X=Y (batch_size, seq_len_y)
# state:(num_layers,batch_size, hidden_size): 解码器的最后一个时间步的所有隐藏层的状态
output, state = decoder(X, state)
# output的形状:(batch_size, seq_len_y, vocab_size)
# state的形状:(num_layers,batch_size,num_hiddens)


print(output.shape) # torch.Size([4, 7, 10])
print(state.shape) # torch.Size([2, 4, 16])


"""
损失函数
"""
# 保留每个序列样本的指定个数
# X (batch_size, seq_len) 原始batch序列
# valid_len (len, ) 用来指定每个样本的有效长度
def sequence_mask(X, valid_len, value=0):
"""在序列中屏蔽不相关的项"""
maxlen = X.size(1)
mask = torch.arange((maxlen), dtype=torch.float32,
device=X.device)[None, :] < valid_len[:, None]
X[~mask] = value
return X

X = torch.tensor([[1, 2, 3], [4, 5, 6]])
print(sequence_mask(X, torch.tensor([1, 2])))


"""
带掩码的交叉熵损失函数
"""
class MaskedSoftmaxCELoss(nn.CrossEntropyLoss):
"""带遮蔽的softmax交叉熵损失函数"""
# pred的形状:(batch_size, num_steps, vocab_size(token种类的打分))
# label的形状:(batch_size,num_steps)
# valid_len的形状:(batch_size,)
def forward(self, pred, label, valid_len):
weights = torch.ones_like(label)
weights = sequence_mask(weights, valid_len)

self.reduction='none'
unweighted_loss = super(MaskedSoftmaxCELoss, self).forward(
pred.permute(0, 2, 1), label)
weighted_loss = (unweighted_loss * weights).mean(dim=1)
return weighted_loss


def train_seq2seq(net, data_iter, lr, num_epochs, tgt_vocab, device):
"""训练序列到序列模型"""
def xavier_init_weights(m):
if type(m) == nn.Linear:
nn.init.xavier_uniform_(m.weight)
if type(m) == nn.GRU:
for param in m._flat_weights_names:
if "weight" in param:
nn.init.xavier_uniform_(m._parameters[param])

net.apply(xavier_init_weights)
net.to(device)

# 优化器:Adam
optimizer = torch.optim.Adam(net.parameters(), lr=lr)

# 损失函数: 带掩码的交叉熵损失函数
loss = MaskedSoftmaxCELoss()

net.train()
animator = d2l.Animator(xlabel='epoch', ylabel='loss',
xlim=[10, num_epochs])


for epoch in range(num_epochs):
timer = d2l.Timer()
metric = d2l.Accumulator(2) # 训练损失总和,词元数量
# batch = (X, X_len, Y, Y_len), X(batch_size, seq_len_x), Y(batch_size, seq_len_y)
for batch in data_iter:
optimizer.zero_grad()
X, X_valid_len, Y, Y_valid_len = [x.to(device) for x in batch]
bos = torch.tensor([tgt_vocab['<bos>']] * Y.shape[0],
device=device).reshape(-1, 1)
dec_input = torch.cat([bos, Y[:, :-1]], 1) # 强制教学
Y_hat, _ = net(X, dec_input, X_valid_len)
#print("check:",Y_hat.shape)
l = loss(Y_hat, Y, Y_valid_len)
l.sum().backward() # 损失函数的标量进行“反向传播”
d2l.grad_clipping(net, 1)
num_tokens = Y_valid_len.sum()
optimizer.step()
with torch.no_grad():
metric.add(l.sum(), num_tokens)
if (epoch + 1) % 10 == 0:
animator.add(epoch + 1, (metric[0] / metric[1],))

print("epoch = ", epoch, " loss = ", metric[0] / metric[1])


print(f'loss {metric[0] / metric[1]:.3f}, {metric[1] / timer.stop():.1f} '
f'tokens/sec on {str(device)}')


"""
预测
src_sentence 为一个样本(X,Y)的X序列(seq_len,)
src_vocab 为源序列的词表
tgt_vocab 为目标序列 词表
num_steps 规定的填充序列长度
"""
#@save
def predict_seq2seq(net, src_sentence, src_vocab, tgt_vocab, num_steps,
device, save_attention_weights=False):
"""序列到序列模型的预测"""
# 在预测时将net设置为评估模式
net.eval()

# 该样本源序列,字符串转token list
src_tokens = src_vocab[src_sentence.lower().split(' ')] + [
src_vocab['<eos>']]

# enc_valid_len 为该样本的源序列的有效长度(不包含填充词的长度)
enc_valid_len = torch.tensor([len(src_tokens)], device=device)
src_tokens = d2l.truncate_pad(src_tokens, num_steps, src_vocab['<pad>'])


# 编码器推理
# 把一个序列,构造成编码器的输入:
# enc_X : ( 1, seq_len=num_steps) )
enc_X = torch.unsqueeze(
torch.tensor(src_tokens, dtype=torch.long, device=device), dim=0)

# 这里的enc_valid_len似乎没有用到
enc_outputs = net.encoder(enc_X, enc_valid_len)
dec_state = net.decoder.init_state(enc_outputs, enc_valid_len)


# 解码器自回归
# 构造一个只含有"bos"开始位的输入的(1, 1 = seq_len), 用来启动自回归
dec_X = torch.unsqueeze(torch.tensor(
[tgt_vocab['<bos>']], dtype=torch.long, device=device), dim=0)

output_seq, attention_weight_seq = [], []

# 我们要预测完一个完整的填充固定长度的序列,除非预测出结束eos
for _ in range(num_steps):
# Y:(batch_size, seq_len_y, vocab_size) (1,1,vocab_size)
# dec_state:(num_layers,batch_size,num_hiddens) (2,1,hidden_size)
Y, dec_state = net.decoder(dec_X, dec_state)

# 我们使用具有预测最高可能性的词元,作为解码器在下一时间步的输入
# 选择token种类的打分最多的一个
# dec_X:(1 , 1) (batch_size, seq_len_y), 此时dec_X就是ID,预测出来的ID
dec_X = Y.argmax(dim=2)

# dec_X (1,1) 转成 int32 ID
pred = dec_X.squeeze(dim=0).type(torch.int32).item()
# 保存注意力权重(稍后讨论)
if save_attention_weights:
attention_weight_seq.append(net.decoder.attention_weights)
# 一旦序列结束词元被预测,输出序列的生成就完成了
if pred == tgt_vocab['<eos>']:
break

# 加入到自己预测的输出序列里面
output_seq.append(pred)
return ' '.join(tgt_vocab.to_tokens(output_seq)), attention_weight_seq


def bleu(pred_seq, label_seq, k): #@save
"""计算BLEU"""
pred_tokens, label_tokens = pred_seq.split(' '), label_seq.split(' ')
len_pred, len_label = len(pred_tokens), len(label_tokens)
score = math.exp(min(0, 1 - len_label / len_pred))
for n in range(1, k + 1):
num_matches, label_subs = 0, collections.defaultdict(int)
for i in range(len_label - n + 1):
label_subs[' '.join(label_tokens[i: i + n])] += 1
for i in range(len_pred - n + 1):
if label_subs[' '.join(pred_tokens[i: i + n])] > 0:
num_matches += 1
label_subs[' '.join(pred_tokens[i: i + n])] -= 1
score *= math.pow(num_matches / (len_pred - n + 1), math.pow(0.5, n))
return score


"""
input_size = 32
hidden_size = 32
隐藏层: 2层
dropout丢弃率 0.1
batch_szie= 64
seq_len = 10
"""
embed_size, num_hiddens, num_layers, dropout = 32, 32, 2, 0.1
batch_size, num_steps = 64, 10
lr, num_epochs, device = 0.005, 200, torch.device("cuda")


train_iter, src_vocab, tgt_vocab = translate.train_iter, translate.src_vocab, translate.tgt_vocab


encoder = Seq2SeqEncoder(len(src_vocab), embed_size, num_hiddens, num_layers,
dropout)
decoder = Seq2SeqDecoder(len(tgt_vocab), embed_size, num_hiddens, num_layers,
dropout)
net = EncoderDecoder(encoder, decoder)
train_seq2seq(net, train_iter, lr, num_epochs, tgt_vocab, device)


engs = ['go .', "i lost .", 'he\'s calm .', 'i\'m home .']
fras = ['va !', 'j\'ai perdu .', 'il est calme .', 'je suis chez moi .']
for eng, fra in zip(engs, fras):
# eng 为一个样本(X,Y)的X序列(seq_len,)
# src_vocab 为源序列的词表
# tgt_vocab 为目标序列 词表
# 规定的填充序列长度
translation, attention_weight_seq = predict_seq2seq(
net, eng, src_vocab, tgt_vocab, num_steps, device)

# 输出自回归的结果,并和标签进行比较评估
print(f'{eng} => {translation}, bleu {bleu(translation, fra, k=2):.3f}')


束搜索

这里讲的搜索办法,是从模型得到的分布中得到一个确定的预测值的方法,也就是从最后一层的MLP的各个token种类的打分中,拿到一个确定的预测。

因为我们的目标是预测T‘个token, 所以我们的目的是为了让:
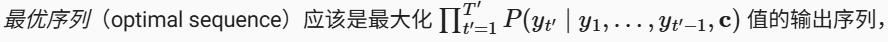
有以下几种方法:

  • 贪心搜索
    • 310
    • 每次都选则当前预测token分布的最大概率,也就是argmax那个操作
    • 计算成本最低
    • 问题:
      • 这属于局部最优,并非全局最优,因为你前面的预测token选择的不一样,会导致下一个token预测的概率分布发生变化。
  • 穷举搜索
    • 计算量太大,精度最高
  • 束搜索
    • 该策略,精度不是最高,成本也不是最低,介于上面两者之间
    • 束搜索(beam search)是贪心搜索的一个改进版本
    • 有一个超参数:束宽k
      • 第一个预测:y1, 我们选择最高条件概率的k个token, 这k个token是候选第一个token预测

      • 第二个预测:y2, 基于前面的k个候选输出预测,继续分化前k个概率最大的。
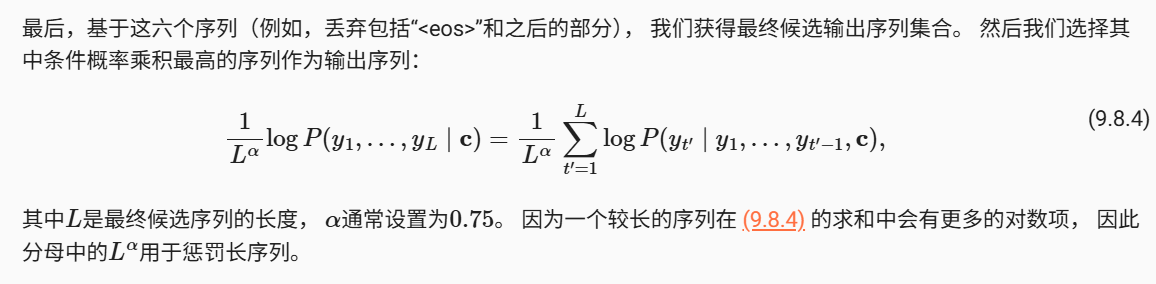
      • 535

那束搜索是如何具体实现的呢?

在序列-序列的编码器解码器模型里面,这个束搜索,要如何来进行实际的运算预测呢?

我的理解是,最初,输入(1,1)=(batch_size, seq_len)的token,也就是bos 来启动自回归,预测k个第一个时间步的预测token,然后这k个预测的token,作为一个新的batch来重新输入吗?

也就是第二个时间步,输入(k, 1) 的小批量,然后产生预测,是这样吗?

但是这样的话,内部的状态要怎么弄?我记得如果一开始输入(1,1)的小批量,batch_size =1, 所以解码器的状态就是:(1, hidden_size), 那这个时候,如果下一次输入的是(k, 1), batch_size = k, 这时候该怎么办呢?

所以束搜索是如何实现的呢?还是说,他把模型预测的进程复制了k份?
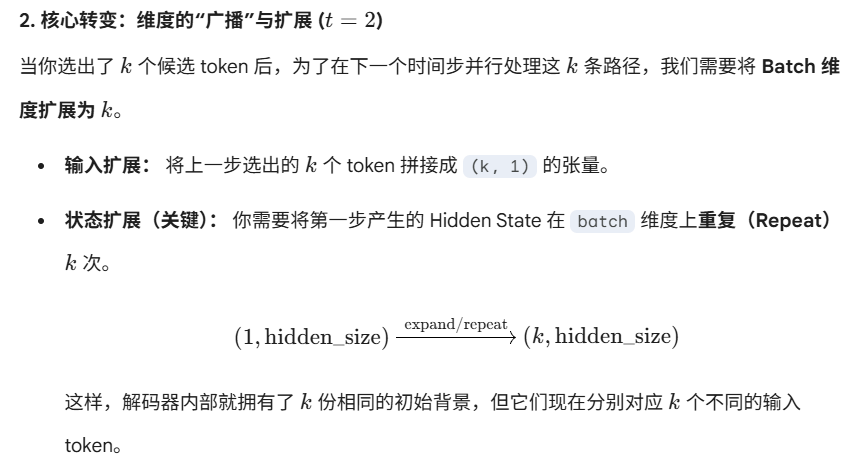
541

502
532

第一层预测了k个,第二层理论上得到k^2个,我需要手动从这k^2个里面筛选出k个, 总之保证每次预测仅保留k个给后面,也就是束(等宽传递)
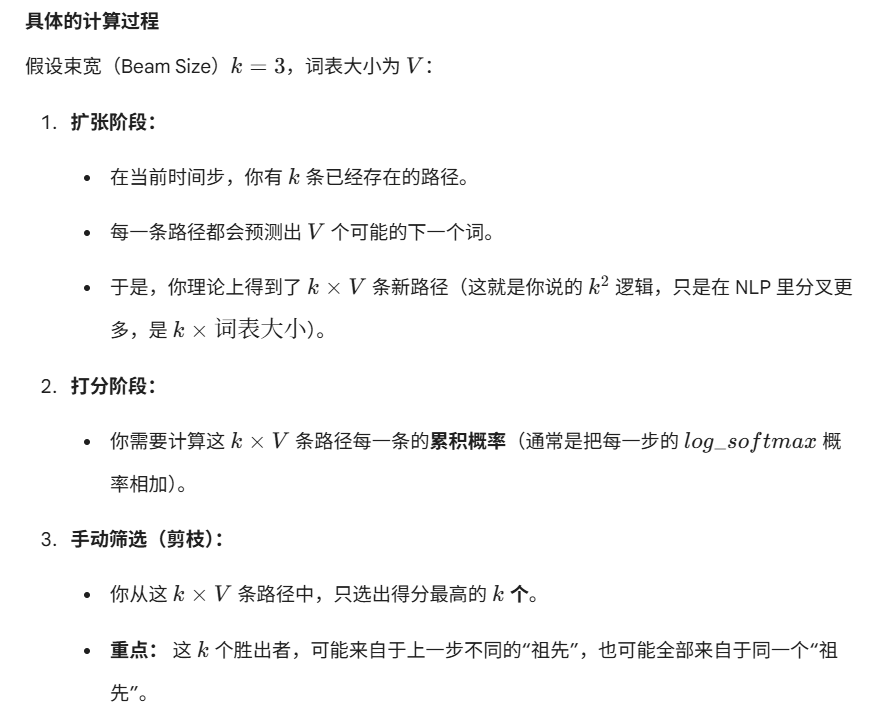
618

补充:TCN

TCN时序卷积神经网络,严格来说他不算RNN,但是他同样是处理序列输入的,借鉴了CNN和RNN,他把序列,看成是一个1xl的图片,通过一个1xk的卷积核,来做卷积运算

卷积核的分类
535

  • full卷积
  • same卷积
  • valid卷积

因果卷积
这里的因果卷积,是说,我们每层卷积层(一个卷积核就是一个通道)的输出序列的每个token,只能向左一对多,不能用未来的输入序列的token来进行
599

膨胀卷积
膨胀卷积的意思,就是,卷积层输出的每个token,原来是依靠原始输入序列的,和kernel_size相同的相邻序列来卷积计算,膨胀卷积,就是原始的输入序列,是采用的隔k隔选一个token,凑够kernel_size,来进行计算
526

d 就是我们的膨胀率, 可以看到,

  • d=1的时候,膨胀卷积,就是我们普通的卷积计算,选择相邻的3隔输入序列(kernel_size=3)
  • d=2的时候,膨胀卷积,是选择的token步长2的3个token,(kernel_size =3)
  • d=4的时候,膨胀卷积,是选择的token步长4的3个token,(kernel_size = 3)
508
换成计算角度,也就是在卷积核里面添加0,这样就可以实现token步长了

551

残差连接

和这里的CNN的通道理解是一样的,你的原始序列,就一个通道,但是经过一层卷积层之后(里面有多个卷积核),会产生多个通道的卷积后的序列。这里就是残差连接里面的部分了,通道数不一样了,所以,如果你这个时候,要残差链接,从旁路,把这多通道的序列,和原始单通道的序列汇合,肯定需要在1这个通路上,用一个1x1的卷积,调整输入序列的通道,变成和残差里面的通道数一致(也就是卷积核的个数)
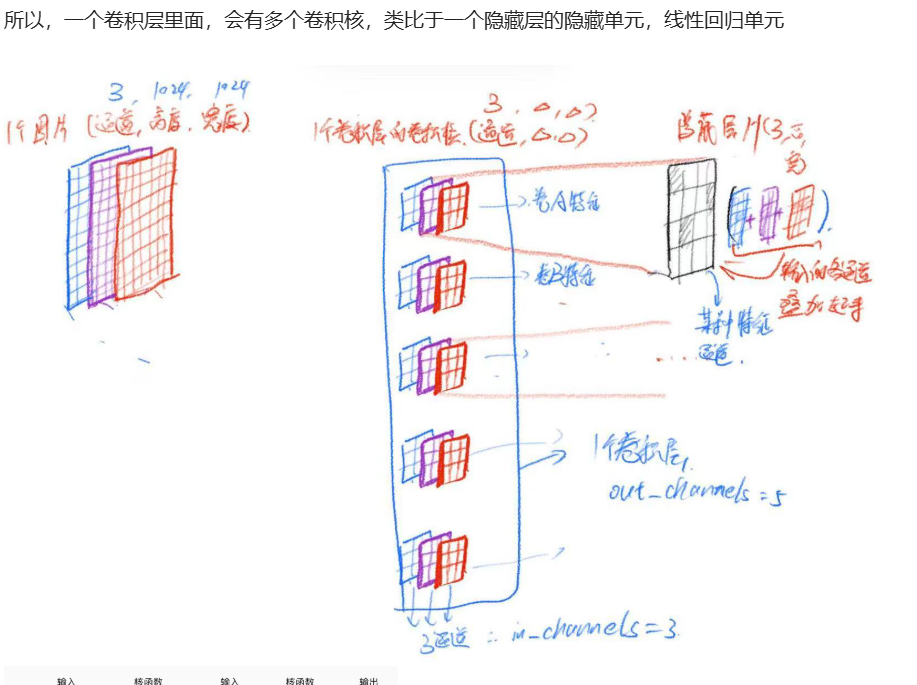
490

注意力机制

注意力提示(Q,K,V)

首先,我们人类的注意力方式,分为主动和被动:

  • 被动注意(非自主性注意):
    • 类似被鲜艳的东西吸引,偏向感官输入(值)
    • 每个值都有对应的键配对(键相当于这些值的都有的一个索引目录)
    • 纯粹从全连接层的输入特征显示出来的焦点(左上角比较红,特征多这种)
  • 主动注意(自主性注意):
    • 虽然我们看到了有焦点的画面,但是我们有自己的意志,想要看右下角的不起眼的内容
    • 通过注意力汇聚层, 把查询(自主性提示)与 键(索引目录)进行匹配,从而引导得出最匹配的值(感官输入)

意思就是假设我们的眼睛是全连接,卷积,出来的某一层的特征就是值V,然后对应的索引就是键K,我们的查询Q和K,通过注意力汇聚层,就是我不看内容V,我只根据目录K,来加入我的意图,也就是注意力,这样Q,K 就形成了类似一个掩码mask层,对V进行过滤
460

572

583

520

注意力汇聚(Watson 核回归)

前面提到Q和K,再通过注意力汇聚,从而得到一张掩码(注意力汇聚)。

这一届,主要介绍Nadaraya-Watson 核回归模型

现在假设有50个样本的训练集训练的模型f(x),我现在输入一个新的x, 我期待他能回归出来一个ypred

平均汇聚
如果是平均汇聚,那么我的f(x)无论输入什么x,回归出来的预测,都是训练集的标签的均值

非参数注意力汇聚
Watson他们提出了一个回归方法,就是如何把训练集的50个样本来训练后,根据输入的未知,对训练集标签,进行加权
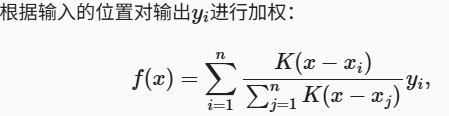
367

其中这个K() 就是核(kernel), 这个公式所描述的一个估计器(模型),被称为 Nadaraya-Watson 核回归

受这个的启发,我们回到前面注意力机制框架的角度,重写这个核回归的估计器,从而得到,一个更加通用的注意力汇聚的公式
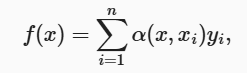
211

其中,x是查询,(xi,yi)是键值对。 这个f(x)输出就是注意力汇聚,也就是加上我们的掩码之后的输出

所以本质上还是加权平均,对所有的值yi,乘上权重α(Q,K)(注意力权重)

所以,这个权重,会被分配给每一个对应的值yi。 对任何查询x(Q), 模型在所有键值对注意力权重α,都是一个有效的概率分布,也就是说,每个值V的权重α(Q,K):

  • 非负
  • 和为1

我们使用一个高斯核,

227
这个核,利用上面的式子,可以组合出α权重,然后乘到每个值上去,最终得到:
367

可以看到就是∑ softmax(-0.5(Q-Ki)2) Vi

也就是说,如果一个键Ki(xi), 越是接近给定的查询x(Q), 那么分配给这个值yi(Vi)的注意力权重就会越大。也就获得了更多的注意力。

此时我们的Nadaraya-Watson核回归是一个非参数模型,所以上面的softmax的构成的注意力汇聚层,实际上,是非参数的注意力汇聚模型

import torch
from torch import nn
from d2l import torch as d2l


"""
创建数据集
"""
n_train = 50 # 训练集 50个样本

# 训练集的输入,随机产生,然后按照从小到大的排序
x_train, _ = torch.sort(torch.rand(n_train)*5)

def f(x):
return 2*torch.sin(x) + x**0.8

# 训练集的标签,并添加高斯噪声
y_train = f(x_train) + torch.normal(0.0, 0.5, (n_train,))


# 测试集
x_test = torch.arange(0,5,0.1)
y_truth = f(x_test)

def plot_kernel_reg(y_hat):

# 预测结果
d2l.plt.plot(x_test, y_hat, 'o', alpha=0.9)

# 测试集
d2l.plt.plot(x_test, y_truth, 'o', alpha=0.5)
"""d2l.plot(x_test, [y_truth, y_hat], 'x', 'y', legend=['Truth', 'Pred'],
xlim=[0, 5], ylim=[-1, 5])"""
# 训练集
d2l.plt.plot(x_train, y_train, 'o', alpha=0.5)


"""
查询Q:x_test, 测试集的输入
键K: x_train, 训练集的输入
值V:y_train, 训练集的标签
"""

X_repeat = x_test.repeat_interleave(n_train).reshape((-1, n_train))
# X_repeat (n_test, n_train), 还是n_test个查询,只不过把每个查询Q,复制成len=n_train的张量
print(X_repeat)


"""
x_test = Q 是(n_test, )
x_train = K 是(n_train, )

X_repeat:
[Q1, Q1, ....., Q1] (n_train列)
[Q2, Q2, ....., Q2]
...
[Qn_test, Qn_test, ....]
"""

# 注意力权重α(Q,Ki)
"""
x_train (n_train, ) = [K1, K2, K3, .... Kn_train]
广播之后:

x_train:
[K1, K2, K3, .... Kn_train]
[K1, K2, K3, .... Kn_train]
...
[K1, K2, K3, .... Kn_train]
n_test行

所以这样形状都是(n_test, n_train), 就可以用矩阵来并行计算了,不用因为两个张量形状不同for循环
X_repeat - x_train = 就是
[Q1 - K1, Q1 - K2, ...., Q1 - Kn_train]
[Q2 - K1, Q2 - K2, ...., Q2 - Kn_train]
...
所以就可以实现对所有的测试集的Qi, 计算得到
[Q1 - Ki]
[Q2 - Ki]
...
就跟batch_size一个道理,一个Qi就是一个样本
我们要计算测试集的每个样本输入Q,他关于所有的训练集的输入Kj的权重

"""
attention_weights = nn.functional.softmax(-(X_repeat - x_train)**2 / 2, dim=1)
# attention_weights (test_batch_size, n_train)

#print(attention_weights.shape)
y_hat = torch.matmul(attention_weights, y_train)
#plot_kernel_reg(y_hat)

就跟batch_size一个道理,一个Qi就是一个样本
我们要计算测试集的每个样本输入Q,他关于所有的训练集的输入Kj的权重

所以,我们的α(Q,Ki),他的形状是(n_test, n_train)

  • n_test 也就是测试集的样本数,test_batch_size
  • n_train 也就是训练集的样本数,train_batch_size
  • 我们的小目标是给定一个测试集的输入Q,计算他关于所有训练集输入K的关联性(用softmax(平方差)表示),
  • 我们的大目标:得到所有的测试集的输入Q,计算他们分别关于训练集输入K的关联性,也就是我们的注意力权重。
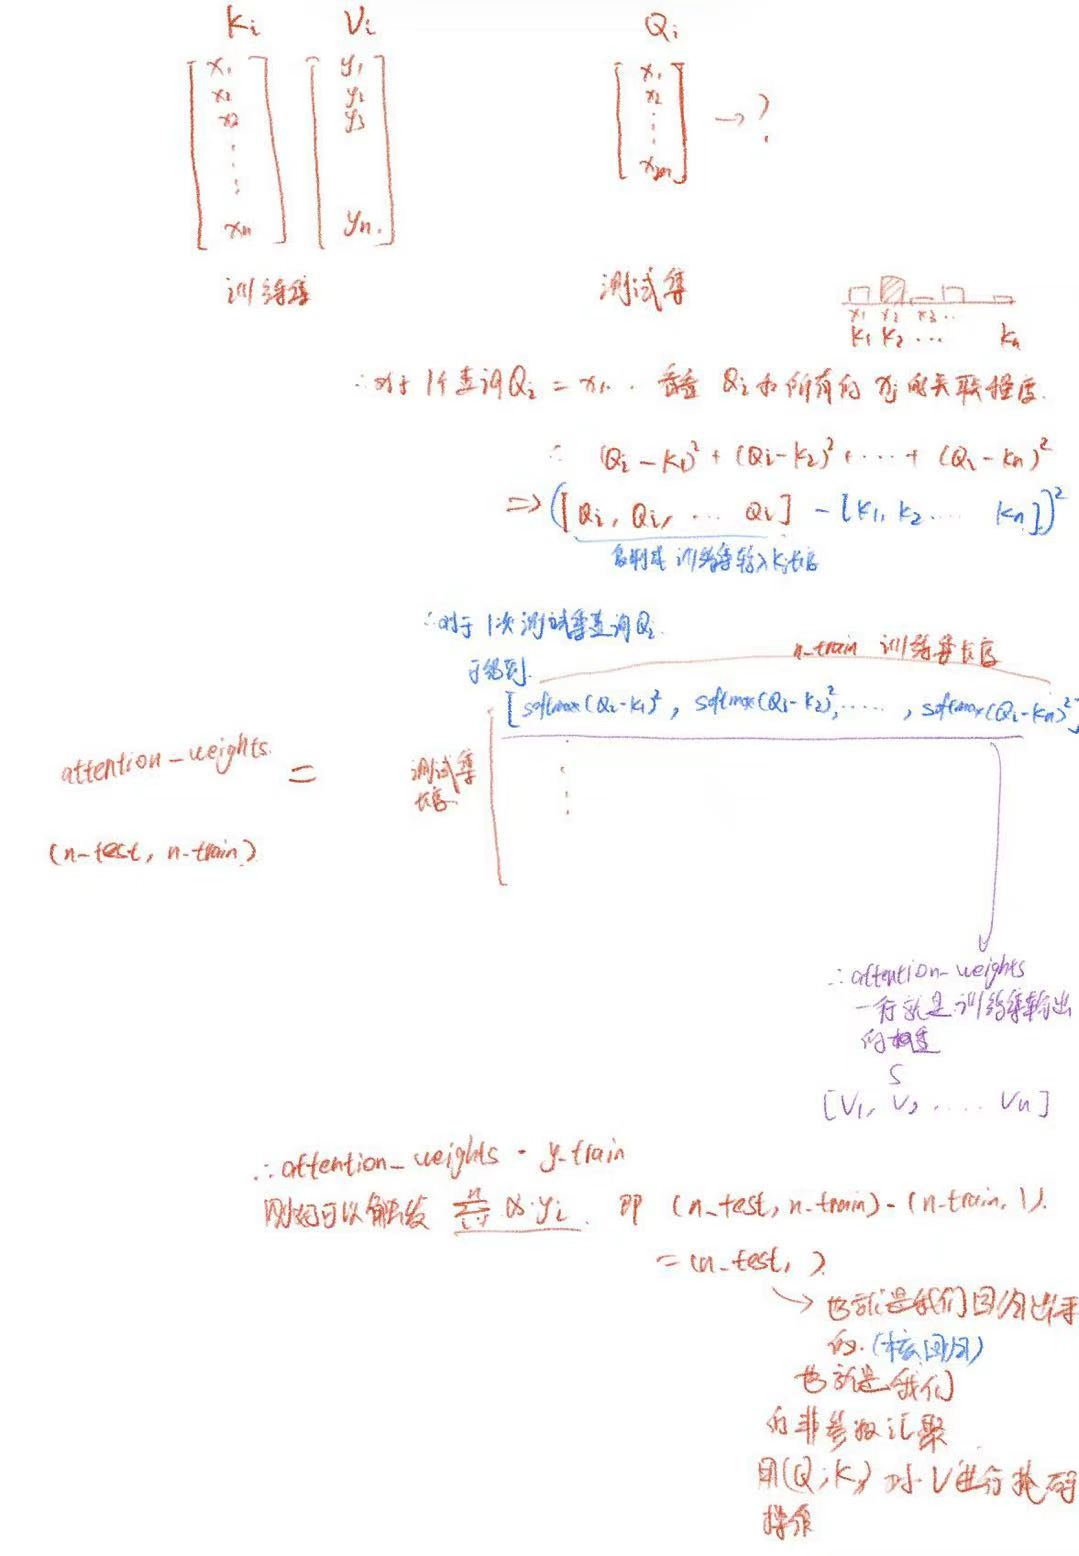
601

所以,这里用测试集,来当作我们的主动注意力的查询Q,可以看到,经过(Q,K)的注意力汇聚层之后,有点像是,让原来的上一层的输出V,按照我的主动注意力Q,调整一下权重变化,这样,得到我们的注意力汇聚, 故名思意,前一层的输出(V),融合了我的Q,得到了新的V’, 也就是注意力汇聚,y_hat
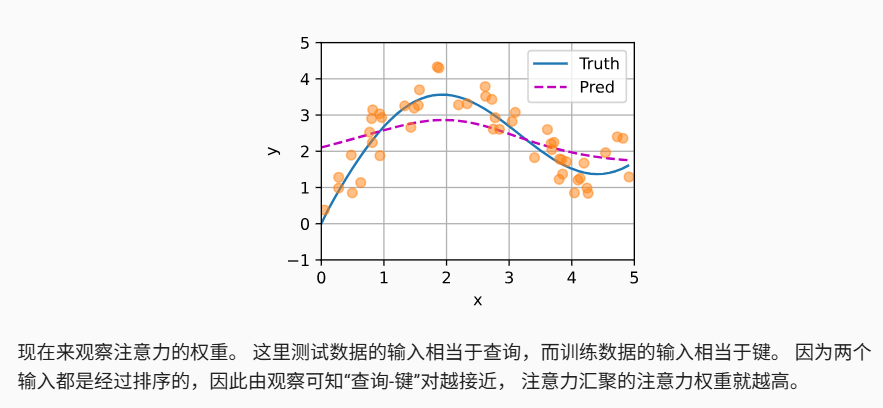
所以,attention_weights, 就是一个注意力权重

带参数的注意力汇聚

我们这里讲的是注意力汇聚层,地位有点像是CNN里面的池化层

非参数的Nadaraya-Watson核回归具有_一致性_(consistency)的优点: 如果有足够的数据,此模型会收敛到最优结果

我们还是可以轻松地将可学习的参数集成到注意力汇聚中
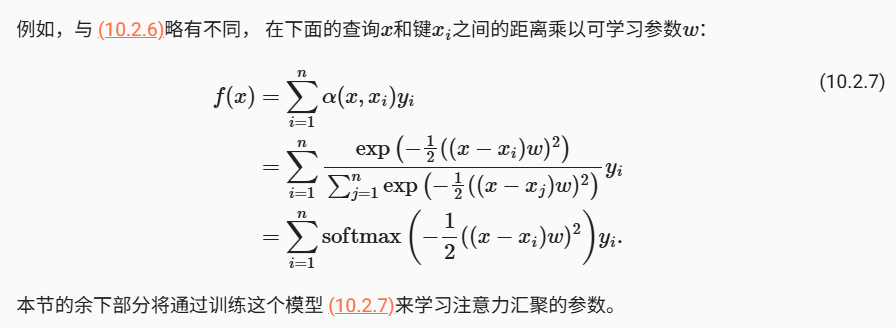
551

对(Q,Ki)的距离计算,乘上了一个系数w

torch的小批量矩阵乘法bmm
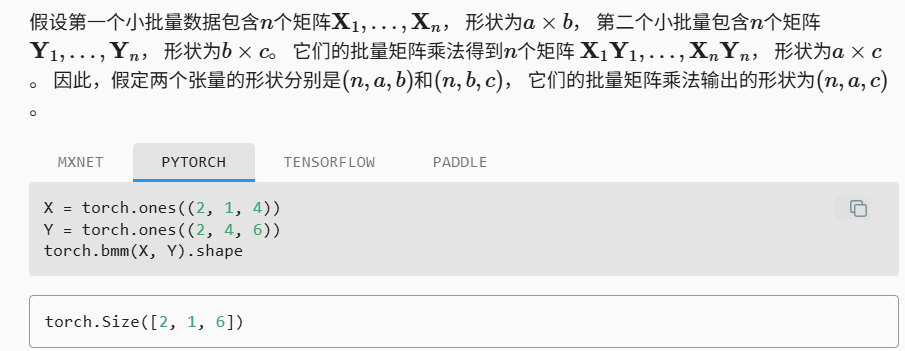
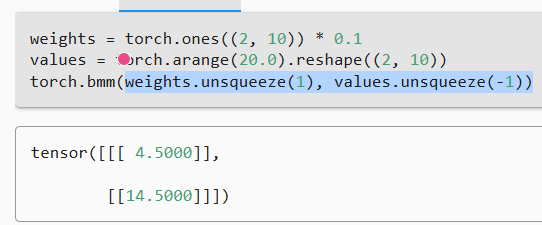
561

378
.unsqueeze(1), 在第一维插入1, 所以是(2,1,10)
.unsqueeze(-1). 在最后一维插入1,所以是(2, 10, 1)
所以最后小批量乘法是(2,1,1)

定义模型

"""
定义了一个注意力汇聚层,拥有一个参数w
"""
class NWKernelRegression(nn.Module):
def __init__(self, **kwargs):
super().__init__(**kwargs)
self.w = nn.Parameter(torch.rand((1,), requires_grad=True))

# 定义了注意力汇聚层的一次前向传播
def forward(self, queries, keys, values):
# queries和attention_weights的形状为(查询个数,“键-值”对个数)
"""
queries (n_test, n_train) (查询个数,“键-值”对个数)
attention_weights (n_test, n_train ) (查询个数,“键-值”对个数)
"""
queries = queries.repeat_interleave(keys.shape[1]).reshape((-1, keys.shape[1]))
self.attention_weights = nn.functional.softmax(
-((queries - keys) * self.w)**2 / 2, dim=1)
# values的形状为(查询个数,“键-值”对个数)
return torch.bmm(self.attention_weights.unsqueeze(1),
values.unsqueeze(-1)).reshape(-1)

训练
用训练数据集的留一法,构造Q,K,V

# X_tile的形状:(n_train,n_train),每一行都包含着相同的训练输入
X_tile = x_train.repeat((n_train, 1))
# Y_tile的形状:(n_train,n_train),每一行都包含着相同的训练输出
Y_tile = y_train.repeat((n_train, 1))
# keys的形状:('n_train','n_train'-1)
keys = X_tile[(1 - torch.eye(n_train)).type(torch.bool)].reshape((n_train, -1))
# values的形状:('n_train','n_train'-1)
values = Y_tile[(1 - torch.eye(n_train)).type(torch.bool)].reshape((n_train, -1))


net = NWKernelRegression()
loss = nn.MSELoss(reduction='none')
trainer = torch.optim.SGD(net.parameters(), lr=0.5)
animator = d2l.Animator(xlabel='epoch', ylabel='loss', xlim=[1, 5])

for epoch in range(5):
trainer.zero_grad()
l = loss(net(x_train, keys, values), y_train)
l.sum().backward()
trainer.step()
print(f'epoch {epoch + 1}, loss {float(l.sum()):.6f}')
animator.add(epoch + 1, float(l.sum()))

476

测试注意力汇聚

n_test = len(x_test)

# keys的形状:(n_test,n_train),每一行包含着相同的训练输入(例如,相同的键)

keys = x_train.repeat((n_test, 1))

# value的形状:(n_test,n_train)

values = y_train.repeat((n_test, 1))

y_hat = net(x_test, keys, values).unsqueeze(1).detach()

plot_kernel_reg(y_hat)

418

546

注意力评分函数(重要)

前面使用了高斯核来对查询和键之间的关系建模

547

 (10.2.6)中的 高斯核指数部分可以视为_注意力评分函数_(attention scoring function), 简称_评分函数_(scoring function),然后把这个函数的输出结果输入到softmax函数中进行运算

通过上述步骤,将得到与键对应的值的概率分布(即注意力权重)。 最后,注意力汇聚的输出就是基于这些注意力权重的值的加权和。
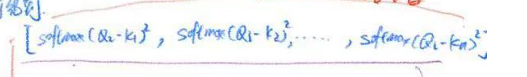
从宏观来看,上述算法可以用来实现 图10.1.3中的注意力机制框架
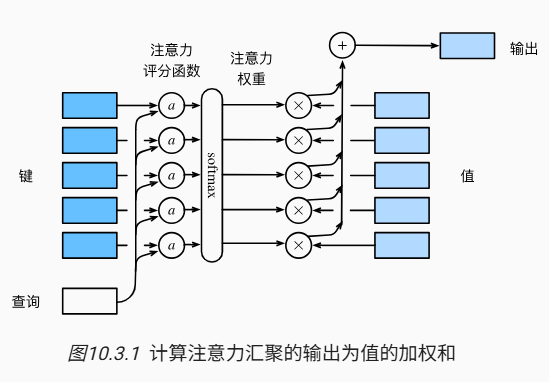
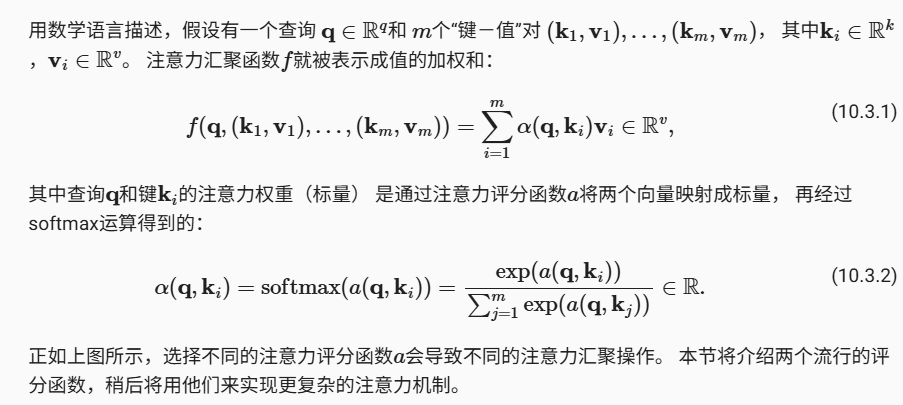
657

所以,q,k就是索引与索引之间的匹配关联程度,然后按照样本的标签,回归我们自己的预测。

softmax()里面的q,ki的计算方法,叫做评分函数

掩蔽softmax操作
这个在序列到序列学习这一节已经学过了

指定每个序列的有效token长度 = valid_len 是一个list
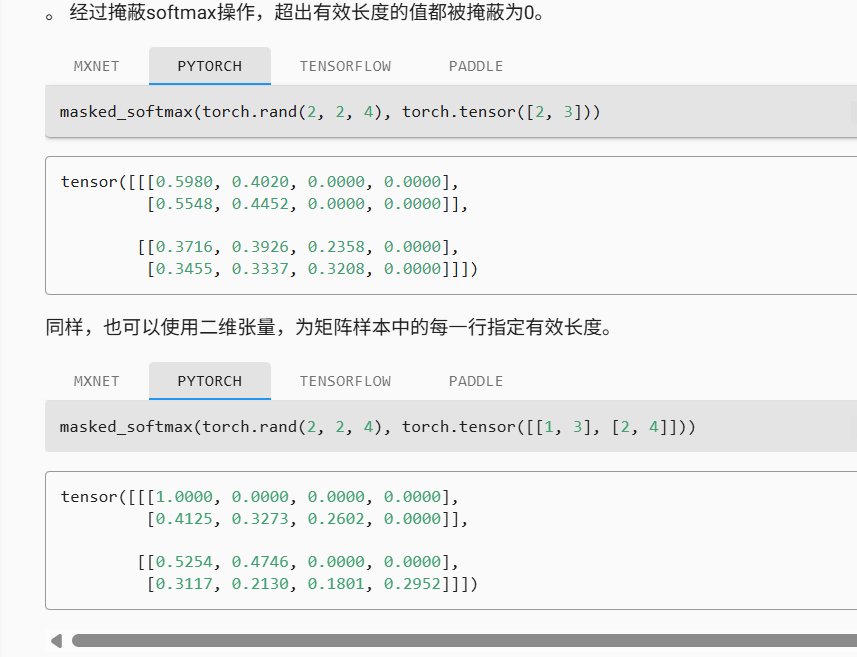
619

加性注意力 (当查询和键是不同长度的矢量时,可以使用可加性注意力评分函数)
一般来说,当Q,K是不同长度的向量时,可以使用加性注意力 作为评分函数
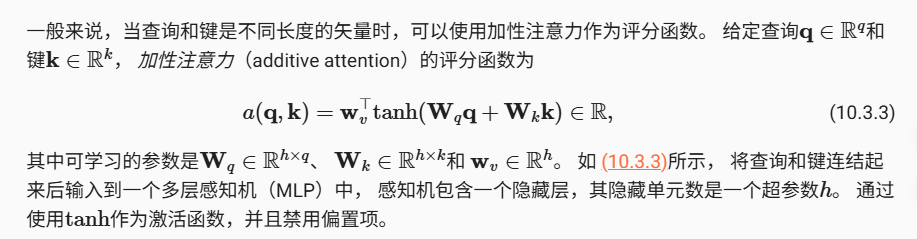
softmax(a(q,ki))

说白了,就是用全连接来实现维度的统一

缩放点积注意力(当它们的长度相同时,使用缩放的“点-积”注意力评分函数的计算效率更高)
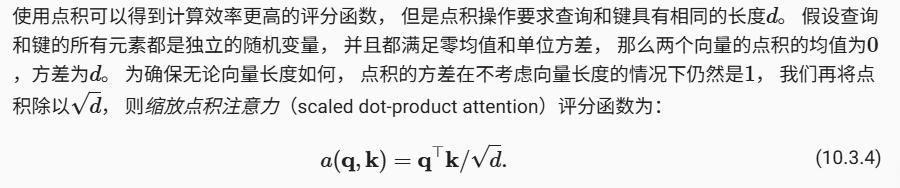

531

缩放点积注意力权重的实现:包含评分函数+softmax

#@save
class DotProductAttention(nn.Module):
"""缩放点积注意力"""
def __init__(self, dropout, **kwargs):
super(DotProductAttention, self).__init__(**kwargs)
self.dropout = nn.Dropout(dropout)

# queries的形状:(batch_size,查询的个数,d)
# keys的形状:(batch_size,“键-值”对的个数,d)
# values的形状:(batch_size,“键-值”对的个数,值的维度)
# valid_lens的形状:(batch_size,)或者(batch_size,查询的个数)
def forward(self, queries, keys, values, valid_lens=None):
d = queries.shape[-1]
# 设置transpose_b=True为了交换keys的最后两个维度
scores = torch.bmm(queries, keys.transpose(1,2)) / math.sqrt(d)
self.attention_weights = masked_softmax(scores, valid_lens)
return torch.bmm(self.dropout(self.attention_weights), values)

热力图查看
489


Bahdanau 注意力

前面,我们学会了一个层,叫做注意力汇聚层,然后我们里面使用的是缩放点积注意力评分函数

再前面的序列-序列的模型,通过设计一个基于两个循环神经网络的编码器-解码器架构, 用于序列到序列学习

然而,即使并非所有输入(源)词元都对解码某个词元都有用, 在每个解码步骤中仍使用编码_相同_的上下文变量。 有什么方法能改变上下文变量呢?

原来的上下文变量C,里面包含了所有的源序列的token的信息,但是不是所有的源序列的token都有用,所有在这里做一点改变

Bahdanau等人提出了一个没有严格单向对齐限制的 可微注意力模型

在预测词元时,如果不是所有输入词元都相关,模型将仅对齐(或参与)输入序列中与当前预测相关的部分,这是通过将上下文变量视为注意力集中的输出来实现的

下面描述的Bahdanau注意力模型

这个新的基于注意力的模型与 9.7节中的模型相同, 只不过 (9.7.3)中的上下文变量C,在任何解码器的时间步t’, 都会被Ct’替换(就是解码器在自回归的过程中,也会调整上下文变量C)

假设解码器的输入序列是T个token, 解码时间步t’ 的上下文更新后 = 注意力集中的输出:
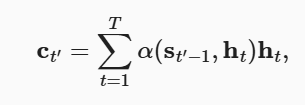
st’-1, 是查询=解码器上一时刻的隐状态,
编码器隐状态ht 视为键和值)

编码器在解码器运行前,就已经跑完了,所以他的所有层的最终状态,作为解码器的初始状态。也就是我们的K,V
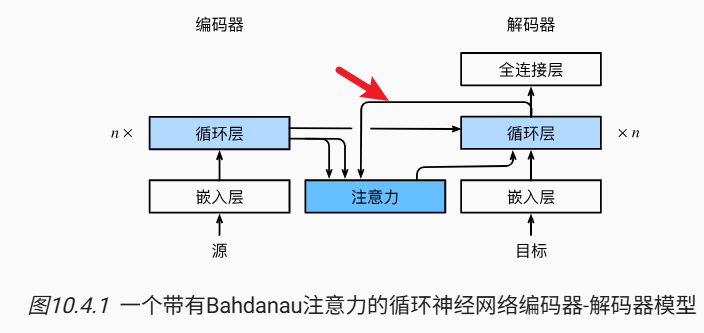
499

所以这样的注意力模型,如上所示。

在大模型里面,RNN的编码器解码器已经不用了,现在主流是transformer,所以这一节不算特别重要

import torch
from torch import nn
from d2l import torch as d2l


class AttentionDecoder(d2l.Decoder):
"""带有注意力机制解码器的基本接口"""
def __init__(self, **kwargs):
super(AttentionDecoder, self).__init__(**kwargs)

@property
def attention_weights(self):
raise NotImplementedError


class Seq2SeqAttentionDecoder(AttentionDecoder):
def __init__(self, vocab_size, embed_size, num_hiddens, num_layers,
dropout=0, **kwargs):
super(Seq2SeqAttentionDecoder, self).__init__(**kwargs)

# 注意力集中层,利用编码器的状态,以及解码器的当前状态,产生上下文变量
# 这里使用的是加性注意力,不是缩放点积注意力
self.attention = d2l.AdditiveAttention(
num_hiddens, dropout, **kwargs)

# 嵌入层,用来把token转换成(embed_size, )的格式
self.embedding = nn.Embedding(vocab_size, embed_size)

# 解码器的循环神经网络
# 输入:(batch_size, y_seq_len, embed_size + hidden_size)
self.rnn = nn.GRU(
embed_size + num_hiddens, num_hiddens, num_layers,
dropout=dropout)

# 产生token种类的打分的全连接层
self.dense = nn.Linear(num_hiddens, vocab_size)

def init_state(self, enc_outputs, enc_valid_lens, *args):
# outputs的形状为(batch_size,num_steps,num_hiddens).
# hidden_state的形状为(num_layers,batch_size,num_hiddens)
outputs, hidden_state = enc_outputs
return (outputs.permute(1, 0, 2), hidden_state, enc_valid_lens)

"""

编码器的输入
X(batch_size, seq_len)
state (layer_num, batch_size, hidden_size)
"""
def forward(self, X, state):
enc_outputs, hidden_state, enc_valid_lens = state
# enc_outputs的形状为(batch_size,num_steps,num_hiddens). 为编码器最后一层隐状态的所有历史状态
# hidden_state的形状为(num_layers,batch_size, num_hiddens),为编码器所有层最后一个时间步的状态

X = self.embedding(X).permute(1, 0, 2)
# 输出X的形状为(num_steps,batch_size,embed_size), 可以开始内部循环自回归了

outputs, self._attention_weights = [], []
for x in X:
# 对于每一个时间步,x (batch_size, embed_size)
# query的形状为(batch_size,1,num_hiddens)
# hidden_state的形状为(num_layers,batch_size, num_hiddens)
query = torch.unsqueeze(hidden_state[-1], dim=1)
# query(batch_size, 1, hidden_size),为编码器最后一层隐状态最终时间步的状态


# context的形状为(batch_size,1,num_hiddens)
# query就是Q,enc_outputs就是K,enc_outputs就是V
# K,V = enc_outputs的形状为(batch_size,num_steps,num_hiddens).
context = self.attention(
query, enc_outputs, enc_outputs, enc_valid_lens)
# context 就是 ct', 为解码器该时间步的注意力集中的输出


# 在特征维度上连结
x = torch.cat((context, torch.unsqueeze(x, dim=1)), dim=-1)

# 将x变形为(1,batch_size,embed_size+num_hiddens)
out, hidden_state = self.rnn(x.permute(1, 0, 2), hidden_state)

outputs.append(out)
self._attention_weights.append(self.attention.attention_weights)
# 全连接层变换后,outputs的形状为
# (num_steps,batch_size,vocab_size)
outputs = self.dense(torch.cat(outputs, dim=0))
return outputs.permute(1, 0, 2), [enc_outputs, hidden_state,
enc_valid_lens]

@property
def attention_weights(self):
return self._attention_weights


"""
encoder = d2l.Seq2SeqEncoder(vocab_size=10, embed_size=8, num_hiddens=16,
num_layers=2)
encoder.eval()
decoder = Seq2SeqAttentionDecoder(vocab_size=10, embed_size=8, num_hiddens=16,
num_layers=2)
decoder.eval()
X = torch.zeros((4, 7), dtype=torch.long) # (batch_size,num_steps)
state = decoder.init_state(encoder(X), None)
output, state = decoder(X, state)
print(output.shape, len(state), state[0].shape, len(state[1]), state[1][0].shape)

"""


"""
训练
"""

class EncoderDecoder(nn.Module):
"""编码器-解码器架构的基类"""
def __init__(self, encoder, decoder, **kwargs):
super(EncoderDecoder, self).__init__(**kwargs)
self.encoder = encoder
self.decoder = decoder

def forward(self, enc_X, dec_X, *args):
enc_outputs = self.encoder(enc_X)
dec_state = self.decoder.init_state(enc_outputs, *args)
dec_outputs, dec_state = self.decoder(dec_X, dec_state)
# 这里只返回 2 个值:预测输出和解码器状态
return dec_outputs, dec_state


embed_size, num_hiddens, num_layers, dropout = 32, 32, 2, 0.1
batch_size, num_steps = 64, 10
lr, num_epochs, device = 0.005, 250, d2l.try_gpu()

train_iter, src_vocab, tgt_vocab = d2l.load_data_nmt(batch_size, num_steps)
encoder = d2l.Seq2SeqEncoder(
len(src_vocab), embed_size, num_hiddens, num_layers, dropout)
decoder = Seq2SeqAttentionDecoder(
len(tgt_vocab), embed_size, num_hiddens, num_layers, dropout)
net = EncoderDecoder(encoder, decoder)
d2l.train_seq2seq(net, train_iter, lr, num_epochs, tgt_vocab, device)


"""测试"""
engs = ['go .', "i lost .", 'he\'s calm .', 'i\'m home .']
fras = ['va !', 'j\'ai perdu .', 'il est calme .', 'je suis chez moi .']
for eng, fra in zip(engs, fras):
translation, dec_attention_weight_seq = d2l.predict_seq2seq(
net, eng, src_vocab, tgt_vocab, num_steps, device, True)
print(f'{eng} => {translation}, ',
f'bleu {d2l.bleu(translation, fra, k=2):.3f}')


自注意力+位置编码


就是对X增加了一层摩尔纹意义,这个sin,cos的设计,主要目的是为了模仿二进制编码的变化频率,(地位变化频率高,高位变化频率低),简单说就是:
该序列的第i个token,他有d维,j∈d,然后按照奇数偶数的不同来得到一个固定的编码值,他的好处是,在j,也就是d维里面比较低的位置,变化的频率快,高维的位置,变化的频率慢(模拟二进制编码的变化)
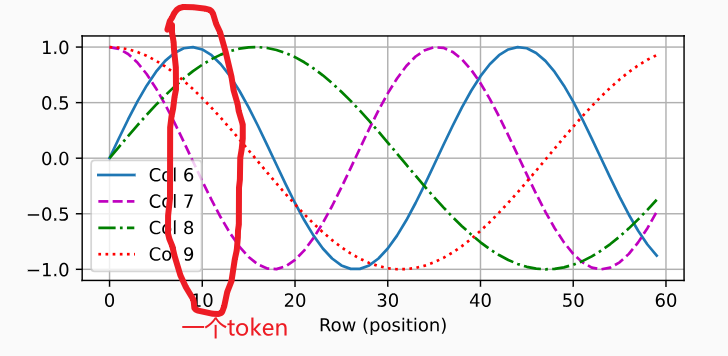
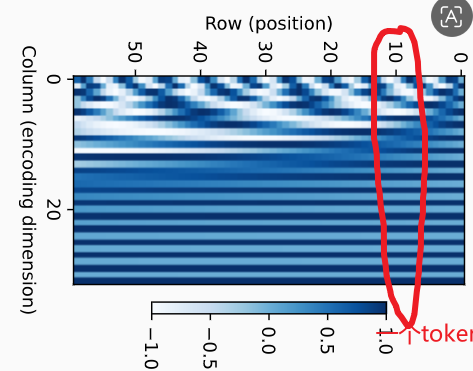
453


可以看到,一个token的d位,低位变化密集,高位变化慢,本质上就是叠了一层二进制地址(address + value, 可以理解为,在这块内存的数据上,加了内存的地址),上图就是模拟二进制地址本身热力图的变化

多头注意力(重要)
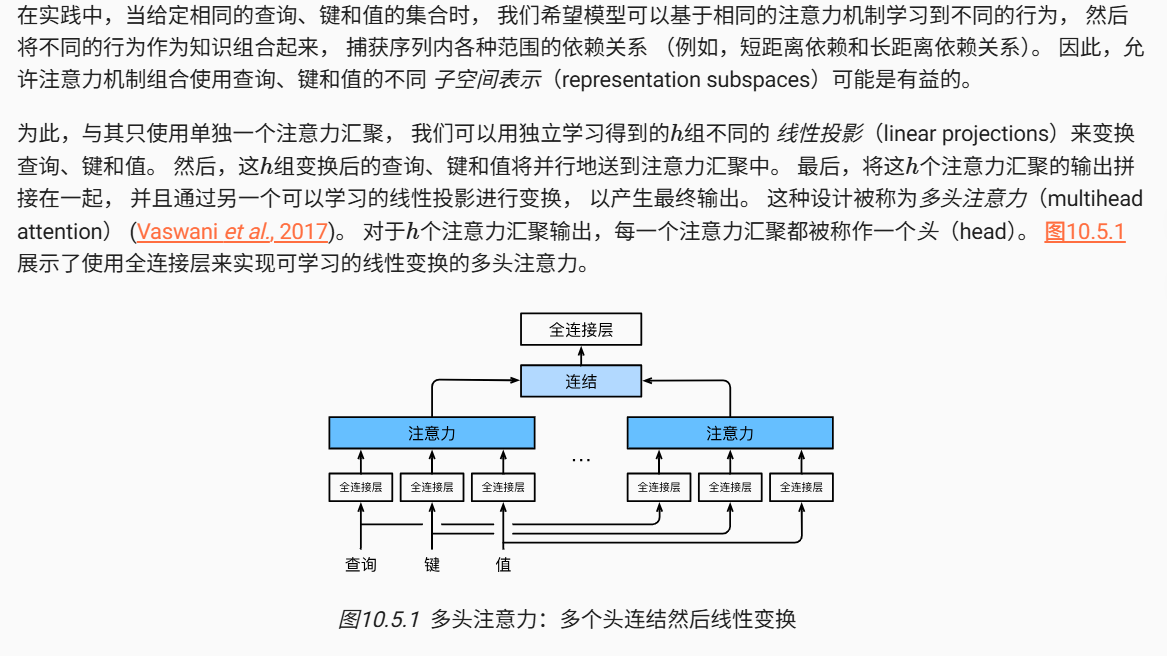
614

使用的是Q,K,V的不同子空间的表示。

也就是,把QKV,进入MLP,投影到不同的特征空间,然后再进入注意力层回归出我们需要的Q的V‘

原来我们的注意力层:h = f(q,k,v)=f(q, (k1,v1), (k2,v2), …,(kn,vn))
现在多头注意力的一个头是hi = f(Wi(q)q, Wi(k)k, Wi(v)v)
也就是每个头,q,k,v都要经过一个独立的全连接层,投影到相同的h维度的特征空间上,然后在完成后续的注意力计算。
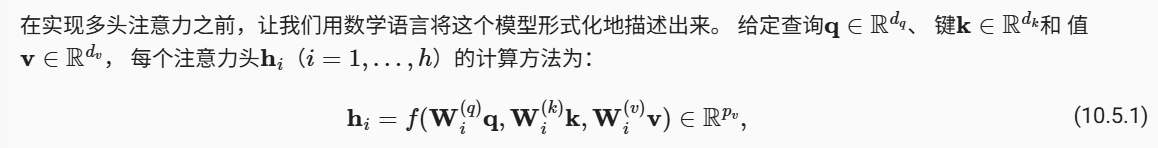
所以,一共有hx3个参数需要学习
f的注意力计算,我们一般使用加性注意力(带参:wv* tanh(wqxq + wk x k))/缩放点积注意力(无参)
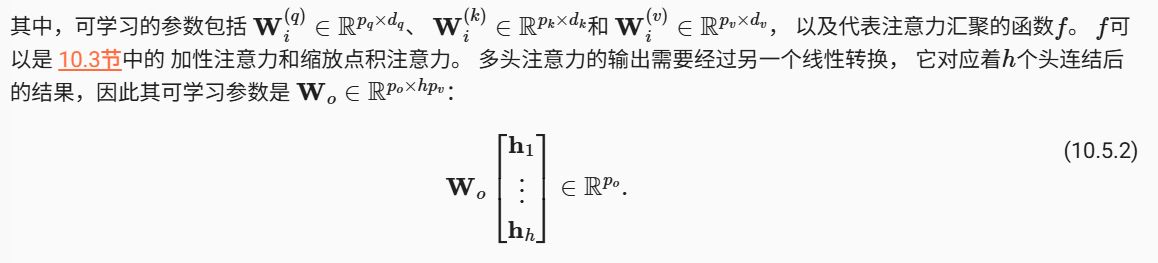
659

494
592

我理解了,因为每个头是并行的存在,所以,我为了并行计算,所以,必须用一个大矩阵Wq = [Wq1, Wq2, Wq3,….,Wqh]来同时作用在q上,得到[q1, q2, q3, …, qh] 就可以实现多头的并行。

所以我的全连接的输出hidden_size = num_heads * query_size 是吗?

那这样的话,如果q,k,v不是一个d, 那岂不是,Q,K,V的全连接输出的hidden_size, 也是不一样的?

然后呢,我为什么需要使用transpose_qkv,来把这一整个的[q1, q2, q3, …, qh],拆分成h个头的专属q,k,v? 是因为不能让头1的q,也算到头2的KV是吧

我这里还有一个疑问,既然是并行计算每个头的pq, pk, pv, 那我直接设置一个大的Wq = [Wq1, Wq2, Wq3,….,Wqh], 因为我初始化不一样,所以里面每个头的全连接的参数都不一样,
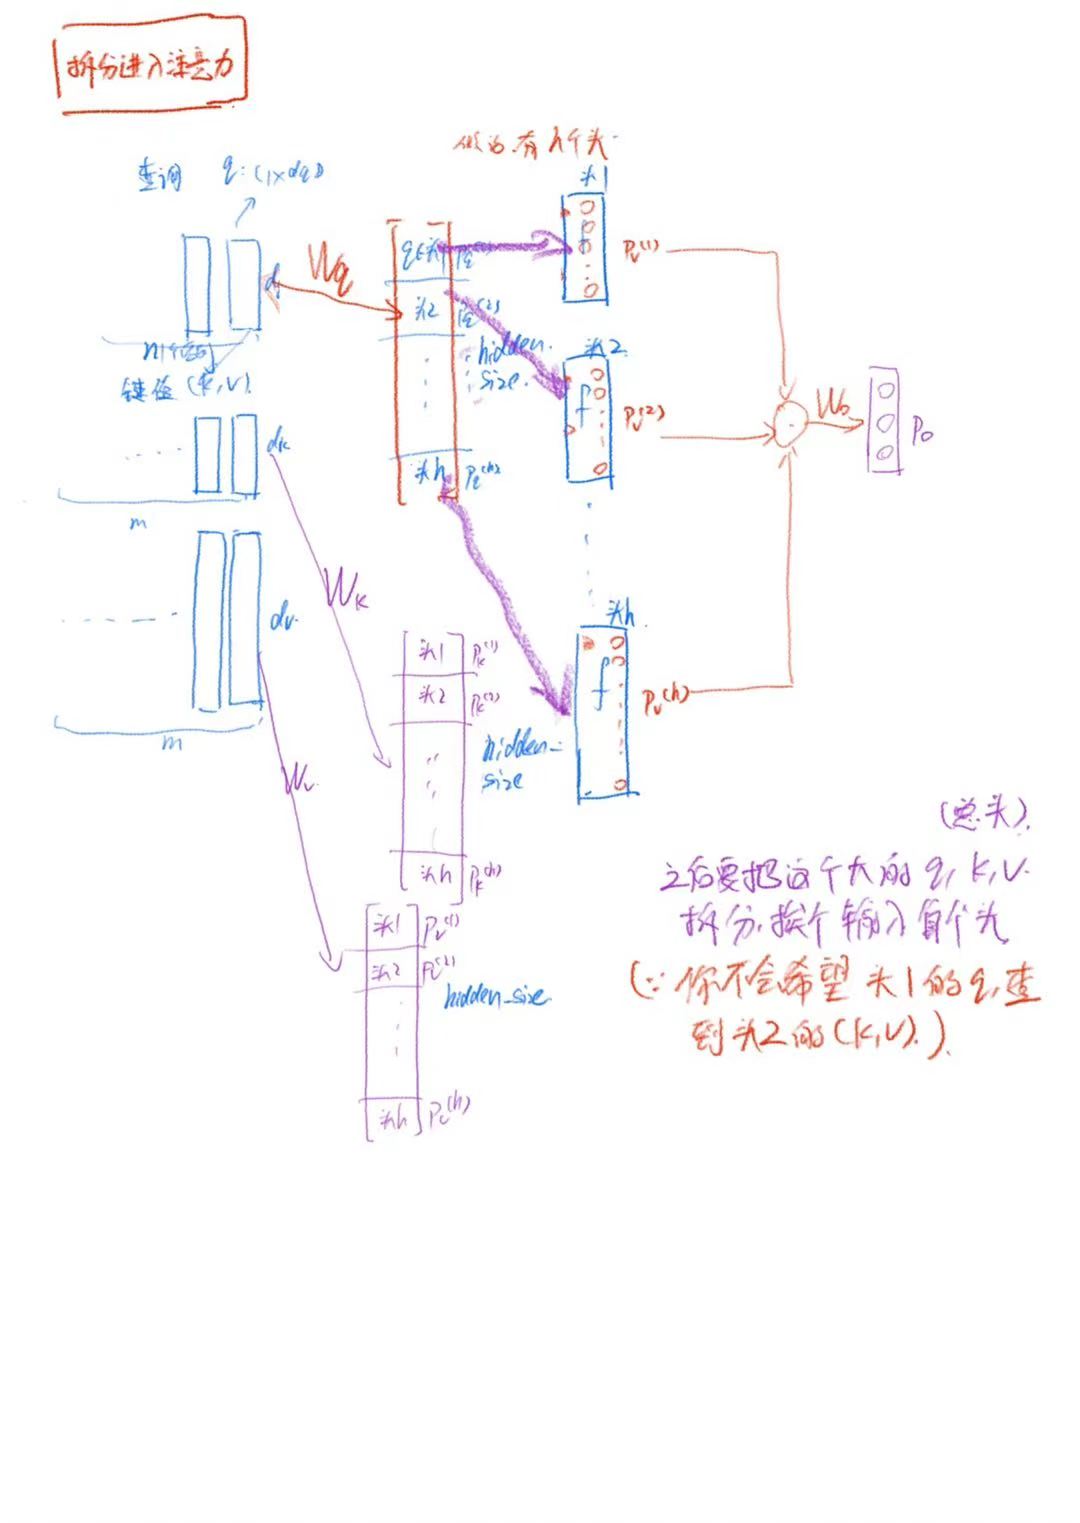
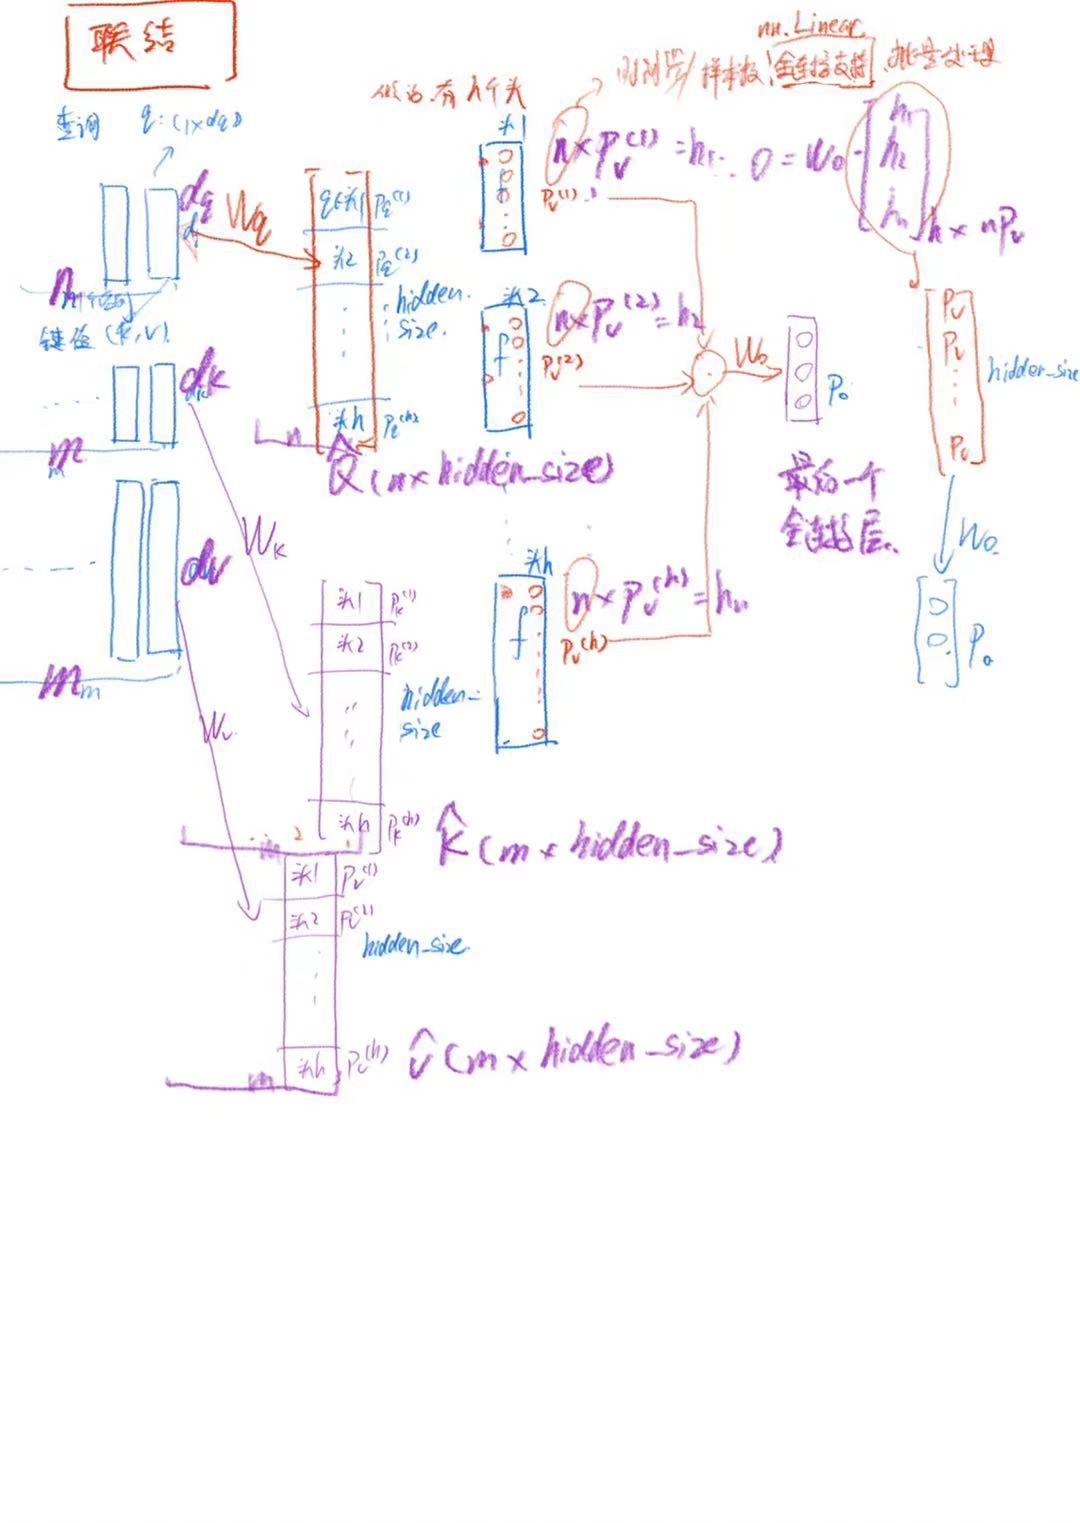
全连接变维度,又是每个头只注意高维空间的部分维,最后又全连接整合映射到一个低维上

是:先拆分升维做多视角建模,再拼接降维做特征融合

总结

朴素注意力机制
所以注意力机制,依赖(K,V)数据库,以及我们的输入查询Q,

他的作用是,通过计算(K,V)中,不同的ki, 对 Q的贡献程度,来实现输入Q的回归预测
注意力权重,就是显示Q和Ki们的贡献程度

所以注意力机制,是没有模型参数的

全连接层,则是把数据的关系,全部训练到模型参数里面

transformer里面的注意力(多头注意力)

所以实际的transformer注意力里面,是先用全连接,把Q,K,V映射到合适做注意力回归的空间(MLP来改变数据维数,也就是空间变形,投影)然后在这个特征空间里面,再来做朴素注意力回归

Bahdanau注意力
原来seq2seq,使用到编码器-解码器的架构,里面用到两层的GRU,此时他的模型参数,主要是里面的RNN的模型参数,他的主要两个设计点是:

  • 编码器最后一层隐藏层的最后一个时间步的状态hT 作为上下文变量context
  • 编码器所有隐藏层的最后一个时间步的状态[hT,hT], 作为解码器的隐藏层的初始状态[s0, s0]

然后再bahdanau注意力里面,通过引入注意力层,来改进这个seq2seq的模型

他的改进是:

  • 上下文变量,不再是一成不变的,而是,我在输入解码器的x1’之前,编码器已经把源序列都输入完成了

因此,我们已经得到了编码器最后一层的所有时间步的状态[h1,h2,…,hT], 我们把这个状态作为K,V,把解码器在接受输入xt’时,他的上一时刻的状态st’-1, 所谓查询,把q,K,V 作为我们的注意力层的输入(这里有一个细节,就是纳入KV的计算,是源序列的所有T时间步的KV)从而得到真实的,根据我们当前解码器的时间步t’的,上下文变量context,然后和输入xt‘合并,输入解码器
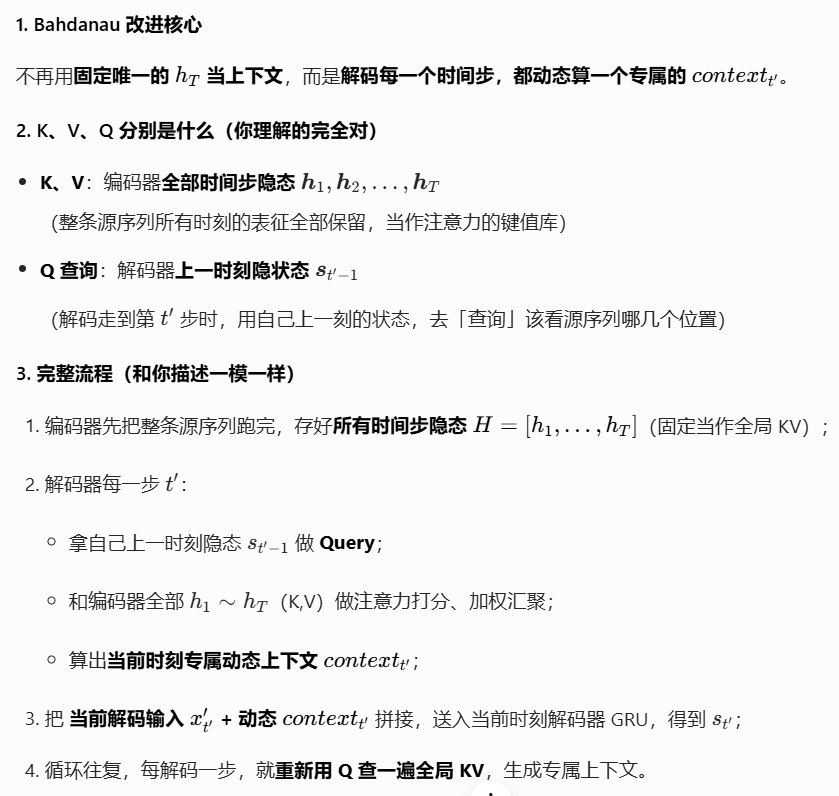
590

499

编码器遮罩(填充掩码:enc_valid_len)

530

解码器自身的遮罩
这个是自注意力,不能让当前时间步,看到未来时刻的token

自注意力

自注意力层,我知道他计算出的自注意力权重,可以反应一个序列中,一个token和其他token的相关程度。

但是我想知道,这个自注意力权重,乘上V(整个序列)之后,有什么意义呢?这个新的序列,有什么意义呢?
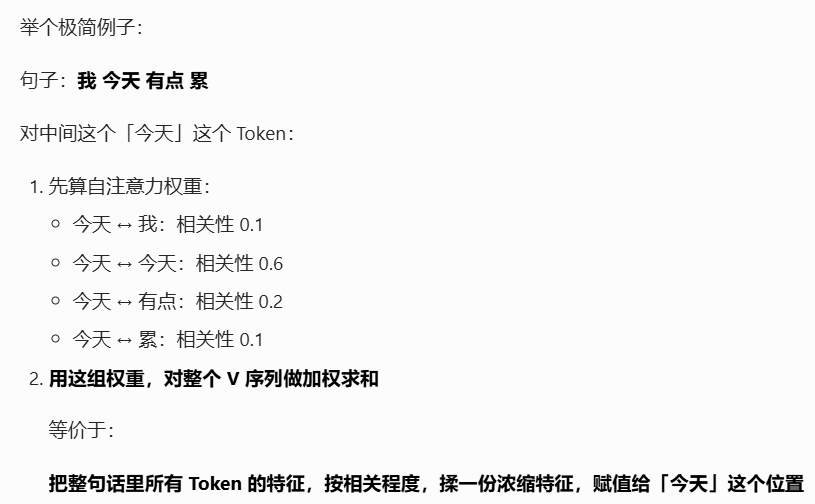
456

455

所以作用就是,让这个token,里面能够包含整个序列的上下文信息
(对比RNN,只能从左到右挨个计算攒上下文,远距离的依赖弱
自注意力,直接并行计算,可以把序列内全部的token信息,全部融合到每个token里面
)

但是,这个自注意力层,有一个问题:就是没有未知关系。只有相对的token2token的关系,没有第一位,第二位的时序关系。

所以,才需要,位置编码

位置编码可以通过学习得到也可以直接固定得到

掩码多头自注意力:

解码器的第一层,是掩码自注意力,如果没有掩码,他就会直接计算目标序列的所有token关于其他全部token的关联,加上掩码之后,只计算该目标序列和之前目标序列的相关程度
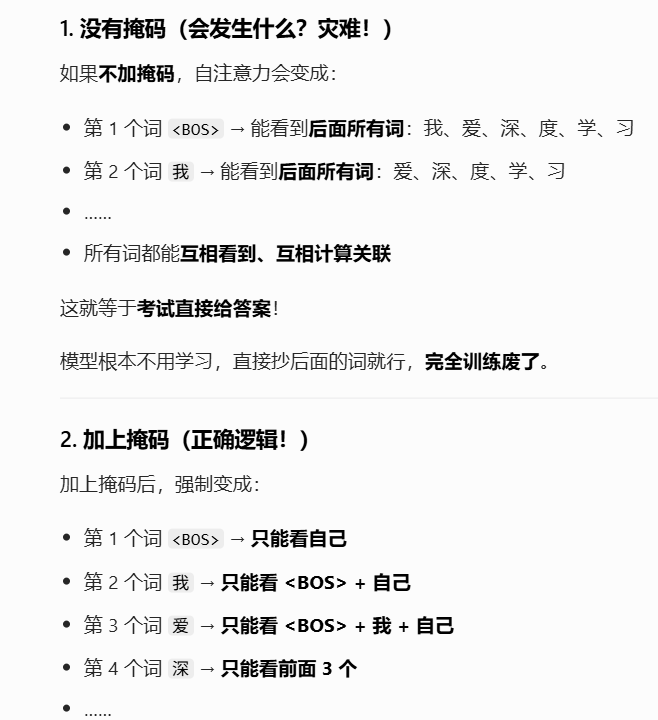
307

我们先讨论训练情况,我一次性输入目标序列,然后多头掩码自注意力,计算第i个token和和前面i-1个token的相关性,作为这个token的注意力权重,所以这个多头掩码自注意力,输出的还是一个序列
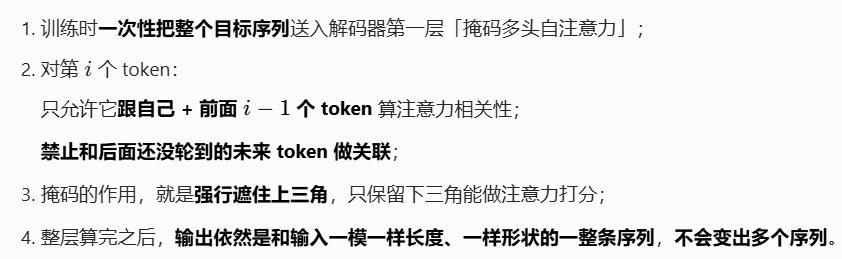
570

所以transformer自回归,因为有多头自注意力开头的原因,所以,每次自回归,都是把自己预测出来的token,和之前的历史token序列拼起来,然后再输送回解码器开头,增加计算这个token关于历史token的自注意力

QA

我想知道,在训练阶段,是一口气输入目标序列, 经过掩码多头自注意力后,生成的序列,每个token:

  1. 知道自己和之前的token的关系(掩码自注意)
  2. 每个token知道自己更高维的特征(多头) 是吧
  1. 我很好奇,我要如何理解这个掩码多头自注意力的输出序列的数学含义呢?(就是我好奇他训练阶段,一口气输入,然后最终解码器产生的序列也是一口气输出,就是整个输入序列的后一个token的预测是吧。这个后一个,是由掩码来决定的)

然后这个掩码多头自注意力的输出序列,(里面携带了哪些信息?)输入多头注意力,KV是编码器对源序列的处理结果(该KV序列,蕴含了原始序列的哪些信息?我要如何形象的理解?)

然后呢,这个多头注意力层,以编码器的输入的序列的掩码多头自注意力的序列维输入,作为Q,我想知道,用目标序列作为查询,原始序列作为键值,输出的物理含义,我又如何形象的理解,最后的FFN又是想干嘛?他的目的是为了什么?是为了学习在编码后的语义空间里面,源序列和目标序列的一个预测的分布关系吗
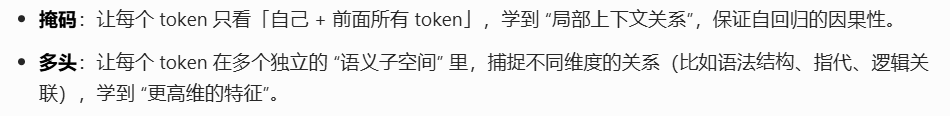

所以,掩码多头自注意力的输出序列,每个 token 的向量,已经融合了 “它前面所有 token 的上下文信息 + 多个维度的语义关系”,但依然保持序列的长度不变
588

676
384
注意,这里是中间有一个非线性

604

570
518

总的来看,解码器的输入输出(训练阶段)

257

解码器的输出和模型的预测输出

transformer架构认知修正

616

  • 编码器和解码器,本质上都是特征处理器,输出的是语义向量,不是词。
  • 真正的 “预测”,是靠解码器后面的线性层,把向量投影到词表空间,再通过 Softmax 变成概率。
627


376
457
319

解码器的KVcache

481

457


torch 损失函数

torch 训练

torch 评估